
 五度妙笔
 企业透视镜
 API商城

 数据库
网络架构的演进正在加速
一年一度的Hot Chips会议于8月23日至25日在斯坦福大学举行,现场门票售罄,加上线上直播,参会总人数约达3000人。尽管AMD、英特尔和英伟达等领先芯片厂商均有出席并发表演讲,但最大的AI主题是一系列定制XPU的亮相,包括谷歌的TPU 8t/i、Meta的MTIA400、微软的MAIA-200以及OpenAI的Jalapeño。
在纵向扩展(scale-up)网络方面,多场演讲展示了基于Broadcom Tomahawk6(TH6)的交换拓扑。AMD展示了其Helios交换托盘,该托盘包含一对TH6芯片,通过飞线电缆连接到背板连接器。OpenAI披露了其Jalapeño ASIC的纵向扩展网络,如图所示。与AMD一样,OpenAI使用TH6连接同一机柜内的加速器。这种铜互连方案可在128个ASIC之间实现最大带宽,用于张量并行处理。第二个“全局”域中每个加速器的带宽仅为本地域的三分之一,该域通过光互连连接16个机柜,共计2048个Jalapeño芯片。
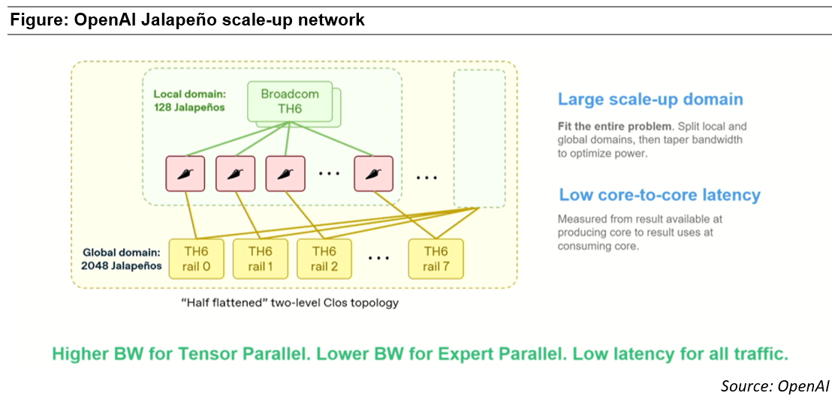
将全局域中的互连带宽限制为本地域的三分之一,这一定是利用可插拔光模块实现实际部署的关键所在。这种做法与华为在其Atlas 950 SuperPod中的实现方式类似。在业界开发更高带宽的纵向扩展互连方案之前,这必然是一种临时性解决方案,但无疑也为CPO/NPO的发展增添了紧迫性。
在横向扩展(scale-out)网络中,一个重要趋势是采用多平面拓扑结构,这种结构能有效倍增交换机的端口数,从而实现网络的扁平化。服务器网络接口(NIC)将其带宽分散到多个端口上,通常为8个。例如,Broadcom的Thor Ultra支持最多8个平面,以适配由AMD、Broadcom、Intel、Microsoft、Nvidia和OpenAI联合开发的全新多路径可靠连接(MRC)规范。同样,Nvidia的Vera Rubin平台通过ConnectX-9 NIC和Spectrum-6交换机,将每个GPU的1.6T带宽分散到8个平面上。谷歌新的Virgo网络(用于GPU和TPU集群的横向扩展)则采用多平面拓扑结构,实现了两级交换。
首批102.4T交换机可支持高达512个端口的端口数,即支持512个200G端口。在8平面两级拓扑中使用这些交换机,最多可支持100万个端点。这意味着超大规模厂商只需两级交换即可构建GPU集群。将多端口NIC连接到8台交换机需要分布式(DR)光模块,因为光纤可以被分路连接至不同的平面。这种网络每个GPU只需配备4个光模块,远低于目前的平均消耗水平。因此,这一趋势可能导致光模块的增长低于GPU和XPU的增长。
我们的最新预测将GPU/XPU的出货量与以太网光模块及CPO/NPO相关联,并综合考虑了不同的网络架构。我们此前预期未来架构将更加高效,但这一变化的速度可能比我们预想的更快。
请订阅用户登录官网获取研究简报全文:
👉https://www.lightcounting.com/login


