

要提高激光亮度,一种办法是把几路激光的功率合进同一束光里。难处在于,即使两束光照射到同一位置,波峰也未必总能相遇。相位差一旦改变,原本相互增强的光就可能彼此抵消。相干合束系统通常需要逐路测量、校正相位,参与合束的光路越多,反馈控制也越复杂。
美国南加州大学和德国耶拿大学的研究人员在一对光纤环里试了另一种办法。他们把光功率平分给两种传播模式,每次实验都随机设定两者的相位差。随着光在环里往返,最低阶模式(基模)的平均功率占比从50%升至82%,整个光场的空间相干性也随之增强。实验无须逐路锁定输入相位。成果以“Coherence enhancement through equilibration to near-zero optical temperatures”为题发表于Nature Physics 。


一对光纤环,怎样让模式交换功率
实验装置由一长一短两条光纤环构成。光脉冲每次经过耦合器,都可以进入长环或短环,走过的路程决定它何时返回。这些先后到达的时刻相当于一排格点,每个格点对应的光场有自己的振幅和相位。在没有非线性作用时,这套装置支持八种可以独立传播、保持形状的基本光场分布,每一种就是一个模式。
团队用同一台激光器制备脉冲,只激发最低两种模式,每种输入28毫瓦。环里各有一段非线性光纤,折射率随光强略微变化,光波沿途积累的相位也随之改变。经过多次往返,这种微弱作用足以让不同模式交换功率。环内的放大器负责补偿损耗。
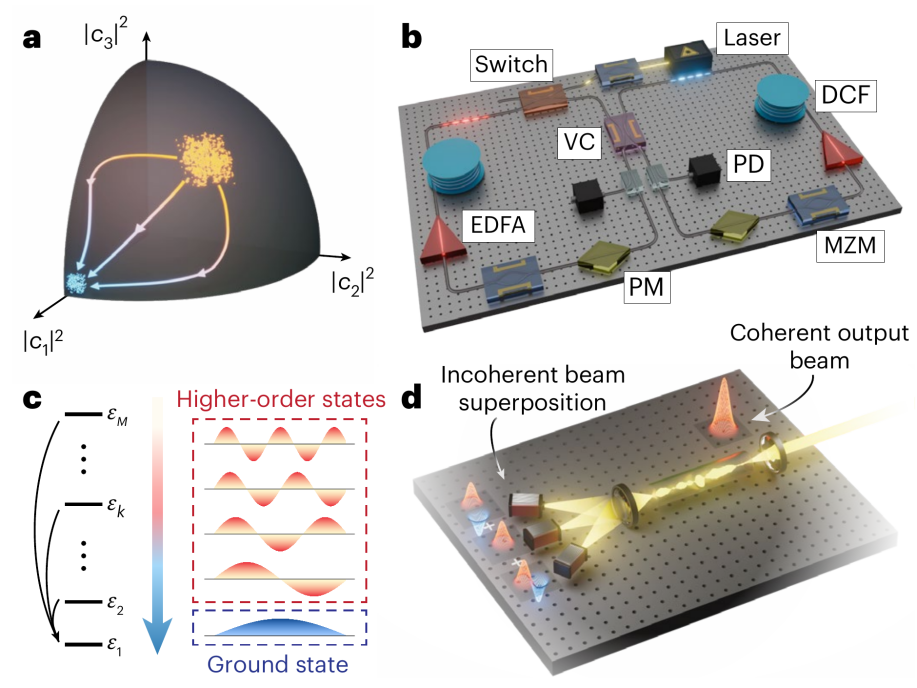
图1 光学热化提升空间相干性的原理与实验装置。(a)非相干多模输入经热化后,功率向基模集中的过程,橙色与蓝色点分别表示初始状态和平衡状态;(b)双光纤环实验装置,两条长度略有不同的光纤环通过可调耦合器相连,构成实验中的八模系统;(c)低光学温度下功率向基模转移的示意图,左侧为模式能谱,右侧为对应的光场分布;(d)利用非线性多模波导中的光学热化实现激光合束的应用设想
功率向基模集中,光学熵为何还会上升?
起初,基模和第二种模式各占一半功率。经过约75个演化时间步,相当于脉冲在光纤环中往返约150次,基模的平均功率占比达到82%。其余功率分布在另外七种模式中,一些起初几乎没有光的高阶模式也分到了一小部分。此后,各模式仍能交换功率,多次实验得到的平均分布却趋于稳定。这就是论文所说的光学热化。同一种模式在不同位置有确定的相对振幅和相位。它在输出中占的份额越大,这种固定的空间关系就越明显。团队根据格点之间的光场关联,计算了整个光场的相干指标。这个指标在完全相干时取1,在这组实验中从0.50升到了0.70。
同一过程中,光学熵也在上升。熵的计算用到了全部八种模式的平均功率,原先近乎空着的高阶模式得到少量光,就会明显改变这个量。与此同时,总功率保持不变,按模式能级加权得到的光学内能也近似守恒。功率原本集中在最低两阶,当一小部分转入较高能级时,基模要留下较大的份额,才能维持原有的平均能级。于是,更多模式有了光,基模也比起初占得更多。
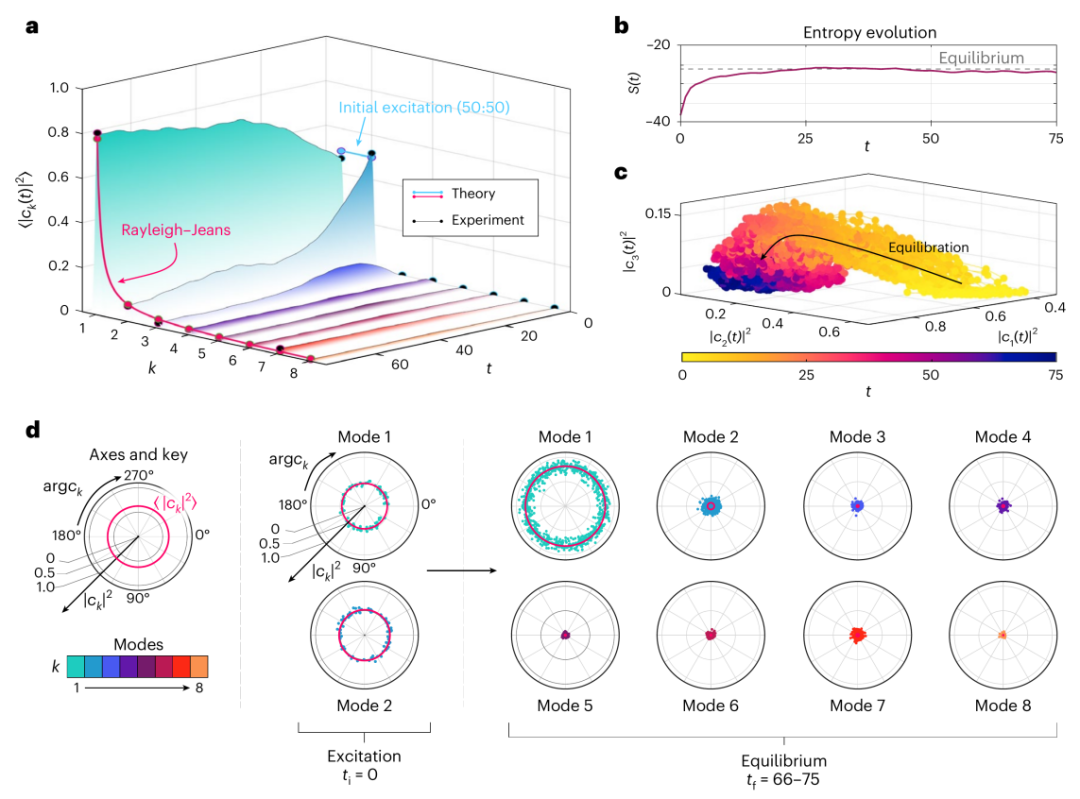
图2 光学热化中的功率分配、熵与相位变化。(a)各模式平均功率占比随演化时间步的变化,黑点为初始与末态的实验均值,彩色曲线为理论结果;(b)光学熵逐渐趋近理论平衡值(虚线);(c)最低三种模式功率占比的三维分布,颜色表示演化时间步,平衡时的深蓝色散点集中在较小区域;(d)热化前后各模式的功率占比与相位,散点的角度表示相位,到圆心的距离表示功率占比,品红色圆环表示理论平均占比
相位各不相同,功率分配依然接近
对合束来说,平均占比高还不够。如果某一次光功率几乎全部进入基模,下一次却只进去一半,输出就很难使用。研究人员设定了59组随机相位差,每组取最后10个时间步的读数,共得到590个样本。在图2d中,基模的散点分布在不同角度,到圆心的距离却十分接近。相位可以各异,基模分到的功率很少大起大落。这里的温度从各模式的平均功率分布中读出,实验无须给光纤制冷。在这组实验中,平衡分布越偏向低阶模式,对应的光学温度就越接近零。根据已知的模式谱和最低两种模式的输入功率,团队预测归一化光学温度为0.040,从实验数据得到的数值为0.038。
改变起初被激发的模式,就能看到稳定性如何随光学温度变化。让最低六种模式平分输入功率,平衡时基模平均只占21.6%。改为最低四种,平均占比升至39%,标准差约16个百分点。只激发最低两种时,基模平均占82%,标准差缩小到约3个百分点。图3右列的分布从宽变窄,说明高占比也更容易稳定复现。
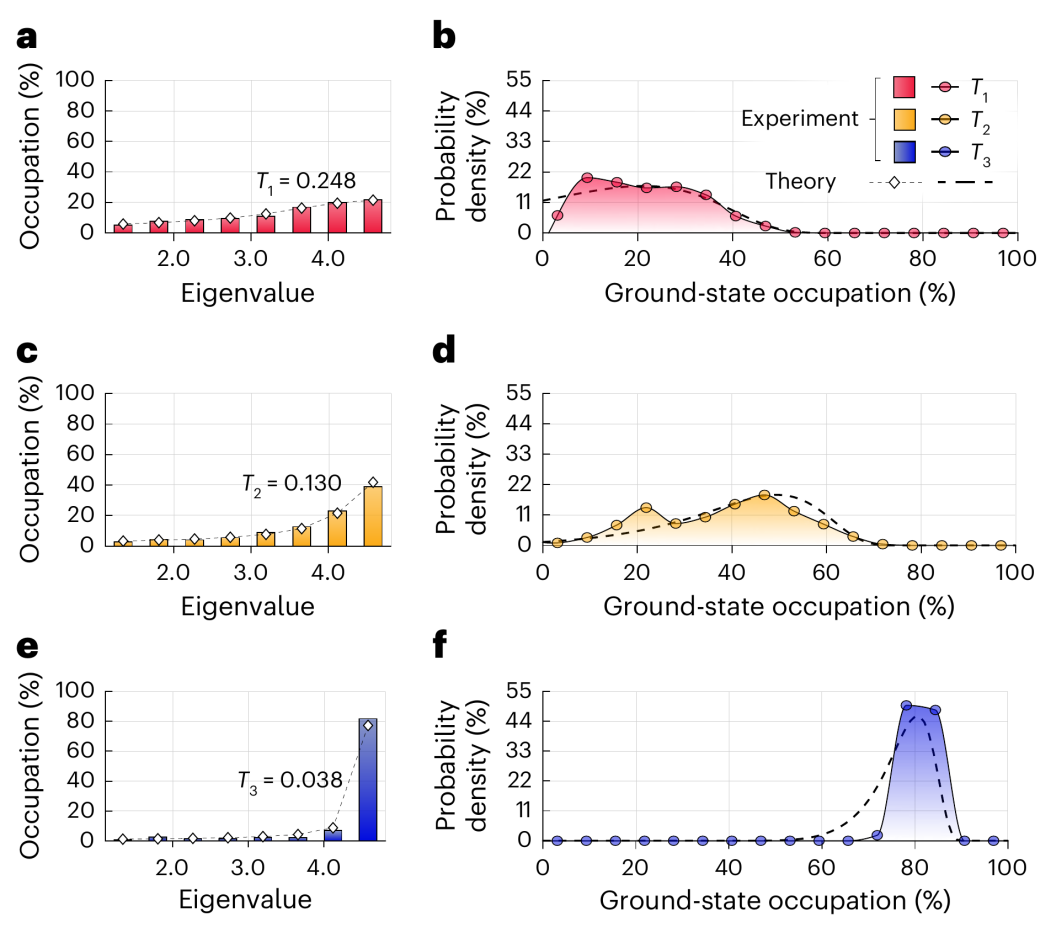
图3 不同光学温度下的功率分配与波动。(a、b)、(c、d)、(e、f)分别对应最低六种、四种和两种模式等功率、随机相对相位激发后的平衡状态。左列(a、c、e)为各模式平均功率占比,彩色柱为实验结果,白色菱形及细虚线为理论预测;右列(b、d、f)为基模功率占比的统计分布,彩色圆点及其连线为实验结果,黑色粗虚线为理论预测。随着光学温度降低,基模平均占比升高,分布逐渐收窄
增加可用模式,还要选对功率
前面的实验改变了最初激发的模式数,双环始终支持八种模式。团队接着在模型中固定输入,始终让最低两种模式平分功率,只增加可用模式的总数。在能级等间隔的模型里,可用模式越多,平衡时的全局相干指标越接近1。要在有限的传播距离内接近平衡,还得选对功率。对八模系统的数值模拟表明,同样传播75个时间步,输入太弱,模式之间来不及充分交换功率。功率超过合适范围后,基模占比又开始回落。作者将回落归因于较强非线性下出现的弱孤子行为,它推迟了系统达到平衡的时间。
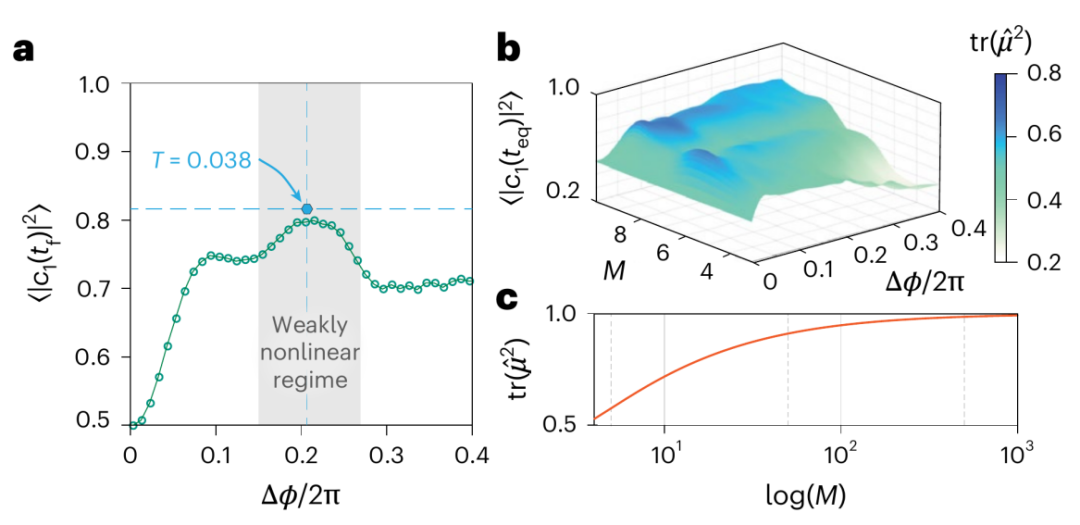
图4 输入功率和可用模式数对相干增强的影响。(a)八模系统演化75步后的数值模拟,绿色圆点及曲线表示基模平均功率占比,灰色阴影标出弱非线性区间;横轴的自相位调制量与输入功率成正比;(b)同时改变功率和可用模式数的模拟结果,曲面高度表示基模平均功率占比,颜色表示全局相干指标;(c)等间隔能谱下的理论预测,在最低两种模式等功率、随机相对相位激发时,可用模式数越多,平衡时的全局相干指标越接近1
总结与展望
这项研究表明,选好低阶输入模式后,光可以在弱非线性作用下重新分配功率,逐渐形成基模占优的高相干状态。双环实验中,基模平均功率占比从50%升至82%,平衡时占比的标准差约为3个百分点。不同输入相位下都能得到相近的结果,说明这种功率集中具有可重复性。结合模式谱和初始功率分配,还能预测平衡时的平均分布,为减少逐路相位反馈提供了实验依据。
面向实际合束,传播距离和光源条件仍需进一步检验。作者提出,调整模式之间的能级间隔,或许能加快功率向基模集中的过程,缩短所需光路。现有实验的两种模式来自同一台激光器,后续可用两台独立激光器分别提供一路输入,考察相对相位持续漂移时,基模能否长期保持较高的功率占比。若高占比与低波动能够同时维持,这种方法有望简化多路激光合束的控制。
原文链接:
https://doi.org/10.1038/s41567-026-03520-z
推荐阅读:
1.Adv. Photon. | “光子石墨烯”的平带调控
2.Adv. Photon. | 光纤传感与光计算融合的感通算一体光神经网络模型
3.Adv. Photon. | 多层同步偏振投影,突破多通道偏振平均串扰理论极限
END
点在看联系更紧密