

SuperCLUE-VLM 是面向中文多模态视觉语言模型打造的综合测评基准,聚焦“模型能否真正看懂图像,并完成推理与应用任务”。基准覆盖基础认知能力、视觉推理能力和视觉应用能力三大维度,以及通用识别、信息解析、学科与应用推理、行业应用、智能交互和安全风控等场景,重点考察模型的视觉感知、信息理解、空间与逻辑推理、真实场景分析及任务执行等核心能力,为用户选择多模态视觉模型、行业评估模型视觉能力提供可靠参考。
「过往文章介绍」
1.【2026年9月多模态视觉语言测评文章】9月多模态视觉测评榜单出炉:Qwen3.8-max问鼎国内榜首,GPT-6-Astra总榜领先!
2.【2026年6月多模态视觉语言测评文章】6月多模态视觉测评榜单出炉:Qwen3.7-Plus问鼎国内榜首,Gemini 3.1保持总榜领先!



测评摘要
摘要3:场景应用能力——学科推理、安全风控趋于成熟,应用推理、行业应用与智能交互短板明显
学科推理全部15款模型均不低于91.67分,安全风控已有两款模型取得满分;应用推理最高分仅83.48分,行业应用最高仅73.33分,智能交互多数模型不超过66.67分。
5.系统化构建各维度专属评测集,形成完整测评题库。
2、测评集质量规范
对于常规图像理解、视觉推理和视觉应用任务,采用独立评价模型对待测模型回答与参考答案进行逐题比对。评价重点包括核心事实、关键对象、数量关系、空间关系、推理结论及任务要求是否一致。对于双轮对话任务,需两轮回答均满足要求,方可判定为正确;同义表达、语序调整或非关键表述差异不影响正确性判断。
对于具身智能规划等需要输出结构化操作指令的任务,采用自动化规则进行校验。校验内容包括函数调用名称、调用顺序、参数结构及关键参数取值是否符合参考答案要求;涉及坐标或位置约束时,进一步判断模型输出是否满足参考答案设定的有效范围。
评估示例

【参考答案】:「3个」
图里真实存在的瑜伽球共有3个:1个粉色、1个黄色、1个蓝色,剩余的1个黄色、1个蓝色,是右侧墙面镜子反射形成的虚像,不属于真实存在的球。答案:3个。
****评价开始**** 1. **模型回答的核心内容分析**:
模型明确回答图中共有3个真实的瑜伽球,并详细解释了颜色的分布(粉、黄、蓝各一个)。同时,模型展现了对图像场景的深度理解,指出画面中另外出现的球体是镜面反射形成的虚像,不应计入总数。
2. **参考答案的核心内容分析**:
参考答案给出的核心数值为“3个”。
3. **模型回答与参考答案的详细对比**:
- **核心结论一致性**:模型给出的最终数量“3个”与参考答案完全一致。
- **关键信息点**:模型不仅提供了正确答案,还通过逻辑推理(区分实物与镜面虚像)解释了得出该答案的原因。这种解释增强了回答的准确性,并未改变或偏离参考答案的核心语义。
- **表述差异**:模型回答包含了详细的推理过程,而参考答案仅提供了精简的数值。根据评估要求第3点,这种表述形式的差异(详细描述 vs 简洁数值)不影响核心事实的认定。
4. **最终判定及理由**:
[[回答正确]]
理由:模型给出的核心答案(3个)与参考答案完全一致。模型通过识别镜面反射准确判断了物体的真实数量,其提供的额外解释信息支持了核心结论的正确性,没有事实性错误。
****评价结束****
# 参评模型


# 模型对比示例
#示例1 基础认知能力-信息解析-数量判断
【问题】:「图中共有几种颜色的葡萄?」

【参考答案】:「3种」
共有 3种 颜色的葡萄:紫黑色、红色和绿色。为了解决这个问题,我们首先分析图中的葡萄:识别葡萄:篮子里有深紫色(或黑色)的葡萄和绿色的葡萄。 计算颜色数量:深紫色和绿色是两种不同的颜色。 图中共有2种颜色的葡萄。 #示例2 视觉应用能力-智能交互-具身智能规划
【问题】:「请根据图片中的信息完成下面的任务。 你先把脏衣服放到单人沙发上,然后去有两个洗手池的卫生间泡澡,最后经过沙发和室外盆栽,到四人小桌边休息。(图中红色圆点代表你目前所在的位置,红色实线上绿色圆圈中的数字代表route_number,你必须按照红色实线一步一步前进,不可以跳步。) 你的回复必须严格遵循以下格式给出:【路线开始】```[route_number, route_number, route_number, route_number, ...]```【路线结束】,不应该包括任何其他文本。」

【参考答案】:「1, 3, 4, 8, 9, 10, 9, 8, 7, 4, 3, 2, 13, 15, 18, 19, 20, 22」
【路线开始】[1, 3, 4, 8, 9, 10, 9, 8, 7, 4, 3, 2, 13, 15, 18, 19, 20, 22]【路线结束】【路线开始】[1, 2, 13, 15, 13, 2, 3, 6, 3, 2, 13, 15, 18, 19, 20, 22]【路线结束】#示例3 视觉推理能力-应用推理-逻辑推理
【问题】:「从所给的四个选项中,选择最合适的一个填入问号处,使之呈现一定的规律性。」

【参考答案】:「B」
这道题考查的是图形的总笔画数(或各组成部分的笔画数规律)。
我们可以通过“奇点数”来判断每个图形的笔画数(笔画数 = 奇点数 ÷ 2,若奇点数为0则为1笔画;多部分图形的总笔画数为各部分笔画数之和):
第一组图形:
图1、2、3都是3笔画图形
第二组图形:
图1:由两部分组成。上方折线为 1 笔画,下方图形有4个奇点,为 2 笔画,共计 3 笔画。
图2:由两部分组成。内部折线为 1 笔画,外部图形有4个奇点,为 2 笔画,共计 3 笔画。
由此可知,每幅图均由两部分组成,且一部分为 1笔画、另一部分为 2笔画,图形的总笔画数恒为 3笔画。
分析选项:
A项:上下两部分均为1笔画,共 2 笔画,排除;
B项:左边部分有4个奇点,为2笔画;右边折线为1笔画,共 3 笔画,符合规律;
C项:上下两部分各有4个奇点,均为2笔画,共 4 笔画,排除;
D项:左右两部分各有4个奇点,均为2笔画,共 4 笔画,排除。
故正确答案为 B。
答案:D
规律:每一组中,前两个图形叠加得到第三个图形。
左边第一组里,第3个图形正是第1个和第2个叠加组合而成;右边第二组同样遵循此规律,所以问号处应是第4个和第5个叠加后的图形。
对比四个选项,只有 D 符合这一叠加规律。
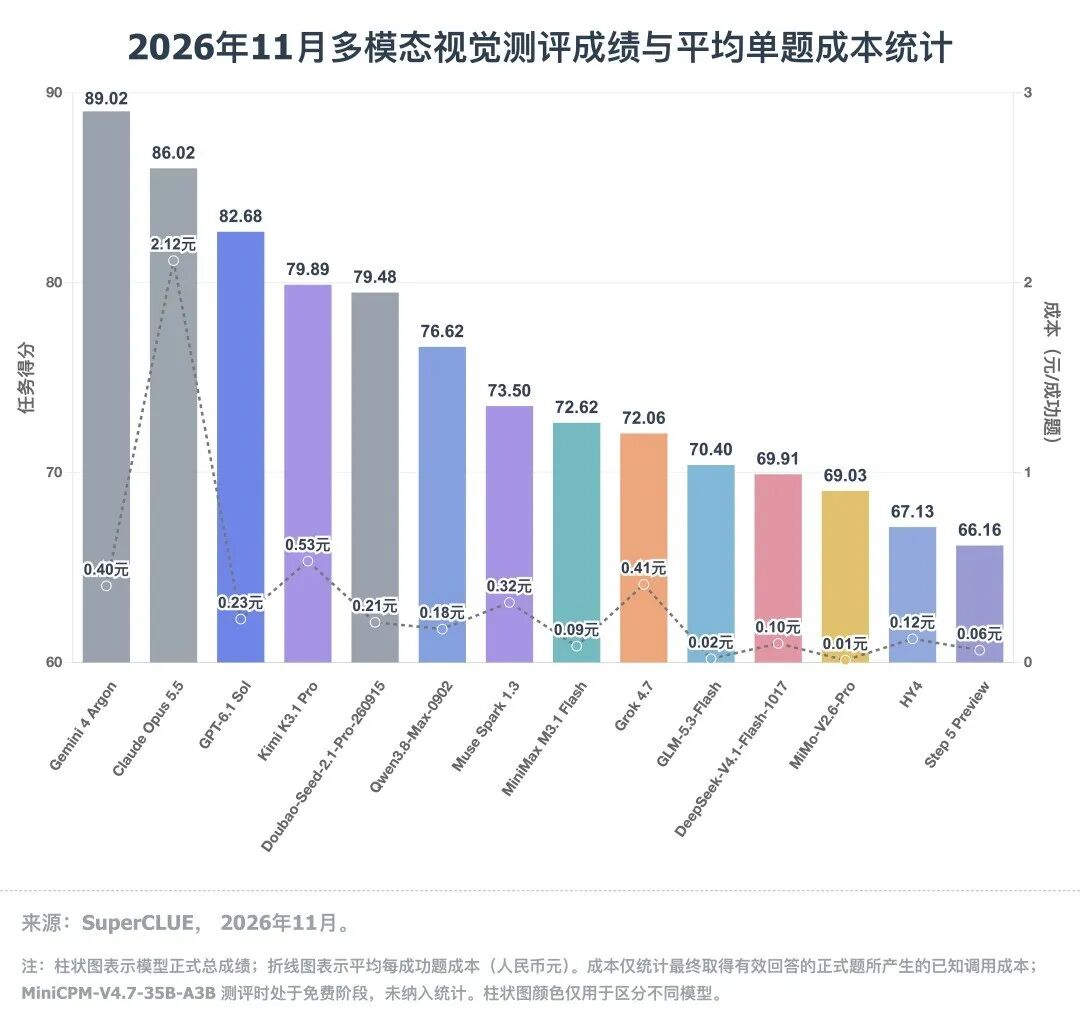
1. Gemini 4 Argon"全维度第一",Kimi与Doubao并列国内并列第一


# 加入社群


扩展阅读
[1] CLUE官网:www.CLUEBenchmarks.com
[2] SuperCLUE排行榜网站:www.superclueai.com
[3] Github地址:https://github.com/CLUEbenchmark