


如今,大模型参数的规模还在继续扩张,普通八卡机、16卡机的显存和算力已难以承载完整模型。计算资源被分散到几十张甚至更多xPU和多个节点,系统由多卡服务器走向超节点:让数十乃至数百个xPU协同工作,尽可能像一台更大的计算机。
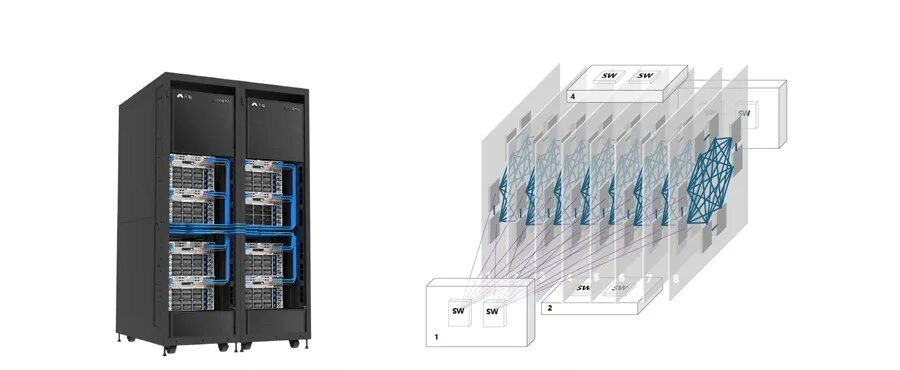
但把更多加速卡装进机柜,并不会自动得到一台高效的“超级计算机”。卡越多,跨设备的数据交换越频繁;通信一旦跟不上,计算单元就只能等待。模型如何切分、多个xPU如何配合、远端内存如何访问,正在成为影响超节点效率的关键问题。
这也是最近一篇技术论文切入的方向。最近浪潮信息发布的技术论文《Co-Fabric: Breaking Host-Domain Boundaries for Unified xPU Interconnection》中,提出了一种跨越主机域的总线式互连架构:把分散在不同主机中的xPU纳入统一的互连域和全域统一地址空间,由硬件承担跨域寻址与转发,减少应用对节点拓扑的感知。它试图回答一个直接的问题:如何让超节点内部的多台主机,不再只是“彼此通信的服务器”,而成为一个能够统一组织资源的计算域?
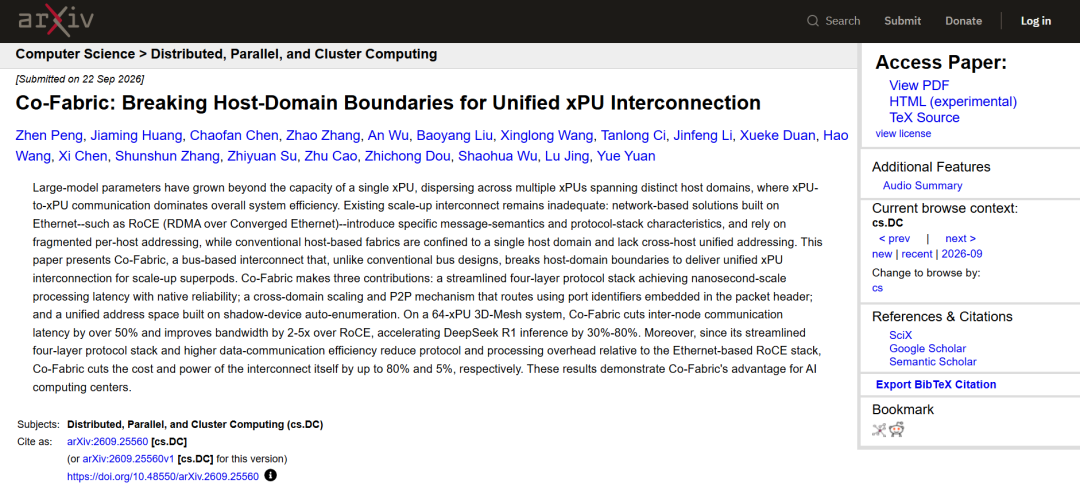
论文摘要
01
一、超节点为何受困于主机边界
现有扩展方式大致沿两条路线发展。总线式互连以计算设备直接交换数据为中心,具备低延迟和Load/Store内存语义,但传统实现通常受限于单一主机域。基于以太网的网络式互连,例如RoCE,能够跨主机连接设备,生态也较成熟,但仍需处理消息语义、内存注册、队列管理和网络协议栈等环节。
两条路线各有所长,而超节点需要同时实现跨主机扩展和低延迟内存访问。Co-Fabric的架构新意,是尝试把总线式互连从单一主机域延伸至多个主机域,保留直接访问和较低协议开销的特点,同时扩大互连覆盖范围。
因此,Co-Fabric并非要取代数据中心以太网,也不是简单拉长传统总线。论文聚焦的是scale-up超节点内部的计算互连;以太网仍可承担对外网络、存储网络或管理网络等功能。理解这一边界,才能看清它的目标:重新组织超节点内部xPU及相关系统资源的连接、寻址与协同。
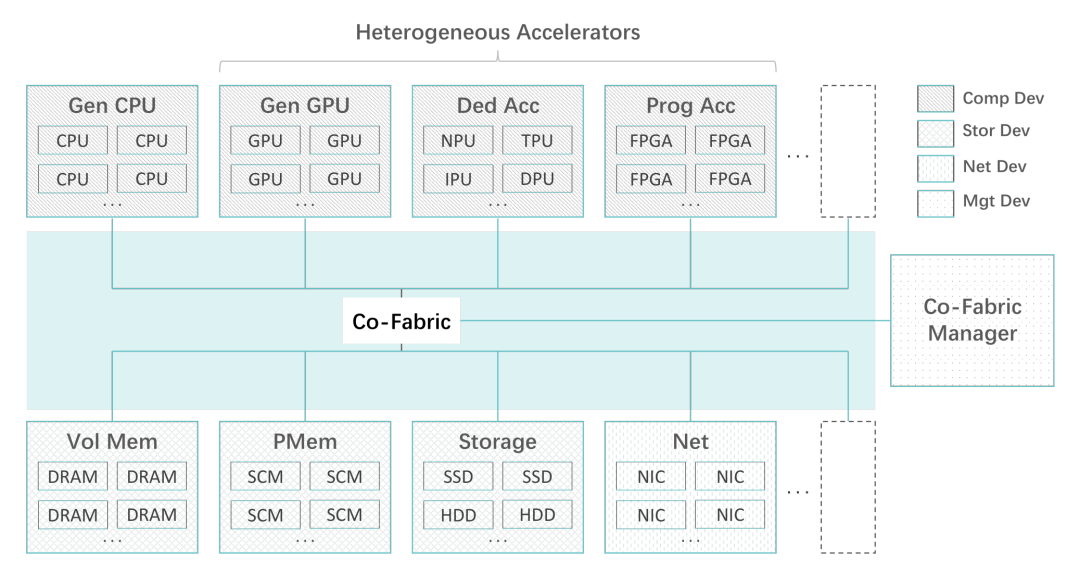
Co-Fabric将异构计算、存储、网络及管理资源纳入统一互连架构。
02
二、核心变化是全域统一寻址
Co-Fabric的核心机制是全域统一地址空间。超节点内不同xPU的HBM被映射到互不重叠的地址范围,地址可以对应到具体设备和内存位置。应用发起远端访问时,可沿Load/Store语义访问目标地址,由互连硬件完成寻址和转发,从而减少对显式消息传递和软件层数据搬运的依赖。
让这一机制落地的关键设计是影子设备(Shadow Device)。Co-Fabric交换芯片在主机设备层级中呈现虚拟端点,并在启动时发现下游xPU、分配地址范围、生成一致的设备视图。每个主机因而可以看到超节点中的远端xPU,应用不必持续判断目标设备属于本机还是其他主机。
这让分布式多xPU程序有机会沿用更接近单节点多卡的编程方式。这里的“像单节点”,主要指设备发现、地址访问和编程模型更统一;它不意味着多个xPU合并成一颗芯片,也不代表形成了完整的缓存一致性共享内存。论文讨论的是统一地址和内存访问语义,并不要求为所有xPU建立完整缓存一致性机制。实际表现仍会受到设备位置、拓扑、带宽和访问模式影响。

交换芯片通过影子设备呈现xPU,并将其HBM地址范围映射至主机物理地址空间,访问再被转发到实际设备。
03
三、让交换芯片参与资源组织
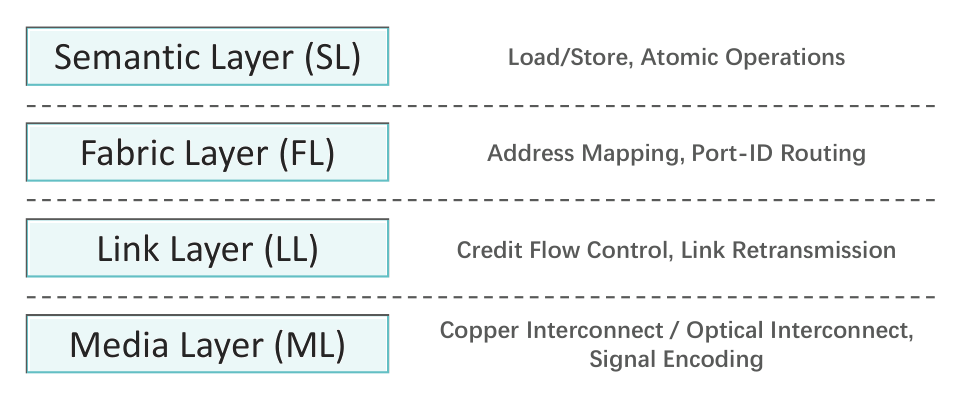
统一地址解决了“访问哪个资源”的问题,超节点还需要解决“数据如何抵达目标”的问题。Co-Fabric把协议栈划分为语义层、Fabric层、链路层和介质层:语义层支持Load/Store和原子操作;Fabric层管理地址映射与Port ID路由;链路层负责信用流控和链路级重传;介质层适配铜缆、光互连及信号编码。
其中一项关键设计,是将跨域路由交给交换芯片硬件完成。每个端口在初始化时获得全局唯一Port ID,数据包头携带源、目的Domain ID和Port ID。交换芯片根据目标Port ID查表转发,避免主机CPU在数据路径中接力,也减少逐跳解析上层地址的需要。
论文还设计了Fabric Type字段,支持单播、多播、广播及网内计算(In-Network Computation,INC)等模式。INC可在转发路径上执行逐元素加、最小值或最大值操作,为AllReduce等集体通信提供硬件卸载思路。论文展示了这些协议机制,但这不等于每种模式都已在所有生产负载中完成规模化验证。
可靠性同样下沉到链路层:信用流控限制发送端注入速率,降低接收缓存溢出的风险;链路级重传则在相邻链路发现错误后局部恢复,减少对端到端重试的依赖。地址映射、路由、流控和部分可靠性处理由互连硬件承担,目标是缩短超节点内部的数据通路。
04
四、元脑超节点上的系统验证
架构设计需要实验检验。论文给出的系统规模为64个xPU,采用双机柜部署,每个节点配置8个xPU,并以3D Mesh方式组织机内和跨节点通信。作者将其与同样配置64个xPU的RoCE系统对比。该实验验证了跨主机域互连和通信扩展能力,但不能等同于千卡规模实测;千级扩展是架构提出的扩展目标。
在基础通信测试中,4MB以下小数据包场景的AllReduce延迟降至RoCE系统的约10%至20%,带宽约为其5至15倍;4MB以上数据包场景,延迟降至RoCE系统的约15%至50%,带宽约为其2至5倍。DeepSeek R1推理测试中,Co-Fabric系统推理性能提升约30%至80%;在128并发测试条件下,吞吐约为RoCE系统的1.8倍。

64个xPU的3D Mesh Co-Fabric系统与RoCE系统对比;左图为不同数据大小下的AllReduce延迟,右图为归一化通信带宽。
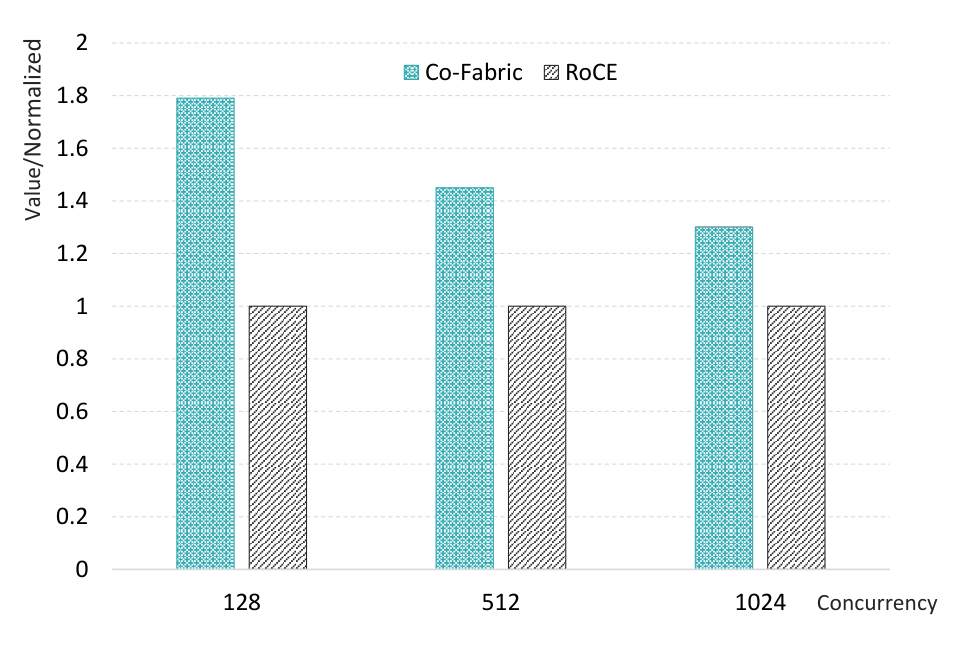
DeepSeek-R1 671B在128、512、1024并发下的归一化推理吞吐对比,RoCE为基准。原论文条件为64个xPU、SGLang、INT8、MLA、DP4 TP16及MoE TP并行,输入/输出均为1K tokens。
固定负载测试显示,Prefill阶段总耗时从约230秒降至约170秒,Decode阶段从约249秒降至约182秒。论文将主要收益与AllGather、AllReduce等通信时间缩短联系起来。规模扩展测试中,DeepSeek V3/R1 LoRA微调在64个xPU时达到8个xPU基准性能的约93%,另两项测试约为98%。这些数字反映的是特定工作负载和系统配置下的性能保持率。
论文同时报告,实验系统的互连成本约降低80%,互连功耗约降低5%。这两个数字针对互连部分,并非整机成本或整机功耗;具体结果也受论文所选硬件配置和对比方案影响,不能直接推广为所有场景的固定收益。
05
五、Co-Fabric的突破与待验证之处
把实验数据放回架构设计中看,Co-Fabric的贡献不是单项链路指标,而是将几种能力组合成一套面向超节点的互连方案:总线式内存语义跨越主机域,全域地址映射统一呈现远端xPU,交换芯片基于Port ID完成硬件路由,链路层提供流控与局部重传,协议还纳入多播和网内计算等模式。
这一组合直接针对超节点扩展中的矛盾:系统既要跨主机连接,又希望减少网络化通信带来的软件和协议开销。如果统一寻址与硬件路由能够在更大规模、更多模型和更多软件栈中稳定工作,超节点便有望降低跨主机资源协同的复杂度。
模型运行效率不仅取决于加速器峰值算力,也取决于参数、激活值、缓存和中间结果能否及时抵达计算单元。互连设计因此会影响数据移动成本,也会影响软件如何切分和组织计算任务。超节点竞争从单卡性能扩展到系统架构,Co-Fabric正是这一变化中的一个技术尝试。
论文目前展示的是面向scale-up超节点的技术路径,以及64个xPU系统的对比结果。更大规模多机柜部署、复杂混合负载、软件生态适配、长期可靠性和维护成本,仍需进一步验证。它的意义在于把跨主机统一寻址从概念推进到协议设计、交换芯片机制和系统级实验,为超节点跨越主机边界提供了一种可讨论、可验证的架构方案。
↓设置星标,精彩不错过↓


欢迎关注本公众号,获取更多半导体设备、工艺、产业动态


