 五度妙笔
 企业透视镜
 API商城

 数据库
从6TOPS到2070:一颗域控制器,正在决定人形机器人的"大脑分级"
智微智能成为智元首批"A链"供应商背后,人形
机器人
产业的核心硬件博弈已经开场
人形机器人最缺的,不是身体,是脑子
2026年,人形机器人的"身体"已经不成问题。
智元远征、宇树H1、傅利叶GR-2、小鹏IRON——国产人形机器人接连走上产线、走进工厂、站上展台。灵巧手能抓鸡蛋,双腿能跑马拉松,外观越来越像人。
但一个残酷的事实是:
绝大多数人形机器人,至今仍然是"四肢发达、头脑简单"。
不是它们不想聪明,是它们的"大脑"装不下聪明。
一个简单算账:人形机器人整机功耗预算通常只有25-40瓦——这点电,连一张桌面级RTX 4090显卡都带不动。而要在端侧跑通视觉语言动作模型(
VLA
),需要的算力远超这个数字。结果就是,大量机器人只能在"弱智但省电"和"聪明但跑不动"之间反复妥协。
这道题,靠机器人本体公司自己解不了。解这道题的,是它们身后那群做域控制器的公司。
9月8日,深圳智微智能(001339)披露了一则看似低调、实则信号量极大的消息:公司推出"
智擎
"系列机器人域控制器产品线,覆盖NVIDIA Jetson、Intel Ultra、Rockchip三大芯片平台,算力从6 TOPS到2070 FP4 TFLOPS全档位覆盖,已成为智元机器人首批"A链"供应商。
一家做智联网硬件的公司,为什么能成为人形机器人头部企业的核心供应商?一颗域控制器,到底在解决什么问题?
"大脑+小脑":人形机器人的算力三层楼
要理解域控制器的价值,先得理解人形机器人到底需要什么样的"脑子"。
和人脑一样,人形机器人的计算架构是分层协同的,业内通常分为三层:
第一层:大脑——"想清楚要干什么"。
负责视觉感知、语义理解、任务规划和决策。对应人脑皮层的认知功能。需要高性能AI芯片跑大模型(VLA/VLM/LLM),对算力要求最高,但对实时响应要求相对宽松。
第二层:小脑——"想好怎么动"。
负责运动规划、动态平衡、力反馈控制。拿到"大脑"的任务指令后,完成全身协调运动。对实时性要求极高,需要50-100Hz的运算频率。
第三层:脊髓——"让每块肌肉动起来"。
由分布在各个关节内部的
MCU
芯片实现,负责毫秒级电机电流环控制,直接驱动每一个关节转动,响应速度要求达到千赫兹级别。
三层架构带来一个现实矛盾:
3赫兹的现实,对抗100赫兹的需求。
目前边缘端VLA大模型实测帧率大多只有3-11帧/秒,也就是3-11Hz;但底层运动控制需要稳定50-100Hz的运算速度。简单说,机器人"大脑想好一个动作"的速度,跟不上身体执行动作的速度。想法出来了,身体还反应不过来——这就是很多人形机器人走路卡顿、动作僵硬的根本原因。
域控制器要做的,就是把这三层算力需求集成到一个(或一组)硬件模块里,让它们高效协同。
智微智能"智擎":三平台全档位覆盖的逻辑
智微智能的"智擎"系列,最核心的特征是
"三平台、全档位"
。
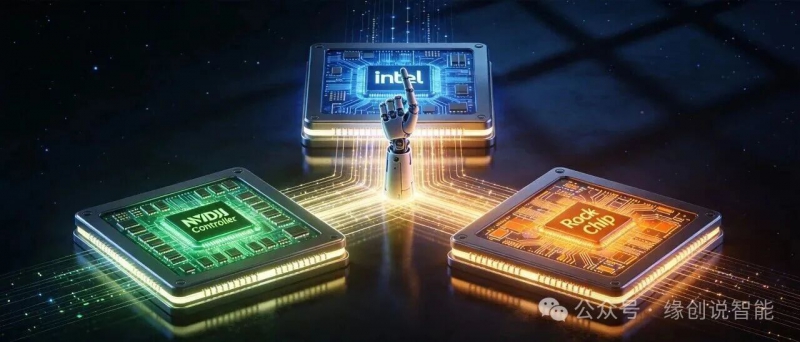
NVIDIA Jetson
平台
:覆盖Orin NX、AGX Orin、AGX Thor三款芯片。Orin NX适合轻量级场景(AGV/
服务机器人
),AGX Orin是当下人形机器人的主流选择(200-275 TOPS),AGX Thor则是下一代旗舰(2070 FP4 TFLOPS),面向高端人形机器人的端侧大模型推理。
Intel Ultra平台
:x86生态兼容性强,适合需要跑Windows/Linux
应用
、对接传统工业系统的场景。在人形机器人领域,Intel更多扮演"补充者"角色,提供通用计算能力。
Rockchip
平台
:国产芯片代表,以RK3588系列为主打,NPU算力够用、功耗可控、成本优势明显。大量国产人形机器人用RK3588充当"小脑",负责运动规划。
从6 TOPS(Rockchip入门级,服务机器人/AGV场景)到2070 FP4 TFLOPS(NVIDIA AGX Thor旗舰级,高端人形端侧大模型推理),
这条产品线覆盖了人形机器人从"小脑"到"大脑"、从"轻量级"到"重量级"的全部算力区间。
这意味着什么?意味着无论一家
机器人公司
做的是几千块的配送机器人,还是几百万的人形旗舰,都可以在智微智能一家供应商里找到匹配的域控制器方案。
为什么是智元?"A链"供应商的含金量
智微智能此次披露中,最引人注目的一个信息是:
成为智元机器人首批"A链"供应商,并获评"优秀供应商合作伙伴"。
"A链"这个词,在制造业供应链中有明确含义——它指的是"核心战略级供应商",直接影响产品定义和技术路线,而非简单的零部件采买关系。
智元是国内人形机器人赛道的头部玩家。截至2026年,智元已完成多轮融资,估值超63亿美元,其远征系列人形机器人在工业仓储、物流分拣等场景实现规模化部署。智元的机器人需要什么样的域控制器,直接影响着整个供应链的技术走向。
智微智能能成为智元的"A链",背后有几层逻辑:
第一,"大脑+小脑"一体化能力。
智微智能不是只做某一层,而是具备从大脑到小脑的完整控制器能力。对于智元这样的头部客户,能同时提供大脑和小脑方案的供应商,在系统集成和协同优化上有天然优势。
第二,多平台选型能力。
人形机器人的芯片选型不是"一个答案",而是根据产品定位、功耗预算、成本约束做"最优匹配"。智微智能同时覆盖NVIDIA、Intel、Rockchip三大平台,可以给客户提供灵活选型建议,而非"只能选某一家"。
第三,NVIDIA生态深度绑定。
智微智能已深度接轨NVIDIA"三台计算机"机器人生态,形成"端—边—云"协同的完整算力闭环。在NVIDIA AGX Thor成为下一代人形机器人标配芯片的趋势下,这种生态绑定价值极大。
第四,智算业务的算力底座支撑。
智微智能2026上半年智算业务收入10.3亿元,同比增长245%,已超2025年全年水平。公司拟募资28.7亿元用于智算中心建设,采购服务器不超过40亿元。这种"云端训练+端侧推理"的全链路算力能力,恰好对应了人形机器人"训练靠云端、执行靠端侧"的核心需求。
产业深层:域控制器正在成为人形机器人的"新战场"
智微智能的故事不是个例。人形机器人产业链正在经历一场静默的"大脑争夺战"。
从芯片端看,两大阵营已经分化。
一方是以NVIDIA为代表的"通用高性能AI芯片"路线。Jetson系列是目前全球人形机器人应用最广泛的端侧计算平台,Figure、宇树、傅利叶等大量企业都在使用。优势是算力上限高、生态完善;短板是功耗偏高。
另一方是以国产厂商为代表的"场景定制"路线。寒武纪做"云边端一体化",地平线把自动驾驶能力迁移到具身智能,瑞芯微RK3588已经批量用于国产人形机器人"小脑",芯驰科技推出R1大脑+D9小脑+E3执行端的完整芯片矩阵,黑芝麻智能将车规级芯片能力延伸至具身智能领域。
从控制器端看,"集成化"正在取代"拼凑式"。
早期人形机器人的做法是"拼芯片"——大脑用一块、小脑用一块、关节控制再一块,各自为战,协同靠软件硬凑。现在的趋势是集成化,比如地平线旗下的D-Robotics推出的S600平台,把18核A78AE CPU + Nash架构BPU + 6核R52+实时MCU集成到单颗SoC上,在一颗芯片内实现感知-决策-实时动作控制的闭环。
智微智能走的是另一条集成路径——不做芯片,做控制器。通过覆盖三大芯片平台的"智擎"产品线,让机器人公司不需要自己去做芯片选型和硬件集成,直接在菜单上选配置。
这种定位,有点像服务器行业的ODM——不造CPU,但把CPU、内存、存储、网络集成成一台可用的服务器。
数据背后的增长逻辑
一组数据可以帮助理解这个赛道的爆发速度:
- 智微智能2026上半年营收30.50亿元,同比增长56.64%
- 归母净利润3.88亿元,同比增长281.92%
- 智算业务收入10.30亿元,同比增长245.51%,已超2025年全年
- 拟募资28.7亿元投向智算中心建设
- 拟采购服务器及配套设备不超过40亿元
这些数字说明两件事:
第一,AI算力需求确实处于高景气度。不只是云厂商在买算力,机器人公司也在成为算力消费者——它们需要云端训练算力,也需要端侧推理算力。
第二,域控制器/智算业务正在从"概念"变成"营收"。智微智能的智算业务半年就超过去年全年,机器人控制器已经进入头部客户供应链——这不是PPT阶段的故事。
写在最后
人形机器人产业有一个经常被忽视的真相:
决定机器人"聪不聪明"的,不只是算法,还有硬件。
一个再好的VLA模型,如果芯片跑不动、功耗撑不住、延迟降不下来,就无法在真实物理世界里流畅运行。算法团队花几个月优化的模型推理速度,可能因为域控制器的架构选型错误而全部浪费。
从这个角度看,智微智能成为智元"A链"供应商,不只是这家公司自身的里程碑——它标志着人形机器人产业链正在从"比谁能动"走向"比谁更聪明",而"聪明"的基础设施,正是域控制器。
从6 TOPS到2070 FP4 TFLOPS,这个数字跨度背后,是人形机器人从"玩具"到"工具"到"生产力"的全部进化空间。
谁能在这个空间里,给机器人装上足够聪明的"大脑",谁就能拿到下一张入场券。
声明:本内容由AI生成,文章所有内容仅供参考。


