
 五度妙笔
 企业透视镜
 API商城

 数据库
人形机器人送餐离实用还有多远?SteadyTray解决行走振动下非固定物体稳定这一关键难题
机器人
&具身智能&SLAM交流&合作&投稿(GreenRobotics)
全文速览
让人形机器人端着托盘走路,看起来只是一个简单的“送餐”任务,真正做起来却远比想象中困难。机器人每一次迈步都会产生冲击和身体摆动,这些振动会沿着躯干、手臂一路传递到托盘。对于固定在机械臂上的物体来说,还可以依靠刚性连接维持稳定;但如果托盘上放的是没有任何固定装置的杯子、医疗器械或者食物容器,轻微的倾斜和加速度都可能导致物体滑动、倾倒甚至液体洒出。来自 UC San Diego 的研究人员提出 SteadyTray,并设计了一套 Residual Student-Teacher Reinforcement Learning(ReST-RL)框架,让 Unitree G1 人形机器人能够在行走过程中主动稳定托盘上的非固定物体。
与直接从头训练一个同时负责“走路”和“稳住物体”的大策略不同,ReST-RL 把问题拆成两个部分:已有的基础策略专门保证机器人稳定行走,新增的 Residual Module 只学习如何抵消步态振动和外部扰动。最终,机器人不仅能端着装有液体的酒杯行走,还能在身体被推、托盘物体被撞击时,通过全身动作重新恢复稳定。仿真实验中,ReST-RL 在变速跟踪任务中的最高成功率达到
96.9%
,在 Push Robot 和 Push Object 扰动任务中的成功率分别达到
84.6%
和
74.6%
。该策略随后直接迁移至 Unitree G1 真机,并成功运输咖啡杯、装水酒杯、医疗器械以及食品容器等不同物体。
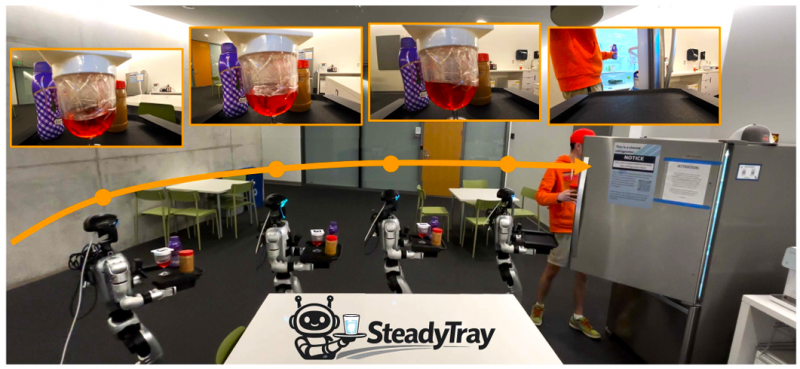
SteadyTray 的难点在于,机器人和物体之间并不存在直接刚性连接。机械臂控制的是托盘,而托盘上的物体只能依靠重力和摩擦被动保持位置。这形成了明显的目标冲突:为了稳定走路,机器人需要自然摆动身体并完成动态步态;为了稳住物体,机器人又希望托盘尽可能保持水平、低加速度和低角速度。如果直接把两个目标同时塞进一个端到端强化学习策略,模型很容易优先学会“走路”,却没有真正解决物体稳定问题。ReST-RL 因此首先训练一个 ba
se Policy,让机器人在端着托盘的情况下保持可靠行走。基础策略使用
5
步本体历史信息,根据线速度和角速度命令输出全身关节目标。随后,基础策略被冻结,只训练额外的 Residual Module。这个残差模块不需要重新学习走路,而是专门根据机器人、托盘和物体的动态状态,计算用于稳定物体的修正动作。
研究人员设计了两种残差实现方式。第一种是 Residual Action Adapter。基础策略首先给出正常行走动作,Adapter 再额外输出一个较小的修正动作,两者叠加后形成最终关节控制指令。换句话说,机器人依旧按照原来的策略行走,只是在必要时增加一些身体、腰部、手臂或腿部修正,以抵消托盘振动。第二种是 Residual FiLM Adapter。它并不直接修改最终动作,而是通过
FiLM
机制调节基础策略内部网络特征,让物体状态以条件信息的方式影响原始控制策略。两种方法都从“零修正”开始,因此训练初期完全继承基础策略的稳定步态,之后再逐渐学习物体稳定所需要的全身补偿动作。
ReST-RL 还有一个重要设计:训练时可以使用真实部署阶段无法直接获得的 privileged observations,例如托盘姿态、物体速度、物体角速度以及物体相对于托盘的位置。这些信息帮助 Teacher Encoder 学习一个描述系统稳定状态的潜在表示。但真正部署机器人时,并不能依赖仿真中的完整真值,因此研究人员进一步进行 Student-Teacher 蒸馏。Student Encoder 只使用机器人本体信息、速度目标以及相机获得的物体位置和姿态,去逼近 Teacher Encoder 的潜在特征。Residual Adapter 在这个过程中保持冻结,使学生最终学会利用可部署传感信息产生与教师相近的稳定动作。
在训练过程中,ReST-RL 还专门加入了物理参数随机化、控制延迟、观测噪声和物体感知延迟。机器人摩擦、托盘摩擦、物体质量、物体尺寸、质心位置以及
恢复系数
等参数都会随机变化。训练时还会直接向机器人或托盘物体施加随机外力,让策略提前学习在突发扰动后如何恢复平衡。尤其值得注意的是,论文并没有假设视觉系统可以实时、无延迟地提供物体状态。针对物体相关信息,训练阶段会主动加入 observation delay,让策略适应真实视觉检测中不可避免的延迟。
实验首先比较了 ba
se Policy、End2End 和不同版本 ReST-RL。在正常 Command Track 任务中,基础策略只有
47.4%
的成功率。虽然 End2End 提升到了
89.1%
,但 ReST-RL 进一步达到更高水平,其中 FiLM WB 版本成功率达到
96.9%
。差距在外界扰动下更加明显。当外力直接作用到机器人身体时,ba
se Policy 成功率只有
9.1%
,End2End 为
44.0%
,而 ReST-RL FiLM WB 达到
84.6%
。当外力直接作用于托盘物体时,基础策略成功率为
25.2%
,End2End 为
50.2%
,而 ReST-RL FiLM WB 达到
74.6%
。这说明单纯端到端联合优化虽然可以学习一定稳定能力,但在强扰动环境下,专门负责物体稳定的残差策略明显更加可靠。
为什么 End2End 表现会更差?训练奖励曲线给出了一个很直观的解释。End2End 的总奖励并不一定明显低于 ReST-RL,但其中大量奖励来自“机器人能够正常行走”。真正反映物体是否保持竖直的 Object Upright Reward 却明显较低。也就是说,一个端到端策略可能找到一条“捷径”:先把走路任务做好,就已经可以获得大量奖励,但并没有真正学会如何精细地稳定托盘物体。ReST-RL 则把稳定问题交给独立残差模块,迫使新增学习能力集中在物体稳定上。
感知延迟实验同样说明了训练设计的重要性。当物体观测延迟为
0 s
时,使用延迟训练的策略成功率达到
90.2%
,而没有加入延迟训练的策略为
78.4%
。当延迟增加到
0.06 s
时,两者分别为
78.3%
和
55.2%
。这意味着主动模拟视觉延迟不仅能够改善 sim-to-real,在没有实际延迟的情况下也会提升策略整体鲁棒性。
在动态速度命令和外力作用下,ReST-RL 仍然能够让机器人身体速度快速跟随目标,同时保持托盘物体速度与机器人运动同步。当机器人本体或托盘物体受到突发外力后,速度偏差能够较快恢复,并没有产生持续振荡。
论文进一步测试了不同方向和不同强度的外力。面对作用于机器人身体的推力,ReST-RL 在不同方向与幅值组合下的整体成功率约为
74.4%
;面对直接作用于托盘物体的推力,整体成功率约为
73.9%
。即使外力方向不断变化,策略仍然能够根据扰动主动调整上半身和下半身,从而重新稳定托盘。
托盘上的物体也不需要固定成某一种尺寸。实验随机改变圆柱物体的半径和高度比例。对于多数物体尺度,成功率都能够保持在
86%
至
98%
左右;对于极端细长物体,成功率才出现较明显下降。这说明 ReST-RL 学到的并不是针对某一个固定圆柱体的控制动作,而是具备一定的几何泛化能力。
最终,研究人员将策略零样本部署到
29-DoF
Unitree G1 真机。在真实实验中,机器人会遭遇两种直接干扰:研究人员可以直接踢机器人身体,也可以直接推动托盘上的物体。面对这些突然扰动,机器人并不是僵硬地保持双手不动,而是协调腿部、腰部和上肢执行全身恢复动作,同时尽可能保持托盘水平。更直观的是,ReST-RL 不只能够运输训练中的规则圆柱体。真机实验还测试了咖啡杯、装有液体的酒杯、医疗和手术工具以及密封食品容器。不同物体在质量分布、形状和接触属性上都存在明显差异,但策略无需重新训练或微调即可完成运输。
总结
SteadyTray 将一个很常见却长期困难的
服务机器人
任务转化为明确的双手移动操作问题:人形机器人如何一边走路,一边稳定没有固定在托盘上的物体。ReST-RL 的核心思路并不是重新训练一个更复杂的全身控制器,而是在可靠步态策略上增加专门负责负载稳定的残差模块,将“走稳”和“端稳”两个目标解耦。实验表明,这种结构在外界推力、视觉延迟和不同负载条件下都比直接端到端训练更加稳定,并能够零样本迁移到 Unitree G1 真机。这项工作也说明,人形机器人未来进入送餐、医疗配送和服务场景后,真正重要的不只是“能把东西拿起来”,还需要在动态行走过程中主动管理物体的稳定性。


