
 五度妙笔
 企业透视镜
 API商城

 数据库
赛事夺冠背后:国产类脑芯片,正在打通从实验室到产业的闭环
2026
年,第
34
届
ACM
国际多媒体会议(
ACM MM 2026
)
Egol
ink
挑战赛上,中科(深圳)无线半导体有限公司联合广西大学团队,凭借类脑跨模态融合认知技术从全球顶尖高校与科技企业中脱颖而出,夺得赛事冠军。
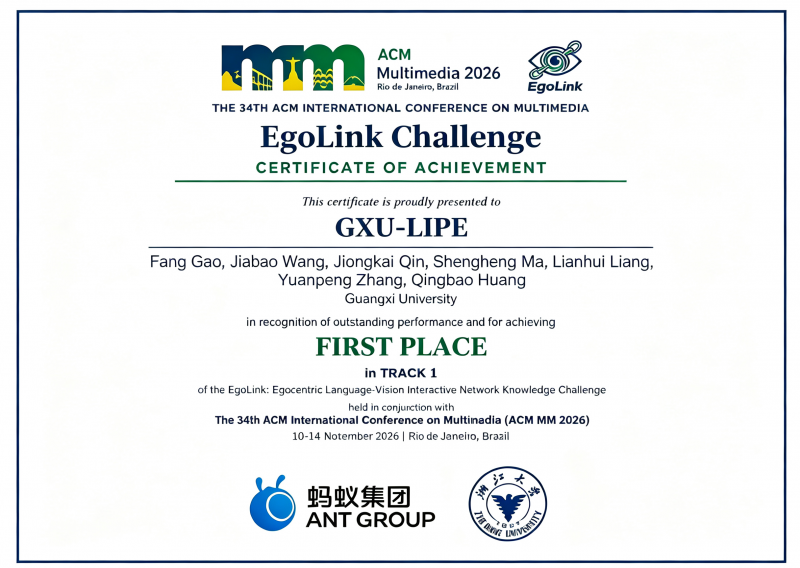
这不仅是一次学术竞赛的胜利,更揭示了
机器人
从
“
感知
”迈向“
认知
”
的一条关键技术路径
——
分布式类脑架构
。
当行业仍在争论
“大模型应当上云还是做端侧部署”时,
中科无线半导体团队
已经通过
一套
“
IDPU
小脑分布式
+
低算力
GPU
协同方案
”
给出了自己的答案:原本需要旗舰级
GPU
才能跑通的多模态大模型,
如今可由一颗中低算力
GPU
,
协同机器人端侧
的
多颗
IDPU
专用小脑芯片
完成
分布式
部署
计算
。
01
.
这场冠军,
为什么值得机器人行业关注?
ACM MM 由美国计算机学会主办,是计算机视觉与多媒体处理领域的全球顶级学术会议。
本届
Egol
ink 挑战赛由蚂蚁集团和浙江大学联合发起
,吸引了全球众多顶尖高校与科技企业同台竞技,代表着当下人工智能
视频
社交、环境事件认知推理领域的最高竞技水平。
对机器人产业而言,
Egol
ink
挑战的核心命题直指
具身智能
的痛点:机器人不能只“
看见画面、听见声音”
,还需要理解场景背后的社交关系、情绪因果与事件逻辑。这正是当前物理认知大模型落地端侧的关键瓶颈,也是衡量一台机器人是否真正“
智能”
的分水岭。
中科无线
团队的夺冠,意味着中国企业在这一前沿赛道上已经具备了与全球顶尖力量正面竞争的实力。
02
.
“大脑”
管认知:
IDPU
重构多模态融合
夺冠方案的核心是一套“
芯片
+
平台
+
传感
+
工具链”
的端侧一体化技术栈。
本次参赛方案依托
CT-Unite RMCS V1.0
机器人多模态认知开发
插件架构
,结合
CT-2001A IDPU
分布式低时延类脑
神经网络加速
架构,对
CT-HS01 4D
光谱传感器采集的事件、视觉、深度、音频多源信息完成跨模态精准对齐,打通视觉感知、环境理解、语言解析与动作交互全链路。
该方案突破了机器人单一传感器独立处理数据的传统模式。
IDPU
作为“
大脑”
,使机器人不再局限于“
看见画面、听见声音”
的基础感知,而是能够推理场景背后的社交关系、情绪因果与事件逻辑,真正实现类人化认知能力。
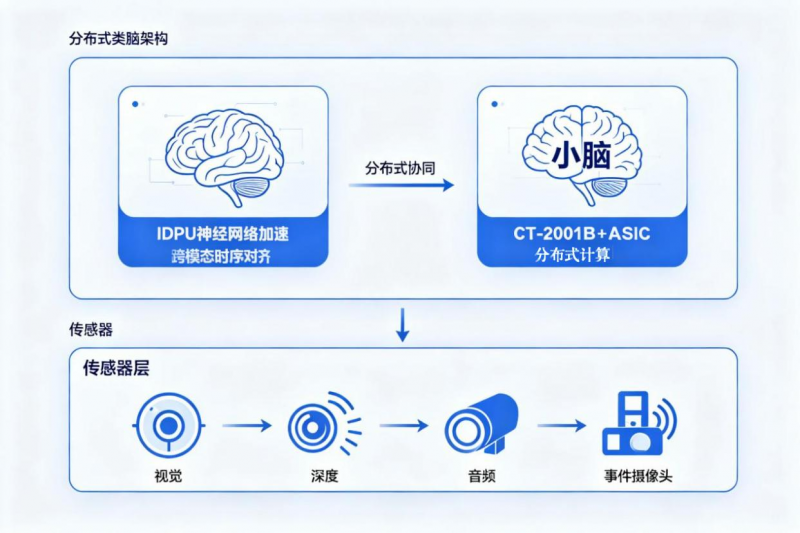
图
1
:中科无线分布式类脑架构
——IDPU
神经网络加速、时序对齐
,
CT-2001A + BSIC
负责
分布式计算,
传感器层提供多源输入
03
.
“
小脑”
管运动:
从单芯片到关节级分布式网络
如果说在
GPU
上运行的
语言大模型是机器人的
“大脑”,
那么
IDPU
专用芯片则承担
着
机器人
“
小脑
”
的
多模态
认知决策
、
神经网络加速,以及低时延感知、运动控制与驱控一体化任务。
更关键的是,
IDPU
架构支持将机器人各个关节的控制芯片组
成为
局域计算网络,
依靠
分布在每个关节控制芯片中的
IDPU
单元
完成
分布式实时加速运算。
算力不再集中于
“大脑”,而是如同人类神经系统一般,由“
大脑
”
负责认知决策,
“小脑”和“神经末梢”负责实时运动控制,实现
分层协同、就近计算。
这种架构很像章鱼的神经系统
——IDPU
作为中枢小脑,连接多颗
CT-2001A
分布式计算节点,形成类脑式神经中枢。章鱼三分之二的神经元分布在八条触手中,每条触手都能独立感知、决策和运动,无需大脑逐一指令;中科无线的分布式架构同理,每个关节的
CT-2001A
节点就近处理运动控制,
IDPU
则负责整体协调与认知决策,分层协同、反应迅捷。
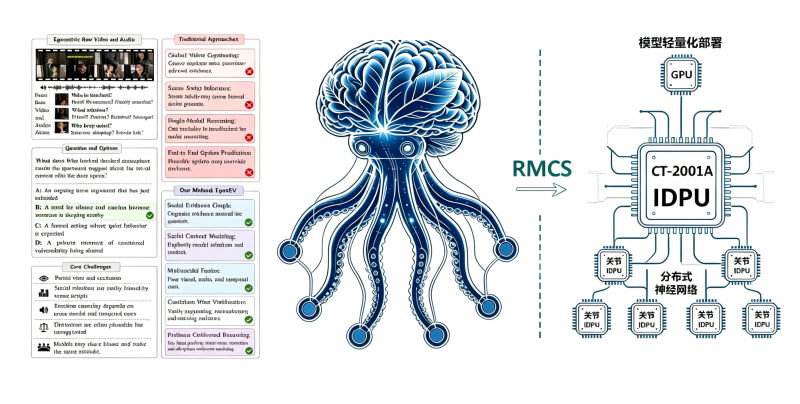
图
2
:章鱼分布式神经系统与中科无线
IDPU + CT-2001A
类脑架构类比示意
中科无线深耕机器人专用芯片与
类脑处理器
研发,核心产品覆盖
IDPU
类脑推理芯片、
CT-2001A/B
系列机器人小脑
ASIC
、驱控一体化芯片,已与国内
40
余家机器人企业达成合作。本次参赛中,团队基于
IDPU
芯片与
RMCS V1.0
软硬件开发平台,完成多模态认知模型训练调优、知识推理策略迭代,实现了类脑跨模态加速与认知技术的工程验证。从实验室算法到芯片端侧落地,这条路径已经跑通。
04
.
算力降维与端侧自治:
100TFLOPS
到
38.8TFLOPS
的背后
依托
IDPU 端侧分布式计算架构的算力优化,团队将
将原
100TFLOPS支撑的云端模型降至38.8TFLOPS在端侧部署
。这一降维的关键,
正是“
IDPU 小脑分布式 + 低算力 GPU 协同”——认知推理由 GPU 承担,
多模态算法融合、时序对齐
与实时加速由分布在各关节的
IDPU 单元就近完成,两者分工协作,避免了单一芯片既要认知又要
推理
的算力瓶颈。
这种分布式架构带来的不仅是算力效率,更是真正的端侧自治。摆脱对云端通信的依赖后,机器人延迟更低、隐私性更好,即便在网络不稳定或完全离线的环境下也能稳定工作。对工业、服务、特种机器人等场景而言,
这意味着具身智能从“
必须联网”
走向“
端侧自主”
。
05
.
产业意义:
中国类脑芯片跻身国际第一梯队
本次斩获
ACM MM
全球赛事冠军,充分印证了我国类脑芯片与多模态融合认知技术,在具身智能物理感知领域已跻身国际第一梯队。
同时,这也是对
RMCS V1.0“
芯片
+
平台
+
传感
+
工具链”
端侧一体化技术路线的权威验证。后续团队
表示
将持续迭代
IDPU
芯片硬件、升级
RMCS
开发平台,联动科研院所与产业链上下游伙伴,共同推动国内机器人类脑芯片产业走向全球市场。
在具身智能从“
大模型驱动”
向“
端侧协同”
演进的关键节点,中科无线给出的答案清晰而务实:让大脑专注
推理
,让小脑掌控认知
、
运动,用分布式类脑架构把
类脑
智能真正装进机器人的身体里。


