
 五度妙笔
 企业透视镜
 API商城

 数据库
上海AI独角兽,开源具身端侧推理引擎,延迟降至26ms
机器人前瞻(公众号:robot_pro)
作者 | 刘俐杉
编辑 | 许丽思
机器人前瞻9月15日报道,今天,无问芯穹联合清华、上交正式开源具身端侧推理引擎APXInf。
如今的具身模型已经能够看懂环境、理解指令,并把看到的、听到的信息转化为机器人该怎么做的决策。
但当一个在云端运行良好的具身模型,放到机器人本体上,让它落地干活时,“模型够不够聪明”已经不是首先要面对的问题,推理系统才是让具身智能规模化落地的关键。
此次开源的具身端侧推理引擎APXInf,不仅能够让具身模型在真实机器人上能够“跑起来”,更希望可以
在有限资源下“跑得够快、够稳,也足够容易接入拓展和持续迭代”。
APXInf支持RTX 4090、Jetson Orin、Jetson Thor等主流计算平台,覆盖从模型开发、效果验证到机器人本体部署的完整链路。
同时在Jetson Thor上,该推理引擎让PI 0.5 FP8实现端到端推理延迟
从278ms降低至26ms
以内;在 FP8下达到
46Hz推理频率
,满足机器人多场景下实时控制对推理频率和响应延迟的要求。
开源地址:
GitHub:
Quick Start:https://github.com/RLinf/APXinf-robo#quick-start
一、推理延迟从278ms降至26ms以内
APXInf的第一个核心能力是,
围绕机器人真实执行链路进行端到端优化
,让机器人从“看到”到“动起来”的整条执行链路变快。
APXInf通过
Pipeline、Graph、Kerne
l
及量化
等多层优化,降低具身模型端到端推理延迟。同时,通过冗余特性的系统设计,为模型提供定制化运行时,在更加轻量化的同时将性能挖掘到极致,并借助Agent4Kernel技术进行极限优化的融合算子,最终达到性能SOTA。
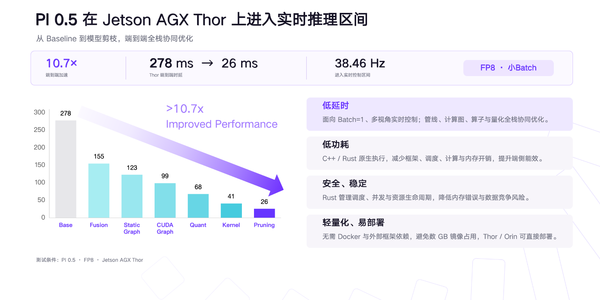
▲PI 0.5在Jetson AGX Thor 上进入实时推理区间
在 Thor 上,APXInf将PI 0.5 FP8的端到端推理延迟
从278ms降至26ms以内
,频率可达
38.46Hz,
为机器人实时感知与控制提供更充足的响应空间。
10.7倍的推理延迟下降,对机器人而言,意味着更快的“感知-决策-动作”闭环,也意味着
具身模型有机会在真实机器人上进入更加实时的工作状态。
二、
让推理行为在真实部署中可预测、不中断
第二个核心能力,“更稳”。在机器人端侧推理中,并不是“一次跑通”就结束了。APXInf强调在长时间运行、感知、推理、控制等多个模块同时运行的真实部署环境中,行为可预测,能够持续稳定运行的能力。
那么它是如何做到的?
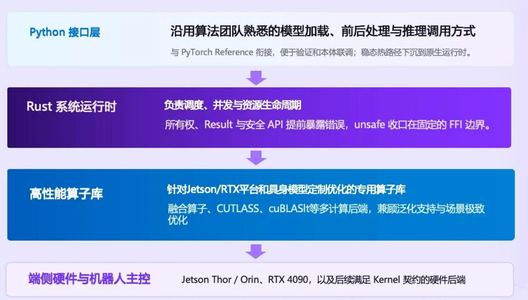
▲创新架构
研究团队采用了创新架构,使用Rust系统语言构建的极简运行时,和Python易用接口。
首先,APXInf利用冗余特性设计,打造极简化运行时,降低运行开销的同时做到可核查、可验证。
其次,利用Rust语言提供的内存安全特性,进一步提升引擎稳定性、降低易错面,从源头规避内存风险,减少运行中崩溃、异常的概率。
最后,通过Python接口封装,保留开发者熟悉的调用方式,兼顾底层硬核与上层易用。
三、利用Agentic Engineering,降低接入与优化成本
解决了“跑得够不够快”和“能否稳定运行”的问题后,APXInf面临的第三个问题是,面对越来越多的具身模型和具身系统,模型怎么更快、更敏捷地接入,并且持续优化?
伴随着大模型能力的提升,推理引擎利用Agentic Engineering,可以快速实现新模型的适配与接入。关键是,这一能力可以加速APXInf的研发迭代,还会开放给APXInf的开发者,让用户自研模型的接入与优化变得简单和敏捷。
所以,从设计之初,APXInf就是面向
Agentic Engineering研发流程
来设计的。
通过
冗余特性、功能隔离、工具箱模型
等方法,显著提升APXInf与Agentic Engineering的适配度,降低研发门槛,使得Token可以更便利高效地转化为生产力。
无问芯穹称,
APXInf也将面向Agentic Native进行探索和迭代,
并探索一种全新的面向Agentic Engineering时代的推理系统构建范式。
结语:补上
具身智能规模化落地的关键一环
APXInf这次开源,首发支持PI 0.5、WALL-OSS,覆盖Jetson Orin、Jetson Thor和RTX 4090,并给出从VLA、VLM、世界模型到国产芯片、国产机器人操作系统、AMD等方向的Roadmap。
同时,APXInf作为
RLinf开源生态中的端侧推理项目首发,
把模型训练、效果验证,到本体部署与真实机器人运行连成一条完整链路,补上了具身智能规模化落地的关键一环
。
但具体能否规模化落地,还需要看到真正的实践:在不同机器人本体上能否长期稳定地“跑”,在真实场景中能否扛住延迟、轨迹抖动、算力和内存的消耗。这些问题答案都只能在物理世界中才可得到。


