五度妙笔
 企业透视镜
 API商城

 数据库
光量子计算:原理、架构与技术演进
光量子计算以光子或量子光场作为信息载体。与依赖静态寄存器的经典计算机不同,光子在传播、干涉和测量的过程中完成信息处理:量子光源制备所需状态,集成光路通过分束、移相和调制改变光学模式,探测器将量子结果转化为经典信号,实时电子学再根据测量结果执行前馈、纠错和控制。
因而,一台光量子计算机并不是一块孤立的量子芯片,而是由光源、复用与同步、可编程光路、低损耗互连、探测、低温系统以及经典控制共同构成的复杂计算系统。
光子几乎不带电,与环境的非期望相互作用较弱,能够在光纤和波导中高速传输,并天然适合构建分布式、模块化系统;但由于相互作用弱,两个独立光子很难像超导量子比特或离子那样直接形成强耦合。如何在易传输和难相互作用之间取得平衡,是理解光量子计算技术路线的关键。
光量子计算的基本原理:量子信息编码与逻辑运算
(一)量子信息编码:离散变量与连续变量
从信息表示方式看,光量子计算主要采用离散变量和连续变量两类编码。离散变量方案将量子信息编码在两个彼此正交的光学状态中。最常见的双轨路径编码用光子位于两条波导中的哪一条分别表示逻辑0和逻辑1,两条路径概率振幅的相干叠加对应一般量子态;偏振编码以水平、垂直偏振为逻辑基;时间箱编码以早到、晚到两个时隙表示信息;频率箱编码则利用不同频率模式。
不同编码各有适用场景,实际系统可以在模块之间进行转换,例如芯片内部使用路径编码,模块互连时转换为更适合光纤传输的时间箱编码。
连续变量编码不再把信息限制在两个离散基态中,而是利用光场两个正交场象限的连续取值承载量子信息。其核心资源之一是压缩光:一个场象限的量子噪声被压低到真空散粒噪声以下,同时另一个象限的噪声相应增加。分束、移相、压缩和零差探测可以对这些连续变量进行制备、变换和读取。与离散变量不同,连续变量系统的基本信息单元是光学模式而不是单个0/1量子比特。
(二)量子逻辑实现:线性光学干涉与测量诱导纠缠
在线性光学网络中,分束器负责耦合不同光学模式,相移器负责调节相对相位。对于双轨量子比特,两者组合即可实现任意单量子比特酉变换;更大规模的线性变换则可以分解为大量两模式耦合与相位调节,并由级联的马赫—曾德尔干涉仪实现。量子编译器的作用,是把抽象线路或目标变换转换为各个干涉单元的分束比、相位、电压和时序参数,使算法能够映射到具体光子芯片。
真正困难的是双量子比特纠缠。两个完全不可区分的单光子同时进入对称分束器时,会出现Hong–Ou–Mandel干涉:由于量子概率振幅发生相消,两个光子倾向于从同一输出端离开。线性光学利用这种多光子干涉,再配合辅助光子、光子数探测和经典前馈,可以获得有效的纠缠操作。
KLM方案进一步证明,即使没有强光子—光子非线性,只要引入辅助资源、条件测量和前馈,线性光学原则上仍可实现通用量子计算。代价是许多纠缠操作具有概率性,需要复用、资源态和量子纠错来吸收失败。
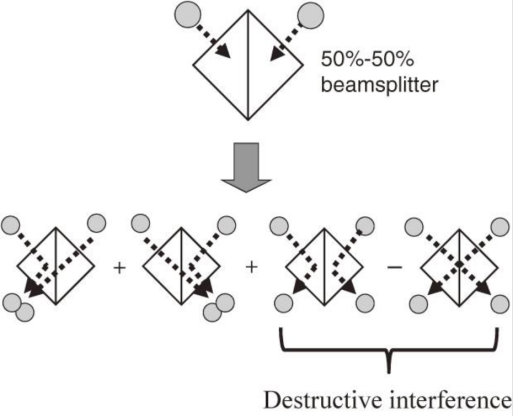
图 Hong–Ou–Mandel双光子干涉示意图
光量子计算机的运行流程:从量子态制备到结果读出
(一)计算输入环节:量子态制备、复用与同步
系统硬件的起点是量子光源。离散变量平台需要高纯度、高不可区分性并按时钟到达的单光子。自发参量下转换和自发四波混频可以成对产生光子,通过探测其中一个先导光子预告另一个光子的存在,但其本质上具有概率性,泵浦过强还会增加多光子污染,因此通常需要并行光源、快速开关和延迟线进行空间或时间复用。
量子点等固态发射体能够在脉冲激发下接近按需发射单光子,可降低复用压力,但仍要解决低温运行、频率漂移、器件一致性和耦合效率。连续变量平台则以压缩光为主要资源,并通过时间或频率复用形成多模式量子态。
(二)计算执行环节:可编程光路与模式变换
光源之后是模式匹配、同步和可编程操控。多光子干涉要求参与干涉的光子在频谱、到达时间、偏振和空间波形上高度不可区分,因此滤波器、脉冲整形器、延迟线和相位锁定装置需要持续校准。
完成模式整理后,光子进入由分束器和可调相移器构成的可编程干涉网络。热光相移器制造成熟但速度较慢,电光相移器响应更快,更适合逐时钟槽动态调节。实际系统往往采用异质或混合集成,由不同材料分别承担低损耗路由、高速调制、量子光源和探测等功能,再通过低损耗封装与光纤互连形成整机。
(三) 计算输出环节:探测、实时前馈与统计处理
探测器不是计算末端的被动读出器件,而是计算闭环的一部分。离散变量平台使用单光子或光子数分辨探测器,连续变量平台主要使用零差探测;测量结果会实时决定后续测量基、传播路径或纠错帧。由于光子无法长时间停留等待,光纤或片上延迟线必须为经典前馈和译码争取时间。
单次运行通常只得到一个随机样本,设备需要多次重复,经典软件再从统计分布中提取期望值、能量、相关函数或采样结果。高性能单光子探测通常依赖超导纳米线器件并在低温环境中运行;如果协议还需要区分一个、两个或更多光子,则要进一步使用光子数分辨探测。探测效率、复位时间和时间抖动都会限制系统时钟和前馈速度。
通用光量子计算的技术架构:离散变量与连续变量路线
(一) 离散变量计算架构:门模型、测量型与融合式计算
从计算架构看,离散变量光量子计算主要形成门模型、测量型和融合式三类思路。门模型最接近传统量子线路:单量子比特门由线性光学元件确定性实现,而双量子比特纠缠门通常依赖辅助光子、条件探测和前馈,因此具有概率性,线路越深,资源态和复用开销越高。
测量型量子计算则把复杂性前移到纠缠资源态制备:系统先生成具有特定图结构的簇态,再通过依次测量节点推进算法;测量基决定逻辑操作,早期测量产生的随机结果通过调整后续测量基或更新经典Pauli帧处理。
融合式量子计算可以看作对测量型架构的进一步工程化:系统不必预先制备完整的巨型簇态,而是持续生成小型、固定尺寸的纠缠资源态,再通过破坏性的融合测量将其连接成更大的计算网络。融合失败和光子丢失被纳入统一的拓扑纠错框架,算法则通过融合测量的位置和测量基写入网络。由于资源态发生器、融合器件、延迟线和实时译码可以设计成重复模块,这一架构尤其适合光子持续传播、边生成边测量的流动式计算方式。
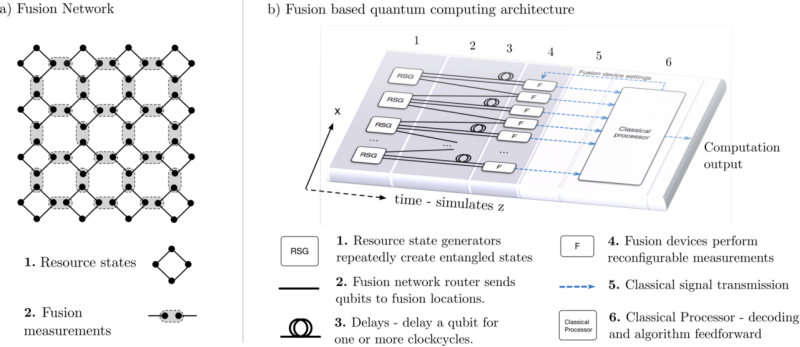
图 融合网络与融合式光量子计算架构
(二)连续变量计算架构:簇态计算、非高斯资源与GKP编码
连续变量架构通常以压缩光、多模式簇态和零差测量为基础。时间复用能够让连续脉冲在较少的物理光路中形成规模很大的时域纠缠资源,高斯操作也较容易以确定性方式实现。其核心难点在于有限压缩会引入持续累积的加性噪声,而仅依赖高斯态、操作和测量并不足以获得通用量子计算能力。
为此,需要引入GKP编码、光子数测量、猫态等非高斯资源,并把非Clifford操作和低损耗量子纠错纳入架构。GKP编码通过在振子相空间中构造离散网格结构,把连续变量噪声转化为可纠正的位移错误,是当前连续变量容错路线的重要方向。
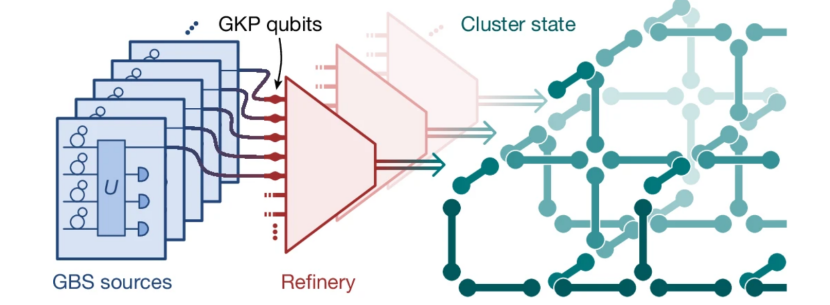
图 GKP资源态制备与簇态构建的三阶段流程
光量子计算规模化的关键挑战:损耗、集成与容错
(一)端到端损耗与误差累积:大规模系统的首要约束
光子从产生到被探测要经过耦合、开关、波导、芯片互连和延迟等多个环节,各环节效率以乘法方式累积;一旦逻辑操作要求多枚光子同时到达,有效事件率还要乘上多光子的联合存活概率。因此,单个器件上看似很小的插入损耗,放到大规模系统中可能造成数量级的性能下降。评价系统不能只看成功事件中的条件保真度,还要同时考察端到端效率、无条件成功率和单位时间有效计算事件数。
对双轨编码而言,完全丢失往往表现为两个轨道都没有计数,错误位置可以被标记为“擦除”,理论上比位置未知的Pauli错误更易译码,但如果丢失与探测错误、门失败和错误资源态混合出现,错误标记也会变得不可靠。连续变量系统还需要面对有限压缩引入的连续噪声。因此,真正有意义的指标应来自端到端、跨模块联合测量,而不是单个器件的最佳实验值。
(二)集成、复用与实时纠错:实现容错计算的工程条件
规模化不是简单扩大单一芯片,而是把光源、低损耗传输、高速调制、探测和封装纳入同一制造体系。目前没有一种材料能够同时在低损耗、强非线性、高速调制、确定性发光、高效率探测和大规模制造上占优,因此,异质集成、模块化封装以及光学—电学—低温协同设计,正在成为更现实的系统工程路线。
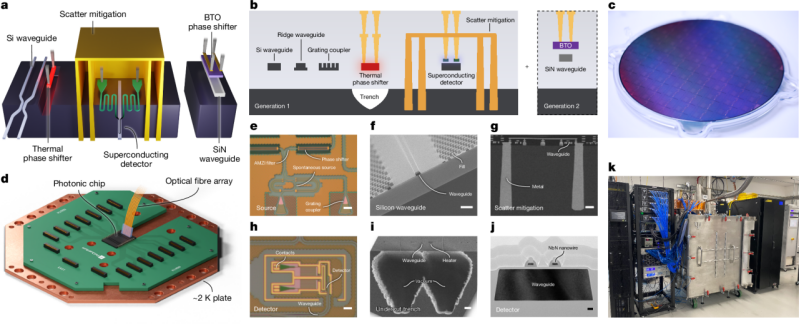
图 可制造集成量子光子技术栈及关键器件
复用、实时控制与量子纠错也必须协同设计。并行光源越多,至少获得一个成功资源的概率越高,但额外开关、延迟线和互连同时增加损耗;时间复用和频率复用能够提高模式密度,却要求系统在大量时钟槽和频率通道间保持稳定相位,并提供足够快的调制、探测和译码。
对于容错计算,误差阈值、资源态规模、融合或门操作成功率、探测效率以及经典译码延迟是相互耦合的。理论上跨过阈值,只意味着在既定噪声模型下扩大编码可能继续降低逻辑错误率;只有当物理损耗、实时前馈和译码吞吐量同时满足要求,容错架构才具备工程可实现性。
光量子计算的发展阶段:从量子优势验证到模块化系统
(一) 专用量子优势向可编程计算演进
早期代表性成果主要集中在玻色采样。2020年的“九章”和2022年的Borealis分别展示了大规模高斯玻色采样和可编程时间复用采样,证明光源、干涉、复用和探测能够在特定任务上形成整体能力,但玻色采样仍是专用问题,不能直接等同于通用量子计算。2024年的Ascella将量子点单光子源与可编程干涉仪结合,同时演示门模型操作、分子能级计算和玻色采样,显示光子平台开始从单一采样任务转向多任务可编程处理。
这类实验的重要价值在于验证一整条光学链路的协同工作,而不是简单用模式数代替可执行通用算法的量子比特数。
(二)模块化、可制造与非高斯能力加速集成
2025年的Aurora是模块化系统工程的代表性探索。它由多块光子芯片、压缩器和光子数分辨探测器组成,连续生成跨芯片、跨时间的时域簇态,并演示实时译码和单时钟周期前馈,体现了模块化系统集成能力。
同一时期,可制造性和非高斯能力也在加速推进。PsiQuantum团队在商业300毫米硅光工艺上系统展示光子产生、操控、探测、独立光源干涉、融合以及芯片间互连,把关键量子光子器件与成熟半导体制造流程联系起来。
连续变量方向则在补齐通用与容错所需的非高斯资源:2025年的集成实验在1550纳米氮化硅芯片上生成具有相空间网格结构的GKP近似态;2026年Clavina平台进一步把可编程线性光学网络与可寻址压缩、Kerr类非线性模块结合,展示完整物理通用门集、近确定性GKP态生成和Bose–Hubbard模型模拟。
这些进展说明研究重点正在从单一器件纪录转向可制造、多模块协同的系统能力,但物理层具备通用操作仍不等同于实现大规模逻辑容错计算。
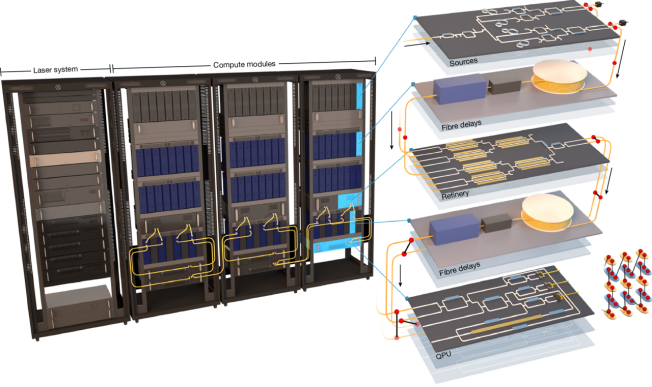
图 Aurora模块化光量子计算系统及主要模块
总结与展望
总体来看,光量子计算正从原理验证和专用量子采样向可编程、模块化、可制造的计算系统演进。离散变量与连续变量路线仍将并行推进,但发展重点已从刷新光子数、模式数和单器件性能,逐步转向降低端到端损耗、提高资源态制备与探测效率、实现高速前馈和逻辑纠错,并验证系统长期稳定运行能力。
未来,光量子计算将进一步呈现集成化、模块化和容错化趋势。异质集成与先进封装将推动光源、调制、探测和经典控制形成更标准化的技术模块,光纤互连以及时间、频率复用将支撑跨芯片扩展,评价重点也将转向逻辑量子比特、逻辑错误率、有效计算速率和系统成本。
能否在可制造硬件上跨越容错阈值,并随编码规模扩大持续降低逻辑错误率,将是光量子计算由实验原型走向通用计算系统的关键。
[2]https://doi.org/10.1038/s41586-025-08820-7
[3]https://doi.org/10.1038/s41586-024-08406-9
[4]https://pmc.ncbi.nlm.nih.gov/articles/PMC4880548/
[5]https://www.nature.com/articles/s41586-025-09044-5/