五度妙笔
 企业透视镜
 API商城

 数据库
Science重磅!中性原子量子计算硬伤被攻克,实现毫秒级连续重载

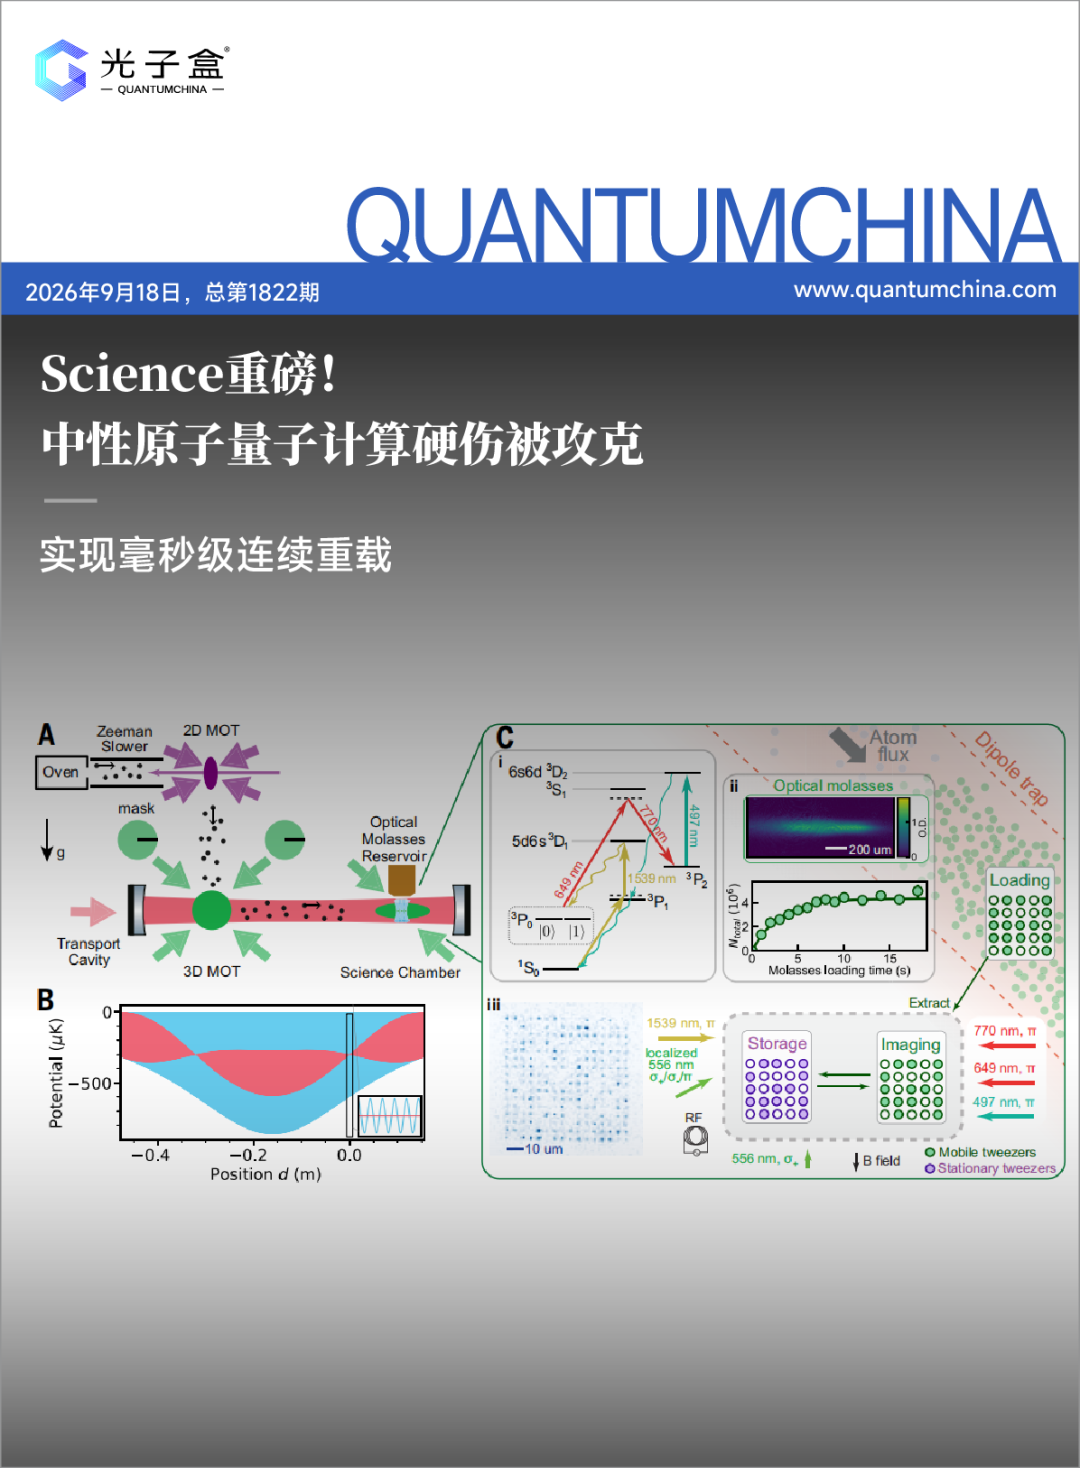
近两年,中性原子量子计算一路高歌猛进。国内外团队已经完成千比特级阵列搭建、逻辑量子比特原型验证、量子纠错代码原理演示等一系列成果进展。
但是,中性原子有一个硬伤是原子丢失。如果原子丢了就要停,停了就要重新装,而且重新装一次的时间,比做一次门操作和测量加起来还要长一个数量级。一句话概括就是,量子计算机跑着跑着就得“停机检修”,深度电路根本没办法跑起来。
2026年9月17日,普林斯顿Jeff D. Thompson团队在《Science》期刊上发表题为“Fast,continuous,and coherent atom reloading in a neutral-atom qubit array”(中性原子量子比特阵列中的快速、连续且相干的原子重载)的研究论文,演示了基于¹⁷¹Yb亚稳态核自旋量子比特的高速、连续、电路中段相干原子重载技术,把原子装载耗时从百毫秒级别压缩至毫秒量级,比此前最先进水平快了近两个数量级。
研究团队在计算区旁的持续装载原子库可通过光镊按需每秒提取最多500个原子。在包含单原子制备、无损成像和初始化的条件下,可每秒初始化30个随机填充的量子比特阵列。不过,重载过程完全不会干扰正在参与计算的现有量子比特,为无限电路深度的容错中性原子处理器补齐关键一环。
原子丢失硬伤
现阶段的中性原子量子计算实验大多是局限在固定且有限数量的量子电路层级中。这样做的原因是,在一个计算周期内,随着量子门操作误差的累积、背景气体碰撞的发生、原子传输过程中的脱落,甚至是在执行破坏性量子比特读取时,最初制备好的原子阵列会不断出现“泄漏”和“丢失”。
在容错量子计算的逻辑中,只要我们能及时检测到这些错误并进行修复,泄漏和丢失其实是相对受欢迎的错误类型,因为它们所需的纠错开销要远低于未知的计算串扰。但问题在于,一旦原子丢失,我们就必须把新的原子重新补充进阵列。
过去科研人员已经尝试开发原子重载方案。早期双原子种类方案,可以在保护一类原子相干性的同时重载另一类原子,但完整装载时间达到90毫秒,比量子门、测量操作慢一个数量级以上,会拖慢整个计算周期。
还有部分工作实现了储库连续装载,但是无法保护原有量子比特的量子相干。另外一部分电路中段测量研究,只实现对现有原子的保护,并没有集成原子重载功能。
总之,此前的方案很难同时满足三个硬性条件:重载发生在量子电路执行中间、新原子装载速度匹配量子门的时间尺度、已经参与计算的量子比特的相干性不受重载相关冷却光、成像光扰动。这正是本次研究重点解决的问题。
把计算区和原子供应区分开
那么,普林斯顿团队究竟是如何做到既能高速重载新原子,又不破坏现有量子比特的呢?
研究团队的核心思路是,不再等阵列缺原子之后重新启动整套冷却和装载流程,而是在计算区旁边持续维持一个高密度冷原子储库。需要新原子时,移动光镊直接从储库中抓取,再送到成像区或计算区。原子供应、量子比特制备和已有量子比特操作由此成为可以并行执行的不同环节。
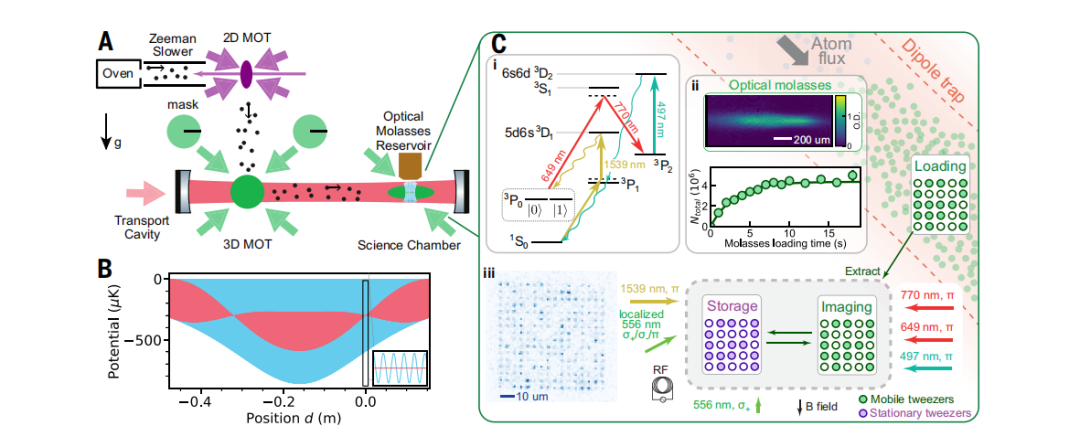
图:连续重载方案
实验选用¹⁷¹Yb,并将量子信息编码在6s6p ³P₀亚稳态的两个核自旋子能级中。这个选择有一个极大的物理优势,一旦原子被初始化到³P₀这个亚稳态,它对大部分用于基态¹S₀原子的冷却、光学泵浦和成像激光都是完全“免疫”的。
因此,当“工作区”的量子比特正在亚稳态安静地进行相干演化时,“装载区”完全可以用基态光对新提取的原子进行光辅助碰撞剥离和成像冷却,两者实现了完美的物理隔绝和频率隔绝。
持续供料的冷原子储库
实验装置首先在相邻真空腔内利用三维磁光阱产生冷原子,再通过带有真空内增强腔的光偶极阱,将原子输运35厘米至科学腔。多个频率分量共同驱动输运光阱,以抑制腔内驻波。到达科学腔后,原子由一维光学黏团减速和冷却,并在计算区附近形成持续补给的原子储库。
储库上叠加了一个16×16的二维移动光镊阵列,共256个位点。完成抓取后,振镜将原子移动约300微米至成像区,以避开储库原子的荧光背景。光镊装载速度与储库密度近似成正比,在最高密度下,装入一个或多个原子的特征时间缩短至0.84毫秒。
团队还以最高每秒500轮的频率执行“抓取并释放”。在每轮1毫秒装载的条件下,系统每秒可提取7.3万个原子,储库密度和装载概率均未下降。被光镊抓取的原子仅占到达储库原子通量的约4%,说明原子供应仍有扩展空间。
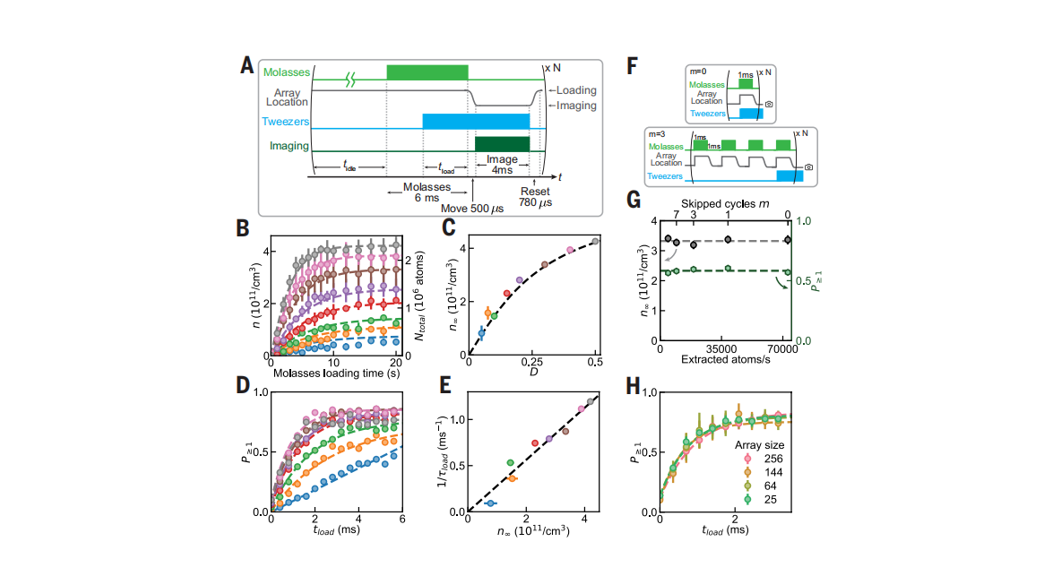
图:快速光镊装载
完成原子抓取后,还需要经过光辅助碰撞、无损成像、冷却和态初始化。当前的实验中,这些步骤分别需要数毫秒,合计占据超90%的循环时间。原子装载本身已经不再是最慢步骤。
重载没有打断已有量子比特
研究团队首先完成了可区分原子损失的无损自旋读出。系统依次把两个核自旋态转移到基态并采集两幅图像,从而把结果分为|0⟩态、|1⟩态和原子损失三类。
实测数据显示,制备在|0⟩态时,正确读出率是97.59%,误判到|1⟩态的概率只有0.57%,判定为损耗的概率是1.85%。制备在|1⟩态时,正确读出率是95.29%。不把损耗计入错误的话,读出保真度可以达到99.27%。
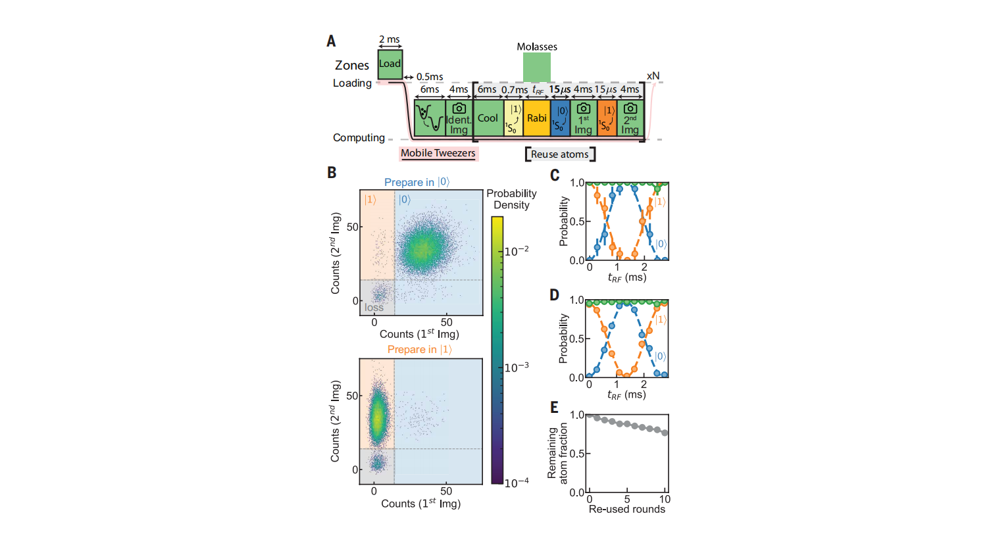
图:可区分损失的自旋读出
这个读出方案使得量子比特可以反复使用,每次初始化和测量循环中的原子损耗只有2.5%。
基于这套流程,系统能够每秒执行30轮新阵列的制备与测量。重复使用已完成无损读出的原子并跳过光辅助碰撞后,速率提高到每秒50轮。研究团队还在25个位点上获得一组拉比振荡数据,用时231毫秒,说明快速重复测量可以直接用于量子门标定。
不过,相干性测试是这项研究最有价值的部分。研究人员利用空间光调制器建立静止存储阵列,将一批量子比特转入其中;移动光镊随后返回储库,持续执行装载、光辅助碰撞、成像和初始化。与此同时,静止阵列中的³P₀量子比特继续接受相干操控。
结果显示,连续重载和无重载对照实验没有显著差别。量子比特寿命分别约为1.35秒和1.30秒,Ramsey退相干时间分别为0.73秒和0.69秒;Hahn回波结果也在实验误差范围内相容。连续拉比驱动没有出现额外衰减。
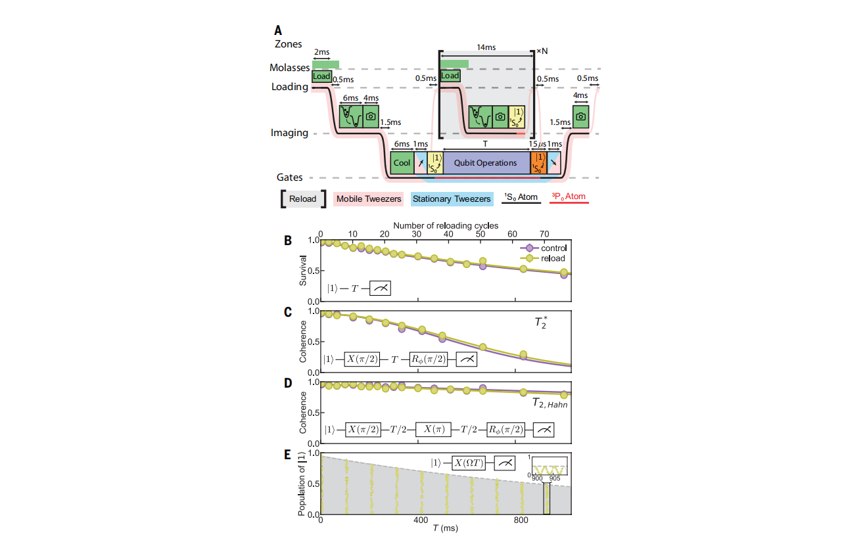
图:连续重载条件下³P₀核自旋量子比特的相干性
一次重载周期内,量子比特因自身寿命产生的衰减概率仍约为1%。但由于重载能够与量子门并行,这部分时间不一定转化为额外电路延迟。对系统架构来说,并行性比单独追求更短的装载数字更重要。
相关进展
事实上,这一方向在过去三年已经形成清晰的技术链。
2023年,不少科研团队分别在中性原子阵列中实现中途测量、能级搁置和分区操作,证明可以只测一部分原子而保护其余量子比特。
2025年,Atom Computing与微软等组成的科研团队在《Physical Review X》期刊上报告辅助量子比特的重复测量、复用和选择性替换,并将其用于重复码和逻辑态制备。系统能够识别丢失的辅助原子,从附近原子源补充,同时保持数据量子比特状态。
也是在2025年,哈佛大学、MIT和QuEra组成的团队在《Nature》上展示了一个可连续运行的3000原子系统。其双光晶格传送带每秒可向光镊装载约30万个原子,并制备超过3万个初始化量子比特。研究人员将3000多个原子的阵列维持了两小时以上,同时保存存储区量子比特的相干性。
不过,哈佛大学团队的工作与本次普林斯顿团队的侧重点并不相同。
3000原子实验解决的是大规模阵列的持续供给和长期维护,普林斯顿团队则把单次光镊装载压缩到1毫秒,并利用¹⁷¹Yb亚稳态核自旋量子比特展示重载与相干量子门并行。前者证明连续运行可以扩展到大规模系统,后者更接近纠错循环对低延迟和擦除偏置的要求。
此外,加州理工团队用光镊囚禁超6100个铯原子,把中性原子阵列规模推到新高度;中科大、复旦、中科院精测院等在无缺陷重排、光纤阵列架构、AI校准、百比特系统上也在快速跟进。
总体来看,这项工作为探索无限深度的容错量子电路建立了完整的基础。对于中性原子路线来说,这一进展分量不轻。
[1]https://www.science.org/doi/10.1126/science.adz9952
[2]https://www.nature.com/articles/s41586-025-09596-6
[3]https://journals.aps.org/prx/abstract/10.1103/v7ny-fg31