
 五度妙笔
 企业透视镜
 API商城

 数据库
OpenAI造“星际之门”、马斯克送算力“上天”,中国AI基建走出了一条什么路?
智东西(公众号:zhidxcom)
作者 | 王涵
编辑 | 漠影
AI行业的竞争重心,已经落到算力基建的比拼上。
2025年1月,OpenAI联合甲骨文、软银抛出
“星际之门”项目
,计划四年投入
5000亿美元
,在美国建成总功率
10吉瓦
的算力配套设施。
可仅仅
一年半
过去,项目推进过程并不顺利,不断暴露出融资、建设、电力配套等问题,像德州阿比林核心园区扩建叫停,项目负责人陆续离开,原本全额自建的方案也改成了租用算力。
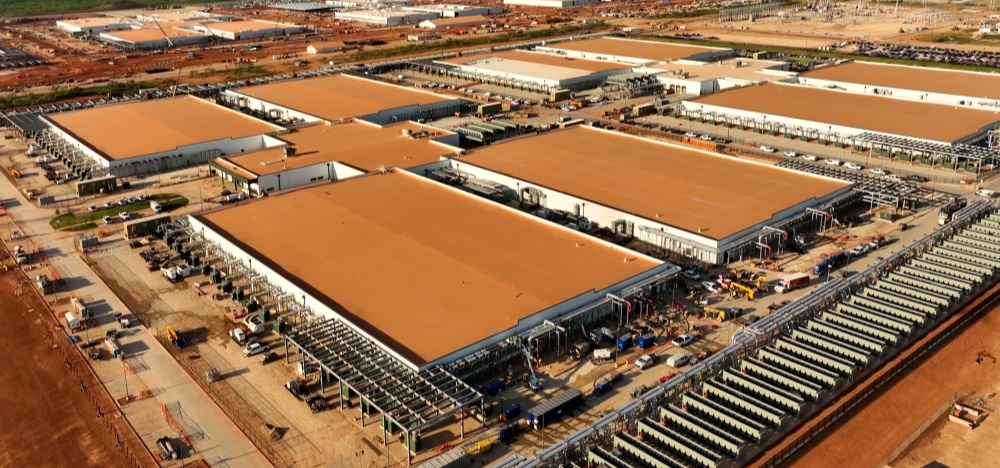
▲OpenAI“星际之门”项目
此外,美国各地的数据中心建设还面临层层政策与环保阻力。全美三十多个州出台了
三百多条相关法规
,两百多家环保机构也联名呼吁,
暂缓
全国范围内的数据中心新建审批。
地面算力扩张受电力、政策双重限制,马斯克由此想到了另一条出路:
把算力搬去太空。
SpaceX已向美国联邦通信委员会提交方案,拟发射
上百万颗
卫星,AI计算容量达
100吉瓦
,在近地轨道搭建
在轨数据中心
。马斯克认为电力供给是制约算力发展的核心短板,依靠太阳能供电的太空算力中心,能够绕开地面供电的局限。
海外算力建设暴露的各类瓶颈,也让国内厂商看清行业共性难题,纷纷开始寻找适配自身的发展路径,试图在地面上寻找一个
从芯片到电网、从单柜到AI工厂、从单点突破到开放系统协同
,系统性重构AI基础设施的方法。
正是在这样的背景下,7月9日,
2026年开放计算技术大会(OCTS 2026)
将在北京举行。
本届大会汇聚
OCP、OCTC、SPEC、CXL联盟、UALink联盟、UCIe联盟、固件产业技术创新联盟
等全球开放组织,以及
浪潮信息、阿里云、字节跳动、英伟达、三星、中国移动、百度
等超50家AI创新企业,围绕
数据中心基础设施、算电协同、可持续计算、开放系统设计、GW级开放智算中心、智算固件生态
等前沿方向展开交流。
这场大会上,你能听到
中国AI基建新前沿
的声音。
一、重构供电链路,从芯片到电网
GW级AI数据中心的崛起,让电力变为制约算力释放的物理天花板。从
芯片到机柜到电网
,三个层级需要同步变革。
在芯片侧
,AI芯片功耗正从数百瓦迈向
1500W+
。英伟达Rubin平台的GPU功耗已突破
1500W
,未来甚至可能达到
2000W
以上。传统供电回路从主板到芯片的路径过长,PCB铜箔损耗以及电压调节器到芯片引脚的阻抗巨大。
垂直供电
可以将供电回路长度从厘米级缩短至毫米级,大幅降低传输损耗与阻抗,使GPU能够从1000W升级到1500W+,同时保持供电效率在90%以上。
这一议题将在“数据中心基础设施论坛”、“算电协同发展论坛”中深入探讨,其中,
晶丰明源
将分享
高密度集成式VRM方案
,
长工微电子
将探讨
数据中心多相电源方案趋势
,
英飞凌
将解析高密高集成IBC和垂直供电如何重
塑AI数据中心电源架构
。
在机柜配电侧
,传统数据中心的主流采用220V交流供电,前几年国内兴起了
240V直流供电
方案,在单机柜数十kW的传统数据中心,240V直流供电能够
降低交直流转换次数
,对传统220V交流设备的良好兼容性,数据中心改造运维成本较低。但当AI机柜功率密度跃升至
100kW乃至1MW以上
时,机柜母线上的电流将达到
数千安培
,铜排损耗飙升至
20%以上
。
面对这一难题,2026年新建的GW级智算中心中,头部云服务商已开始采用
800V HVDC架构
,整体供电效率可从传统方案的80%左右提升至
95%以上
,万卡集群每年可节省
数千万度
电力成本。
在会上,
捷蒽迪
将分享
AI服务器800V直流供电架构下的数字电源解决方案
,
伟创力
将系统阐述
向±400V、800V DC母线电压演进的多级电源转换技术路径
。
在电网侧
,一个GW级智算中心的年用电量相当于
一座中型城市的全社会用电量
,对电网冲击不可忽视。
2026年政府工作报告首次提出
“算电协同”
,其本质是让算力调度与电力供给实现动态匹配——算力跟着电力走,电力调度靠算力。
在“算电协同发展”专题分论坛上,
潍柴重机
将解析
AIDC高密供电与备用电源方案
,
阳光电源
将分享
从电力基石到算力引擎的转型
,
阿里云
将分享
超大规模智算数据中心电力架构演进方向
。
二、两相液冷与原生液冷,突破散热天花板
AI芯片的功率迈向1500W+,机柜功率密度将从100+kW跃升至
1MW以上
,散热已升级为算力释放的决定性因素。
单相液冷依靠冷却液的温升带走热量,当单芯片功耗突破1000W时,需要极大的流量和流速,系统复杂度和能耗急剧上升。
两相液冷
则可以利用冷却液沸腾与冷凝过程中的相变潜热,散热效率是单相液冷的数倍,可在全球大部分地区实现自然冷却,无需额外机械制冷,能够支持
3000W以上
高功耗芯片散热,系统PUE可低至
1.1以下
。两相冷板已被定义为
新一代算力芯片的标配散热方案
。
在“可持续计算发展”专题分论坛上,
斯特林
将分享
两相液冷兼容与泄漏解决方案
,
钛芯智冷
将探讨
泵驱两相冷却技术
,
合肥新沪
将分享
液冷创新实践
,
百度
也将分享
液冷如何赋能超密度算力时代的冷却之道
。
原生液冷
是整个系统的创新。传统的“风液混合”的拼凑模式,受限于气冷数据中心的地板高度、机柜间距等先天约束,液冷效率无法充分发挥。原生液冷是在服务器、机柜及数据中心设计初期即统一考虑计算单元、散热系统、供电与互连网络。
大会上,
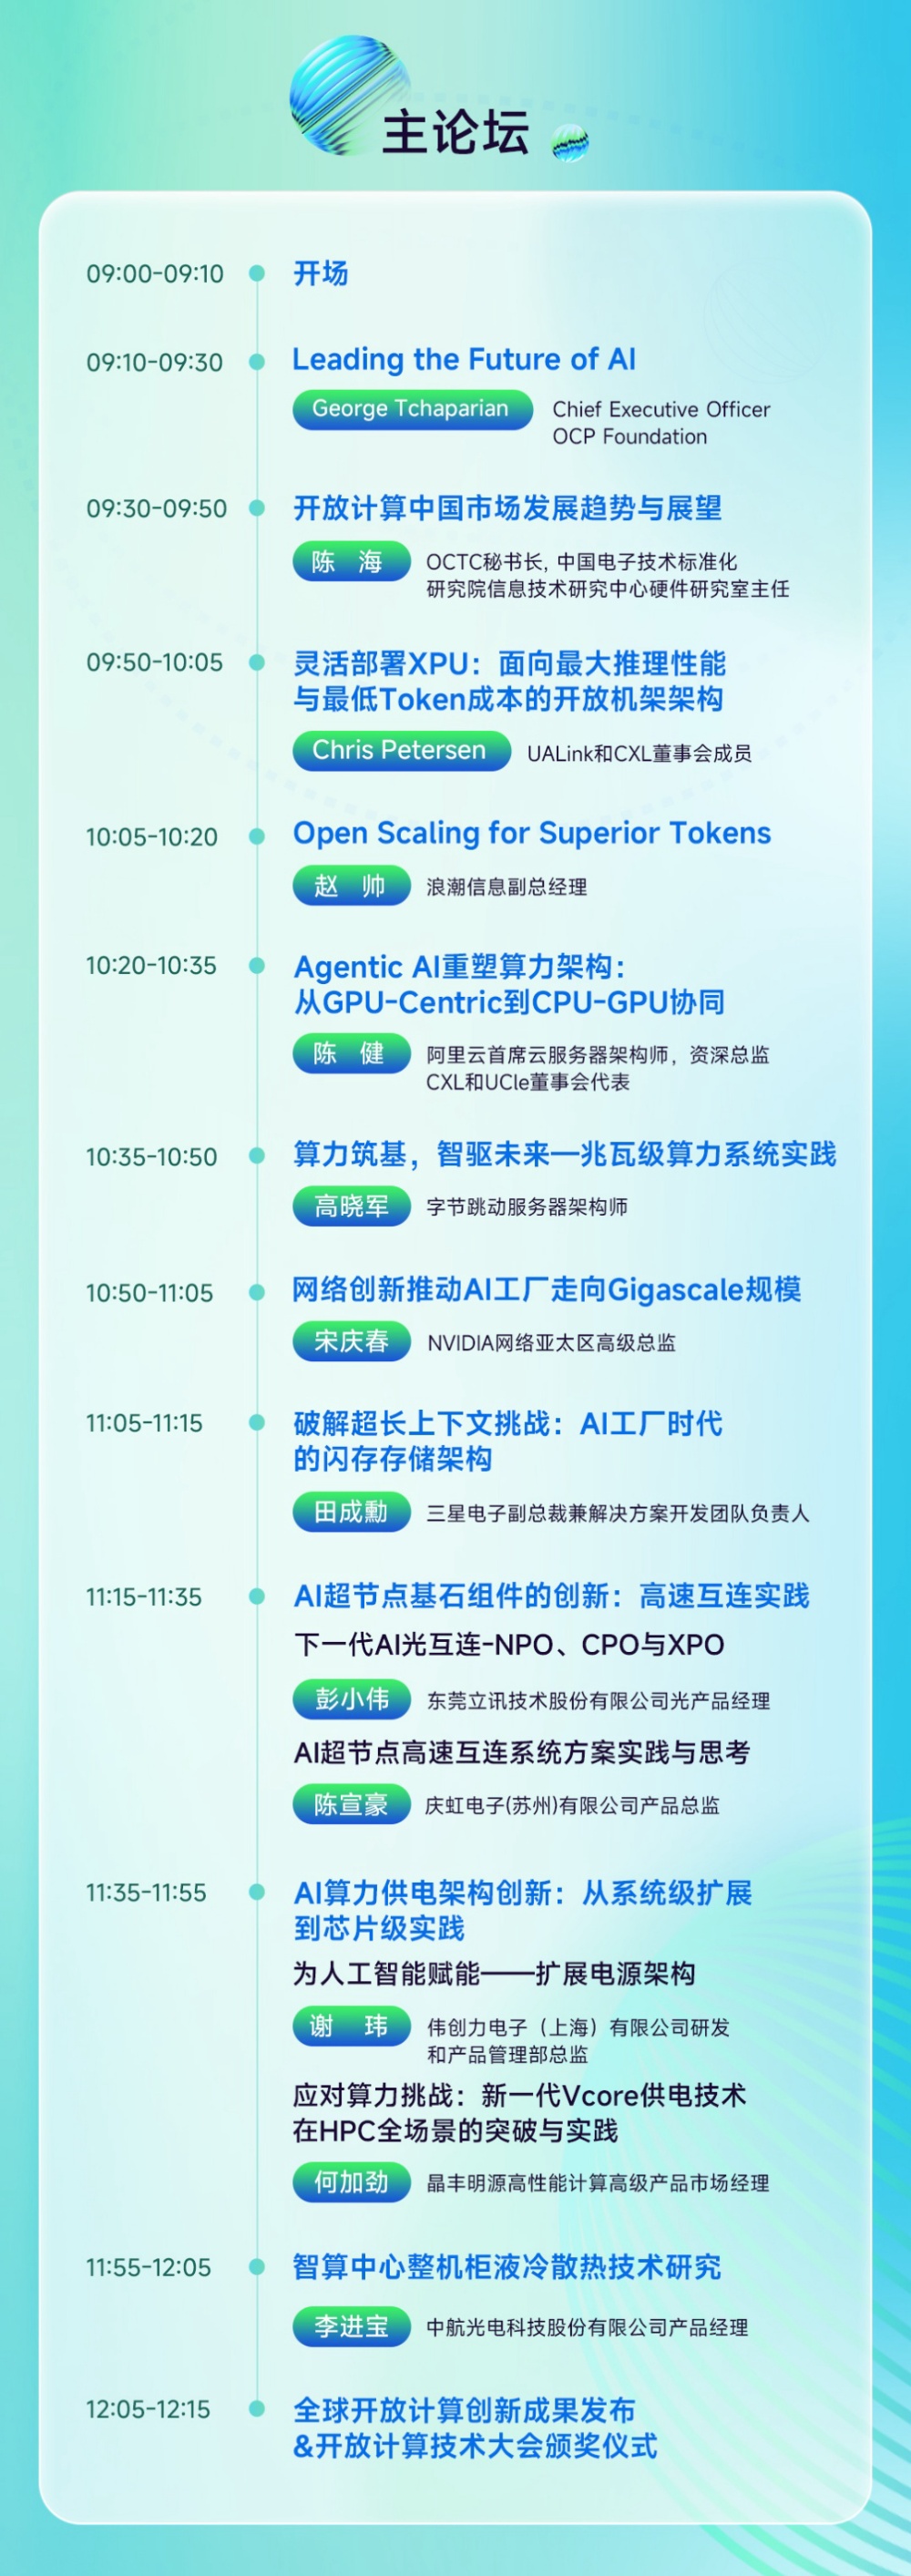
中航光电
将解析
智算中心整机柜液冷散热方案
,
浪潮信息
也将在主论坛系统阐述
包括原生液冷在内的前沿创新实践
。
三、AI工厂的“神经系统”如何升级?
AI算力集群从万卡迈向
十万卡
,互连带宽从800G/1.6T飙升至
3.2T、6.4T乃至12.8T
。互连成为决定集群算力线性扩展效率的
“神经系统”
。
重构的方向是明确的:Scale-up(机柜内)走向
448G超高速铜互连
,Scale-out(机柜间)走向
硅光与OCS光(光电路交换)互连
。
在Scale-up场景下
,机柜内XPU通信对延时极度敏感,链路距离小于1米,光互连成本高、功耗大、延时反而更差。铜互连凭借
极低延时(<1ns)
和成熟供应链,依然是机柜内部的首选,功耗仅为同速率光互连的十分之一。材料科学与信号完整性设计的突破,让铜缆在448G速率下依然保持信号可靠性。
大会上,
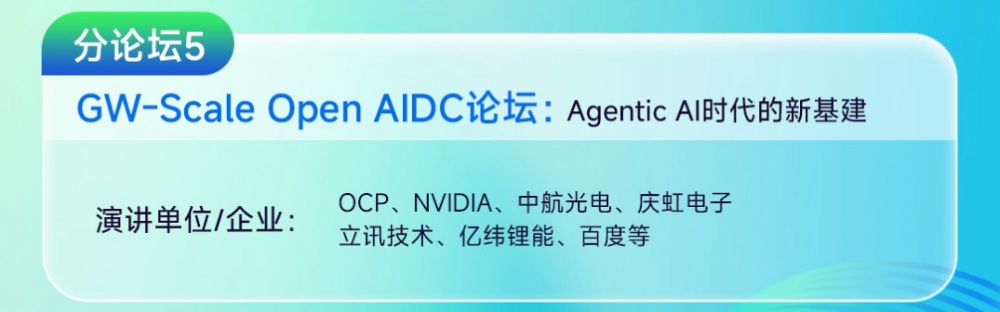
庆虹电子
将分享
AI超节点高速互连系统方案与实践思考
,
支撑224G/448G下一代速率演进
;
立讯
将分享
ACC(有源铜缆)、AEC(有源电缆)、CPC(共封装铜互连)
等铜互连的前沿方向;
中国移动研究院、阿里云
也将介绍
面向Scale-up场景下的智算中心最新高速互连架构
。
在Scale-out场景下
,机柜间传输(>10米)必须依赖光互连。传统可插拔光模块在端口密度、功耗和成本上遭遇瓶颈。
光模块与芯片共封装(CPO)
可将功耗降低50%以上,端口密度提升2-3倍。OCS则用
全光交换
替代电交换,实现毫秒级拓扑重构。
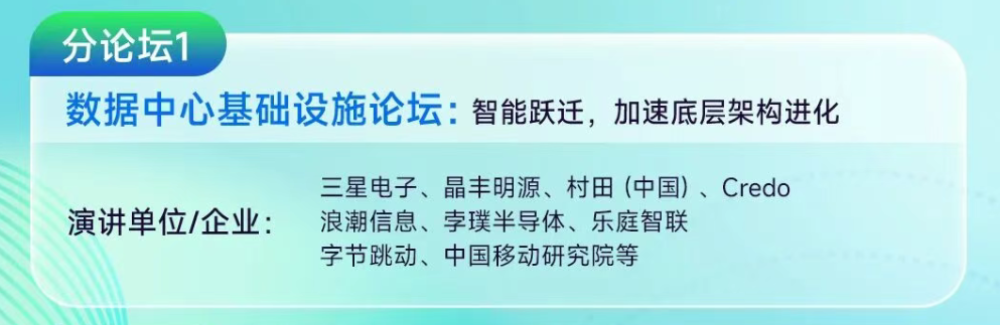
大会上,
立讯技术
将围绕
NPO、CPO与XPO
等下一代AI光互连路线,解析性能、可维护性、散热和成本的差异。
孛璞半导体
将带来
高端口密度硅光OCS技术——面向AI集群的新一代光交换技术
。
英伟达
也将在主论坛分享
网络创新如何推动AI工厂走向Gigascale规模
。
四、从GPU-Centric到CPU-GPU协同,算力架构重构
Agentic AI
的爆发,正从根本上改变AI基础设施的设计逻辑。
AI应用从面向单模型训练优化,转向支撑多智能体协同、自主决策和持续推理。AI基础设施也要围绕计算与存储架构展开系统性重构。
从系统层面来看
,大会主论坛上,
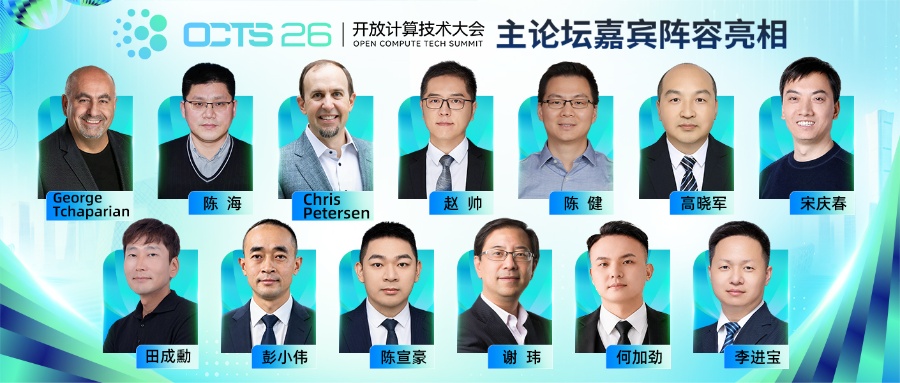
OCP Foundation首席执行官George Tchaparian
将分享全球开放计算社区如何
以“从芯片到电网”的全栈创新重塑AI数据中心建设范式
;
OCTC秘书长陈海
将围绕开放计算标准体系建设,解析
超节点、整机柜、液冷、GW级AIDC
等关键方向的演进趋势
。
在计算架构上
,Agent工作流中规划、编排、反思等逻辑密集型任务占比急剧上升,若全部交由GPU处理,Token成本会非常高昂。CPU凭借强大的单核性能与逻辑处理能力,重新成为Agent编排与执行的最佳选择,Agent基础设施正在走向
“GPU专注模型张量计算、Token生产;CPU负责推理调度与Agent编排”
的分工协同。
在存储架构上,
超长上下文
成为Agent刚需,KV Cache爆发式增长,若全部走昂贵的高带宽内存,成本将失控。将KV Cache按活跃与归档分层,即热数据走DRAM/CXL,冷数据走向定制化SSD,存储成本可
降低60%-80%
。
大会上,
三星电子
将分享针对
“活跃KV缓存”与“归档KV缓存”分层定制
的下一代SSD解决方案,还将探讨CXL内存池化与计算卸载如何支撑Agent AI的分层内存架构。
此外,智能体要实现群体智能意味着大量Agent之间需要频繁的交流、同步与协同,封闭的私有协议栈已无法应对这种复杂性。
国内厂商给出的解决方案是
以UALink、CXL、UCIe等开放标准构建统一计算域
,打破供应商锁定,让CPU、GPU、内存、互连自由组合,让Agent Swarming像集群操作系统调度进程一样高效。
大会上,
UALink联盟与CXL联盟董事会成员Chris Petersen
将展示
首个符合OCP开放标准的极低延时机架架构
,基于PCIe支持多达256个XPU,并介绍Hypercast与在网计算如何通过在互连网络中卸载集合通信来降低Token成本。
字节跳动
将分享
GPU/NPU模组标准化接口设计
,让异构算力即插即用。
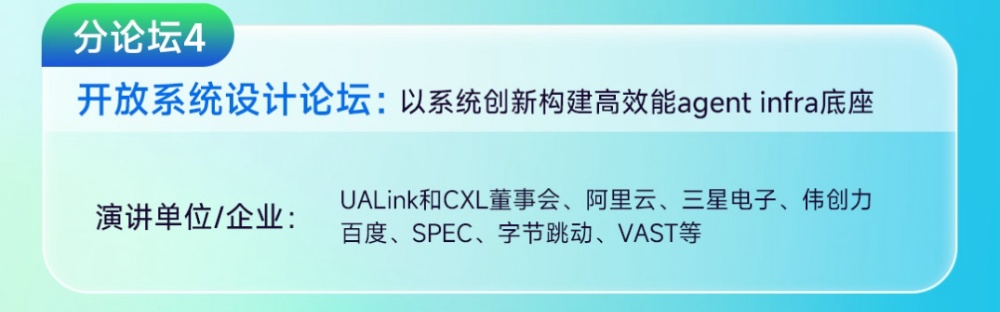
开放系统层面,
SPEC、TÜV莱茵
等机构将在大会可持续计算分论坛中分享能效评估与标准化的前沿进展;
浪潮信息、百度
等也将在GW-Scale Open AIDC分论坛中呈现各自的前沿探索。
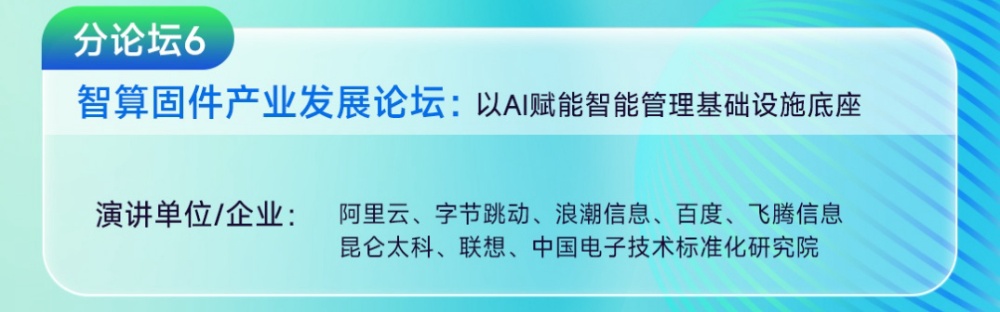
此外,智算固件产业发展论坛上,
阿里云、字节、凌思微电子
等将聚焦
未来数据中心服务器
等IT基础设施智能管理场景,探讨
基于BMC智能运维
等前沿固件创新技术展开交流,旨在推动构建安全、开放的智能管理生态。
结语:在地面上解决问题,在开放中寻求协同
这场全球AI基建竞赛走到今天,产业已经逐渐意识到:算力的天花板在电网上;竞争力的分水岭在系统效率上。
在这方面,中国拥有天生优势:全球规模最大、最稳定的电网基础设施,完整且具有弹性的IT供应链,以及从芯片设计到系统集成的全栈工程能力。更重要的是,“算电协同”已经被写入政府工作报告,这是一种其他国家很难复制的顶层设计与执行效率。
中国选择了一条更偏工程化、系统化的路径:用系统思维把供电、散热、互连、计算、存储每一个环节的效率差、成本差、时间差抹平。
7月9日,2026年开放计算技术大会(OCTS 2026)即将举行。这场大会的意义,正在于它标志着中国AI基建正从单点突破走向系统重构。
当全球算力竞赛进入深水区,真正能拉开差距的,不再是某一块芯片,而是一整个能持续进化的开放系统,以及支撑这个系统运转的完整产业生态。


