
 五度妙笔
 企业透视镜
 API商城

 数据库
中文语音识别测评体系发布!覆盖6大维度、15项核心任务
2026 年,语音识别(ASR)技术快速发展:闭源API相继强化方言口音、长音频与结构化数字能力,中文厂商也在方言、古诗文及专业词汇方向持续投入。然而,现有公开评测或侧重英文场景,或仅面向开源模型,既难覆盖中文方言、中文实体等特有需求,也缺乏对长音频稳定性、结构化关键信息与高难度表达的统一评价,尚未形成系统、客观的中文语音识别综合排名。
因此,我们正式推出 SuperCLUE-ASR 中文语音识别测评体系。该体系结合国际成熟评测方法论和中文方言评测的地域细分经验,并补充中文结构化信息与中文高难度表达两类评测任务,最终形成包含 6 大一级维度、15 项核心任务的测评方案。
排行榜地址:www.SuperCLUEai.com
# SuperCLUE- ASR测评体系
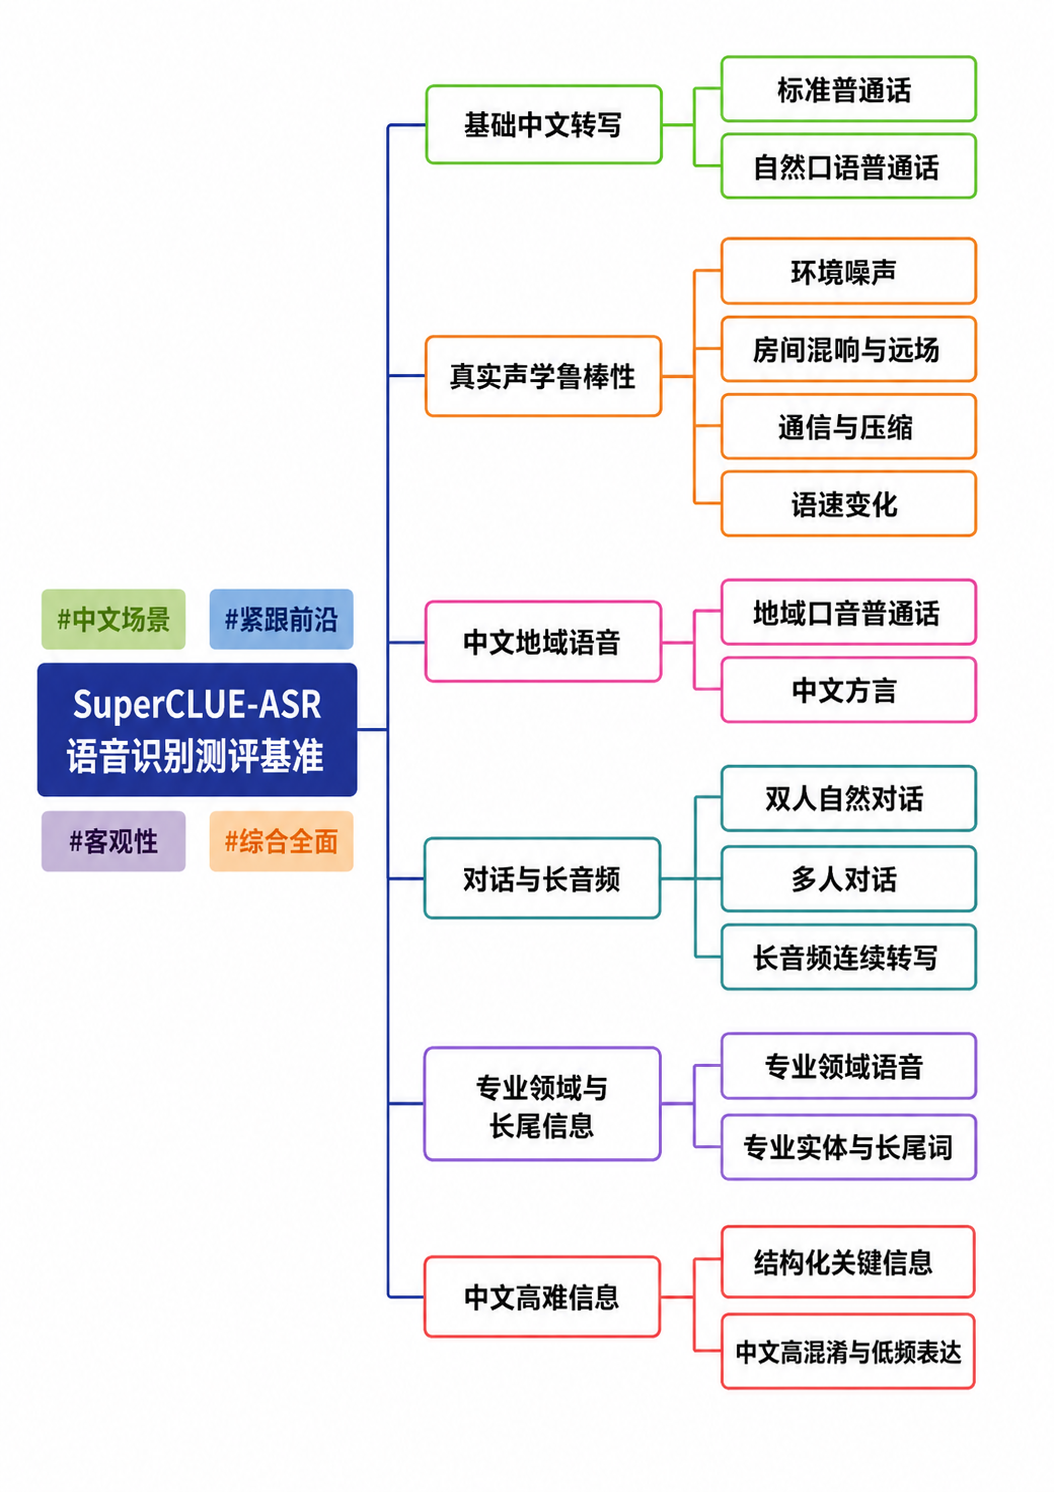
测评体系总览:

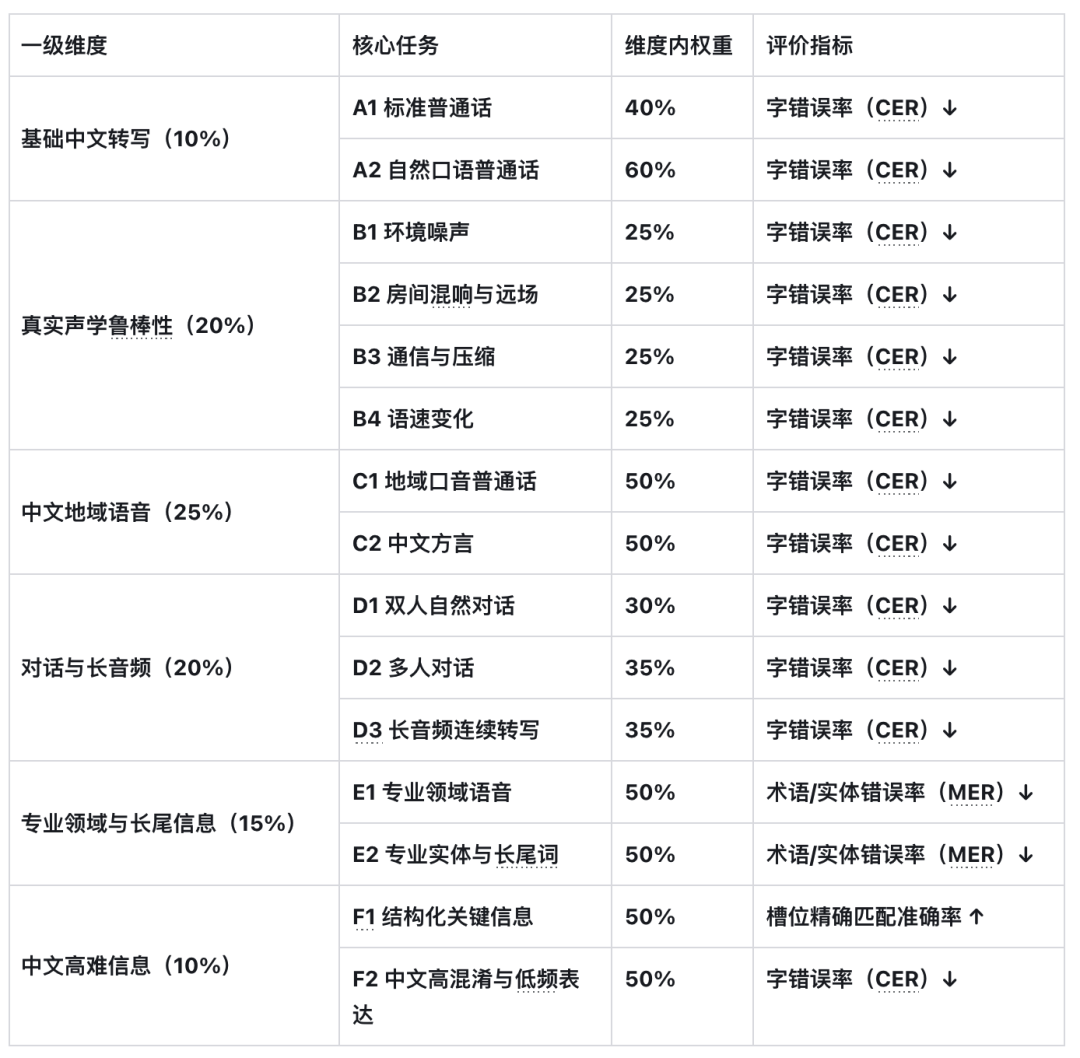
15 项核心任务与评价指标:
1. 任务体系介绍
(1)基础中文转写
标准普通话:覆盖日常、社会、科技、新闻、知识性陈述等内容,采用标准中性普通话、自然语速、干净声学环境,时长按 5–30 秒分三档分布;
自然口语普通话:评估模型由朗读语音转入真实中文自然口语后的性能变化,样本覆盖犹豫、自我修正、重复、不完整表达、语序松散、口语化省略等,时长 8–45 秒。
(2)真实声学鲁棒性
环境噪声:混入咖啡厅、办公室、人群、道路交通、车内、机械/风扇等 4–6 类真实环境噪声;
房间混响与远场:设置轻度室内、中等会议室、远场加强混响三档空间声学条件,Hard 样本不叠加强噪声,以避免与“环境噪声”任务产生混淆;
通信与压缩:模拟电话、低带宽及低码率通信条件,覆盖 8 kHz 电话窄带、Opus、AAC 等编码条件;
语速变化:采用保持音高的变速方法,覆盖 1.25×、1.5× 及少量 1.7× 快速中文,评估语速变化条件下的转写稳定性。
(3)中文地域语音
地域口音普通话:内容仍为普通话,但带有明显且自然的地域发音特征,初始口音簇覆盖东北、川渝、河南、江浙、广东等地区普通话;
中文方言:评估真实中文方言的连续转写能力,参考答案保存实际方言表达。
(4)对话与长音频
双人自然对话:可能包含短轮次、快速切换、自我修正及少量打断,时长 30 秒至 5 分钟,仅评价转写内容,不评价说话人身份与时间戳;
多人对话:覆盖 3–5 人的对话,对话中可能包含抢话及可控重叠语音,时长 2–15 分钟;
长音频连续转写:设置 20 / 40 / 60 分钟三个时长档,评估转写性能随音频时长增长的稳定性;调用方式优先完整文件输入,受模型或 API 限制时依次降级为约 9 分钟分段、约 30 秒分段,切点选取自然停顿位置,处理方式仅作记录、不计入扣分。
(5)专业领域与长尾信息
专业领域语音:覆盖 AI/IT、医疗、金融、法律、汽车、工程六大领域,允许自然出现 GPU、CUDA等英文术语与缩写,强调连续信息密度而非孤立术语;
专业实体与长尾词:评估模型对密集实体、相似实体及长尾专名的转写能力,Hard 样本单条包含约 8–15 个实体,并引入 H100/H200、Qwen3/Qwen3.5、A17/A17 Pro 等相似实体对以提高区分度。
(6)中文高难信息
结构化关键信息:覆盖日期、时间、金额、百分比、电话、邮箱、IP、URL、订单号、产品型号、软件版本号、字母数字混合串等业务关键结构信息,采用严格精确匹配,单个字符错误即判定该信息项错误;
中文高混淆与低频表达:覆盖同音/近音、多音字与音义歧义、绕口令与高相似音序列、古诗词、文言与低频表达、生僻专名六大子类型,聚焦真实中文语境中易发生的混淆,避免将任务设计为单纯的生僻字识别测试。
2. 测评方法和任务示例
无需裁判模型:每道题目均有经多轮人工 QA 冻结的标准参考答案,模型输出与参考答案直接比对,评分过程不存在主观判断环节;
评分完全确定:字错误率(CER)、术语/实体错误率(MER)基于编辑距离自动计算,结构化信息执行严格精确匹配,同一模型输出在任何时间复测得分完全一致,不受裁判模型版本或采样随机性影响;
字错误率(CER):衡量模型转写文本与参考答案之间的差异程度,基于编辑距离计算,计算公式:
术语/实体错误率(MER):计算方式与 CER 相同,但基本单位由“字”改为“术语/实体”:一个英文单词计为一个单位,GPU、FP8 等技术缩写、型号与专名整体计为一个单位。允许格式等价(如 GPU = gpu),但不允许内容替换(如 H100 ≠ H200)。
槽位精确匹配准确率:面向 F1 结构化关键信息任务。每条样本预先标注若干关键信息槽位(日期、时间、金额、电话、邮箱、IP、订单号、型号等),评分时逐一核对模型转写中对应槽位的内容,计算公式:
【测评维度】:中文高难信息——结构化关键信息
【音频】:
您的浏览器不支持 audio 元素。
【参考答案】:
【模型回答】:
【得分】:H200-07 与 H100-07 不等价,识别错误。
各任务示例
示例1
【测评维度】:基础中文转写——标准普通话
【音频】:
您的浏览器不支持 audio 元素。
【参考答案】:
请关注本周城市公共交通调整,部分公交线路会根据早晚高峰客流重新安排发车时间,出行前建议查看站点公告和实时信息。
示例2
【测评维度】:真实声学鲁棒性——环境噪声
【音频】:
您的浏览器不支持 audio 元素。
【参考答案】:
示例3
【测评维度】:中文地域语音——中文方言
您的浏览器不支持 audio 元素。
【参考答案】:
我哋下周开个短会,睇下测试结果有冇问题。如果数据正常,就按原来个计划继续做。听朝之前记得交翻份报告,边个负责嗰部分,如果仲未整理好,就尽快喺群里面讲声,等大家可以一齐跟进,唔好到最后先至发现有嘢漏咗。每个人都要睇清楚自己负责嘅记录。
示例4
【测评维度】:对话与长音频——多人对话
您的浏览器不支持 audio 元素。
【参考答案】:(说话人身份不参与评价)
[说话人A] 好久不见,时隔半年的三人合体时间了。
[说话人B] 又可以线下录一期了。
[说话人A] 那我们今天呢其实本来应该是在25年年末聊的,其实我们是想要盘点一下每个人在这一年当中觉得值得大家去关注的茶行业相关的事情。
[说话人B] 我们录这期呢是2月嘛,我觉得其实
[说话人B] 还没有过农历年都不算过年。
[说话人A] 对,但是其实这26年开始也发生了不少的事情。
[说话人B] 是的,所以我们今天的
[说话人C] 信息密度非常大。
[说话人A] 非常大,对。
[说话人A] 所以我甚至觉得这一两个月发生的怎么比25年一整年的好像都要更精彩。
[说话人B] 近大远小。
[说话人A] 对,好。
[说话人A]好的,那我们今天的话就主要是每个人选了两到三件觉得比较值得关注的事情来进行一个盘点。
示例5
【测评维度】:专业领域与长尾信息——专业领域语音
您的浏览器不支持 audio 元素。
【参考答案】:
当前服务使用 H200 GPU 运行 Qwen3 模型,并通过 vLLM 提升并发处理能力。测试时需要观察 KV Cache、FP8 量化和首 Token 延迟对整体吞吐量的影响。同时还要记录不同请求长度下的显存占用,确认系统在高峰时段是否仍能保持稳定响应。
示例6
【测评维度】:中文高难信息——中文高混淆与低频表达
【音频】:
您的浏览器不支持 audio 元素。
【参考答案】:
夫君子之学,贵在博观而约取,审问而明辨。譬如长风破浪,行舟者当审其向;见贤思齐,见不贤而内自省。若以一时得失遽论成败,未免舍本逐末,失之毫厘,谬以千里。故临事不可徒恃聪明,亦不可因循自困;当知积善成德,积学成识,日久方能见其功。读古人之言,尤当辨其字义与语境,不可望文生义。
测评邀请
时间规划
测评流程
1.邮件申请
2.意向沟通
3.参测确认与协议流程
4.提供API接口或大模型
5.获得测评报告


