

单击上方“图灵人工智能”,选择“星标”公众号
您想知道的人工智能干货,第一时间送达
视频自监督预训练这些年有个默认设定:想防住"表征坍缩",就得在架构上打补丁——EMA目标编码器、stop-gradient、专用预测器,或者干脆上解码器做像素重建。补丁越攒越多,算力越吃越贵。
杨立昆(Yann LeCun)团队的新工作LeVJEPA,把这些补丁一次撕干净:整套可训练组件只剩一个编码器加一个投影器,训练目标只剩一个超参数。同等训练轮次下,预训练算力比V-JEPA2低5.6-20.8倍;算力拉平后,ImageNet-1K反超最强视频基线7.6个点。
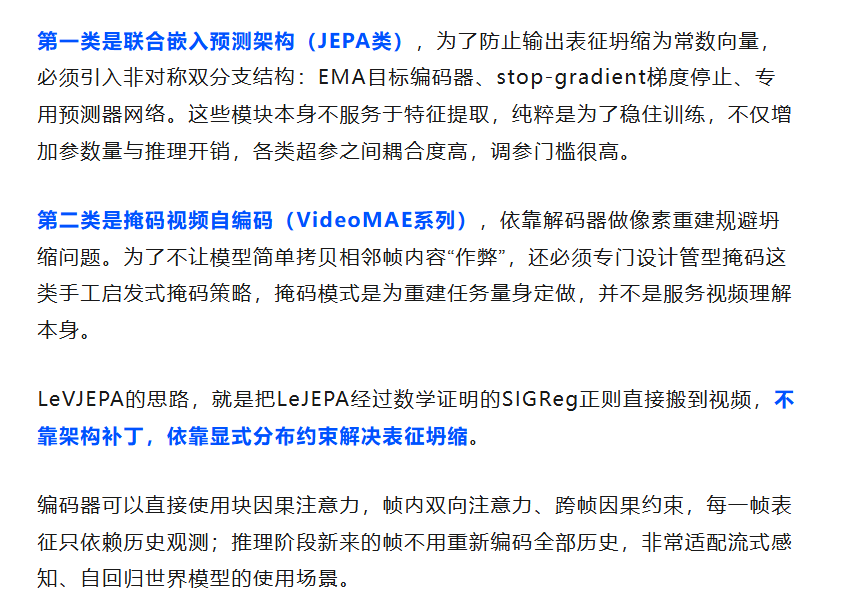
如今视频自监督预训练主要分为两大流派,但两套方案都带着难以割舍的设计包袱,这也是LeVJEPA这项工作想要解决的现实痛点。
整套框架没有复杂的辅助网络,核心由视图采样、损失函数、编码器三部分组成,训练完成后投影器直接丢弃,下游任务只复用编码器。
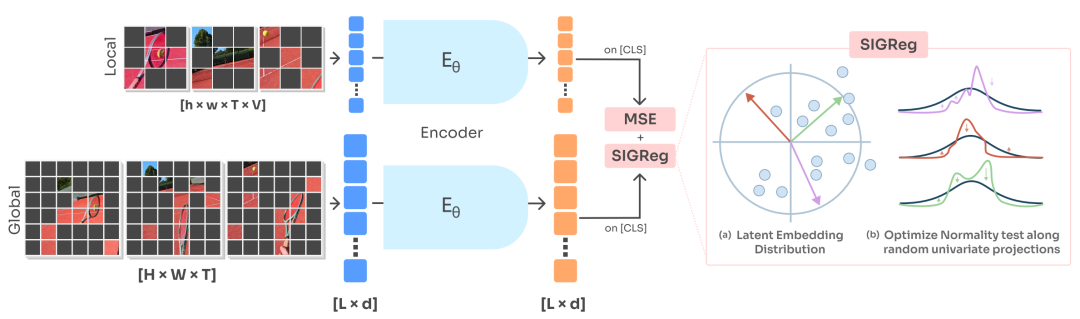
图 | LeVJEPA训练流程©【深蓝 AI】编译
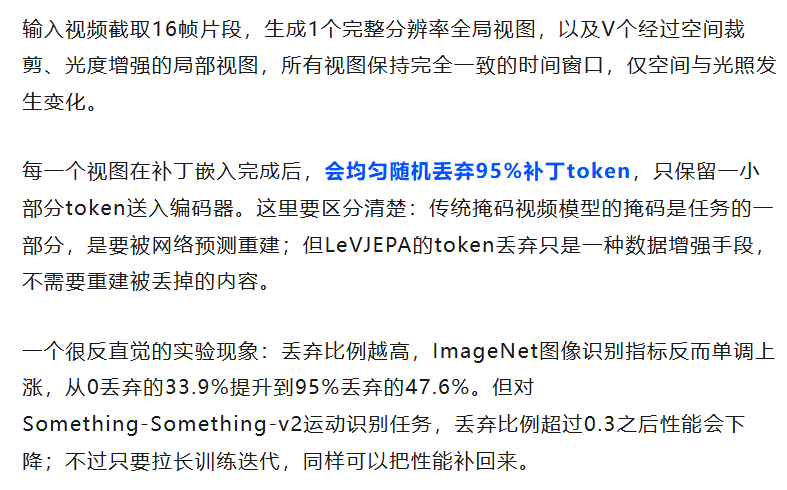
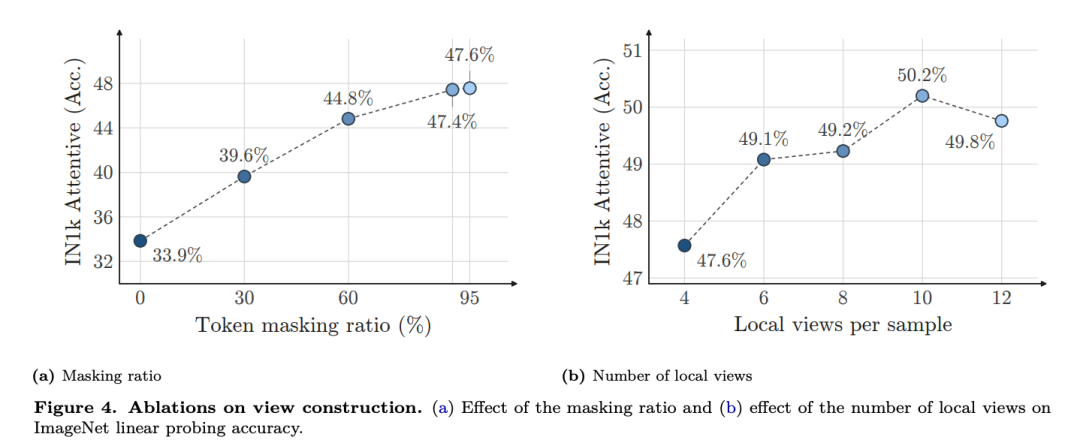
2.1 全局‑局部视图构造与随机Token丢弃
2.2 损失函数:不变性损失+SIGReg正则,仅一个可调超参
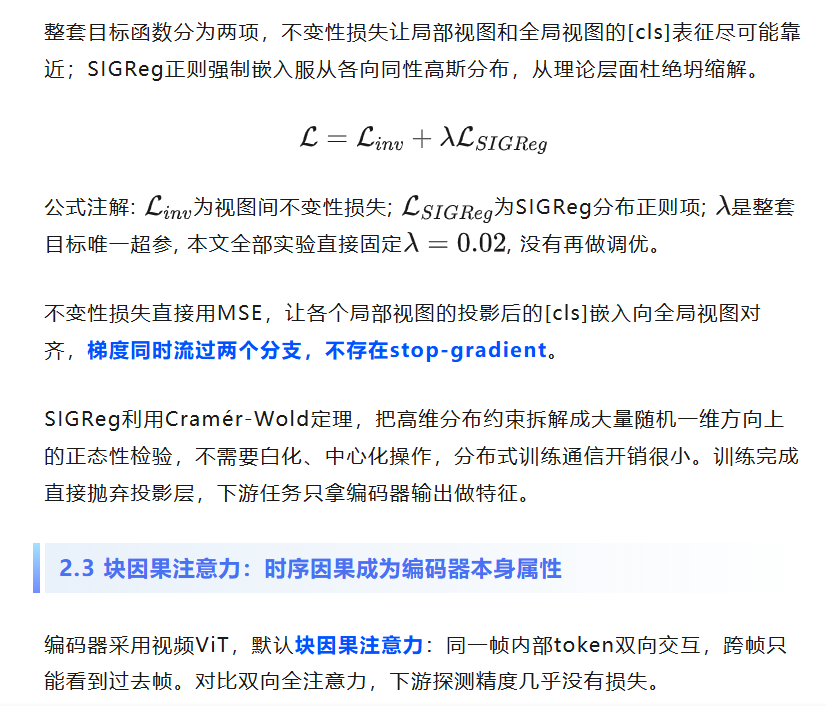
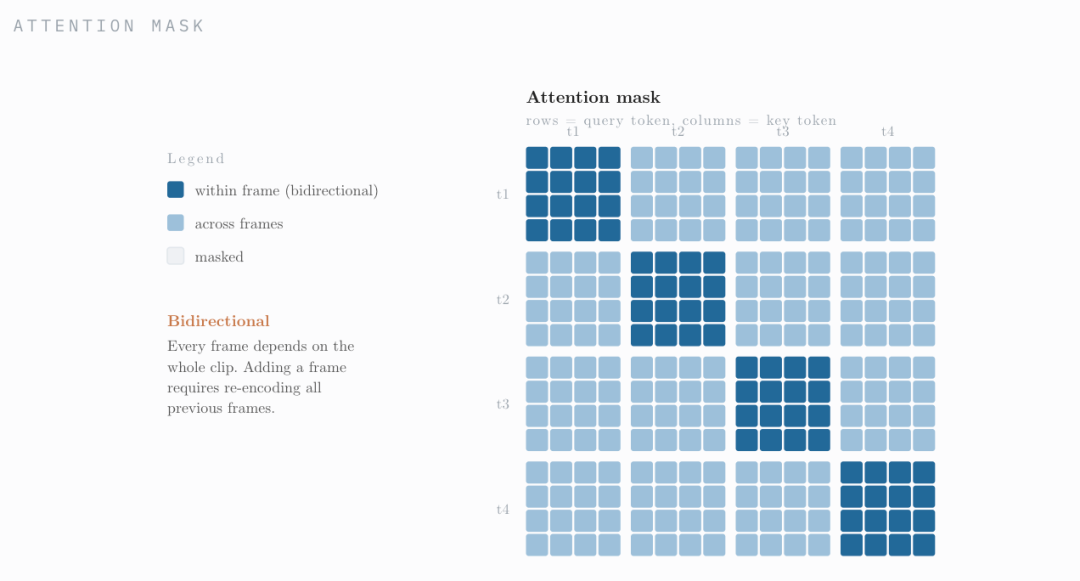
图 | 因果注意力掩码示意图—帧内双向交互、跨帧因果约束的注意力模式©【深蓝 AI】编译
这一点带来工程上的关键收益:双向编码器做流式推理,每新增一帧必须把全部历史重新编码;块因果注意力则可以增量输出帧表征,新增帧带来的算力开销是常数。这对于流式视频分析、自回归世界模型是非常友好的原生特性。
3.1 训练轮次对齐:算力大幅下降,效果持平甚至超越基线
在完全相同的K710 20%子集,训练固定240个epoch。ViT‑S/B/L全部规模下,LeVJEPA效果追上或者超过V‑JEPA2,预训练总FLOPs降低5.6‑20.8倍。ViT‑L配置下,LeVJEPA不仅算力仅为V‑JEPA2的1/5.6,精度还高出1.9个点。
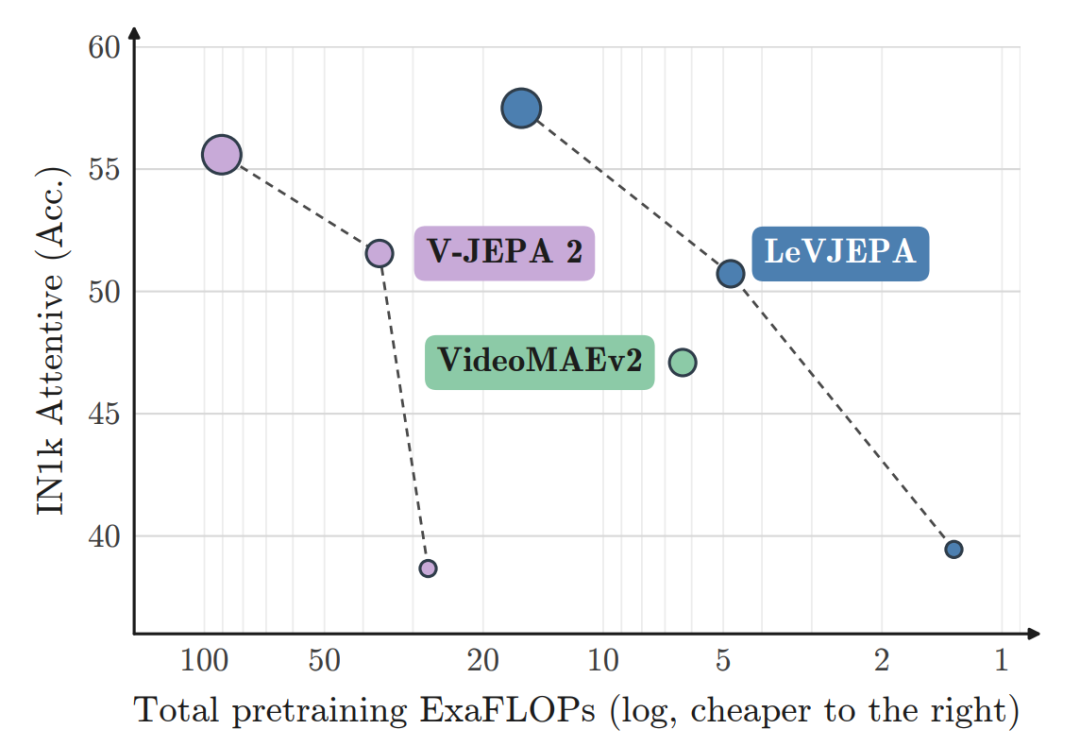
图 | 同等训练轮次下预训练算力与ImageNet‑1K注意力探测精度对比©【深蓝 AI】编译
3.2 算力对齐实验:视频预训练兼顾图像能力成为可能
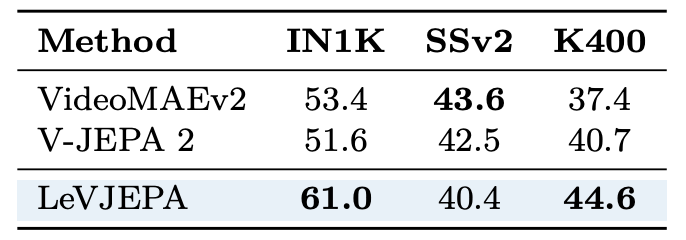
表 | 同等总预训练FLOPs下多基线对比结果©【深蓝 AI】编译
算力预算完全拉齐之后,LeVJEPA的ImageNet‑1K达到61.0,相比最强视频基线高出7.6点;K400动作识别同样第一;仅在SSv2运动理解任务略低于VideoMAEv2和V‑JEPA2,差距3.2点。
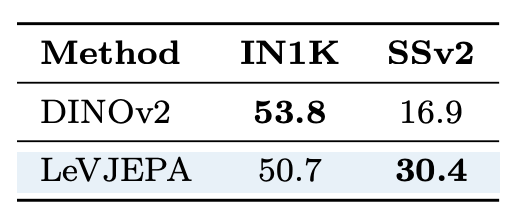
表 | 和同等算力图像预训练基线DINOv2对比:ViT‑B,相同视频源数据,FLOPs对齐。©【深蓝 AI】编译
这一组对比很有行业启示:过去大家普遍认为视频预训练必须牺牲图像识别能力换取运动理解。LeVJEPA在相同算力下,图像能力距离纯图像预训练DINOv2只差3.1个点,而运动任务精度几乎翻倍。这说明视频完全有潜力作为通用视觉预训练的基础素材,而不是只专门用来做动作识别。
3.3 消费级硬件可行性与数据缩放
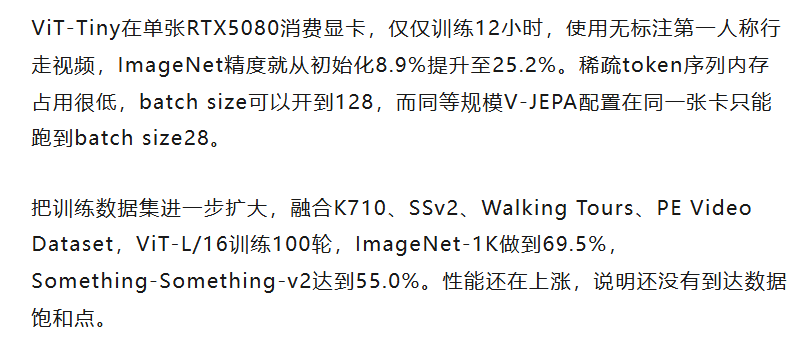
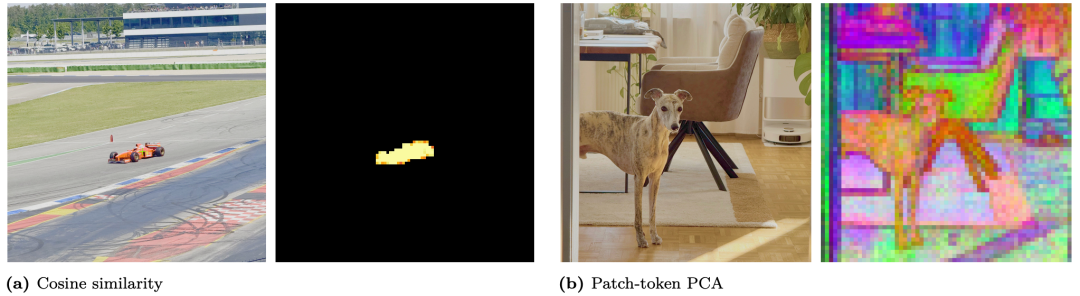
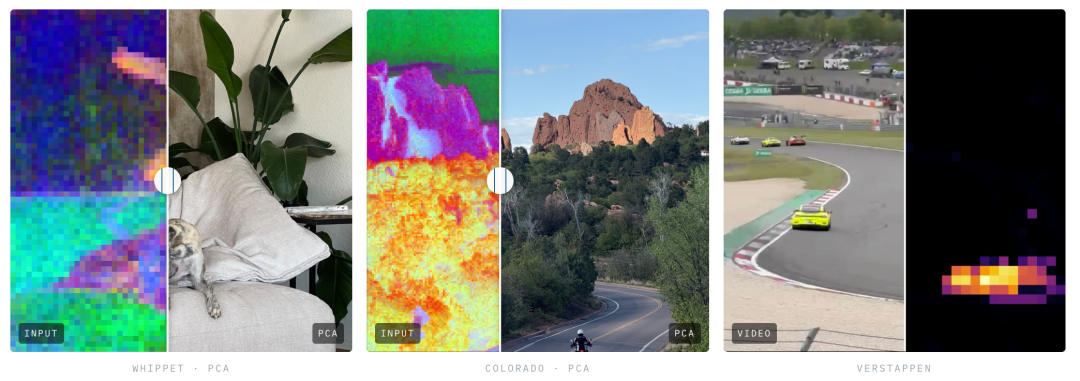
图 | 更多补丁Token可视化案例:(a)查询补丁和全部补丁token的余弦相似度,高相似度严格集中在目标物体;(b)另一组场景的PCA可视化,同样实现物体与背景语义分离。©【深蓝 AI】编译
消融实验可以看到,尽管训练只监督全局[cls],补丁层面自动涌现出语义、空间结构化表征,不需要额外补丁损失;对比V‑JEPA2.1,后者是靠专门增加辅助补丁损失才拿到同类效果。
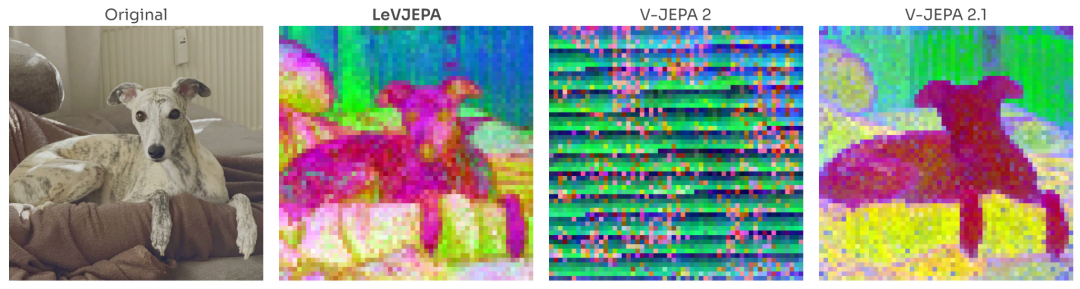
图 | 补丁Token主成分可视化:对同一张输入图像,把补丁token表征前三个主成分渲染成RGB。©【深蓝 AI】编译
长久以来,视频预训练被贴上“算力昂贵”的标签,行业默认想要时序运动能力,就要付出巨大计算代价,还要牺牲图像理解。LeVJEPA把LeJEPA理论落地视频领域,把一大堆用来防止表征坍缩的启发式架构补丁全部拿掉,仅仅依靠编码器、投影器加上SIGReg正则完成视频自监督学习。
随机token丢弃这个看似简单的操作带来了反直觉结果:丢掉绝大多数token,图像表征能力反而提升。块因果注意力让时序因果成为编码器的原生属性,为流式感知、世界模型提供便利。实验也揭示一个重要趋势:只要把计算 overhead降下来,视频素材完全有资格作为通用视觉预训练的底座,而不是只作为动作识别的专用数据源。
当然,它也留下若干待解决问题:高丢弃率对时序运动信息的伤害如何进一步缓解;SIGReg正则在互联网规模视频、超大模型下的稳定性;涌现出来的补丁表征在分割、追踪等稠密任务的实际表现,都是后续值得深挖的方向。
编辑|小小怪博士
审核|阿蓝
Ref
论文标题:LeVJEPA: Efficient & Scalable Video Pretraining without the Heuristics
论文链接:https://arxiv.org/abs/2608.27395
项目主页:https://levjepa.github.io/
文章精选:
1.图灵奖得主姚期智最新演讲: AI有边界,恰恰是好事