五度妙笔
 企业透视镜
 API商城

 数据库
一周AI丨25位菲尔兹奖得主联名示警;AI短剧带火人脸授权生意;GPT Images 2.5上线;华为发布首个韬定律芯片;燧原科技登陆科创板……
AI万象
计算机图形学领军人物童欣加入Meshy,出任首席科学家
AI短剧爆发带火人脸授权生意:普通人卖脸一次100元
大平台动作
Meta可能已提前泄露下一代高端超轻薄头显
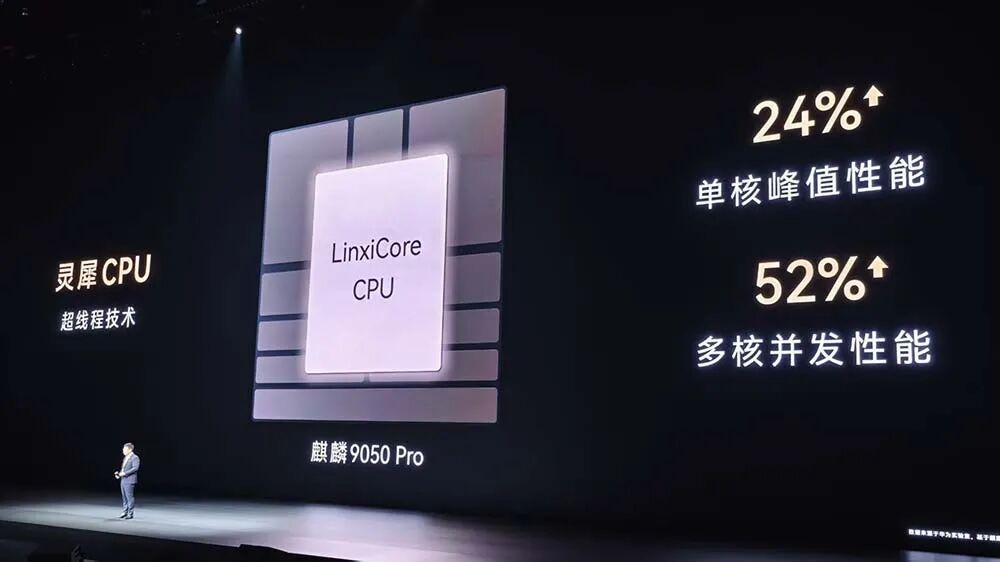
华为发布首个韬定律芯片麒麟9050Pro,用于三折叠新机
新力量崛起
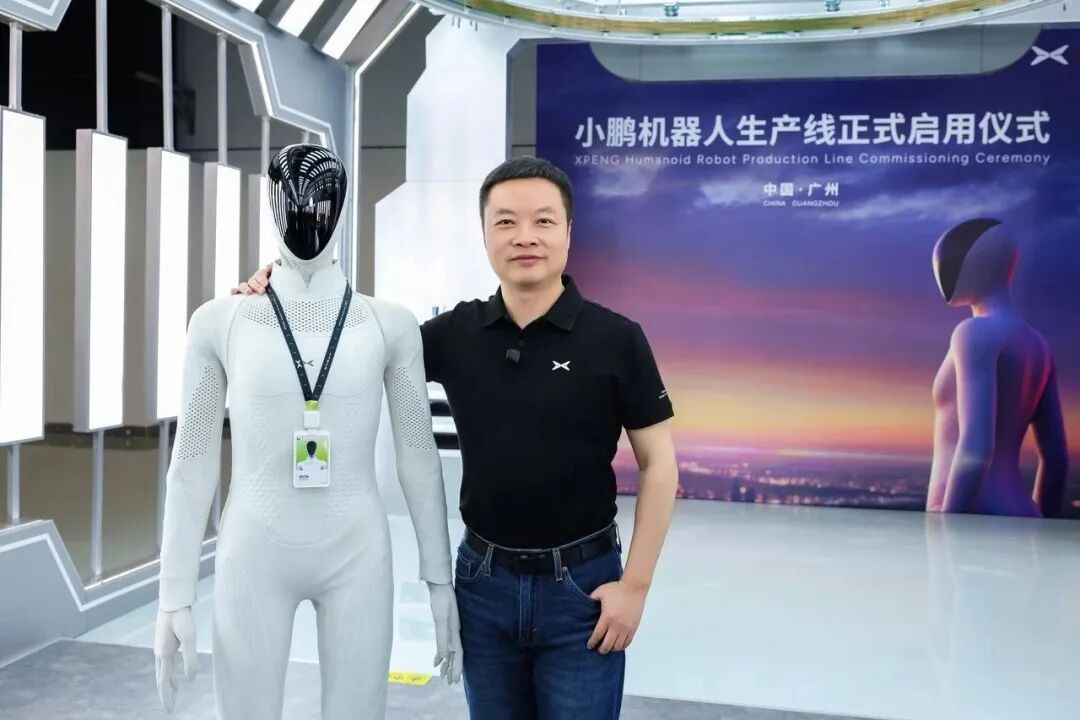
2027年交付!小鹏首位人形机器人自主走下产线
投融资风向
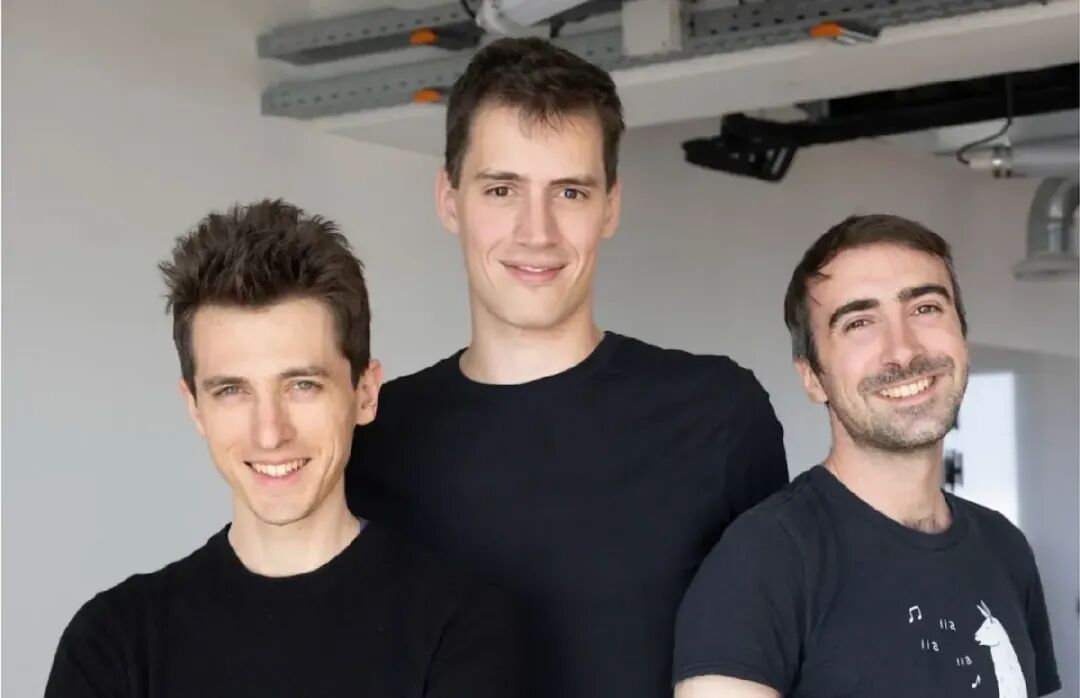
Mistral完成30亿欧元融资,创欧洲科技企业私募融资纪录
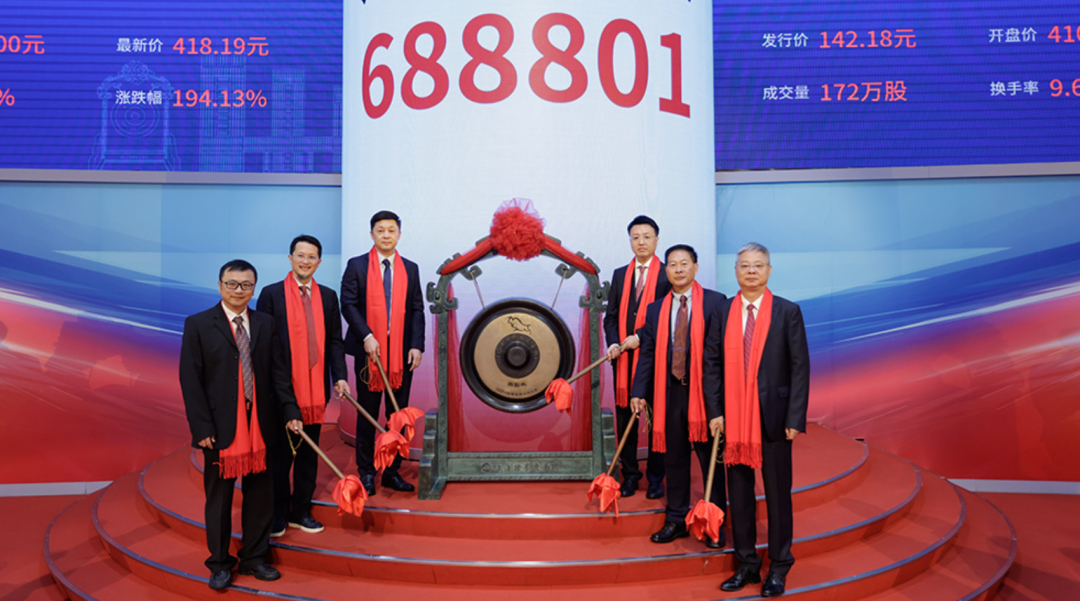
燧原科技登陆科创板!两位创始人成亿万富翁
01
陶哲轩等25位菲尔兹奖得主联合发出警告:AI公司正在摧毁数学
AI万象
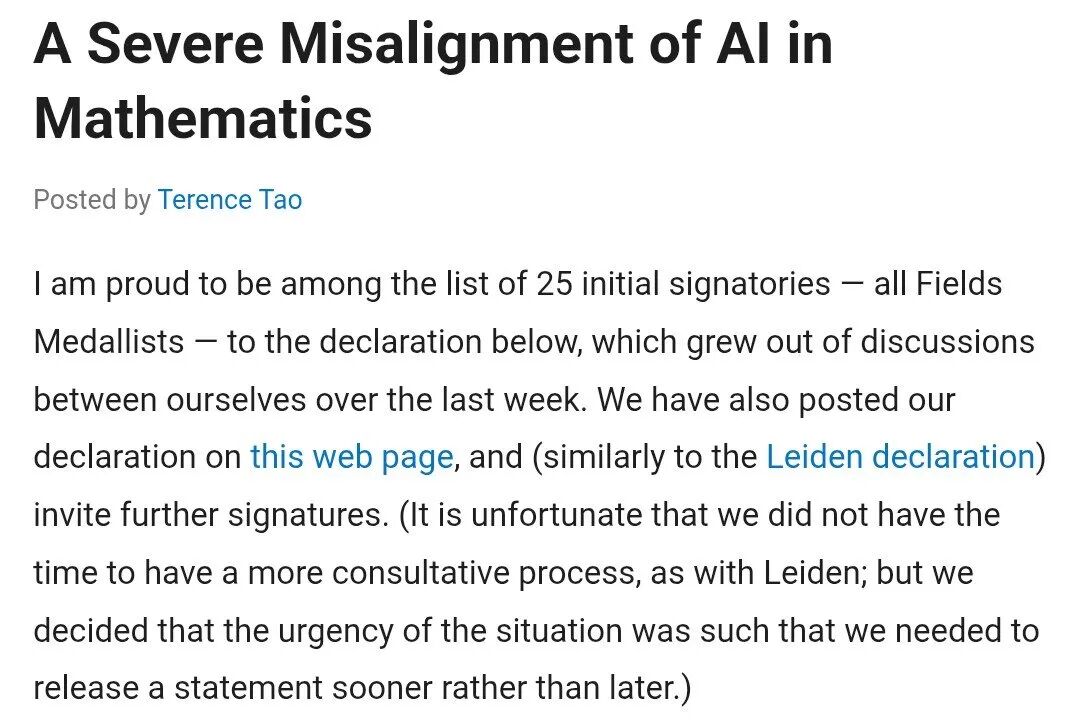
当地时间9月11日,陶哲轩、邓煜、彼得·舒尔茨(Peter Scholze)等25位菲尔兹奖得主联合发表声明《人工智能在数学中的严重错位》(A Severe Misalignment of AI in Mathematics),警告AI公司与数学共同体之间的目标错位可能损害数学研究。
陶哲轩当天在个人博客“What's new”发布了声明全文。他介绍,这份声明源于25位菲尔兹奖得主过去一周的讨论。由于认为当前问题具有紧迫性,他们没有等待更长时间进行更广泛的协商,而是决定尽快公开发表声明。
声明承认,过去几个月大语言模型的数学能力显著提升,已能解决多个领域的重要未决问题。但数学家们指出,AI公司以“解决了多少难题”作为模型能力基准,这与数学共同体的追求存在严重错位——重要的未解问题如同数学世界的“地标”与“灯塔”,其价值在于解决过程中产生的新洞见、方法和概念,这些成果还需经报告、讨论和简化,沉淀为教材与工具,往往历时数十年甚至数百年。
声明强调,“解决问题只是实现概念理解和洞察这一首要目标的工具和代理指标”。若以批量生产"真/假"结论衡量进展,被优化的只是指标本身,反而可能摧毁孕育思想的沃土。
声明还指出,一些AI解答被匆忙宣布,缺乏规范的论文写作、新方法提炼和对前人工作的引用,带来成果归属与抄袭问题;即使AI产生正确的新思想,若没有数学家将其整合进知识体系,知识传承链条也会断裂。
更深层的担忧在于人才培养。数学最宝贵的资源是学生与思想,解题训练的真正目的是发展研究能力。若答案可直接获得,人类是否还会经历形成理解、提出新问题的必要训练?
签署者由此将问题扩展至更广泛的智力劳动领域:许多行业的专业训练本为发展理解与提问能力,而AI正直接产出这些工作的结果,造成普遍的目标错位。
声明并不拒绝AI,肯定其加速数学研究的潜力,认为关键在于掌握技术者如何选择。它呼吁数学共同体、AI公司和社会共同面对一个根本问题:当机器越来越擅长给出答案,人类究竟希望从研究中得到什么?当AI改变工作的完成方式时,不应忘记这些工作最初希望实现什么。
新闻拓展:
突发!陶哲轩、邓煜等25位菲尔兹奖得主联合声明:AI公司正在摧毁数学
02
计算机图形学领军人物童欣加入Meshy,出任首席科学家
AI万象
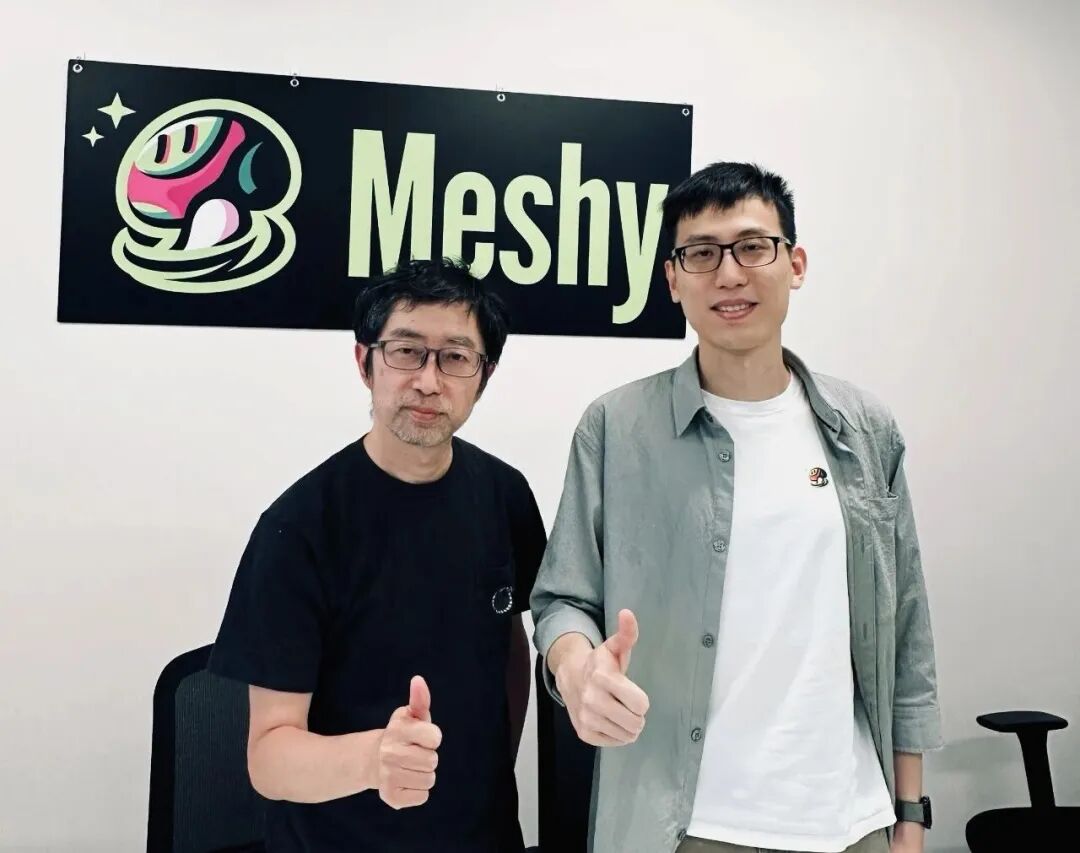
9月7日,AI 3D生成平台Meshy宣布,计算机图形学与3D视觉领域最具影响力的研究者之一童欣博士正式加入公司,出任首席科学家。
这一任命标志着Meshy的科研发展进入新阶段:研究重点正从单个3D资产,拓展到能够理解、创造并持续运行完整数字世界的系统。Meshy希望让3D成为承载人类创造力的基础媒介——个人创作者可以轻松上手,专业制作团队能够获得足够强大的创作能力,同时以更丰富的表现力催生全新的交互体验。
作为首席科学家,童欣将负责制定Meshy的长期科研战略,带领团队在下一代3D基础模型方向开展研究,推动多模态世界模型与实时交互系统的探索和突破。他还将参与研究团队建设与人才培养,助力研究成果转化为服务全球创作者、开发者和工作室的模型与产品。
公开资料显示,童欣于1999年获得清华大学博士学位,同年加入微软亚洲研究院,此后在该机构工作25年,曾领导网络图形组,并担任全球研究合伙人(Partner Research Manager)。职业生涯中,童欣共发表论文190余篇,其中60余篇发表在ACM SIGGRAPH和ACM Transactions on Graphics 上。据Google Scholar统计,截至2026年9月,其研究成果已被引用超过21,000次,H指数达到80。
他的研究覆盖了现代3D智能的多个核心问题。他与合作者在SIGGRAPH 2017发表的O-CNN提出了一种基于八叉树的高效架构,使深度学习能够高效处理高分辨率3D形状。近年来他共同参与的研究还包括结构化3D生成模型TRELLIS、单图几何估计模型MoGe,以及能够对三角网格进行全局光照神经渲染的RenderFormer。过去两年,他带领团队在基于视频的角色表演模型方向进行了一系列探索。
童欣还长期推动图形学研究走向大规模产业应用。他带领团队的研究成果已落地于微软多项产品与平台,包括Xbox游戏开发技术、Windows中的3D打印功能以及Direct3D。
与此同时,Meshy也在将研究拓展到实时交互世界,这一方向正通过Mora项目逐步落地。Mora是Multimodal Open-world Real-time Architecture(多模态开放世界实时架构)的缩写。Mora 1现已在mora.fun开放体验,它将编程智能体、Meshy 的 3D生成技术与实时视频模型结合起来,创造出人们能够进入、互动并重塑的世界。
Mora初步验证了童欣未来将参与引领的重要方向:把空间理解、生成能力与实时交互融合进同一个系统。Meshy方面表示,对这一方向的探索,有望让AI成为源源不断创造快乐和体验的力量。
新闻拓展:
图形学宗师童欣加盟Meshy,要做“AI for Fun”的头号玩家
03
AI万象

部分人像交易平台办理授权流程十分便捷,普通人完成资料提交与审核,半小时之内就可以把自己的肖像放到平台等待交易。平台会对收集到的人像素材做技术处理,生成适配各类故事题材的数字形象包。
这类交易大多属于有限授权,并非买断肖像权,合同会对使用周期、投放渠道、播出地区、角色用途、二次加工权限等做出约定。
在定价上,普通素人和专业演员差距明显,素人每部作品授权费用约100元,演员则根据剧集规模、使用范围,报价从五百到数千元不等,平台会在成交之后抽取分成。
有平台上线两个月,就完成百余笔交易,交易总额接近7万元,素材库当中专业从业者占八成,普通民众仅占两成。人脸授权火热,根源在于AI短剧产业巨大的素材缺口。
行业数据显示,今年前五个月AI短剧市场规模突破220亿元,全年有望冲击400亿元,一季度上线的微短剧当中AI短剧占比超95%。AI直接生成的虚拟人脸往往辨识度不足,表情生硬,观感较差;基于真人面部素材生成的数字角色会更加自然真实。
一部短剧往往需要数十位角色,海量的作品产出,让真人面部素材成为刚需。与此同时AI短剧出海势头强劲,海外市场规模快速扩张,也进一步拉动不同人种面孔素材的市场需求。
但可观收益背后也潜藏不容忽视的风险。人脸属于高度敏感的生物信息,部分平台在还未签订协议的阶段,就要求用户提交素颜照片用于定级审核,照片流向缺乏约束。
部分机构采集大量多角度照片、动态视频,一旦数据泄露或者被挪作他用,会给当事人带来长久隐患。
监管也在跟进补齐制度短板。2026年4月发布的《数字虚拟人信息服务管理办法(征求意见稿)》明确,利用自然人面部、声音等敏感信息制作虚拟形象,原则上需要获得当事人单独同意,为行业划定合规底线。
新闻拓展:
AI时代,真人脸更值钱了!一位银行职员3天“卖脸”7次,收入2500元!交易平台谈赚钱逻辑:AI脸已审美疲劳,素人脸可能更有机会
04
大平台动作

相比上一代ChatGPT Images 2.0,新版本最直观的变化是生成时延降低,官方数据显示图像生成延迟最高可减少50%,大幅缩短用户等待图片输出的时间。
除速度优化外,模型在画面细节、光影材质还原能力上得到强化,重点解决旧版本多轮编辑容易出现主体变形、构图崩坏的痛点。当用户对图片进行局部修改指令时,模型可以精准锁定需要调整的区域,保留原图人物主体、产品外形、画面构图与整体风格,大幅降低创作者反复调试提示词的成本。
产品端配套新增多项创作工具,其中Sketch手绘功能是本次更新的亮点,用户不需要具备专业绘画功底,仅勾勒基础构图就能快速把构思转化为成品图。
ChatGPT Images 2.5现已面向所有ChatGPT、ChatGPT Work和Codex用户开放,支持桌面端、移动端和网页端。
此外,GPT-Image-2.5 Sunburst和GPT-Image-2.5 Flare模型已通过API提供。Flare作为通用版本,具有2.5系列速度、画质与编辑能力,适合社交媒体素材、产品原型、大批量图像生成场景;Sunburst主打高精度精细编辑,面向广告大片、商业产品图等专业生产级视觉内容,图像可控性更强,但生成耗时更长。
在AI图像生成赛道,ChatGPT Images 2.5的核心差异化优势在于深度嵌入对话交互链路。当前市场中,Midjourney在艺术质感、电影感画面输出上仍保持优势,但产品缺少原生对话交互与草图输入能力,上手门槛更高;Adobe Firefly依托创意软件生态,在商用版权保障方面更有竞争力,但独立对话创作能力偏弱;谷歌Gemini内置图像模型在品牌一致性控制上仍存在短板。
据OpenAI披露,ChatGPT Images系列模型及对应API每周图像产出总量超过30亿张。
本次图像模型更新,是OpenAI近期密集产品迭代之一。就在9月3日,公司发布旗舰大模型GPT-6 Astra,强化自主计算机操作、复杂推理、编程与科研任务处理能力,支持直接识别屏幕像素并模拟键鼠操作,可直接操作各类软件界面,被视作其推进智能体能力的重要一步。
OpenAI联合创始人兼总裁格雷格・布罗克曼在发布电话会议上表示,“欢迎来到AGI时代”。
9月7日,黄仁勋在社交平台发文称,OpenAI从发布ChatGPT到o1再到Astra只用了4年。“AGI已经到来,恭喜OpenAI团队。”
不过,9月6日,OpenAI首席科学家雅各布・帕乔基(Jakub Pachocki)在官网发布万字长文,称人类已经创造出一套难以完整理解的智能体系,全人类尚未做好应对超级智能快速演进的准备,呼吁全球AI研发主动放缓全速扩张节奏。
新闻拓展:
GPT Image2.5悄悄上线,靠提示语提升AI生图可控性的时代要过去了
05
大平台动作

新闻拓展:
倒计时28天,Meta憋了两年的“秘密武器”终于要亮相了?
06
华为发布首个韬定律芯片麒麟9050Pro,用于三折叠新机
大平台动作
新闻拓展:
华为时隔六年再发布高性能芯片,麒麟9050 Pro带Mate XT 2“展翼高飞”
07
定价下调,DeepSeek V4.1 Flash模型正式发布
新力量崛起
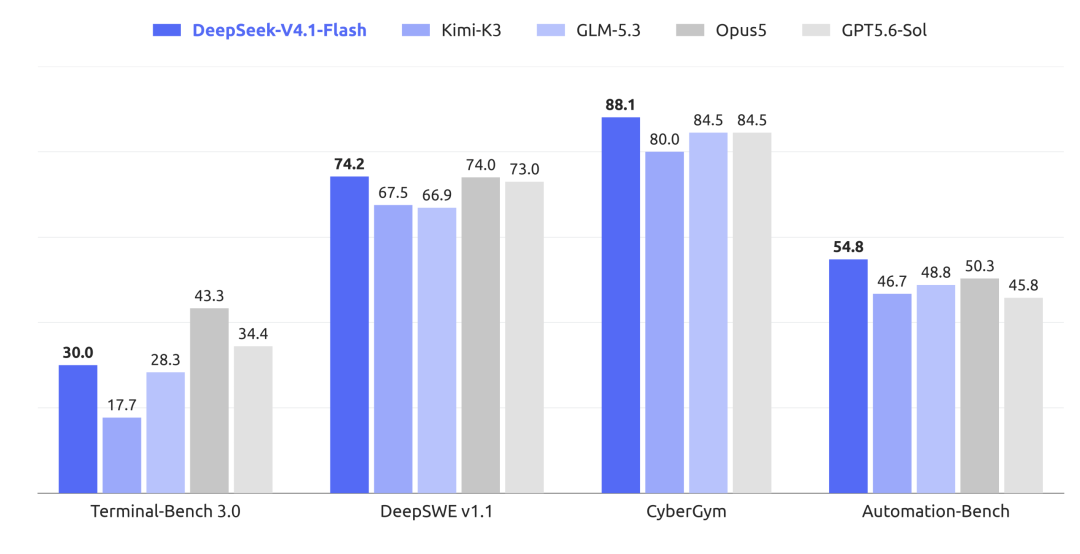
DeepSeek V4.1 Flash为552B参数的MoE模型,采用了全新的Causal-Encoder-Decoder结构,输入和输出不对称,输入激活只有8B,输出激活16B,成本显著低于已知的同尺寸模型。同时,V4.1 Flash还采用了新的预训练方式、经过了更大规模的强化学习后训练,在基准测试中,成功超越了包括DeepSeek V4 Pro在内的一众旗舰模型的智能水平。
新一代模型大幅减少了KV Cache缓存的大小,与上一代模型相比,对HBM的需求减少到1/4,对 SSD的需求减少到1/8。在Agent使用场景中,缓存命中的费用往往占比较高,对KV Cache的压缩大幅降低了Agent类任务的使用成本。
DeepSeek V4.1 Flash已同步上线DeepSeek API,原生支持多模态,将模型名称更改为deepseek-flash即可调用最新的V4.1 Flash模型。旧版本模型V4 Flash与V4 Flash Vision Exp现已下线,出于兼容考虑,模型名deepseek-v4-flash、deepseek-v4-flash-vision-exp将被暂时路由到V4.1 Flash。
同时,经多方测试,DeepSeek V4.1 Flash在性能、费用、速度、总用时等各项指标上已全面超越V4 Pro。基于此,官方计划有序下线V4 Pro模型。北京时间2026年9月14日12:00起,至未来V4.1 Pro上线之前,用户访问deepseek-v4-pro的请求将全部路由至V4.1 Flash,并按V4.1 Flash单价计费。
目前,腾讯(WorkBuddy、CodeBuddy)和OpenCode作为官方合作伙伴,已全量接入DeepSeek V4.1 Flash。
定价方面,得益于模型架构的创新,DeepSeek V4.1 Flash能够以更低成本服务更多用户,官方相应下调了该模型定价。同时,为更合理调配资源,该模型仍采用峰谷定价,闲时价格为高峰时段价格的一半,以鼓励用户根据实际使用情况调整任务时间。新价格于2026年9月10日12:00起生效。
新闻拓展:
刚刚,DeepSeek 新模型突然上线,Flash 的模型,Pro 的野心
08
2027年交付!小鹏首位人形机器人自主走下产线
新力量崛起
09
投融资风向
新闻拓展:
234亿!“欧洲版OpenAI”融资了
10
投融资风向
新闻拓展:
燧原的命,攥在腾讯手里
信息来源:WAIC综合整理