
 五度妙笔
 企业透视镜
 API商城

 数据库
DeepSeek-V4-Flash-Vision-Exp 模型已开源,多模态 Agent 能力接近 Opus-4.8
发布时间:2026-08-31来源:IT之家
感谢IT之家网友
fakepheonix
、
软媒新友2156291
、
Domado
、
陈倔强123
的线索投递!
IT之家
8 月 31 日消息,刚刚,DeepSeek V4 首个多模态模型
DeepSeek-V4-Flash-Vision-Exp
在 Hugging Face 上线,采用 MIT License 开源。
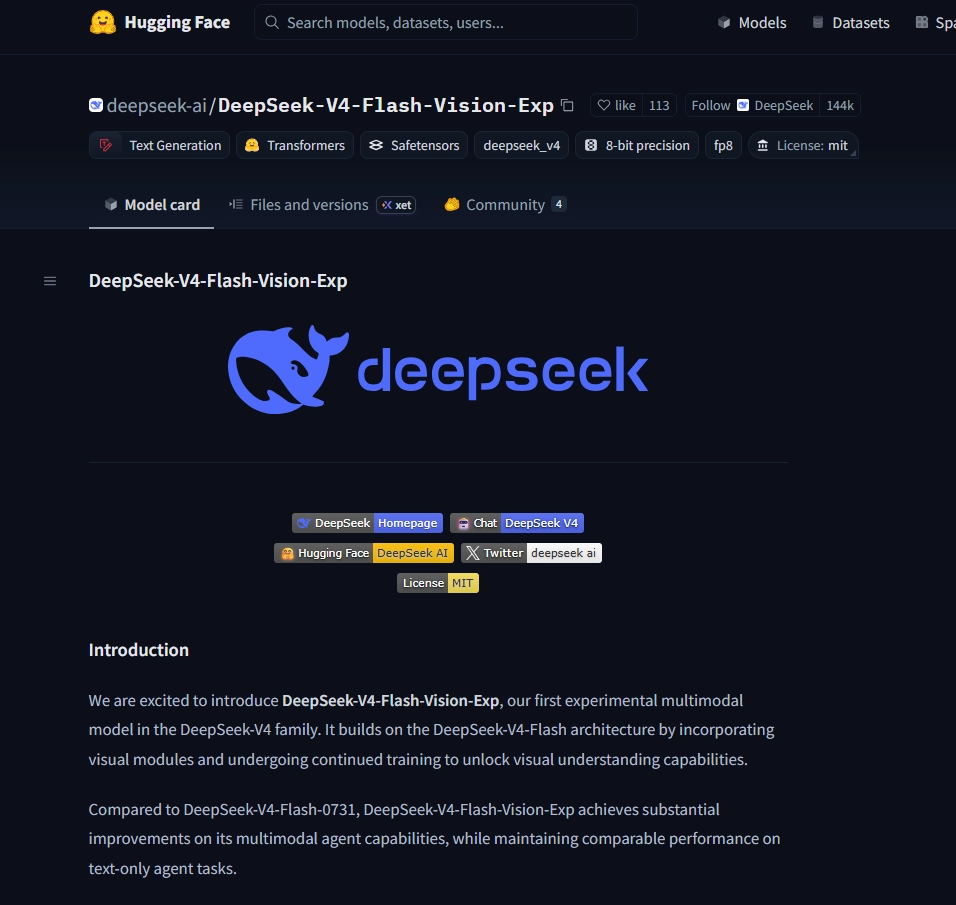
公开内容包括模型文件、Tokenizer、Prompt Encoding 参考实现,以及最小化 PyTorch 推理实现,覆盖视觉编码器、Aligner、DFlash Attention、MoE、Hyper-Connections 与 DSpark 等核心模块。
据IT之家了解,
DeepSeek-V4-Flash-Vision-Exp
是 DeepSeek V4 系列首款原生支持图片输入的视觉模型,官方明确标注为“Exp”实验版本,于 2026 年 8 月 21 日上线 DeepSeek API 平台。
该模型支持在文本之外输入图片,可以让模型描述图片、识别截图中的文字、分析图表等。支持的图片格式包括 JPEG、PNG、GIF、WebP。
深度求索官方表示,V4-Flash-Vision-Exp 在各类 Agent 框架内展现出了较好的多模态适配能力,能够有效支持大家借助多样化的 Agent 工具解锁更多实用的工作场景。在 Agent、推理、世界知识等纯文本任务上与 V4-Flash 正式版持平,原有优势完整保留。在需要视觉理解的 Agent 基准测试中较 V4-Flash 大幅提升,多模态 Agent 能力已接近 Opus-4.8。
转载说明:本文系转载内容,版权归原作者及原出处所有。转载目的在于传递更多行业信息,文章观点仅代表原作者本人,与本平台立场无关。若涉及作品版权问题,请原作者或相关权利人及时与本平台联系,我们将在第一时间核实后移除相关内容。


