五度妙笔
 企业透视镜
 API商城

 数据库
长程 Agent 的上下文压缩:轨迹内容与执行位置
Agent 执行一项持续较久的任务时,上下文会不断积累。用户补充的要求、工具返回的结果、已经尝试过的方案,以及中途调整过的计划。为了控制输入长度,一些运行框架会定期把较早的交互整理成摘要,再让 Agent 带着摘要继续执行。这类操作通常称为上下文压缩(Compaction)。
Anthropic 在官方教程中直接说明了这种取舍。摘要会保留目标、决策和主要发现,较早交互中的具体动作顺序则不会被完整保留。压缩提示词决定了保留内容的侧重。
现有的上下文压缩方法往往隐含了一个假设:摘要越短,只要保留了任务相关内容,就足以接替原始交互历史。但长程 Agent 的历史还记录着一段已经发生的执行过程,TRACE 论文就在关注,上下文压缩之后,执行过程里的一些重要信息会不会丢失。作者指出,交互历史还为 Agent 判断当前执行到哪里提供了依据。内容被整理成摘要以后,这种作用能保留多少,需要通过后续行为来检验。
原始交互记录有明确的先后顺序。Agent 发出动作,环境返回结果,Agent 再根据结果继续行动。一次失败可能使原计划失效,一次成功可能意味着某项操作已经无需重复,一条完成反馈也可能意味着任务应当结束。
这些记录中的事实与顺序共同影响下一步决策。即使摘要保留了目标、关键发现和“某项工作已完成”的进度标签,模型仍然需要从这份表示中判断,先前的动作和结果现在应当怎样约束自己的行动。论文将这种判断概括为对“执行位置”的识别。
这与工作交接中的一个困难相近:交接材料写清了项目背景和各项进展,接手的人仍需要据此判断当前该推进哪一步。摘要也可以明确记录执行顺序和当前进度,但写进摘要与模型在下一步有效利用这些内容,是两个需要分别检查的环节。
TRACE 在 AppWorld 中研究了这一问题。AppWorld 提供带有持久状态的模拟应用,Agent 通过 API 完成任务,许多先前查询过的业务信息可以再次获取。论文的主要行为实验使用 MiniMax-M3,运行框架由 OpenClaw 一个固定版本的循环压缩逻辑改造而来。
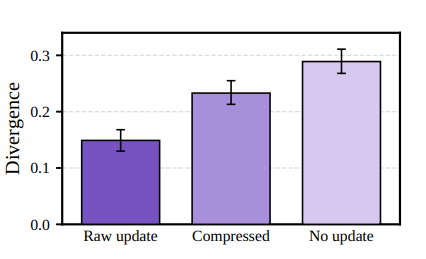
作者先比较了近期交互的不同呈现方式。在同一个决策位置,以完整原始历史作为参照,再分别给 Agent 提供“旧摘要加上未经压缩的新交互”“吸收了新交互的更新摘要”,以及“省略新交互的旧摘要”。各组随后接上相同的后续记录,并多次采样下一步行动。
结果呈现出一个梯度。保留新交互原文时,行动分布相对完整历史的偏离为 0.149;把新交互压入摘要后,偏离增至 0.233;完全省略这段交互时,偏离为 0.289。这组数值衡量的是行动选择的变化程度,不能换算成错误率。摘要保留了近期交互的部分行为作用,但与原样保留相比,Agent 的后续选择发生了更大的变化。
另一组实验检查了任务结束前的决策。在相同任务、环境和决策位置,作者比较摘要、只保留近期原始记录,以及完整历史三种条件。摘要条件下,Agent 更容易继续操作或输出多余内容,直接结束任务、按要求结束任务的比例均有所下降。
这两组观察使“执行位置”有了具体含义。需要检查的内容包括近期结果能否改变下一步行动,以及已经完成的工作能否让 Agent 及时停止。
现有研究中已经出现了把任务执行结果用于评价压缩的方式,例如ACON论文。ACON 会分析同一任务在完整上下文下成功、在压缩上下文下失败的执行轨迹,据此修改压缩规则。TRACE 将观察范围进一步缩小到一次具体的压缩事件。
一条长任务轨迹可能经历多次压缩。最终成功的任务,中途也可能反复查询、付出额外成本;最终失败的任务,原因也可能出在工具使用或任务判断上。任务级结果可以评价整体方案,却难以直接指出某次压缩带来的影响。
TRACE 在压缩发生的位置保存环境状态,再从相同状态分别继续运行两组 Agent。
PRE 使用的是这次压缩发生前可见的上下文,其中可能已经包含更早的摘要。POST 也保留了最近一轮原始交互。两组条件对应的是运行框架实际发生的一次上下文替换。
与前面只采样下一步选择的实验不同,这里的动作会真正交给工具执行,工具结果也会返回 Agent,影响接下来的决策。作者在 590 个压缩位置上进行了 4,640 条局部续跑,每条至多执行五个动作,以多次采样估计上下文替换后的行为差异。
评测主要记录两类现象。一类是工具执行触发环境明确报告的错误;另一类是出现与此前相同的工具调用,包括重新查询信息和重复尝试操作。实验中,压缩后的第一步就出现了更多执行错误,后续几步还出现了更多重复调用。
作者随后尝试利用这些局部结果优化压缩提示词。在选出的 12 个训练位置上,每处生成三个候选摘要,通过续跑结果形成优劣对照,再让模型提出五份候选压缩模板。最终采用哪份模板,仍由完整开发集任务的表现决定,选择标准是任务在两次独立运行中都成功的比例。
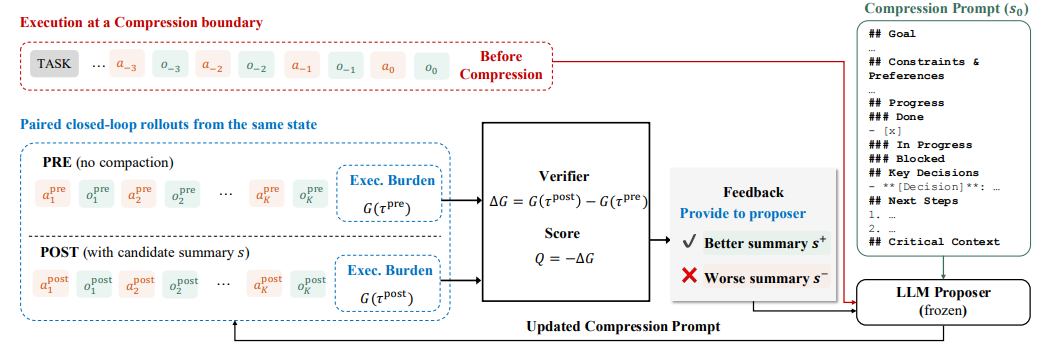
局部评测与完整任务评测在这里各有用途。前者帮助比较一次压缩造成的短期执行负担,后者检查修改后的压缩策略在整条任务轨迹中是否有效。
TRACE 观察到三类现象:近期交互被压入摘要后,下一步行动相对完整历史发生更大偏移;任务结束前,Agent 更容易继续行动;压缩后的几步中,被拒绝的动作和重复调用有所增加。这些结果支持特定实验条件下存在行为差异。
论文没有完全区分这些变化的来源。信息可能在压缩时被遗漏,任务进度可能被表达失真,写进摘要的信息也可能没有被模型有效利用。“执行位置识别受到影响”能够统一解释观察到的现象,当前实验还没有把它分离成单一、确定的因果机制。
另外,现实中的开放网页、真实邮件、CRM 和人工审批往往难以恢复到完全相同的外部环境状态。AppWorld 可以在每个压缩位置恢复相同的应用执行状态,使 PRE 和 POST 从同一外部状态开始局部续跑;许多先前信息也可以通过 API 重新查询,离开上下文并不意味着信息永久丢失。这两个条件分别支撑了压缩前后的局部对照和对“信息遗漏”解释的进一步分析。TRACE 的局部行为实验仍基于论文采用的循环摘要压缩配置,也没有覆盖其他任务环境和压缩机制。现有结果适合视为一种早期证据和诊断方法,还不足以说明各类长程 Agent 都会以相同方式受到压缩影响。
现实中的上下文管理已经包含多种取舍。Anthropic 的教程除摘要压缩外,还介绍了清理旧工具结果的方式:较大的返回内容可以被占位符替换,工具调用记录仍然保留。这两种处理会留下不同的历史信息,也会改变 Agent 后续重新获取信息的条件。
OpenClaw 的压缩文档则明确区分较早历史和近期消息。较早内容被整理成摘要,近期消息继续以原始形式进入后续上下文;切分交互记录时,还会维护工具调用与返回结果的配对关系。
这些实现说明,设计压缩策略时,可以分别决定旧历史的摘要方式、近期交互的保留范围,以及工具结果的清理方式。评测也应当对应具体实现,不能仅凭“使用了压缩”就推断后续行为。
TRACE 采用了由 OpenClaw 固定版本改造的实验框架,实验中的模型、预算和任务环境也有明确设置。其结果不能直接作为当前 OpenClaw 产品或 Anthropic 压缩服务存在同类问题的证据。
摘要是保留历史的一种方式,运行框架还可以显式维护一部分能够由程序确定的执行信息。《Turning Interaction History into Execution State》提出的 Ledger,便在代码 Agent 外增加了一层执行记录,用确定性规则更新状态,不额外调用语言模型。
例如,Agent 曾经读取一个文件,后来又修改了这个文件。执行轨迹中两件事都被保存下来,但此前读取的内容可能已经过时。Ledger 会记录实际返回过的文件及行范围、后续修改,以及已经尝试过的命令,帮助区分“相同条件下的重复操作”和“修改之后有必要重新执行的操作”。
这些记录通过两个位置影响执行。模型生成动作前,系统把当前状态整理成一份简短视图,告知先前观察是否仍然有效。命令执行前,系统再检查已有记录;对于满足条件的重复读取,可以返回对先前结果的引用。重复测试等操作则可能只收到提示,仍然允许执行。复用旧结果还要求结果在当前上下文中可见,避免把 Agent 指向已经被移除的内容。
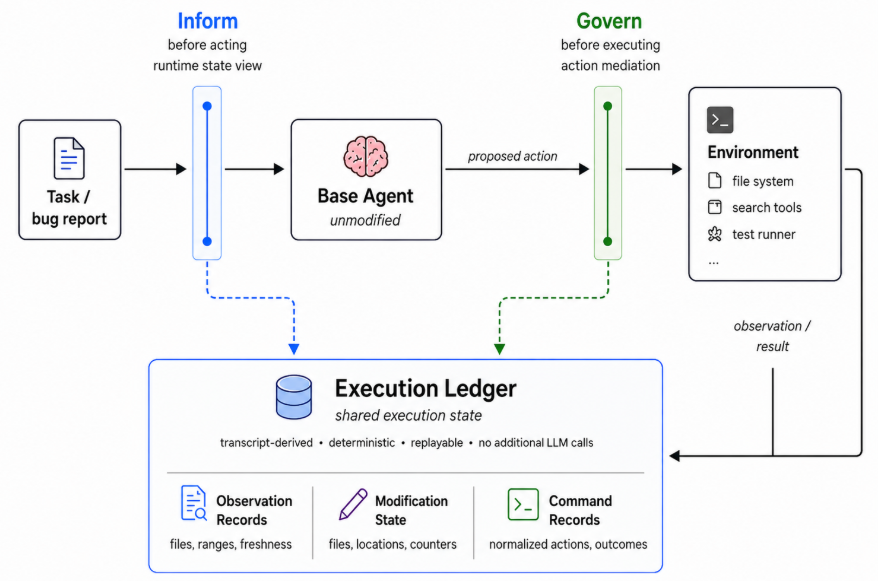
在 SWE-bench Verified 的 500 个代码修复任务上,Ledger 配合 mini-swe-agent 和 GPT-5 mini 时,Pass@1 从 56.2% 提高到 64.2%,总成本下降 28.9%。这些数字对应状态提示和动作干预共同作用的完整系统,不能单独归因于增加了一份状态记录。
Ledger 维护的是能够从工具行为中推导的执行事实。任务目标是否仍然成立、修复方案是否合理,仍由模型判断。它没有验证 TRACE 的压缩结论,但说明部分执行信息可以由运行框架显式维护,减少模型反复从长历史中推断同一事实的负担。
TRACE 为可复位的测试环境提供了一种诊断方法:从相同的外部环境状态出发,比较 Agent 带着压缩前后的上下文继续执行时的行为。它能补充任务成功率、成本等整体指标,但目前观察的主要是压缩后几步内的报错和重复探索,较晚出现的影响仍需完整任务评测。
结合现实中的Agent编排以及工程化,长程 Agent 的上下文工程需要把执行进度作为组织信息的依据。“与任务相关”还不足以决定一条记录该怎样进入上下文:已经完成的计划仍与任务有关,却不应继续被当作待办;旧版本的文件内容仍可能有参考价值,却不能不加区分地作为当前修改的依据。筛选、压缩和重新组织历史时,需要保留这些区别,让模型能够判断过去的信息在当前阶段应当怎样影响行动。
沿着这个思路,保留近期原始交互、压缩旧历史、显式维护部分执行信息,应当放在同一个上下文设计中考虑。程序能够确认的变化,不必都留给模型从历史中重新推断;需要模型使用的状态,也应在相关决策发生时进入上下文。具体采用哪种组合,要结合任务验证。
Guanghui Min 等,Toward Reliable Context Compression for Long-Horizon Agents: An Empirical Study of Execution Instability。arXiv:2608.06503,2026 年 8 月 6 日,v1。https://arxiv.org/abs/2608.06503 - Minki Kang 等,ACON:
Optimizing Context Compression for Long-horizon LLM Agents。arXiv:2510.00615,2025 年 10 月首次提交,2026 年 6 月更新至 v3;ICML 2026。https://arxiv.org/abs/2510.00615 - Anthropic,Context engineering:
memory, compaction, and tool clearing。Claude Cookbook,官方教程。https://platform.claude.com/cookbook/tool-use-context-engineering-context-engineering-tools OpenClaw,Compaction behavior and settings。OpenClaw 官方文档。https://docs.openclaw.ai/reference/session-management-compaction/compaction Zehao Wang 等,Turning Interaction History into Execution State: A Runtime Layer for Long-Horizon Coding Agents。arXiv:2608.00808,2026 年 8 月 1 日,v1。https://arxiv.org/abs/2608.00808