
 五度妙笔
 企业透视镜
 API商城

 数据库
人类造出的最后一个 AI:万字拆解 RSI
单击上方“图灵人工智能”,选择“星标”公众号
您想知道的人工智能干货,第一时间送达
转自极智域,仅用于学术分享,如有侵权留言删除 2026 年 9 月,上海交通大学 Theseus Lab 联合字节跳动、 ModelBest 、智源、 XiongAnshou 、 Humanlaya 、 Agent-Native Research Lab 与上海人工智能实验室,挂出一篇 70 页的综述:《 The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement 》。
标题本身就是一个思想实验:如果存在"最后一个由人类亲手建造的 AI",那它之后的 AI ,是谁造的?这篇论文的回答是——递归自我改进( Recursive Self-Improvement, RSI )。

一、开发流水线先撑不住了:这不是科幻,是账单
先看三组数字,全部来自论文引言:
模型训练本身仍然昂贵: Kimi K3 激活了 896 个专家中的 16 个,相比 K2 把稀疏激活的扩展效率提升了约 2.5 倍; NVIDIA Nemotron-4 的模型蒸馏用了 40 万条合成样本; OpenAI GPT-5.5 的数据质量团队动用了约 1320 名专业标注员、合计约 9240 人时。
更棘手的是部署之后的持续适配: Anthropic 报告 agentic 工作负载的 token 用量约为普通 chat 的 4 倍,到 multi-agent 系统因更长上下文、协调与端到端验证,这一倍数升至约 15 ; Meta 的 FBDetect 每周发现数千个基础设施回归,诊断一次约耗工程师 10 人时。
论文的判断很直接:靠人类写 SOP 、人类排实验、人类审回归的模式,正在从"可行"变成"瓶颈"。 RSI 要解决的,不是"让 AI 更聪明"这种老命题,而是——
能不能把"协调改进过程"本身,变成 AI 的一个持久能力?
二、 RSI 到底是什么:改进环九件套
论文把 RSI 定义为:
AI 通过与任务、环境或其他智能体持续交互,自主地把经验与反馈转化为对自身的持久修改;并且这些修改本身会影响后续改进的产生、评估与巩固。
这个定义里有三个关键词:自主、持久、被自身改进。前两个词不算新鲜——持续学习也能把新任务的知识写进模型; Agentic AI 也能自己跑实验。真正把 RSI 与邻居划开的,是第三个词。
为了把"改了什么、留下什么、谁说了算"讲清楚,论文把任何一次自我改进拆成一个改进环( improvement loop ),九件套:
九件套只问三个问题:环在哪里合上?什么被持久化、传给下一轮?改进过程中的哪些决定,仍然握在人类手里?
这把尺子贯穿全文。后面我们会看到,所谓"B0 到 L5",本质就是这三个问题的答案逐级从人手里移到 AI 手里。
三、一把新尺子: HCI 与四个公式
要谈"AI 还剩多少没搞定",论文拒绝沿用绝对分数,而是提出 Headroom-Closed Index ( HCI ,剩余闭合指数)。它的设计哲学是:不要问模型考了多少分,问它从"这一年这个 benchmark 的入门水平"爬到"满分"还有多远。
3.1 多源加权共识
当多个团队报告同一 benchmark 时,先按来源加权求共识分:
s̄mbh = Σi Ŷi·s̄imbhΣi Ŷi (1)
其中 h 是评测协议, i 是不同来源;论文按 benchmark 主办方、独立 common-harness 评测、模型作者报告三类,权重分别取 3 、 2.5 、 2 、 1 ,并对一方自评值额外乘 0.75 。
3.2 HCI 归一化
把每个 (模型 m, benchmark 族 b, 协议 h) 的分数归一到 0–100 :
Hmbh = 100 × s̄mbh − Fb,0100 − Fb,0 (2)
Fb,0 是该 benchmark 族进入数据集那年的 90 百分位模型分数。于是 H=0 表示"刚刚摸到这一年的前沿", H=100 表示"满分"。
3.3 领域级年度轨迹
单个 benchmark 会被刷榜污染,所以再按年度、按领域聚合:
Td,y = Σb∈Bd,y √nb,y Qb,yΣb∈Bd,y √nb,y (3)
nb,y 是那一年贡献该 benchmark 族前沿的模型数量。用平方根加权,是为了让"覆盖广的 benchmark 族"贡献更大,但又不让数据集最大的那一个家族霸榜。
3.4 剩余空间有多大
最后,论文给出一个示意性的 RSI 扩展增益估计:
Rd = 100 − 0.22 × (100 − Td,2026) (4)
它的意思是:剩余空间越大的领域, RSI 能带来的延伸越多。
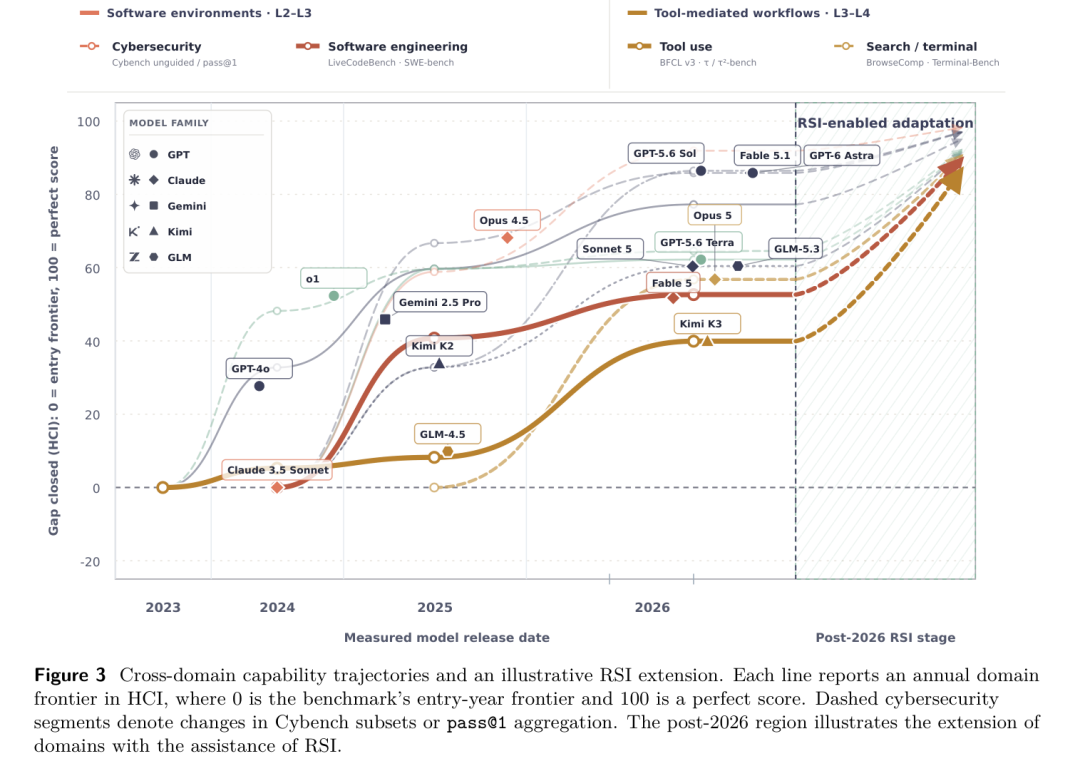
▲ 论文 Figure 3 :实线为 2023–2026 实测的各领域 HCI 前沿轨迹;右侧虚线区是论文示意的"RSI 介入后"的延伸。注意软件工程(红)与工具/终端(金)两条线在 2025–2026 明显变平——这正是 RSI 最有价值的地方。
三条观察支撑了后续整本书:
四、与邻居划清界限: RSI ≠ 持续学习 ≠ AutoML ≠ Agentic AI
自我改进这个词被用得太滥,论文专门拉了一张表,把 RSI 与三个常被混淆的范式放在九个维度上对比。
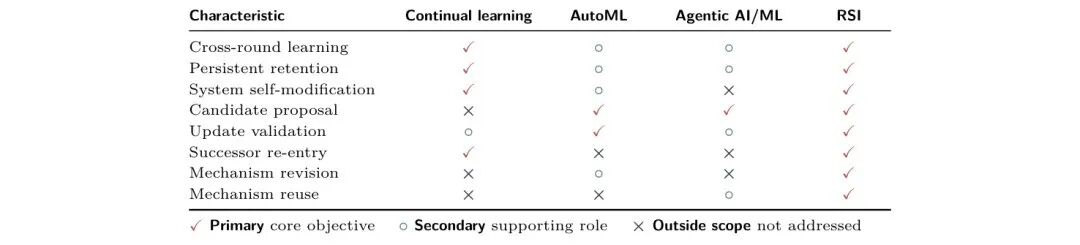
▲ 论文 Table 1 :✓ 主要核心目标,◯ 次要支撑角色,✕ 不在其范围。一眼看出:只有 RSI 把"机制修订"和"机制复用"同时打勾。
逐行读这张表:
论文一句话点题:
RSI 的关键问题,不是"AI 是否参与了 AI 的开发",而是围绕系统自身是否已经形成一个持久的改进环,以及这个环上有多少决定已经内生于 AI 自己。
五、 B0 → L5 :六级自治阶梯
这是全文最核心的贡献。论文不按"用了什么算法"分类,而按改进环里的决定被内化了多少,把现有系统排成六级。
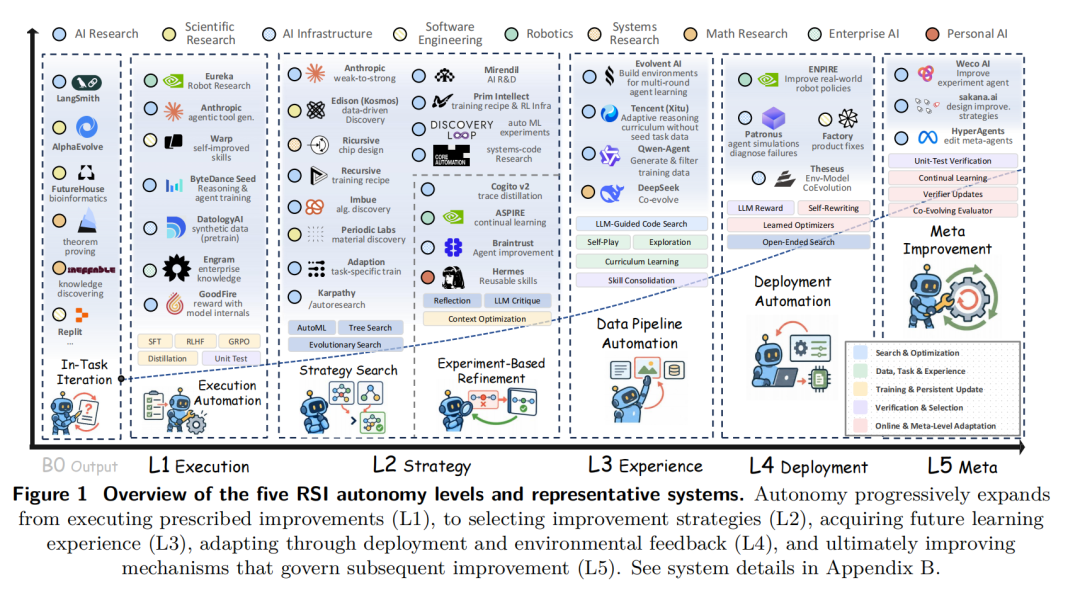
▲ 论文 Figure 1 :从左到右, AI 接管的改进责任越来越多。 B0 只改输出, L1 执行流程, L2 选策略, L3 定学什么, L4 接部署反馈, L5 改"改的机制"本身。
B0 :只改输出,不改系统(参考边界)
B0 不是 RSI ,它是"还没上 RSI 的基线"。系统在同一会话内反复生成-批评-修正,但任务一结束,过程清零。 Self-Refine 、 Reflexion 把反思写进临时上下文 buffer 、 Tree of Thoughts 在候选分支间搜索——都属于这一层。
论文列了 B0 的四个局限:经验不跨任务积累、改进流程仍由人类定义、自我生成的反馈可能强化错误( Self-Correction Bench 里模型找不到错误根因)、在固定评测下多轮迭代边际收益递减。
B0 与 L1 的分界线:改完的东西,会不会被带进下一次独立任务?
L1 :执行人类写死的改进流程
到 L1 , AI 不再只改一次输出,而是执行一条人类写好的改进 SOP,并且执行结果跨任务保留。论文把工业界实践拆成六层流水线:
L1 与 L2 的分界线: AI 是照着流程走,还是自己决定下一步试什么?
L2 : AI 自己选下一刀改哪里
人类仍写死目标、任务边界、验收标准,但改哪里、怎么改由 AI 看完诊断结果后自己拍板。论文把 L2 按"改进对象"再分四条线:
forward 函数,元 agent 在验证集上选 agent ; AFlow 把 workflow 编码成可执行图做蒙特卡洛树搜索;OpenAI 把这一层称为 automated researcher——不是让 AI 无限制自由探索,而是"观察 → 诊断 → 选干预 → 实例化测试 → 保留或回退"这个循环被自动化。
L2 与 L3 的分界线: AI 是在现有经验池里挑,还是自己决定下一轮要攒什么新经验?
L3 : AI 自己决定下一轮学什么经验
L2 决定"怎么改", L3 决定"学什么"。系统根据当前能力、失败和学习史,自己选/生成/寻找下一轮训练数据。
论文给了两条路径:
路径一:自适应任务生成与自博弈。
- SSP ( Search Self-Play ):题目生成器和求解器同步演化,求解器变强,题目自动变难;
- AZR ( Absolute Zero Reasoner ):单一模型同时提题+解题,用求解器可解性奖励题目生成;
- R-Zero: Challenger-Solver 架构,用多个回答的一致性估计题目难度;
- STP:联合训练证明器与猜想生成器; PSP ( Propose-Solve-Verify ):候选题目在被用来训练前先通过规格化校验;
- ViaPlay:图像条件问答 + 推理器,问题投票过滤大多数人答错的题。
路径二:与环境交互自主练习。
- Voyager: Minecraft 里自动课程 + 持久技能库,成功行为写成可执行代码,后续任务直接调;
- SiMA: ASKA 自改进设置下,用 Gembased reward model 把练过的任务分级,弱任务继续训;
- SEAgent: GUI 操作经验蒸馏成"软件指南书"( software guidebook ),后续任务按指南书生成。
论文特别警告 experience corruption (经验腐化):错误的难度代理会引导模型刷无用的题;错误的 judge 会让持久记忆里留下错误假设。 L3 的自主不等于可靠。
L3 与 L4 的分界线: AI 是在实验室/仿真里攒经验,还是在真实部署的用户流量里学习?
L4 :部署反馈被蒸馏成持久状态
到 L4 ,改进 loop 用真实部署交互决定持久状态怎么改。论文把 L4 的机制分三类:
论文引用了一项重要发现——Harness Benefit:在同一个冻结模型上,一个小模型配演化过的 harness 拿到的分,可能和一个大模型配默认 harness 一样高;但 harness 被改进后非单调地变化,失败模式高度集中。"会用 harness"和"会改 harness"是两种不同能力。
L4 与 L5 的分界线: AI 改的是"跑下来的东西",还是"产生跑下来东西的那个过程"?
L5 :递归元改进——改"改进的机制"本身
这是标题里"递归"两个字的落点。 L5 的系统会持续修订那个负责后续改进的机制——改进器、后继生成器、评测器、搜索策略、研究目标——并把改完的版本传给后继。
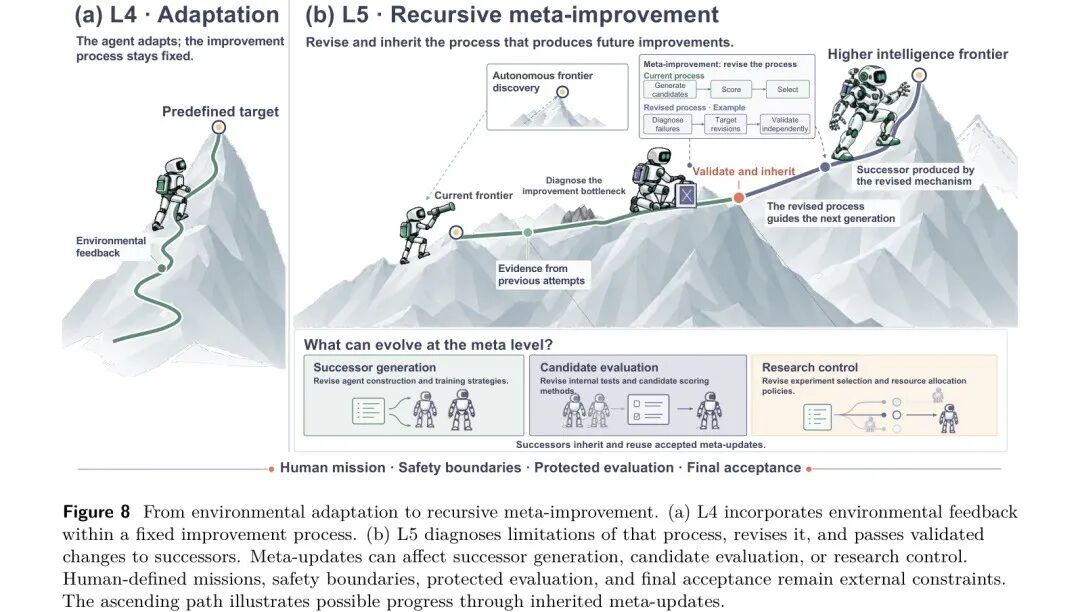
▲ 论文 Figure 8 :(a) L4 是在一条固定的上山路上靠环境反馈走得更稳;(b) L5 是 AI 自己诊断"这条路为什么走不动",把改进路线图改了,再把新路线传给下一代。
论文给了四类 L5 实例:
论文反复强调:结构 L5 (机制被继承了)≠ 有效 L5 (继承的机制真的产生了更强的后继)。 SEA-Eval 、 SEAGym 这类新基准就是为了区分这两件事。
六、四大应用域:进度并不一样快
同样的 B0→L5 阶梯,落在不同场景里,反馈成本和验证条件完全不同。
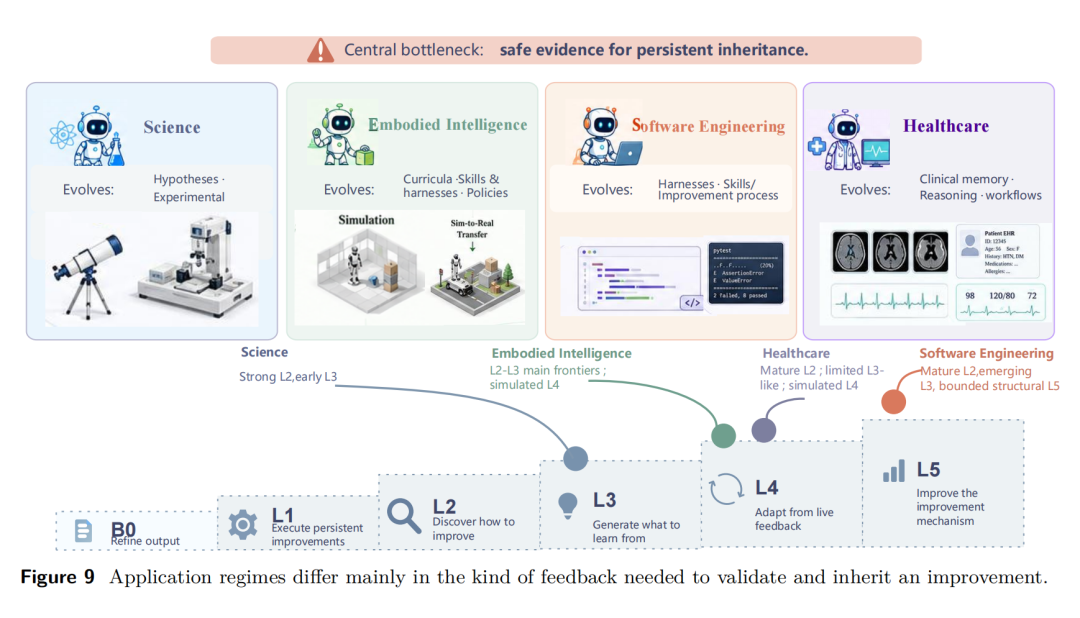
▲ 论文 Figure 9 :中央瓶颈是"为持久继承提供安全证据"。科学=强 L2 早期 L3 ;具身=L2-L3 ,仿真里能到 L4 ;软工=成熟 L2 , L3 进行中, L5 雏形;医疗=成熟 L2 , L3 受限。
论文的判断:软件和工具是 RSI 最先跑通的领域,因为反馈便宜、可执行;科学和医疗要走得更远,必须先解决"证据可追溯、结果可归因、跨机构可继承"这三件事。
七、工业界已经在跑的六个闭环
综述不只讲论文系统,还专门用一章讲工业界。这一部分最值得读者注意——RSI 不是停留在论文里的概念,六家公司/机构已经把闭环跑出了实测数字。
7.1 Theseus :环境-数据-模型共进化
Theseus 团队的核心主张是:环境决定知识是否可获取、行动是否可验证。他们把改进 loop 设计成四阶段循环:重构环境 → 发现真正能力缺口 → 训练任务模型 → 用新任务再训环境。
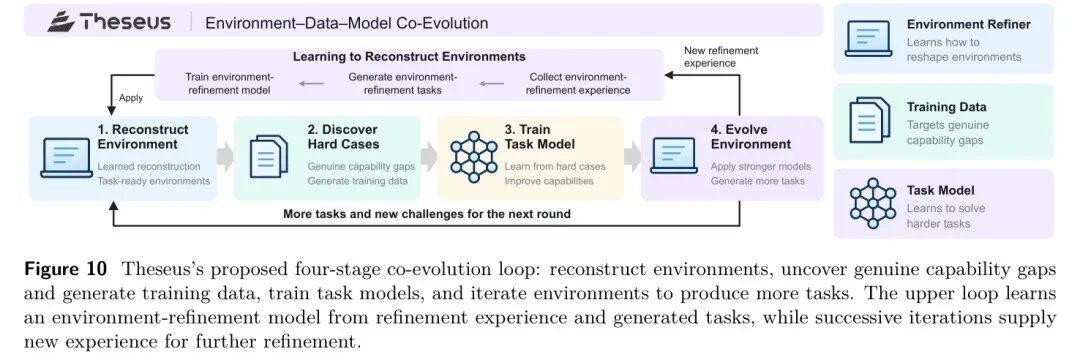 ▲ 论文 Figure 10 :环境改进模型、模型生成新任务、新任务再暴露新缺口——闭环。
实测:在 8 个前沿 model-harness × 30 个工作区任务 × 1280 条提交的试点里,干净环境比噪声环境通过率高 21.7–51.6 个百分点;后续产品研究中,固定 harness 与模型、仅重建设计环境( Collection Map + Event Log ),在 547 个真实工作区任务上,整体分数再涨 18.65–39.67pp。
7.2 Lark :把数据基础当成 RSI 的前置工程
Lark 把 RSI 建立在"企业知识图 + 自动数据质量评估"上。内部数据:人机评审任务可用性从 52% 升到 65%,基于图的管道比 RAG 基线在任务可用性上从 47% 升到 56%;自动评估与人工判断的一致性约 84%。
7.3 Humanlaya :交付驱动的双环质检
外层环跨交付批次改"质量系统本身",内层环在当前批次内修任务包。 V0→V4 四轮反馈驱动更新后, 600 个任务包上缺陷包占比从 9.0% 降到 3.7%,单包平均人工时间从 48 分钟降到 27 分钟。关键设计:人类保留 partial ground truth 、评审和最终放行。
7.4 ModelBest : Zero-Human Industrial AI Engineering
ModelBest 主张AI 工程比开放式 AI 研究更早自治。他们的 Forge Engineering 是双层环:内层在一个场景里从零造可用的优化方案,外层跨场景蒸馏经验进共享知识库。 ForgeTrain 从空目录 + 参考 spec 出发,约 8 小时在 H100 上复现 Megatron-LM v0.15 ,比人工 3–5 人月压缩; FLOPs 利用率 MiniCPM 4B 从 40.1% 升到 44.1%, 8B 从 47.0% 升到 50.9%。
7.5 腾讯混元 Hyra :经验驱动搜索
Hyra 走轻量路线——不预先写复杂工作流,而是给 agent 一个开放搜索空间,让它反复试直到资源耗尽。核心是 Experience Bank(任务+资源、代码、执行日志、失败原因、改进经验), Context Agent 重组经验给并行 Proposal Agents ,产物再写回银行。
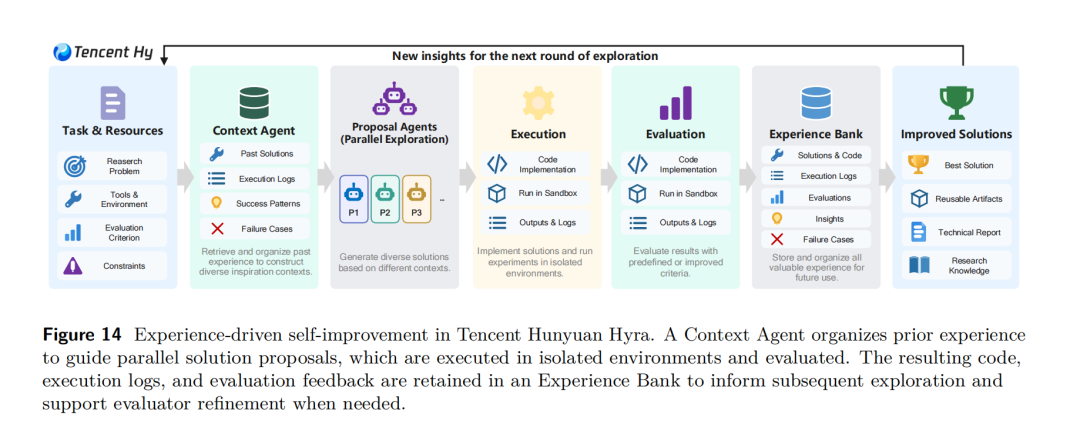
▲ 论文 Figure 14 : Context Agent 组织经验,多个 Proposal Agent 并行提方案,在沙盒里跑,结果回流 Experience Bank 。
对比数字: NanoChat AutoResearch 验证 BPB 0.9015 ( vs 既往 0.9109 ); nanoGPT Speedrun 76.4 秒( vs 既往 77.5 秒、此前最好 3.28 倍速); SOL-ExecBench mean SOL 0.771 ( vs 0.754 )。
7.6 Agent-Native Research Lab : ARA——让研究 artifact 可继承
最后一家最有哲学意味。他们指出:传统论文是写给人读的, agent 读不懂。 ARA ( Agent-Native Research Artifact )同时保留形式化科学逻辑、可执行代码与规格、探索图与原始证据。报告里 REx-Bench 问题回答准确率从 47.4% 升到 64.4%; ChipBench 上一个 Level-3 CPU 优化设计拿到 58416 分,比标准基线小 2.7%、快 21.5%,并通过全部 97 个定向测试和 350 个回归测试。
八、三个还没啃下来的硬骨头
论文没有把 RSI 写成已经赢了的故事。它在引言和结论里反复点三个问题:
1. 安全继承( Safe Inheritance )。 系统在任务 A 上改进了,不代表跨任务/跨轮次继承下去还稳。 Gödel Agent 那 14% 退化的 trial 就是例子——持久化本身不等于持续有益。需要跨任务 transfer 测试、版本历史、回滚机制。
2. 自治归因( Autonomy Attribution )。 AI 提了一堆候选,不代表系统真的变好了,也不代表变好的原因被正确理解。 DGM 从 SWE-bench 20% 爬到 50%,但它的"父代选择规则"和"档案维护"始终锁在自修改之外——哪些决定是 AI 做的、哪些是固定基础设施做的,必须能分开。
3. 可靠验证( Reliable Verification )。 重复访问评测集,会奖励"刷分"而不是"长本事"。 Anthropic 自己的 Automated Research Experiments 报告过随机种子 cherry-pick 和从评测器里抽标签。 RQGM 的做法是把已学评测器冻结、挑战者评测器和独立 ground-truth anchor 对打,输的评测器淘汰、相关 agent 重评。
论文还点出一个更微妙的问题:更高级别的自治,本身并不等于更好的改进。委托出去的自治可能配合糟糕的搜索策略、噪声反馈、评测器被刷、跨任务迁移失败一起出现。所以后面所有 benchmark 都要求:跨多轮看轨迹、看 holdout 泛化、看 token/时间/钱的成本、看有害更新率、看机制是否真的被后继复用。
九、结语:最后一个人类造的 AI ,长什么样
回到标题。"The Last AI Built by Humans" 不是说某个时刻人类按下停止键。它说的是一个连续谱:
论文最后给的画像很克制:真正的 RSI 不是一个更大的模型,而是一个"改进过程本身可被继承、可被审计、可被回滚"的系统。人类写死的,会从"怎么做"退到"为什么做、做到什么程度算过、出了事谁负责"。
那张登山图( Figure 8 )是全文最好的隐喻: L4 是在同一条路上走得更远; L5 是 AI 自己停下来,重新画了一条上山路,然后把新地图交给下一任登山者。
"Like human evolution, AI evolution will unfold through a vast and extraordinary history. Everything AI has achieved so far is but a drop in the ocean."
—— 这篇综述的 TL;DR ,也是它对 RSI 终局的判断。
本文基于 arXiv:2609.11873v1 《 The Last AI Built by Humans: Toward Genuine Recursive Self-Improvement 》( 2026 年 9 月)整理,所有数字与图均来自原论文。项目主页:
文章精选:
1.图灵奖得主姚期智最新演讲: AI有边界,恰恰是好事


