
 五度妙笔
 企业透视镜
 API商城

 数据库
10 万张国产 GPU 放在一起,会发生什么?
最近,京东云宣布拟建设十万卡全功能GPU集群,以摩尔线程全功能GPU为算力底座,面向大模型训练、推理和具身智能,并计划向行业开放算力。
这条消息值得关注,不仅仅是因为“十万卡”这个数字。它还意味着国产GPU正在被纳入头部云厂商的大规模算力基础设施规划,客户考察的也不再只是一张卡或者一次模型测试,而是一整套系统能否长期运行。
尤其是在Day-0适配逐渐成为头部国产GPU厂商基础能力的当下,“能不能跑最新模型”已经不足以回答商业化问题。真正需要继续观察的,是集群扩大以后效率如何、系统能否稳定运行、原有业务是否方便迁移,以及设备能不能按计划交付。
在我看来,京东云的十万卡规划提供了一个具体切口:国产GPU正在从“通过技术验证”,走向接受大规模生产环境的检验;摩尔线程要回答的,也从单卡和模型支持,扩展到了集群、软件和工程交付。
Day-0 主要检验适配速度,生产环境继续检验效率、稳定性和成本
Day-0适配首先确认的是,新模型能否较快接入一套软硬件环境。进入客户测试以后,还要换成客户自己的模型、数据和业务负载,重新验证精度、性能和运行成本。
两者不能直接画等号。一个公开模型能够正常运行,不代表客户已有的全部代码和算子都能直接使用;一次测试顺利,也不能说明同样的表现可以在生产环境中持续重复。
这就像一辆车能够正常启动,只能证明发动机和基本系统可以工作。真要把它投入长途运输,还要继续看满载后的速度和能耗、连续行驶是否可靠,以及发生故障后需要多长时间维修。
在摩尔线程的产品体系中,MTT S5000位于底层,承担大模型训练、推理和高性能计算。它首先要满足客户对基础计算性能和模型精度的要求。
但对客户而言,单卡参数只是投入的一部分。单位时间内能够完成多少训练、承接多少推理请求,因为故障损失多少时间,才会直接影响这套算力的实际使用成本。
卡数不等于有效算力,万卡甚至十万卡集群要看扩展效率和稳定运行时间
即使单卡性能达到要求,把卡的数量增加,也不会自动得到同等比例的业务产出。
当集群扩大到千卡、万卡规模,某个节点变慢、网络出现拥堵或者任务调度不合理,都可能让大量GPU一起等待。卡越多,一些在小规模测试中偶尔出现的问题,就越容易成为集群运行中的日常问题。
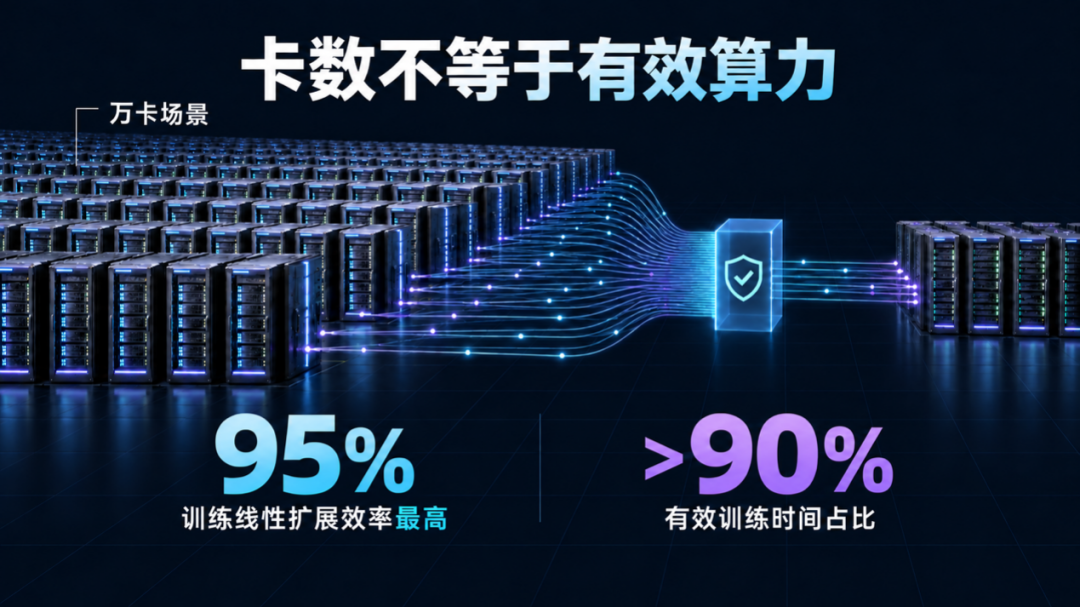
大规模系统既要尽量降低故障发生的频率,也要在故障出现后迅速发现异常节点、隔离问题,并让训练任务从中断的位置继续。故障定位需要几分钟还是几个小时,最终消耗的都是训练周期、电力和客户预算。
在集群层,夸娥覆盖任务调度、监控诊断、故障恢复以及训练和推理工具等环节,负责让大量GPU协同运行。
据摩尔线程披露,其万卡场景训练线性扩展效率最高达到95%,有效训练时间占比超过90%。前者对应集群扩大以后各节点能否保持较高的协同效率,后者对应集群有多少时间真正用于模型训练。
对客户而言,卡数只是投入。单位时间内实际完成多少训练、处理多少推理请求,以及系统能够保持多久稳定运行,才构成这套集群的实际产出。
规模化落地还取决于软件迁移、持续供货和工程运维
除了性能和集群运行,软件迁移也会直接影响客户是否采用一套新的GPU平台。
成熟企业通常已经积累了大量模型代码、算子库、开发工具和工程经验,不会轻易为了更换GPU进行大面积重写。如果迁移需要投入大量开发和调试人员,还会影响原有业务上线,客户就会把这些时间和人力一并计入采购成本。
摩尔线程的MUSA架构采用与CUDA兼容的编程模型,并提供相应的迁移工具,目标是减少代码改造和重复验证,让客户已有的软件资产和开发经验能够继续使用。
这并不意味着所有业务都可以直接搬过来,但需要修改多少代码、迁移需要多长时间、团队是否需要重新学习,都会影响客户的采用速度。
软件之外,持续供货、安装部署、备件更换、监控运维和服务响应,也直接影响系统能否按期上线并持续运行。摩尔线程已经披露S5000实现规模量产,相关智算集群也已在多地落地。这些项目为其积累大规模算力系统的生产、部署和运维经验提供了基础。

几部分之间的分工也由此变得清楚:S5000提供底层计算,夸娥负责集群管理和运行,MUSA面向软件兼容与迁移。客户最终还要看这三层能否在真实项目中配合,以及供货和工程团队能否把系统按计划部署起来。
京东云的十万卡规划,把观察范围从单卡和单模型扩大到了大规模算力基础设施。在这样的规划中,摩尔线程面对的不只是模型适配,还包括集群扩展、长期运行、软件迁移和工程交付。
对国产GPU的评价标准,也正在从“能否快速支持新模型”,扩展到“能否在真实业务中长期、稳定并以可接受的成本完成任务”。


