斯坦福吴佳俊ECCV 演讲:机器需要怎样的「世界表示」,才能真正开始行动?| ECCV 2026
发布时间:2026-09-16来源:图灵人工智能
单击上方“图灵人工智能”,选择“星标”公众号
您想知道的人工智能干货,第一时间送达
转自AI科技评论,仅用于学术分享,如有侵权留言删除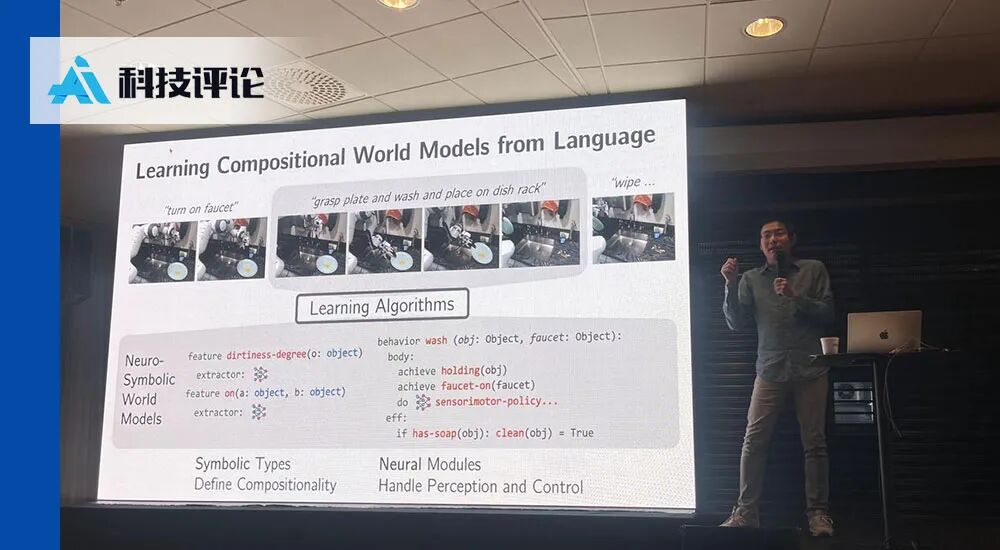 9月9日的瑞典马尔默,Malmömässan会展中心,斯坦福大学计算机科学助理教授吴佳俊(Jiajun Wu)大概是整个ECCV 2026会场里最忙碌的学者之一。一天之内,他需要在 3 到 4 个不同的 Workshop 之间来回“赶场”发表演讲。而当他终于站上今天这场主题 Workshop 的讲台时,他抛出的却是一个远比“识别像素”更宏大、也更直击具身智能痛点的话题:当机器人踏入一个充满未知与突发状况的物理世界,它究竟该如何见招拆招地“行动”?人看到一个厨房,很少会从头计算眼前的一切。我们知道盘子可以被拿起来,洗洁精意味着接下来可能要清洗,压在盘子下面的垃圾意味着桌面需要先被清理。即使人临时改变了动作,或者换了一件从未见过的物体,我们仍然可以凭借对世界的某种理解,补出接下来应该发生什么。它面对的不是一连串已经写好的动作,而是一个不断变化、充满例外的世界:物体会变,人会改变行为,任务会被打断,训练时没见过的东西随时可能出现在眼前。真正困难的,也因此不只是让机器人“做对一个动作”,而是让它知道一个动作为什么成立,又该如何把一个个局部的技能重新拼成一件完整的事情。二十天前,在德国北部的不来梅,吴佳俊刚刚获得IJCAI ECAI 2026“计算机与思想奖”。那场题为《Building Visual and Physical Intelligence Through Code》的获奖演讲,讨论的是机器如何从像素构成的世界里,进一步理解藏在背后的几何、材质、可供性与物理属性。他把这些更深一层的结构称为“物理代码”。到了马尔默,问题没有换掉,只是向前走了一步。如果机器已经获得了某种关于世界的表示,它又该如何利用这些表示去行动?这两个问题之间,恰好隔着今天具身智能最棘手的一段距离:从“知道世界是什么”,到“知道在这个世界里应该做什么”。而吴佳俊这次给出的答案,并不是再造一个无所不知的模型。他谈的是如何把复杂的操作拆成可以验证、组合和重新排列的原子技能;如何在没有人演示的情况下,从一个陌生物体本身推断它可能被怎样操作;也谈如何从视频生成模型中“借”来那些模型已经见过的世界,让机器人获得原本需要真人遥操作、拍摄视频才能得到的经验。这里有一个颇有意味的转折。二十天前,他还在用一个坐垫和一只猫说明视频生成模型的局限:猫甚至还没有落下来,坐垫却已经开始变形。画面看起来合理,物理却是错的。但到了机器人这里,“不完全正确”并不意味着“没有价值”。一个视频模型也许不真正理解重力,却可能知道一只猫通常怎样跳上一张坐垫;它未必能够精确模拟一块布的物理属性,却可能提供大量关于“这块布可以怎样被拉动”的线索。对于机器人来说,这些并不完美的知识,依然可以成为一种“现成的演示”(free demonstrations)。于是,同一项技术在两场演讲里被放在了两个不同的位置:在理解世界时,它暴露出与真实物理之间的距离;在教机器人行动时,它又成为一种可以借用的经验。他在不断追问:一种表示究竟能够告诉机器什么,又有哪些事情必须交给另一种表示去完成。从二维图像,到三维空间,再到随时间变化的四维世界;从已经存在的人类演示,到没有演示时对物体运动方式的推断,再到从生成模型中蒸馏出来的交互轨迹——这些看起来不同的工作,最终都指向同一个问题:机器怎样获得一种足够结构化的世界表示,并把“理解”真正变成“行动”。以下是吴佳俊在ECCV 2026 Physical AI: Understanding and Building the Physical World Workshop上的演讲精编稿。AI科技评论基于现场英文演讲进行编辑,在不改变原意的基础上,对口语表达和技术术语进行了重新梳理。
▎Beautiful Equations for Visual Representation
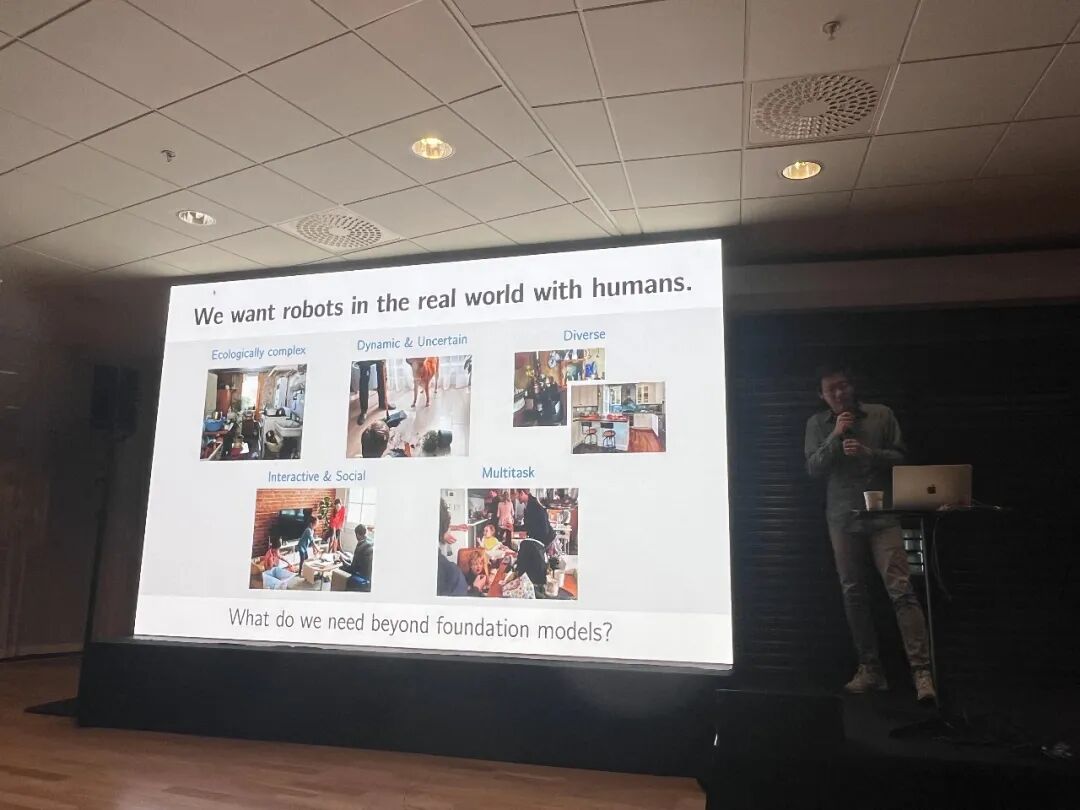
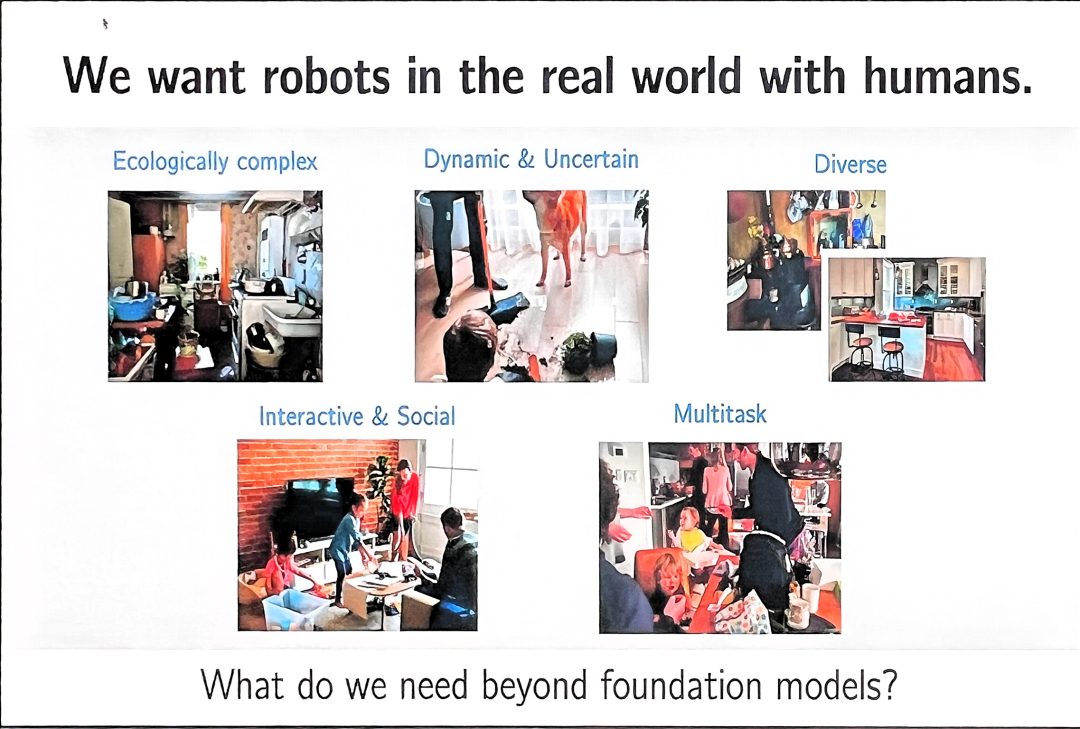
我先分享一件有点幸运的小插曲。来之前,主办方特意叮嘱,最好能根据 workshop 的主题微调一下PPT。我当时心想,时间这么紧哪来得及?结果我打开网站一看,这个 workshop 的主题是结构化的视觉表示(structured visual representation)。巧了,我这套幻灯片的原标题就叫 Beautiful Equations for Visual Representation(视觉表示的优美方程)——好,这下我一个字都不用改了。 当然,我们不仅要讨论如何发展出这些视觉表示(或许可以用时空结构);更要解决怎么把这些结构,特别是如今日益强大的生成式AI,真正接入物理世界。 毕竟,我们造机器人,是希望它们能在复杂、多变、充满不确定性的现实中干活,甚至和人协作。 如今,我们早就过了讨论“要不要用基础模型”的阶段,真正的痛点是“怎么用好”。如何构建在它们之上,如何让它们适配你真正关心的那些领域。 尤其是当你进入很多私有场景的时候,你的数据可能非常少。你怎么让你的系统快速泛化和适应新环境?这些环境里有大量私有信息,但它们未必能拿来训练基础模型。举个我们实验室里的例子。设想一下:一个机器人正准备和人一起清洗盘子,学生刚挤好洗洁精,突然接个电话人走了。 这时候你问机器人:“这有几个陶瓷餐具?”现在的视觉大模型一秒就能答出“四个”。你接着问:“能帮我把它洗了吗?”机器人不仅得精准领会“它”就是那个涂了洗洁精的盘子,还得自己规划一套行动流:拿起盘子、冲洗干净、放上沥水架,最后把水龙头关掉。单做这一套动作或许不难,真正困难的地方在于:机器人必须跨越不同类型的物体、不同类型的环境、不同类型的目标去泛化。 即便是在这个同一个熟悉的厨房里,它还得学会随机应变,去适应不同人类千奇百怪的行为习惯。接着刚才洗盘子的例子,刚才接电话的同学回来了,把干净的盘子又放回了桌上。虽然我也不理解他图啥,但机器人必须意识到:好,现在我不用再洗一遍了,因为它已经是干净的了。我直接把它放上架子就行。 又或者初始状态变了,洗洁精根本还没挤到盘子上。机器人应该意识到:我得先挤洗洁精。 你必须让操作具有适应性,随时更新。 比如这个很简单的任务:拿起桌上干净的盘子,放上架子,完事。但它拿起盘子发现,等等,盘子下面还压着一些垃圾。 机器人必须能够重写行动流:先去找抹布把桌子擦干净,而且理想情况下,擦完之后,它应该还能把抹布放回到桌上。 光是在一个熟悉的厨房处理熟悉的物体,就需要如此庞大而且灵活的泛化能力。如果你把它扔到一个全新的国家、全新的厨房,面对你从未见过的物体呢?这才是真正困难的地方。 02
把长任务拆开:状态、动作,
与一套能被验证的技能
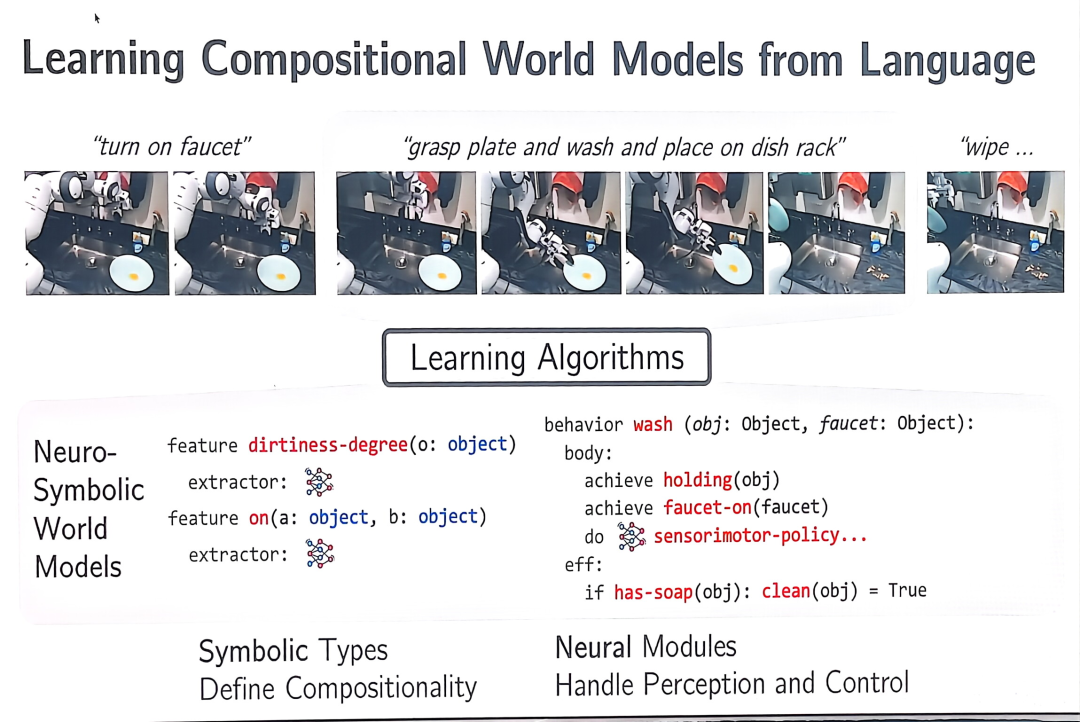
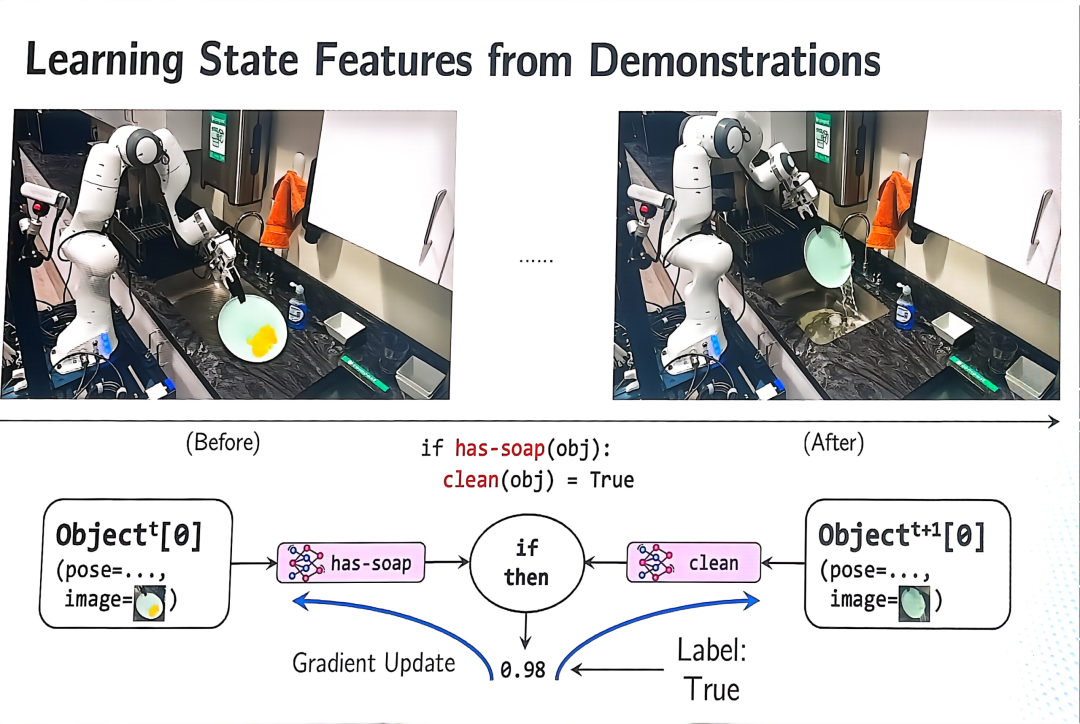
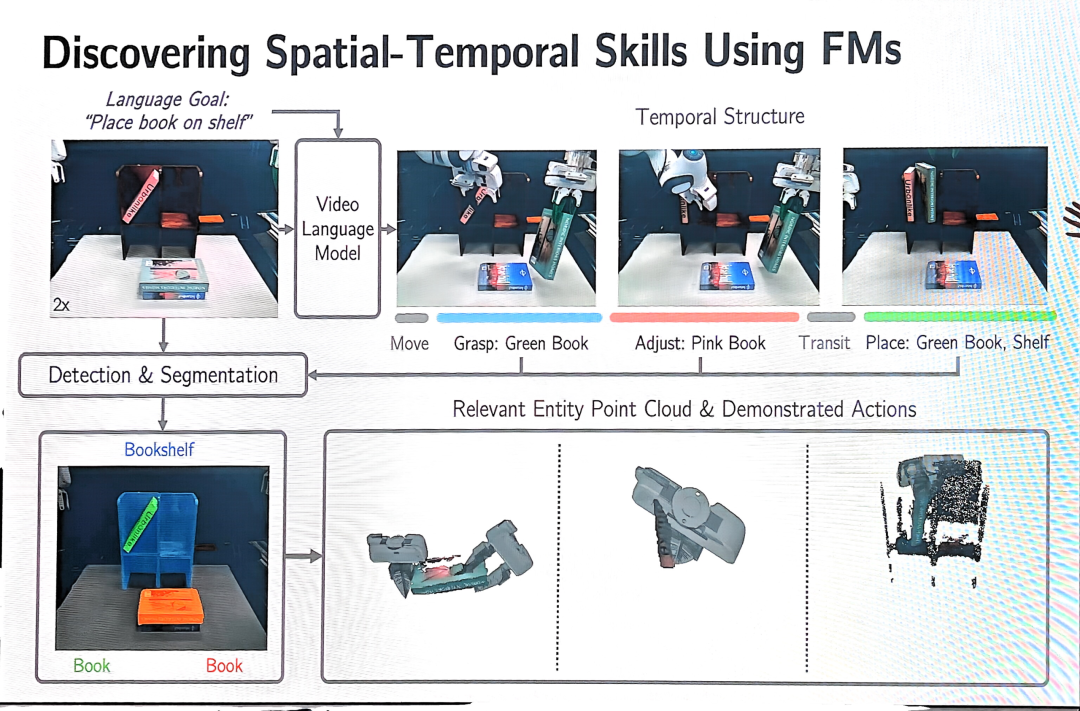
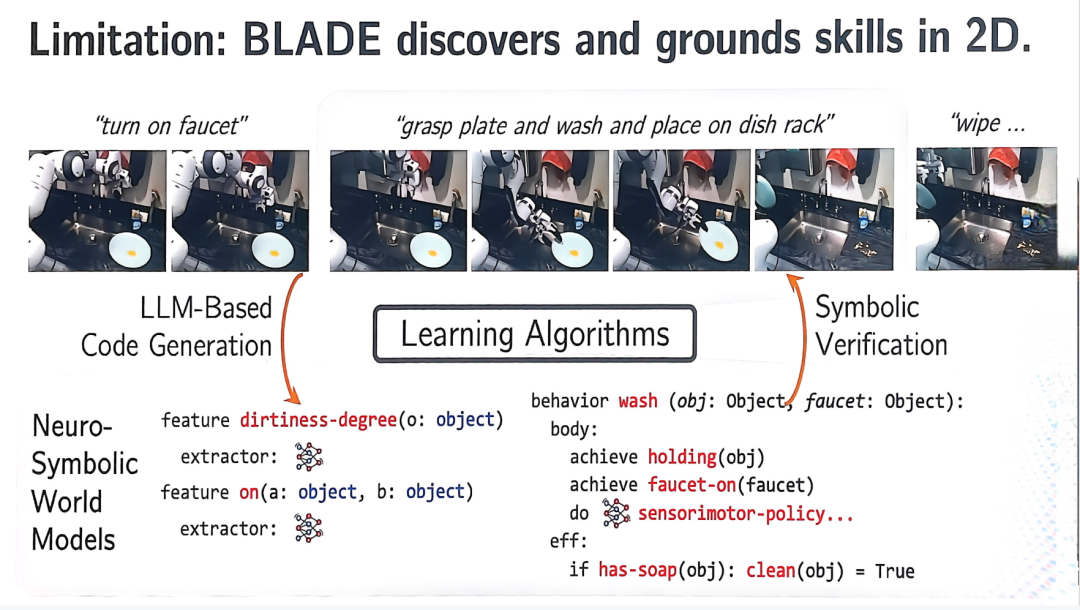
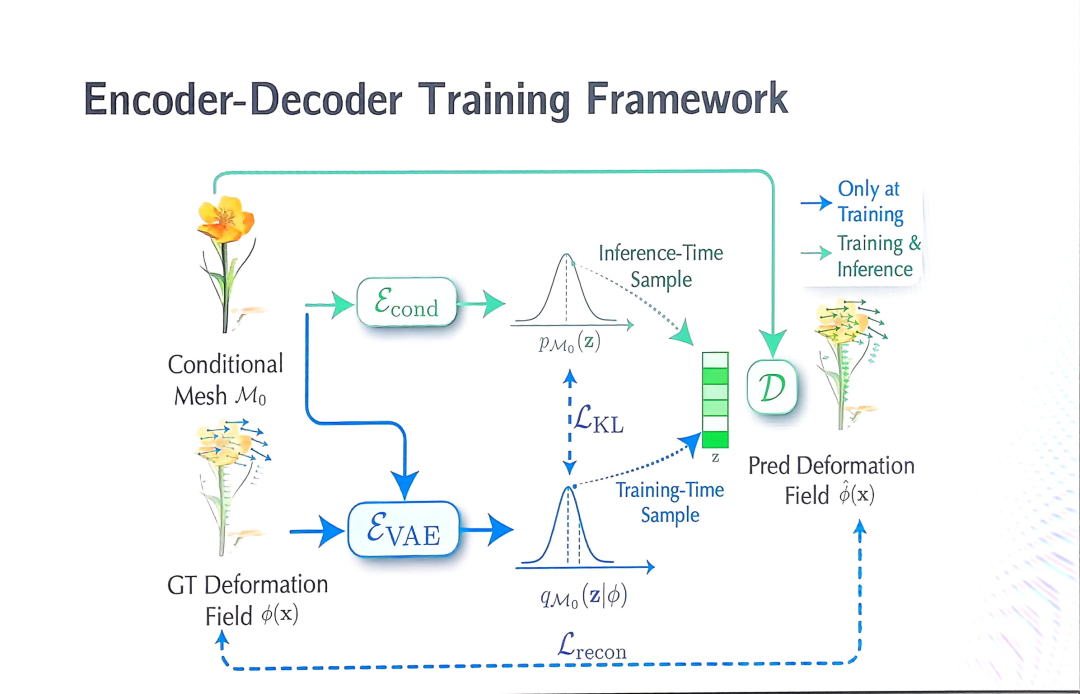
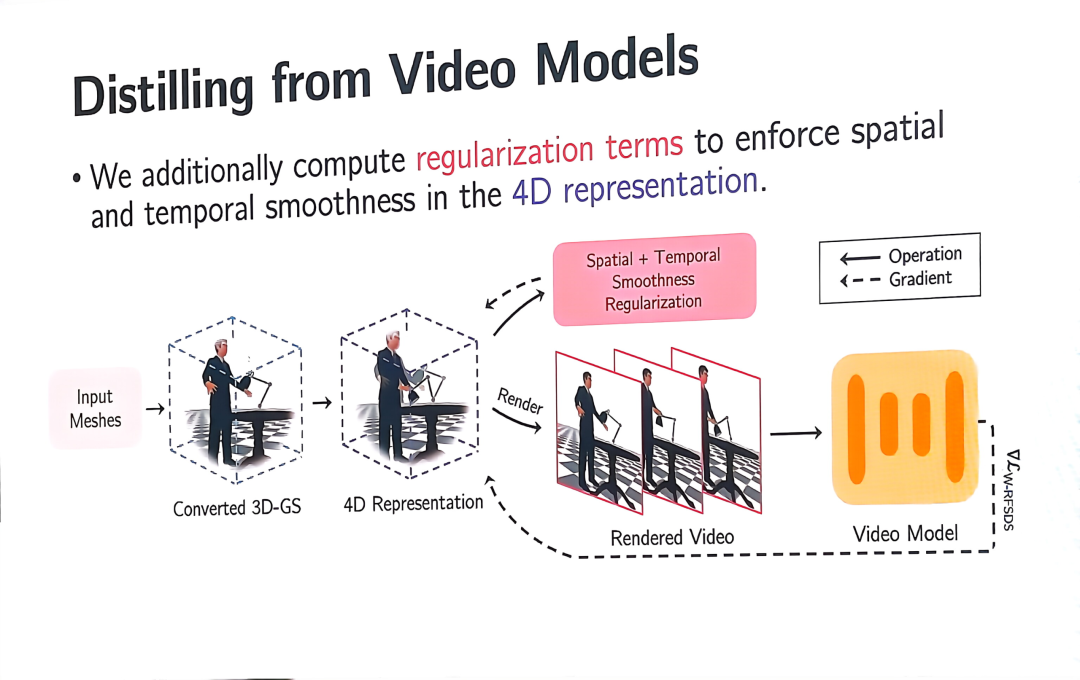
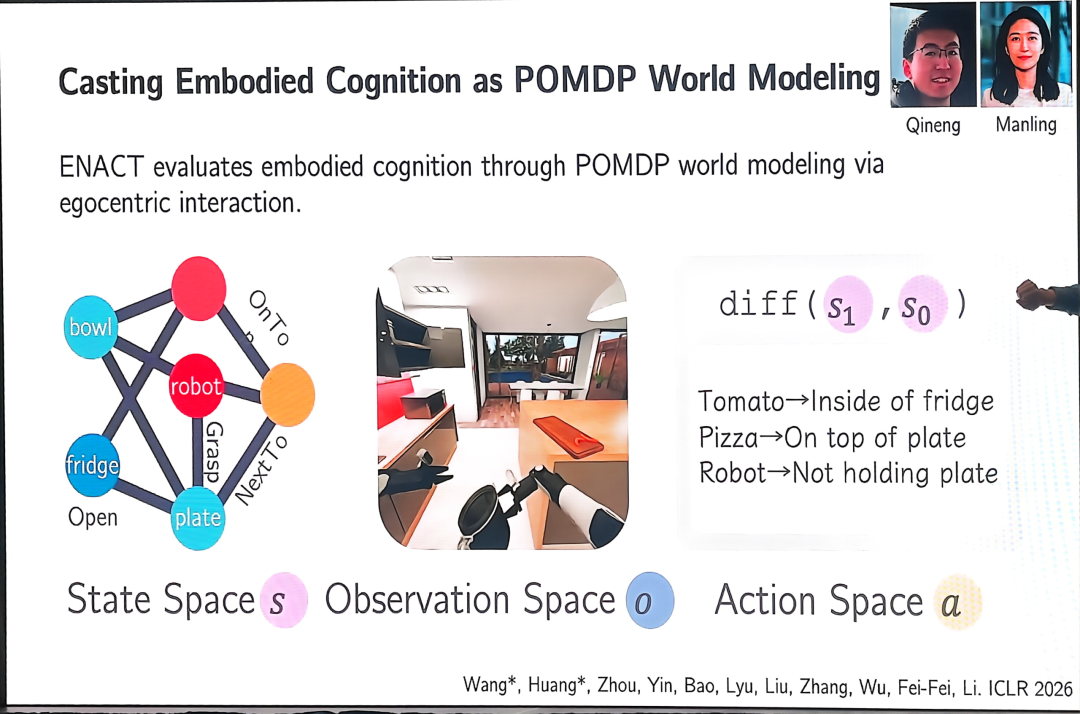
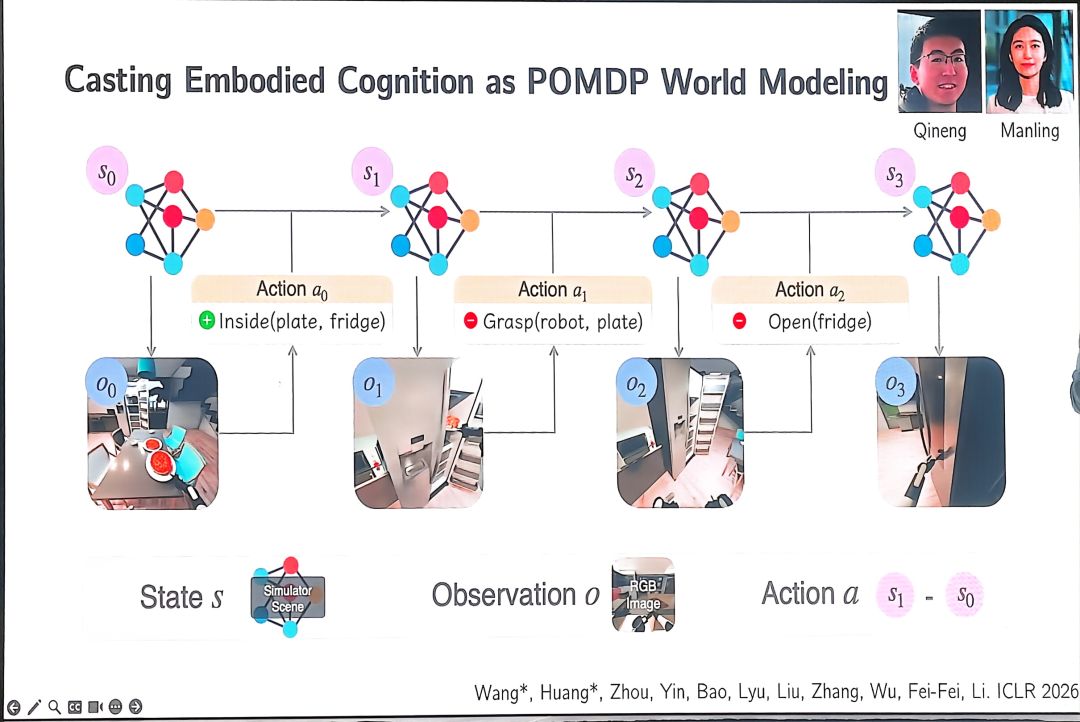
所以,我们一直在探索另一种范式。这个范式放到今天,其实比两年前容易理解得多。 我们尝试发展出某种用于推理的组合式抽象(compositional abstractions for inference)。 它的结构是这样的:你有原始观测,可以是图像、视频和语言;你有基础模型,帮你完成感知和语言理解;然后你得到一组组合式抽象——它本质上是一组原子技能(atomic skills),这些技能之后可以被组合起来,用于规划,并输出动作。 而你要做的,是去发现并学习这些抽象。一切都应该是端到端学习的,从原始监督中学习——所谓原始监督,就是自然语言、图像和视频。 那具体怎么做呢? 假设你有一段视频演示。比如你有一个遥操作的机器人,由人来操作,它采集了一段很长的演示。你可以用一个描述生成模型(caption model)给这段视频打上字幕。这样我们就有了视频,也有了字幕。 那么学习算法想要发现的东西,就是我们所说的组合式抽象。它由几样东西组成。 第一,是一组状态(states)。这些状态可以是二元的,系统需要去验证它们。比如:这个物体是不是脏的?物体 A 是不是在物体 B 的上面?当然,这些验证是由神经网络来完成的。 第二,是一组动作(actions)。这些就是原子技能。举个例子,你有一个“洗”(wash)的技能。你会发现:要洗一个东西,你必须先把它拿住(hold)。当然,水龙头还得是开着的。在这之后,如果上面有洗洁精,那么这个物体就会变干净。 第三,是这些状态与动作之间的关系。在某种意义上,是这套符号化的类型(symbolic types)定义了组合性(compositionality),而由网络来处理感知与控制。 而拥有这种表示的意义在于它允许你推演:如果前置条件已经满足,那么执行这个动作会发生什么?后置效果是什么?这就让你能够思考:接下来我真正被允许做什么。 顺带说一句,这里还有一个额外的问题:如果所有这些东西都是手工编码(hand-coded)的,那它就退化成了传统的规划系统,而那是无法泛化的。 所以问题就变成:你怎么知道“拿住”是“洗”的前置条件?答案是:这些东西同样是由神经网络发现的。 今天的基础模型可以为你生成一些假设:有哪些类型的属性?它们如何构成各个技能的前置条件和后置条件?整个集合本身是由网络生成的,它们由网络来验证,控制策略也是由网络给出的。 同时,你还可以做验证。你有一个验证器(verifier)在问:网络说“洗”这个动作需要先拿住物体,这个结论与演示本身一致吗?这件事同样可以交给网络来做。我记得这项工作大概是在一年半前做的。那时候我讲起它,人们都非常困惑:你到底在说什么? 但大概从半年前开始,它突然变得好理解多了。 因为我们在数字空间里,终于有了一个完美的类比——Claude Code。 如果我让 Claude Code 去做一件非常复杂的事,它会怎么做?它会说:我得先想出五个不同的步骤。先做这个,再做那个;在能够添加某个东西之前,我得先生成这个文件。而到最后,它还有一个验证器——它必须检查用户提出的需求是否全部被满足。 在某种意义上,你可以把我们做的事理解为:在物理世界里做同样的事。你把所有的技能都发现出来,你验证“拥有这些技能”到底意味着什么,你考虑这些技能如何被串联起来,以完成长程的操作任务;你验证技能的条件,验证后置条件是否与用户提供的演示相一致。 在此基础上,你甚至可以直接用现成的系统把这件事搭出来。比如,你可以用一个视觉语言模型(VLM)来提出抽象;判断一个物体脏不脏,你可以用一个现成的感知模型;如果你有分割结果,你可以把它送给 Gemini 或者其他模型去问。 但如果需要的话,因为机器人领域确实存在“从未见过”的场景。你可能会在生产流水线上遇到一个随机的零件,它是某台机器的一个组件,这个物体你从来没见过。这时候你会问:它是否满足某种条件?而神经网络对此毫无概念,因为这可能真的是一个全新的物体,也许你刚刚才把它打印出来。 如果需要,我们也做了一个可以对系统进行微调(fine-tune)的方案。这些网络的作用是:假设你面对一个新物体,问它“这个物体上面有没有洗洁精”,在通用的现成系统可能无法直接回答的情况下,我们的系统可以给出答案。如果需要,我们还做了一个可以微调的版本。 当然,这时候你使用的网络会大得多,而且受算力约束。 但关键的一点是:一旦你有了这些“表格”,它们就允许你给出监督信号,用来训练一个系统。于是系统能够学会更好地识别。即便只有极其有限的演示,某个物体是否满足当前技能的某条条件。如果需要进行这种后训练(post-training),这个机制就可以提供支持。 所以,它让你能够泛化到新的物体、新的本体(embodiments),以及不同的目标。 这就是这个工作的第一个版本。不过,第一个版本有一个局限。 这个局限在于:当我说“它是不是脏的”的时候,所有的验证都是在 2D 里完成的。你分割出一块图像区域,然后要么用你自己的网络去判断,要么直接把它发给 Gemini,问它“这脏不脏”。 在 2D 里,有很多事你能做,但也有很多事你做不了——尤其是对于复杂的操作问题,当你必须去推理物体的空间结构时。 比如:物体 A 是不是在物体 B 上面?这种情况,你真的必须去发现三维场景才行。 所以在后来的扩展系统里,我们让它去发现时空目标,以及其他一切。整个范式和之前非常相似。 但现在,我们输入的是随时间变化的三维点云——有时候你也可以把它叫做点云轨迹(point cloud trajectories)。 有了它,你就可以完成所有这些验证:检测物体、验证它们的状态、验证它们之间的关系。 同时,你还能泛化到更长的任务周期(longer horizons),因为你学到了“抓取”和“放置”这样的原子技能。 举个例子:假设在训练时,我们只演示了几个例子,展示你如何抓取和放置一本书。但在测试时,你有两本书。现在你必须处理一个更长的任务周期问题:你要把两本书都放到架子上。 你可以看到,系统能够思考这些技能如何被组合,从而适应并完成比训练时更长的任务。 类似的例子还有很多。你可以演示抓取一个杯子、把杯子挂起来,然后重复这个任务,系统就能泛化去挂更多的杯子。 再回到厨房的场景。同样地,你有几个原子技能:打开水龙头、抓起盘子、清洗盘子。然后你可以泛化到一个更长的任务——清洗并把两个盘子都收好。 系统必须学会并意识到:这些原子任务,例如拿起、放置、清洗盘子等,是如何被组合起来的,而且是可以被重复的。于是你就能处理额外的任务。 到目前为止,我们一直假设我们有一段视频演示。有人给机器人做演示,人类去遥操作,然后你试图预测:什么是正确的做法?如果这里有个水龙头,你可以打开它,也可以关上它,那么在这个情境下,正确的动作是什么? 我们能不能做出一个系统:即便给你一个全新的、从未见过的物体,它依然能够推理出与这个物体交互的正确方式? 当你在这里看到某些物体——比如一个水龙头、一个牛顿摆。你就会明白,只有特定的几种方式可以和它们交互。 即便从来没有人类演示过“如何关上这个水龙头”,你其实也拥有大量关于“与水龙头交互的正确方式”的先验知识。 这就是我们这篇论文的目标。我们把它叫做 Neural Kinematics(神经运动学),今年发表在 ECCV 上。 这里的核心想法是:即便你没有关于“如何与这个物体交互”的演示,你对这个物体可能形变空间的内在维度,依然拥有某种先验知识。 你可以想象成一个人。你能做这个动作,能做那个动作,但你并不是真的什么都能做——你受到自己身体的约束。我们要捕捉的,正是单个物体所固有的那种运动学空间(kinematic space)。这样一来,从这个空间里采样,你就能看到这个物体处于不同状态时的样子。 我们做这件事的方法其实非常简单。我们有一个编码器—解码器(encoder-decoder)训练框架。你有一个作为条件的静态网格(mesh),还有一个作为真值的形变场(deformation field)。 在训练时,你实际上训练了两个网络。第一个是一个条件变分自编码器(conditional VAE)。它输入一组网格作为条件,尝试把这个形变场编码进一个隐分布,你可以从中采样,得到一个隐向量。 第二个是一个编码器,它只接收网格作为输入,把它编码进一个隐分布,你也可以从中采样得到一个隐向量,然后从它解码出形变场——这个解码结果应该能够重建出那个形变。 训练时你有两个损失函数。一个是重建损失(reconstruction loss):我希望重建出来的结果,与一个可能的演示重建——也许来自仿真——相对齐。第二个是 KL 散度:你希望最小化这两个网络输出分布之间的距离。 而在测试时,你只会看到其中一个,不是那个标准样本,你只会用到上面这一半。你把一个网格编码进一个数据分布,从中采样,就得到一个可能的形变。 概念上非常简单。 后来我们还做了扩展系统,让它变得完全可控——你可以真的把动作作为输入传进去,有几种不同的做法。 我认为这里真正的目标是:尝试捕捉这些物体的一种内在属性,也就是“这个物体可以被怎样移动”。 那么,如何把学到的、物体内在的维度与自由度,与一种恰当的动作表示有效地结合起来,从而让它变成一个真正的神经模拟器(neural simulator),这是一个非常有意思的问题。我们一直在做各种扩展。 但在这第一次尝试中,我们只是试图发现几个隐维度,让我们能够预测和推理与物体交互的方式。至少在这第一次尝试里,我认为系统表现得相当不错。 你可以用同一个模型走进一个房间,去预测我与这些不同物体交互的所有可能方式,从一个台灯,到一台笔记本电脑,到一把转椅,到一个柜子。这里是另一个场景:我走进一间浴室。同样,你并没有见过这个水龙头,但你能推理出与它互动的方式;窗帘、洗碗机、马桶,也一样。 不过有人可能会说:如果在训练时你见过所有这些完美的网格,测试时也是完美的网格,即便它们是不同的物体、不同的实例,那可能也没那么令人惊讶。 那我们把它放到真实世界里试试呢? 于是就有了这个我觉得很有意思的结果:我们的一位作者,用他的 iPhone 对房间做了一次三维扫描。你知道,你可以用 iPhone 做三维扫描,但它并不怎么准确。 但结果是:即便面对这样一个重建得不完美的场景,你可以看到这里全是伪影,这是 iPhone 扫描造成的——当你把它送进我们的系统,你会看到,在某种意义上,我们的系统实现了零样本泛化,去预测与这些物体交互的可能方式,比如那个水龙头。 尽管输入是这么一团一团(blobby)的东西,它依然能够推理。而这,某种意义上就给了你一种“现成的演示”(free demonstrations)。 你没有见过这些物体,但你其实可以预测出:与这些物体之间可能发生哪些交互。而这些,可以自然地与我们前面讲的一切结合起来,帮你发现技能,帮你推理这些原子技能如何被串联起来,以完成长程的操作任务。 这里还有一个办公室的例子。用三维扫描得到的笔记本电脑和显示器的网格有大量伪影,但系统依然能够泛化,去预测与它们交互的可能方式。 前面我们用的是编码器—解码器框架,去发现单个物体内在的自由度。这里我们想问的是:能不能更多地去借助这些基础模型——视频扩散模型(video diffusion models),以及视频语言模型? 使用这些模型的一个好处是:它允许你用语言进行大量的引导(steering)。因为这些模型是在海量数据上训练的。这里有个例子。你有一个静态的 3D 场景,然后有一个文本提示。比如这个提示是:一个孩子跳上跷跷板。而我们想要的输出,是一个遵循这段文本描述的、动态的三维场景。 这条管线和前面的方法不同。前面我们用编码—解码框架去发现物体内在的自由度;这里我们试图借助这些未来的基础模型的力量,特别是视频扩散模型。 道理很简单:如果它们能够生成人类做各种事情的漂亮视频,那么它们一定已经捕捉到了关于“这些物体应该被如何移动”的某些知识。我们能不能把这些知识发现出来、蒸馏出来? 如果我们可以从这些模型里把它蒸馏出来,我们就能得到物体在三维中相互作用的序列。然后它本质上就变成了一个四维序列——三维中的物体在彼此交互。 具体做法是:假设我们有一组静态网格作为输入。你可以把它们转换成某种高斯表示(3D Gaussian Splatting),然后给它加上一个额外的时间维度,于是你就有了一个四维表示。 在最开始,它是静态的,你从高斯出发,加了个时间维度,但它随时间变化仍是静止的场景。而你的目标是:一旦有了这个四维表示,你当然可以把它渲染成视频。 你可以从多个视角渲染,得到多视角的静态视频。但它们看起来不会很真实。于是你会想:如果我有一个视频扩散模型,它本质上捕捉了“在给定语言提示下,某个视频出现的似然(likelihood)”,那我们能不能利用这些视频模型,把知识从视频模型里蒸馏出来,从而优化我们的表示、提升这些渲染视频的似然? 如果你在三维这个较低的维度上做这件事,你有一个静态场景,渲染成图像,送给图像扩散模型去计算似然,再用它来改进底层的三维表示——这个技术叫做分数蒸馏采样(Score Distillation Sampling,SDS)。 而这里我们做的,本质上是 SDS 的一个广义版本,并且是在三维、乃至四维上做。我们希望:用渲染出来的视频,用视频模型去计算一个分数,这个分数让我们可以进一步计算梯度,去优化底层的四维表示。 但如果你熟悉这一套,你就知道让它真正跑通是非常困难的。而在四维上让它跑通当然更难,因为你现在是在一个更高维的空间里做优化。 所以在实践中,我们不得不做出不少改动。比如为不同部分设计专门的数据结构和表示方式,也可能需要在空间和时间两个维度上都使用层次化的结构。 好,来看一个例子。这里我们有一个静态场景,由一组网格构成。我同样没有任何关于“机器人应该如何与这些物体交互”的演示。我只给了这个静态场景,外加一句语言提示:一个机器人手臂抓起一块砖。 你可以看到,系统正在为每个单独的物体生成交互状态序列,包括像机器人手臂这样的关节物体。你可以看到机器人手臂可能会如何与这块砖交互。 在某种意义上,我等于给了你免费的演示,机器人可以拿去学习真正的运动技能,学会如何把物体抓起来。这里是另一个例子:输入的是一个篮球和一个篮板的网格,提示是“篮球砸到篮筐并弹开”。你可以看到生成的交互序列相当真实。 你也可以回到动物身上。输入一只猫和一个坐垫,文本提示是“一只猫跳上坐垫”。同样,生成的序列相当真实。就像我说的,这给了你关于交互序列的“免费演示”,所以你再也不必去遥操作机器人了。你甚至不需要采集视频,因为一切都是生成的。 所以你得到了“免费的”东西。来看这个例子:我有一块布,我说“生成一段人与这块布交互的序列”。你可以看到,在左边,因为所有东西都被蒸馏到了四维,你实际上得到了密集的点追踪轨迹(point trajectories)——你想要多密集就可以有多密集,因为一切都是生成的。这在某种意义上就给了你免费的监督信号。机器人可以学着去完成这个任务,让物体以类似的方式运动。而在右边,你会看到一个真实的机器人正在学习执行完全相同的任务——并且没有任何演示。 不过我想说明的是,这里的物体是我们熟悉的。所以也许现有的模型在某个阶段之后也能做到这一点。 我认为我们其实应该——我们还没做,但我们应该尝试用一组全新的物体来做这件事。要真正超越 π0.5 这类模型的能力范围,去展示:对于任何新物体,以及与之交互的新方式,这个框架都能给出新的交互方式。这会很有意思,但我们还没做。 好,这个 workshop 的主题是我们提出了各种各样的结构化表示,用于机器人操作。但我们不能不去评估它们。 所以,稍微相关地,我们提出了几个不同的基准(benchmark),帮助我们从不同角度做评估。我打算每个大概讲一到两张幻灯片,给一个快速的概览——评估的对象既包括我们自己的系统,也包括其他人开发的系统,以及这些基础模型本身。 第一类评估,是我们做过的一个关于“推理的分解”(factorization of reasoning)的工作。 你现在有了所有这些具身推理(embodied reasoning)系统,但推理本身是个黑箱。那么:我们如何把推理拆开来,评估它们在多大程度上做出了有效的预测、在多大程度上正确地推理了动作? 众所周知,在传统的机器人规划里,人们总是把问题设置成一个 POMDP(部分可观测马尔可夫决策过程)。你有一组状态,你对状态的观测随着你看到更多东西而更新,你还要构建某种表示。 受这个框架启发,你总可以说:这里有一个状态空间,一个观测空间,一个动作空间。但这个基准想做的事情是,你可以把所有的基础模型,或者任何你有的模型放进来,然后评估:这些模型在多大程度上正确预测了状态的变化?在多大程度上正确预测了动作? 这里有个难点:动作空间非常大。所以很难说:如果模型输出了某些动作,它未必与真值动作相同,但它可能依然有效。那你如何评判它对不对? 所以,这个基准的设置方式不是直接让模型产生动作,而是给你一组动作,要求你重新排序,让它们与你观测到的状态变化相对齐。 你会看到初始时刻的状态,以及它们随时间如何变化、如何演化。然后给你若干个动作,你要回答:哪个动作先执行?之后执行哪个动作?从而实现所有这些状态变化。 这就是这个基准的设置方式。它叫 Inact,今年发表在 CoRL 上。 但它仍然是被动的——你只是在预测动作而已。 所以我们在做的另一个基准,叫做“具身空间智能基准”(Embodied Spatial Intelligence Benchmark)。在这个基准里,你的智能体(agent)是真的可以移动的。 你可以说“我要向前走”,然后它就真的向前走了。所以不再是“给你一组动作,你重新排序”,而是允许你向前走。然后你必须回答并预测一系列问题,而有时候你必须先移动,才能正确回答。 比如,在物体被遮挡之后,你被问到一个问题——“某个东西的几何形状是什么?”。你就必须绕过去看才行,这个基准的设置方式是:有一批任务,多数以问答的形式呈现,但你被允许移动着去回答这些问题。这些问题分为十个类别,基本上归为四组:关于三维表示的推理、关于数量的推理、关于布局的推理,以及关于目标导向动作的推理。其中还包含大约 29 个子类别。 最后,我们还在建一个规模非常大的东西。我从 2020 年就开始做它了,到现在已经六年。这是一个真正庞大的工程——为交互式环境中的家庭日常活动(household activities)建立基准。 你可以看到它非常复杂:你有一个仿真环境里的真实机器人,你必须处理所有这些不同的活动——打扫房间、清理浴室、整理餐桌,什么都有。你可以做一切事情:可以向前走,可以行动,但你必须完成这些长程活动。 而这些活动的选择,并不是研究者拍脑袋想出来的——不是“哦,我想让机器人去拖个地”之类的。 它们是通过一项调查选出来的。研究者先去查美国劳工部的网站,看美国人每天在家里都在做什么,由此列出一张“最常做的活动”清单。然后他们做了一项调查:如果机器人帮你做这件事,你能在多大程度上受益? 人们给这些活动打了分,于是就有了一个排序。 排在第一位的,是“聚会之后打扫房间”。第二位是“清理淋浴间”。而排在四百名左右的,是“摆好餐桌”——因为有些人喜欢做饭,他们并不想让机器人替他们摆桌子。“一起做饭”也是类似的情况。 我们和一大群人一起建成了这个基准。参与的 PI 有五六位,学生有二十来位,前后历时五六年,因为要仿真一千项家庭活动,这个基准建起来实在太难了。而且还要把它设置成一个挑战赛。 我们最终把它做成了一个挑战赛,并且必须定义清楚指标:一顿晚餐的初始条件是什么?机器人成功做好这顿晚餐意味着什么?哪些资产(assets)支撑这个基准?大量的精力都花在了这些地方。 终于,我们做成了。在五年的开发之后,第一届挑战赛于去年举办,我们从中挑选了 50 项活动,因为尽管一千个场景最终都可用了,它们还是太难了,我们希望采集一些演示。 于是我们对这 50 项任务采集了大量的人类演示,总计 3000 小时,还有若干基线方案。我们有二十来支参赛队伍参加。 我觉得这相当令人兴奋。今年我们还会再办一届。欢迎大家提交作品。我们还增加了额外的内容,也有更多演示。基本上,我们花了相当可观的一笔钱,考虑到这是一个学术机构,这笔投入是很大的,来为这些活动采集更多演示。 好,我们来回顾一下。 我们讨论了:如何为机器人操作发现结构化的表示;如何泛化到那些我们甚至可能没有演示的场景。方式各有不同,有的借助合成数据,有的借助预训练的基础模型和视频模型;以及我们尝试用来评估它们的各种基准。回到这个 workshop 的主题,我们一直在思考的是:如何从三维、四维数据以及语言数据中,发现和发展出这些模型。 而在这里,还有一件我们探索得不算多的事情:这些智能体系统(agent systems)本身。 在智能体(agents)还不流行的时候,大概两年前,我们做过一些尝试。而现在,当大模型变得越来越强,我认为这里存在大量机会。 因为追踪大规模机器人数据这件事,一直都非常困难。从遥操作,到第一人称视角(egocentric)数据,到各种形式,数据的采集始终是个难题。 所以情况可能是这样的:这些强大的模型本身,或许已经包含了非常丰富的信息…… ▎Q1:既然基础模型已经学会了生成某种“从隐式表示到隐式表示”的东西,那我们能不能直接用这种隐式表示来训练机器人,而忽略那些显式的部分?
我想我大概明白你的意思,但我不太确定你的问题具体指什么。你能举个例子吗?比如,你说的隐式表示是指什么? (提问者补充:比如 Dreamer 这类工作。Google 有 Dreamer 3 之类的工作,它们是隐式的表示模型,但带有动作组件,不像 JEPA,JEPA 没有动作组件。它们有一些关于如何用在机器人上的简单演示。你是这个意思吗?我理解对了吗?) (提问者:是的。我的意思是,我们能不能干脆忽略那些显式的东西?比如对于基础模型生成的视频,另一种做法是:我们直接从基础模型里学习,就像 Dreamer 那样——但我们不把它“画”出来,不让机器人从基础模型生成的视频里学。) A:好,这确实是个不错的问题。 我想先澄清几件事。 第一,当我说“从视频扩散模型里偷知识”的时候,我们实际上并没有真的生成视频。你有一个视频扩散模型,它只被用来计算分数(score)。没有任何视频被生成出来。你可以把它理解成:它被当作一个先验(prior)来指导你——就像 SDS 一样,没有图像被生成,你只是计算出分数,用来更新你的表示。 但如果你是在说,我们必须依赖一个预训练的视频扩散模型,这件事本身就已经“太显式”了。那么像 Dreamer 这类方法确实不同:你不需要训练一个视频模型作为先验,一切都是在隐空间里学习,规划也更多是在隐空间里进行。你不会产生显式的谓词(predicates),你有的只是隐空间中被预测出来的方向。 我觉得那可能会很有意思。 但我认为,就目前而言,这类方法——对比那些更专门做视频的方法,比如现在流行的 world action models(那些公司发布的东西),我认为 world action models 比我们用 Dreamer 能做到的要令人印象深刻得多。 不过往前看,谁知道呢。你想利用视频里那些海量数据,这一点是相当明显的;你想共享这些模型,这一点对于具体的形式而言,我认为也是相当明显的。 ▎Q2:我想问一个关于“奖励模型过时”的问题:当你的奖励模型变得陈旧(stale)时,你怎么检测你的知识已经不再被激活,又该如何修复或补救它?
嗯,我觉得这可能在更大程度上要分情况讨论。 这其实是表示学习社区里一直存在的一个问题。他们总是在用 FID 之类的指标,但 FID 的问题是非常明显的——你在测试集上得到的 FID,实际上会比你预期的要好得多,这显然是个问题。 所以这就属于那种“用一个并不是最优的指标,去学习更好的表示”的情形。 顺便做个小广告:我们之前做过一个规模更大的图像数据集,它完全符合 CC 协议,所有人都可以下载;而且它还附带了一个比大家都在用的 FID 更好的指标。 但话说回来,确实存在一些情形,指标是过时的,奖励模型也是过时的,你可以去更新它,但更新有时候要花很大的力气。光是做那个更大的图像数据集,就又花了五六个月。 所以,如果你能更新它,那当然很好,毫无疑问。但也存在另一些情形。比如,如果你用的奖励模型是一个视频扩散模型,它本身一直在被推进,那么要更新这种视频扩散模型——它需要极其庞大的模型和数据——实际上是极其困难的。 不过我倾向于认为,这更多是“用小模型当奖励模型”时才会出现的问题。因为 FID 本身就是一个小网络。而如今有了这些极其强大的基础模型,如果你把它们当作某种奖励来使用,我认为它们过时的可能性要小一些。 与此同时,也有人在持续收集大量数据——比如奖励数据(reward data),这取决于你关心的路径是什么,以及你如何思考它们可能被持续更新的方式。 我不知道。如果你能有一种更聪明的办法,把人放在环路里(human in the loop),又不至于慢到让人无法接受,从而能持续收集到更新的数据和奖励,那会很棒。因为从人那里收集任何形式的数据,本身就是一个瓶颈。 但我认为,对于大模型来说,总体而言,它们过拟合、过时的可能性是比较小的。 ▎Q3:我的问题是,你在演讲里从不同来源学到了不同的结构,我的意思是,我感觉我们的表示并不统一。
我不觉得我们的表示不统一。我认为我们的表示其实是相当统一的。 在这个意义上,物体和任务中有趣的结构,几何的类型、任务的结构与关系,也就是“什么依赖于什么”,我认为这些东西是统一的。 我认为区别不在于“表示本身不统一”,而在于另外两件事。第一,那个统一的表示到底是什么?第二,我们如何把它表示出来?还有第三个问题:即便某种表示已经被以某种方式表示出来了,你怎么才能得到它? 举个例子,就说三维表示。你可以直接让一个神经网络输出点云;也可以直接用点云来表示它;你也可以直接去问 GPT,让它输出点云。所以,不管那个表示是什么,我认为人们在这件事上的分歧并没有那么大——它是相当统一的。 但是,在“如何表示一个表示”,以及“我们如何得到这个表示”这两件事上,我认为仍然有相当多有意思的问题等待我们去解决,谢谢。
文章精选:
1.图灵奖得主姚期智最新演讲: AI有边界,恰恰是好事
2.图灵奖得主本吉奥警告全网:AI已经学会“演给安全测试看”,下一代我们可能真的抓不住了!3.图灵奖得主萨顿 WAIC 2026 最新演讲:现在的 AI 还不算真智能,我们正迈入经验时代4.菲尔兹奖得主陶哲轩最新访谈:未来数学属于人类与 AI 的混合体5.图灵奖得主、AI教父辛顿:AI已具备意识,且将进化成远超人类的智能生命体6.图灵奖得主、“AI教父”辛顿认错:我当年想得太简单!卡死医疗AI落地的,其实是背后的法律7.图灵奖得主Bengio预言o1无法抵达AGI!Nature权威解读AI智能惊人进化,终极边界就在眼前8.图灵奖得主、强化学习之父Rich Sutton:大语言模型是一个错误的起点9.图灵奖得主杨立昆:大语言模型缺乏对物理世界的理解和推理能力,无法实现人类水平智能10.压缩即是全部 —— 菲尔兹奖得主 Michael Freedman 给数学和 AI 的一封信
转载说明:本文系转载内容,版权归原作者及原出处所有。转载目的在于传递更多行业信息,文章观点仅代表原作者本人,与本平台立场无关。若涉及作品版权问题,请原作者或相关权利人及时与本平台联系,我们将在第一时间核实后移除相关内容。

 五度妙笔
 企业透视镜
 API商城

 数据库