五度妙笔
 企业透视镜
 API商城

 数据库
谷歌披露 RSI 最新进展:AI 不改模型参数,也能在“梦中”学会自我改进
如果把当前的 AI 研究智能体比作一支探索队伍,大模型决定了队员有多聪明,工具决定了它们能做什么,而搜索策略决定了它们往哪里走、何时放弃一条路线,以及如何分配有限的算力。
谷歌最新公布的 Dream-RSI,首先试图改进的不是模型本身,而是最后这一层。
近日,来自 Google、Google DeepMind、马里兰大学帕克分校和弗吉尼亚大学的研究团队发布论文《Dream-RSI:通过演化世界实现递归自我改进》。
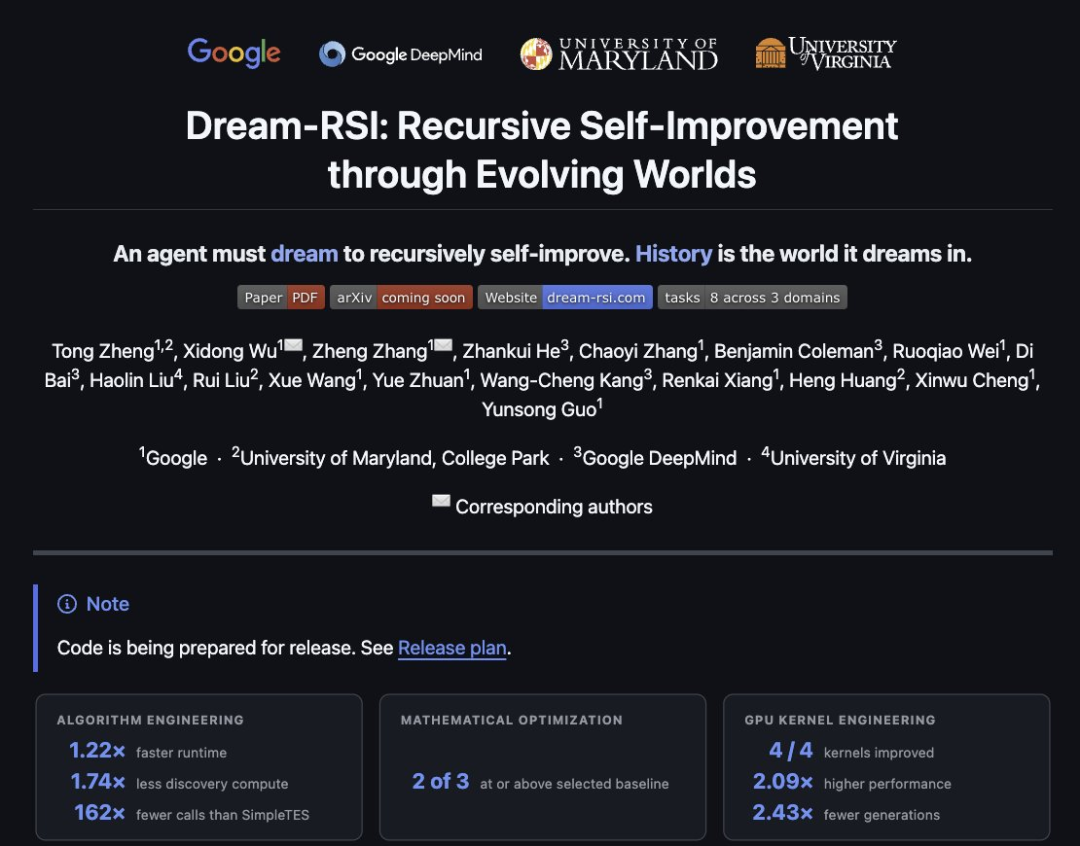
研究人员提出一种新的递归自我改进框架:AI 可以把过去执行任务留下的搜索记录转化为一个“回放模拟器”,在不重新训练模型、也不反复调用智能体执行真实任务的情况下,测试和改写自己的探索策略。
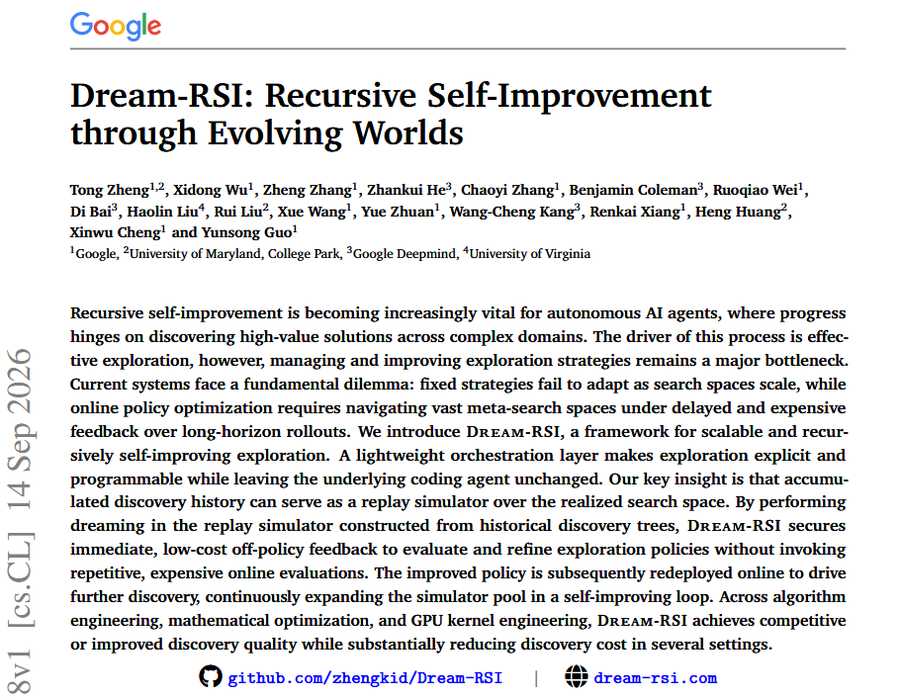
随后,改进后的策略会重新投入真实任务,产生新的探索历史,进一步扩充模拟器。如此反复,系统便形成了一个从“行动—记录—做梦—改进—再行动”构成的闭环。
研究团队将这一过程称为“Dreaming”,也就是“做梦”。
实验显示,在算法工程、数学优化和 GPU 内核优化三类任务中,Dream-RSI 在部分场景下能够以更少的模型调用获得相当或更好的结果。
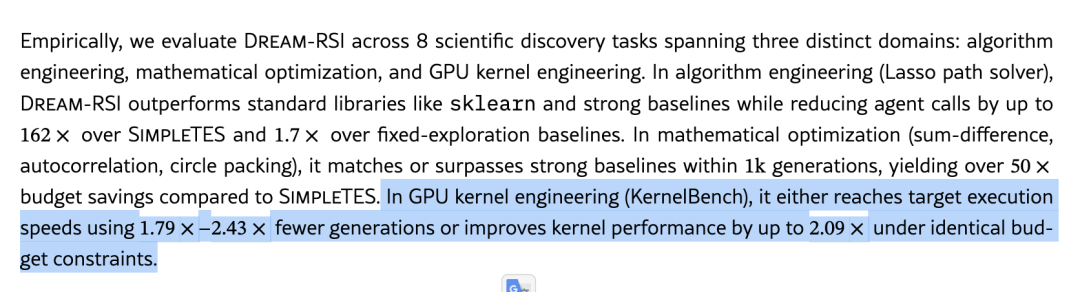
其中,在 Lasso 算法发现任务中,其调用次数较已有系统最高减少约 162 倍;在 GPU Kernel 任务中,系统最多用少约 2.43 倍的生成次数达到相近性能,或者在相似计算预算下,将内核性能提高至固定搜索策略的 2.09 倍。
不过,这距离科幻叙事中的“AI 自己训练出更强的 AI”仍有明显距离。Dream-RSI 没有修改 Gemini 的模型权重,真正发生变化的是模型外部的搜索和编排代码。更准确地说,这是一种发生在智能体 Harness 或元探索层的递归自我改进,而不是基础模型能力的无限递归增长。
过去一年,AI 驱动的科研与算法发现正在从一次性回答问题,转向大规模、长时间的自动搜索。
以 Google DeepMind 的 AlphaEvolve 为例,系统并不是让大模型一次写出最优程序,而是让模型不断生成候选方案,通过自动评估器测试,再围绕表现较好的方案继续变异。整个过程可能包含数百甚至数千轮“生成—执行—评分—修改”。
这类系统的效果,不仅取决于底层模型有多强,还取决于一套更隐蔽的机制:探索策略。
面对已经生成的大量候选方案,智能体需要决定:
是继续改进当前最好的程序,还是开启一条新路线; 哪些失败是值得修复的,哪些方向应该尽早放弃; 应该同时并行多少个实验; 在什么时间停止搜索; 有限的 Token、API 调用和计算资源应该如何分配。
目前,这些策略大多由研究人员提前编写,并在任务执行期间保持固定。
问题在于,当搜索空间扩大、任务周期拉长后,一套固定策略很容易反复进入无效方向。例如,系统可能持续优化一个已经接近上限的方案,也可能因为早期一次失败,过早放弃一条原本有潜力的路线。
一种直接的解决办法,是让 AI 在线测试不同的搜索策略。但测试一套策略是否有效,往往需要让智能体重新运行完整任务。每换一次策略,都可能需要数百甚至数千次模型调用,计算成本很快变得难以承受。
Dream-RSI 的核心,就是希望绕开这部分成本。
Dream-RSI 最关键的设计,是不再把过去的搜索记录仅仅视为日志或者提示词,而是将其重新组织成一棵完整的“发现树”。
在这棵树中,每个节点都对应一次真实的生成和评估过程,保存了当时的工作区状态、候选程序、执行结果、错误信息和最终得分。不同分支代表智能体曾经探索过的不同方向。
当一次真实搜索结束后,Dream-RSI 会把整棵发现树转化为一个回放模拟器。
由于树中每一个已经走过的节点都有真实结果,系统在测试新策略时,不需要再次调用 Gemini 生成代码,也不需要重新运行评估程序。它只需要让新策略在历史记录中重新做一遍选择:
如果当时先探索另一条分支,结果会怎样?如果同时启动更多并行任务,能否更早找到高分答案?如果在第五轮停止一个长期没有进展的方向,可以节省多少调用?如果没有因为第一次报错而放弃,后续是否可能恢复?
这些问题的答案已经包含在历史发现树中。新的搜索策略只需要按照不同顺序读取已有节点,就可以估算自己在真实运行中可能取得的效果。
研究团队把这个过程称为“做梦”:系统不必在真实世界中重新经历每一种搜索策略,而是先在过去经验构成的世界中,模拟大量可能的行动路线。
其思路与基于世界模型的强化学习有一定相似性。
DeepMind 此前的 Dreamer 系列研究,是让智能体在学习到的环境模型中想象未来轨迹;Dream-RSI 则将类似思路用于科研和编程智能体的搜索编排。
两者之间也有区别。Dream-RSI 并没有训练一个新的世界模型来预测未知结果,其模拟器完全由已经发生过的真实搜索记录组成。因此,在已经记录的节点范围内,回放结果是确定的;但它也无法预测历史记录之外的新分支会产生什么结果。
Dream-RSI 的运行过程可以分成三个阶段。
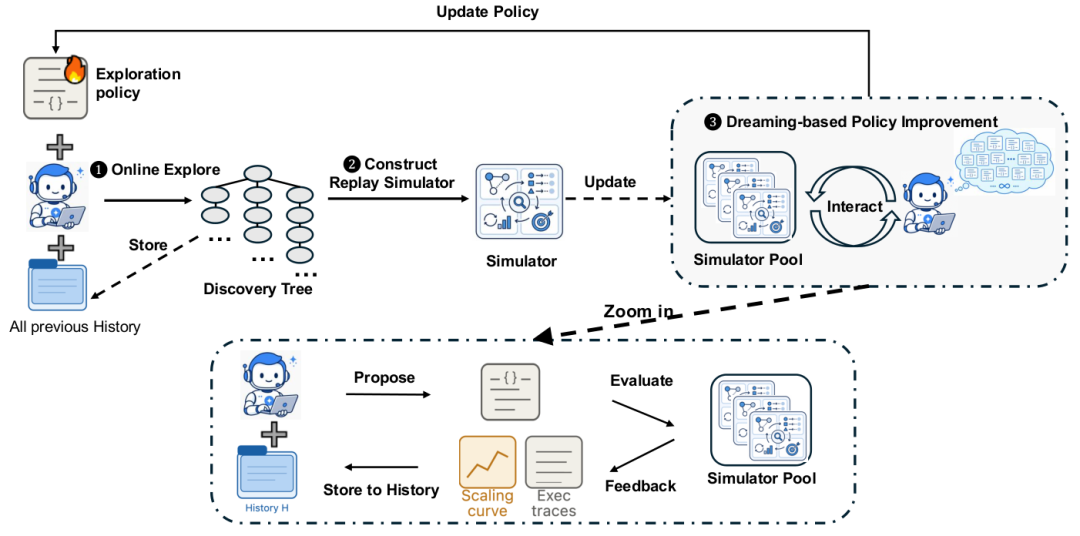
第一步是真实探索。
当前搜索策略负责调度 Gemini 编程智能体,决定从哪些节点继续生成、开启多少个并行分支,以及何时停止。每一次生成和评估都会被保存,最终形成一棵新的发现树。
第二步是构建回放模拟器。
系统将本轮以及此前所有轮次的发现树加入模拟器池。过去执行任务产生的经验不再是一次性消耗品,而是转化为后续优化搜索策略的数据。
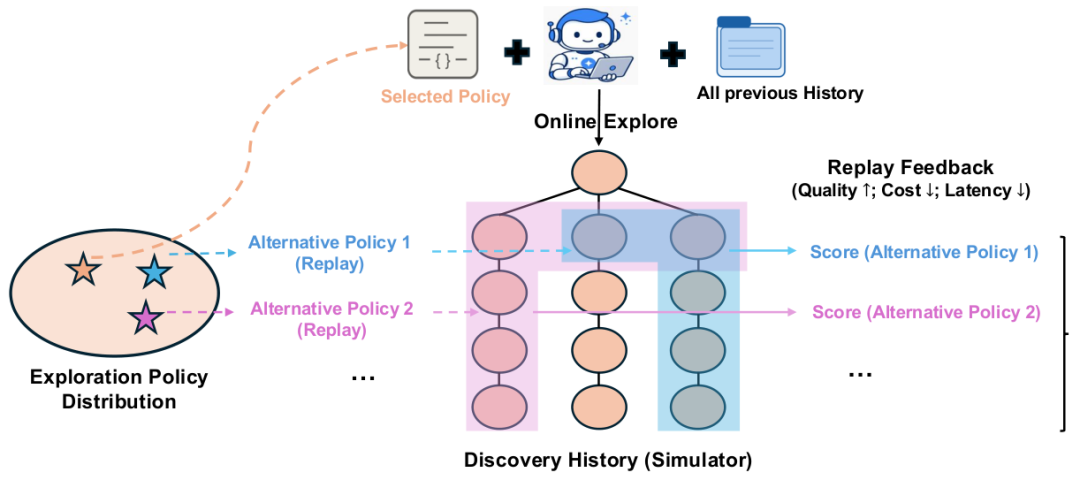
第三步是离线“做梦”。
另一个固定的大模型智能体负责修改探索策略代码,生成多个候选策略。这些策略被放入历史模拟器中测试,按照三个指标评分:最终找到的答案质量、消耗的模型调用数量,以及并行计算资源的利用效率。
获得最高综合得分的策略,会被部署到下一轮真实搜索中。下一轮产生的新历史又会进入模拟器,帮助系统继续改进策略。
需要注意的是,在整个循环中,Gemini 模型、任务评估器和执行接口都保持不变。发生改变的只是模型外部的一层轻量级编排代码,它控制搜索的宽度、深度、并行度和停止规则。
因此,Dream-RSI 所实现的并不是“模型修改自己的参数”,而是“智能体修改自己使用模型的方式”。
研究团队首先在 Lasso Regularization Path 算法工程任务上测试了 Dream-RSI。
Lasso 是统计学和机器学习中的常用方法,广泛应用于特征选择、基因组分析和金融建模。实验要求 AI 在保证数值正确的前提下,发现运行速度更快的 Lasso 路径求解器。
研究人员使用 17 个合成实例进行搜索,再通过六个没有出现在搜索阶段的数据集检验算法的泛化能力。
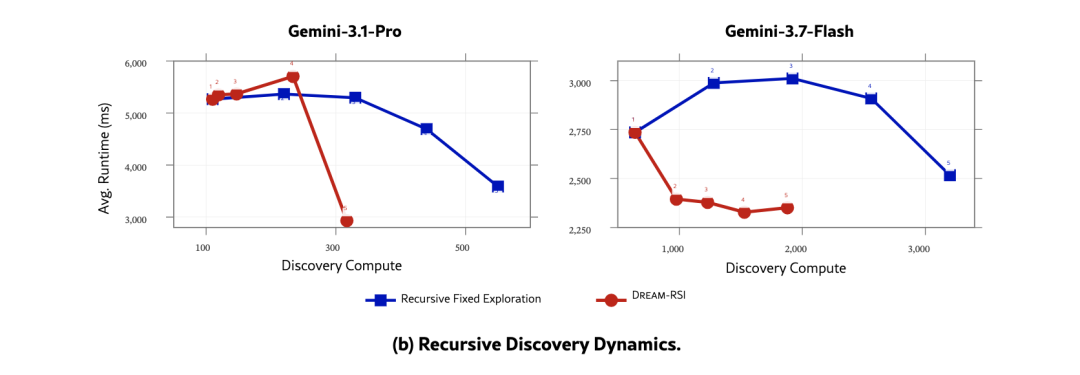
以 Gemini 3.1 Pro 为底层智能体时,固定探索策略经过 550 次智能体调用,得到的求解器在六个数据集上的平均运行时间为 3587.1 毫秒;Dream-RSI 使用 317 次调用,将平均时间缩短到 2931.0 毫秒。
相比之下,Dream-RSI 在结果更好的同时,将搜索调用量降低约 42%。
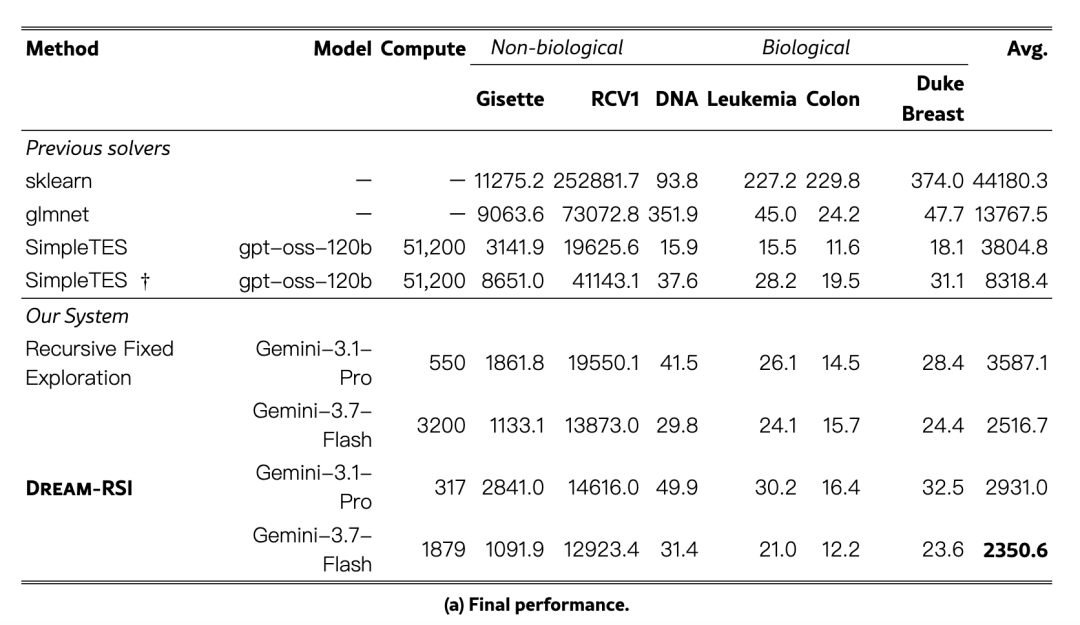
以 Gemini 3.7 Flash 为底层智能体时,固定策略使用 3200 次调用,最终求解器平均运行时间为 2516.7 毫秒;Dream-RSI 使用 1879 次调用,将平均运行时间进一步降低至 2350.6 毫秒。
研究人员还将其与 SimpleTES 进行了比较。后者使用 GPT-OSS-120B,并进行了 51200 次生成。Dream-RSI 最少仅使用 317 次调用,因此得出了最高约 162 倍调用差距的说法。
但这一数字需要谨慎理解。Dream-RSI 与 SimpleTES 使用了不同的底层模型和系统设计,并非严格控制变量的横向比较。更有说服力的结果,仍然是其与采用相同模型、相同资源和相同初始策略的固定搜索基线之间的对比。
最终,Dream-RSI 找到的程序在六个测试数据集上均超过了 scikit-learn 和 glmnet 的标准实现。不过,这一结论仅适用于论文给定的数据集、硬件和正确性约束,并不意味着它已经能够全面取代这些经过长期验证的通用软件库。
在 GPU 内核工程任务中,研究人员选取了 KernelBench 中的 VGG16、LayerNorm、ConvDiv 和 ConvMax 四项任务。
这类任务要求智能体同时处理算法结构、显存访问、线程并行和硬件特定优化,也是检验编程智能体能否产出高性能代码的重要场景。
实验结果显示,在 VGG16 和 LayerNorm 上,Dream-RSI 分别以少 2.43 倍和 1.79 倍的生成次数,达到与固定搜索策略相近的性能。
在 ConvDiv 和 ConvMax 上,两种方法使用近似的搜索预算,Dream-RSI 找到的内核性能分别达到固定策略的 2.09 倍和 1.44 倍。
更值得注意的是,系统的搜索行为并不是简单地越来越激进。
在 ConvDiv 实验中,随着前几轮结果持续改善,Dream-RSI 将每轮评估次数从 110 次逐渐减少到 50 次,主动节省计算资源;当性能进入平台期后,它又重新扩大搜索范围,随后获得新的性能提升。
这说明它学到的并非一条固定规则,而是在尝试根据历史状态调整探索强度:有进展时继续利用有效路线,陷入停滞时增加搜索宽度。
论文中还有一个颇为反直觉的结果。
一种常见的智能体改进方式,是把历史经验总结成自然语言,例如告诉模型“哪些方向曾经成功”“哪些方案不值得继续尝试”,再将这些总结加入下一轮提示词。
研究团队也测试了这种做法,但结果持续低于不加入方向性建议的版本。
研究人员认为,长周期探索依赖于多个并行方向,而自然语言总结容易把历史中偶然成功的路线固化成强先验,导致模型过早收缩搜索空间。换句话说,系统可能从过去“学得太具体”,最终只会沿着已经验证过的道路继续前进。
Dream-RSI 没有直接告诉智能体下一步应该研究什么,而是让它在完整历史中测试“应该如何分配搜索资源”。它改进的是寻找答案的方法,而不是把过去的答案直接塞回上下文。
这也构成了 Dream-RSI 与普通记忆系统的主要区别:记忆通常为下一次决策提供内容,而回放模拟器为“决策机制本身”提供训练和评估环境。
Dream-RSI 论文公布前后,谷歌在组织层面也释放了另一个值得关注的信号。
今天凌晨,DeepMind CEO Demis Hassabis 宣布成立 DeepMind Institute。
与负责训练模型、推进产品和开展技术研究的 Google DeepMind 不同,这个新机构主要关注 AGI 可能带来的社会影响,希望引入计算机科学之外的经济学、公共政策、哲学、教育和社会科学等视角,讨论通用人工智能如何被安全部署,以及它将如何改变经济、科研和人类生活。
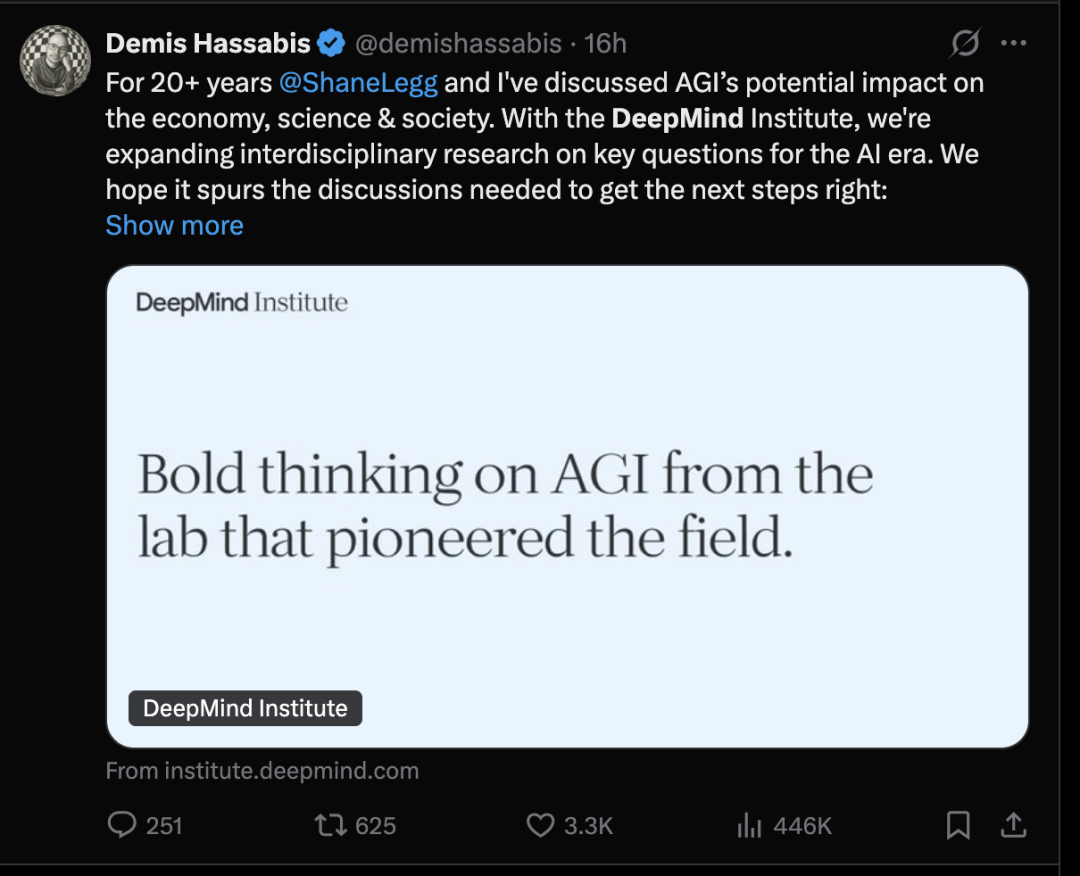
“通过 DeepMind Institute,我们正在扩大对 AI 时代关键问题的跨学科研究。”Hassabis 在宣布这一消息时表示。
该机构由 Google DeepMind 联合创始人 Shane Legg 担任执行编辑,Google 高级副总裁 James Manyika 与 Hassabis 共同参与。首批研究内容涉及 AGI 时代的经济政策、模型推理过程的透明度、AGI 的全球可及性,以及技术进步与“人类繁荣”之间的关系。
Axios 报道称,该机构不仅会汇集 Google 和 DeepMind 内部研究人员,也将引入外部学者,希望把原本分散在实验室和学术论文中的讨论转化为更公开的社会辩论。
Hassabis、Manyika 与 Legg 在成立声明中也承认,Google、Google DeepMind 与外部研究群体不会总是达成一致,随着前沿技术和证据快速变化,参与者也可能改变原有判断。成立这一机构的理由,正是社会需要更广泛的知识讨论,才能逐步形成应对 AGI 机遇与风险的共识。
Shane Legg 在新机构成立之际警告,AI 能力的进步速度不应超过安全控制的发展速度。越来越强的 AI 智能体已经能够编写软件、执行长时间任务,并参与开发新的 AI 系统,这也让递归自我改进从一个理论概念逐渐变成现实的治理问题。
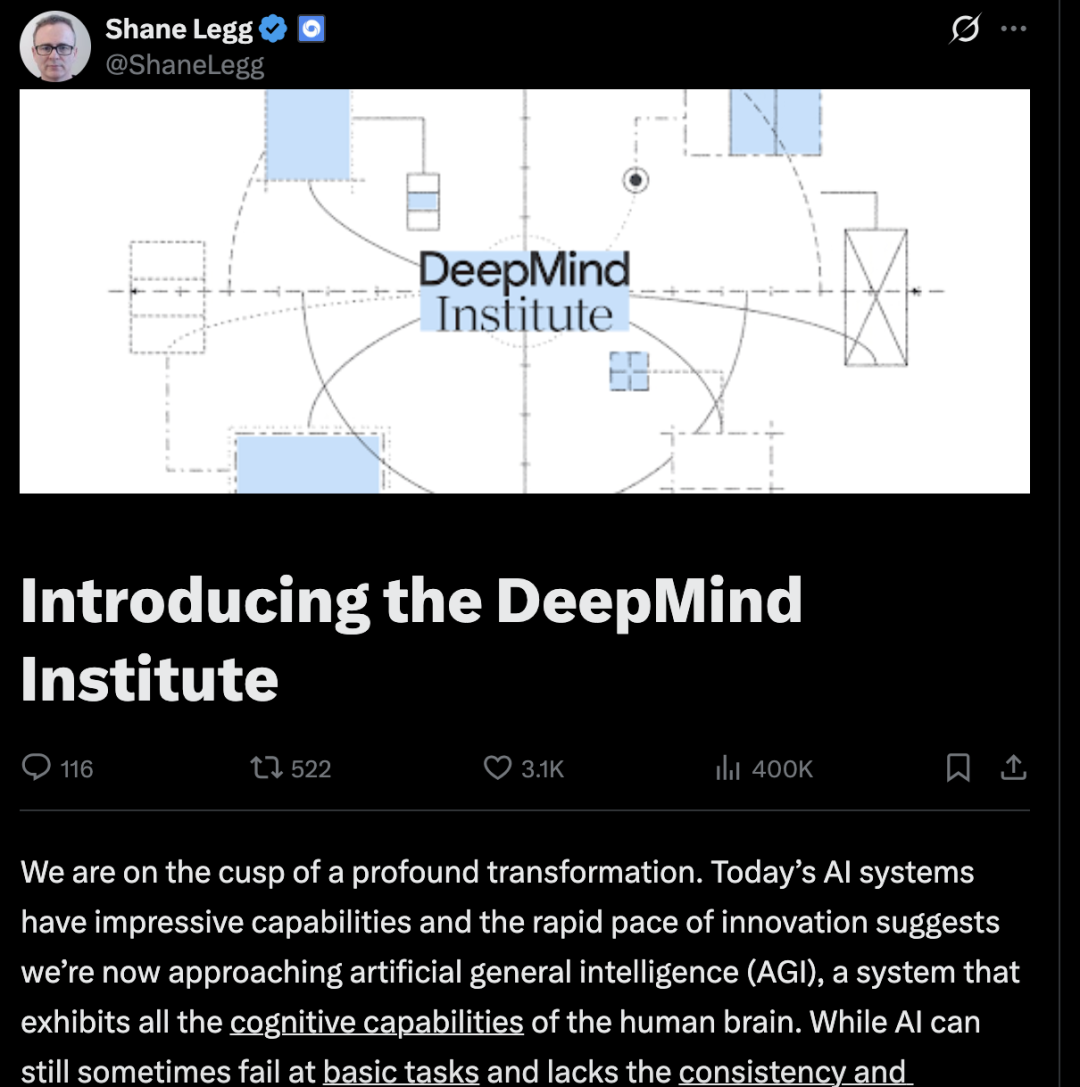
不过,Legg 同时认为,现在宣布 AGI 已经到来仍为时过早。他仍维持此前的判断:到 2028 年出现“最低限度 AGI”的概率约为 50%。
Google DeepMind 将 AGI 理解为拥有接近人脑广泛认知能力的系统,不是只在编程、数学或者某些专业任务上超过人类的模型。
到这说到底,这算真正的 RSI 吗?
RSI,即 Recursive Self-Improvement,通常被翻译为“递归自我改进”。在更激进的定义中,一个 AI 系统不仅能完成任务,还能改进自身核心能力;改进后的系统又会以更高效率继续改进自己,最终形成能力加速增长。
Dream-RSI 确实满足了其中一部分结构特征:
系统修改自己的探索策略;新策略产生新的搜索经验;新经验又用于改进下一代策略,形成了持续闭环。
但它至少存在三重边界。
首先,它没有修改底层模型权重。Gemini 3.1 Pro 和 Gemini 3.7 Flash 在实验过程中保持不变,系统没有训练出一个更强的新模型。
其次,它改进的是特定的元探索策略。系统学会了更合理地选择分支、利用并行资源和决定停止时间,但没有证明这种提升可以无限延续,也没有证明策略可以直接迁移到任意开放任务。
第三,所谓“世界”只覆盖已经探索过的空间。回放模拟器无法生成历史之外的新结果。如果过去从未尝试过某种路线,系统就无法仅靠回放准确判断这条路线的价值。它可以更有效地利用经验,却不能取代真实探索。
此外,当前结果来自研究团队自行设计和执行的八项任务,论文仍处于预印本阶段。项目仓库显示,完整代码还在准备发布,外部研究者目前尚不能完整复现实验。
因此,将 Dream-RSI 描述为“AI 已经可以无限自我进化”,从这一角度讲有些夸大了论文结论。更准确的判断是,谷歌展示了一种成本更低的元层自我改进机制:不需要重新训练大模型,也可以让智能体根据执行历史持续修改自己的搜索编排方式。
Dream-RSI 的意义,也许不在于它已经实现了一个强版本的递归自我改进,在于它进一步扩大了“AI 自我改进”的边界。
过去谈到模型进步,行业首先想到的是增加预训练算力、扩展数据规模、进行强化学习,或者由上一代模型帮助生成下一代模型的训练数据。这些路径都直接作用于模型参数,成本高、周期长,也需要大规模算力集群。
如今,越来越多研究开始把改进目标转向模型之外:提示词、上下文、记忆、技能库、评估标准、工具调用方式、多智能体协作机制,以及包裹模型的 Harness。
这意味着,未来衡量一个 AI 系统是否在自我改进,不能只看模型权重是否发生变化。即使基础模型被冻结,一个能够自动修改工作流、调整搜索策略、积累经验并重新分配计算资源的智能体,也可能在同样的 Token 预算下完成更复杂的任务。
从这个角度看,Dream-RSI 与其说是在创造一个会自我训练的模型,不如说是在创造一套会自我管理的研究系统。
它不会让 Gemini 醒来后突然变得更聪明,却可能让同一个 Gemini 更少走弯路。
而在需要成千上万次生成与验证的自动科研阶段,减少无效探索本身,就可能成为一种重要的能力增长方式。
参考资料:
https://arxiv.org/html/2609.14858v1
https://www.reddit.com/r/singularity/comments/1whwy4m/google_demonstrated_rsi_loop_for_ai_discovery/
https://x.com/ShaneLegg/status/2100229706641539248
https://www.axios.com/2026/09/16/google-deepmind-institute-agi
声明:本文为 AI 前线原创,不代表平台观点,也不构成投资建议,未经许可禁止转载。
 会议推荐
QCon 全球软件开发大会·2026(上海站)将于 10 月 22 日—24 日举办。本届大会聚焦 Harness AI 时代的工程实践,从「构建 AI」到「驾驭 AI」,围绕 AI Native 架构、Agent Runtime、AI Infra、Agent 安全与可观测、Loop Engineering、具身智能与世界模型等热门技术方向,邀请全球技术社区与产业一线实践者,共同分享 AI Native 时代最具价值的工程经验。查看更多详情可扫码或联系票务经理 18514549229 进行咨询。
今日荐文
刚刚!OpenAI与Anthropic CEO罕见同台,黄仁勋当场唱反调:AI到底要不要踩刹车?
129 亿美元卖身英伟达之后,是时候重新理解 Hugging Face 了
刚写完V4.1主算子就要“转业”?DeepSeek资深工程师深夜独白
Dario 高喊 AI 刹车,Altman、马斯克罕见同队支持!杨立昆翻旧账:7年前你就这么吓人
月之暗面:网传创始人及员工信息系恶意造谣;OpenAI 放弃今年上市;iPhone Duo炒到9万,黄牛贷款欲囤货|AI周报