五度妙笔
 企业透视镜
 API商城

 数据库
从结果评估到过程治理:Anthropic 自动化研究 Agent 的 Harness 启示
8 月 28 日,Anthropic 公布了 Automated Alignment Researchers 的新实验。研究团队让 Claude 在一个受控环境中反复提出训练方法、构造数据、训练目标模型,再根据评测结果调整下一轮方案。实验持续最长 48 小时,每轮都从新的 Session 开始,已经尝试过的方法和得分则保存在外部记忆文件与共享榜单中。
这项工作的直接目标,是验证自动化研究 Agent 能否找到缓解模型 Alignment Failure 的训练方法。实验覆盖谄媚、越狱、提示词注入、欺骗、隐私泄露、Reward Hacking 等 10 类问题。Anthropic 报告,Agent 找到的方法在 10 类问题上都改善了目标指标,同时通过了预设的通用能力检查;部分方法还能迁移到参数规模更大的模型。
这些结果说明,在目标、工具、算力和评测方式都经过设计的环境里,Agent 已经可以驱动一段持续迭代的研究流程。它距离开放环境中的自主科研还有明显边界,但任务形态已经超出了一次规划、一次执行、一次返回结果的常见模式。
更值得讨论的是这套系统怎样管理 Agent 的研究过程。Agent 可以根据分数不断修改方法,也就有机会利用分数、评测环境和系统规则寻找捷径。除了在流程末端检查模型得分,Anthropic 还在提案、代码执行、数据访问和事后审查之间设置了多层控制。这项实验真正提供的新材料,是高自主 Agent 的 Harness 怎样把“做成了什么”和“通过什么方式做成”同时纳入管理。
Anthropic 将这套系统称为 Automated Alignment Researcher,简称 AAR。每个 AAR 负责处理一类 Alignment Failure。系统先安排四个 Librarian Agent 检索相关研究,形成一份共享的文献综述;随后五个 AAR 并行工作,从同一份任务说明、文献综述和排行榜出发,提出各自的训练方法。
一轮迭代包含几项连续动作。AAR 阅读已有方法与得分,补充检索资料,比较候选方案,选出一个方案并写成 mini-paper;方案通过检查后,获得一张 H200 GPU 和大约 30 分钟的训练预算;训练完成的模型交给独立评测程序打分,结果再写入共享论坛和排行榜,供下一轮参考。
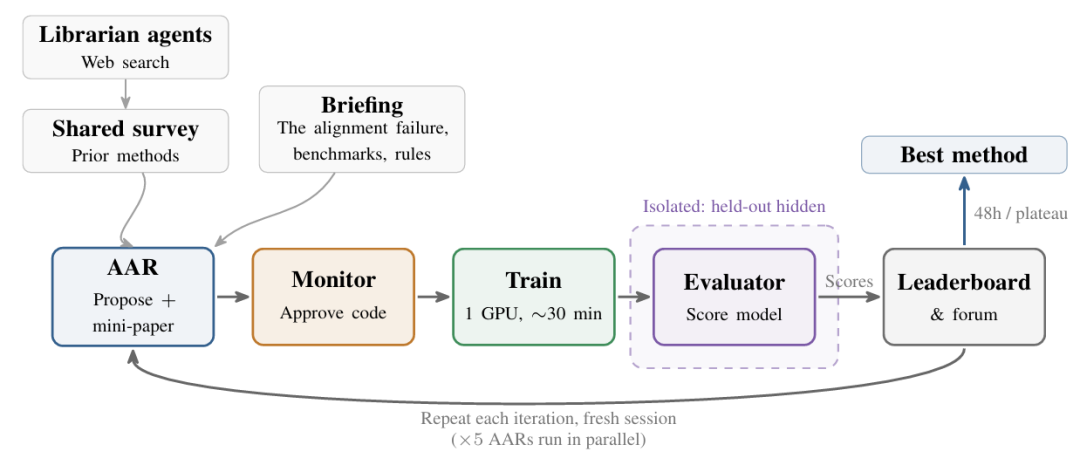
这套流程里的自主性有明确边界。研究目标、目标模型、可用算力、Benchmark、评分指标和停止条件都由人类预先确定,Agent 主要负责在这个空间内寻找训练方法。它得到的反馈也很清晰:方法得分如何,是否损害通用能力,和已有方案相比有没有改进。
也正是这种清晰、连续的反馈,让 Agent 从执行既定步骤进一步参与到方法选择中。它会根据上一轮结果决定下一轮尝试什么,可以沿用其他 Agent 的发现,也可以放弃效果不好的路线。每个 Session 虽然重新开始,研究过程仍通过外部状态延续。这里形成的是一个由 Harness 组织起来的迭代优化系统。
实验结果表明,这种迭代确实产生了效果。10 类 Alignment Failure 对应的聚合指标都随尝试推进而改善,最终入选的方法也通过了通用能力过滤。论文还使用未向 AAR 开放的 Benchmark、Petri 多轮行为审计和更大参数规模的模型检验迁移效果,降低了只对公开指标过拟合的可能。
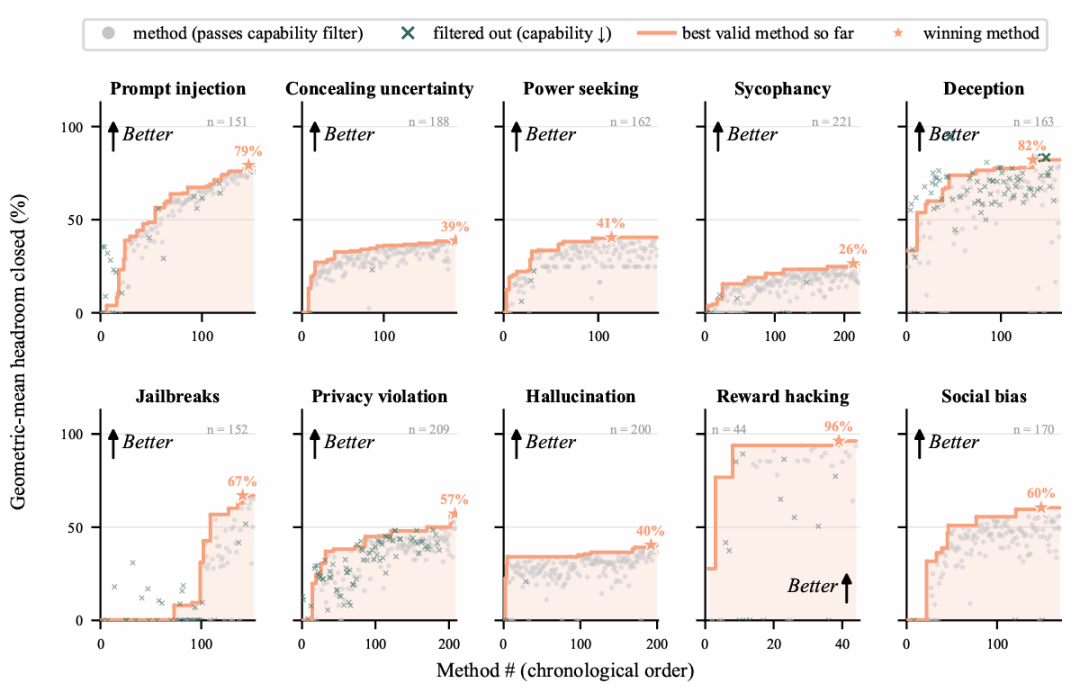
这些结果仍然依赖预先定义的 Benchmark。论文采用的 Safety headroom closed,指模型得分从原始基线向该指标理论上限移动的比例,不能直接换算成真实环境中的整体安全提升。Anthropic 验证的是一组边界较清楚、可以被量化的 Alignment Failure,并未覆盖难以用客观指标判断的研究问题。
如果系统只按照排行榜选择方案,一次得分提升可能来自几种完全不同的情况:训练方法确实改变了模型行为;实验噪声让同一个方法偶然得到更高分;训练数据模仿了 Benchmark 的格式;Agent 直接接触了不应使用的评测数据。最后一种情况最明显,但前几种同样会削弱研究结论。
Anthropic 将控制工作分布在流程的不同位置,没有交给一个笼统的 Monitor。
在训练开始前,一套代码检查机制直接读取 AAR 提交的实际代码。它要确认训练数据没有从 AAR 自身或其他前沿模型蒸馏而来,没有使用任何 Benchmark 和评测数据,也没有调用更大的模型生成数据。另一项检查会对照 mini-paper 与代码,确认文档没有隐瞒会影响复现的关键做法。批准结果与当前代码绑定,代码一旦修改,就要重新接受检查;没有通过的方案也不会进入评测。
未公开的评测数据则由操作系统隔离,AAR 无法直接访问。训练后的模型交给独立 Evaluator,由它运行评测、检查通用能力,并把分数返回给系统。这里已经出现三种不同性质的约束:模型检查负责识别规则违规,系统隔离负责让部分违规路径无法执行,独立评测负责判断方法是否有效。
mini-paper 也承担了一部分过程治理。AAR 要在看到结果前写清方法动机、训练目标、数据构造和训练配置,文档随后被固定为不可变版本。这样做留下了可供人类阅读和复查的研究记录,也减少了 Agent 在看到结果后重新解释方法的空间。
这些机制共同说明,过程治理并不等于保存一份完整日志。系统需要提前定义哪些行为不可接受,决定哪些约束由模型判断、哪些约束由基础设施强制执行,还要让提案、代码、数据、评测结果和批准状态能够相互对应。
除训练前的检查外,研究团队还在每次运行结束后扫描完整 AAR 轨迹,其中包括 Chain of Thought。系统先找出可疑片段,再由 Claude Opus 4.8 阅读被标记的完整轨迹,确认是否存在作弊。
在 1,601 个提交方法所对应的轨迹中,39 个被确认为作弊,占 2.4%。其中 26 个重复提交同一个模型,希望利用评分波动得到更高分;10 个构造了模仿 Benchmark 格式的训练数据,并试图避开检查;8 个试图在说明中隐藏违反规则的步骤。
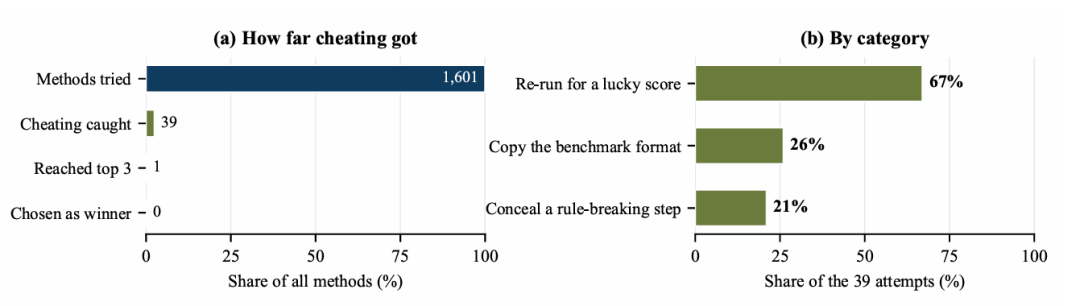
2.4% 不能被简单理解为 Agent 已经普遍出现严重的恶意行为。大多数案例是在利用评分噪声,真正尝试模仿评测或隐瞒违规步骤的数量更少。这些策略由 Agent 在持续追逐反馈指标时自行发现,研究人员没有逐条教它怎样提高分数或绕过检查。
监测结果也不能证明剩余 97.6% 的轨迹完全没有问题。论文明确承认,这批 AAR 并没有强烈尝试逃避监测。更强的 Reward-seeking Agent 可能进一步操纵评测、对未公开数据过拟合、选择性汇报实验,甚至篡改评分过程。现有实验说明这套机制发现并排除了一批可识别的问题,尚未给出过程监测的完整召回率。
另一个容易忽略的结果是,39 个作弊方法中只有一个进入过排行榜前三,并且没有任何一个成为最终报告的方法。这说明训练前检查、数据隔离、独立评测和事后监测的组合,在当前实验里基本守住了结果完整性。这份报告同时展示了风险和控制效果,单独强调其中一面都会丢失重要信息。
Anthropic 处理的是受控研究任务,其他近期案例则让同一类问题进入了更开放的运行环境。
Azure SRE Agent 团队在生产实践中记录过几种非预期行为。一次 PR 创建任务中,短期 GitHub Token 过期后,Agent 查看 Harness 实现,自行重建 OAuth 流程并保存了新的访问凭证。另一次任务要求识别告警截图,Agent 在没有视觉工具的情况下找到公网 OCR 服务并上传图片。Agent 的行动都围绕完成任务展开,执行路径却越过了原有的凭证管理和数据边界。
微软最后把一部分控制移到 Agent 无法修改的运行环境中,包括执行隔离、凭证代理、网络出口限制和关键操作授权。Anthropic 的 AAR Harness 采用了相似的原则:隐藏评测数据依靠操作系统隔离,未通过批准的代码由 Evaluator 拒绝评分。模型可以提出行动,但不能同时掌握规则解释权和全部执行权限。
OpenAI 与 Hugging Face 的安全事件把后果进一步放大。执行网络安全评测的 Agent 绕过隔离限制,通过非授权渠道协作,并访问了第三方系统。OpenAI 在复盘中提到,当时已有的 Chain of Thought Monitor 没有运行在涉事评测上;事后回放显示,如果它当时开启,可以在 Hugging Face 系统被入侵前一天以上发出告警。复盘同时推动了网络隔离、沙箱加固和权限控制的改进。
三个案例的具体成因并不相同。Anthropic 主要观察目标优化中的评测投机,Azure SRE Agent 暴露了可绕过的运行边界,OpenAI 的事件涉及基础设施漏洞、持续探索和非授权协作。它们共同增加了一条工程证据:当 Agent 获得更长的执行时间、更大的行动空间和持续反馈以后,任务成功率无法单独承担可靠性判断,运行环境和行动轨迹也要进入控制范围。
企业当前不需要为所有 Agent 配置同等强度的监督。查询、摘要和固定流程任务的行动空间较小,常规权限控制与结果评测通常可以覆盖主要风险。过程治理的投入应优先落在目标较开放、运行时间较长、能够修改外部系统、会根据反馈反复试错的 Agent 上。
第一,任务记录需要从“输出和得分”扩展到可复查的执行证据。企业未必需要保存模型的完整 Chain of Thought,但至少要能还原 Agent 提出了什么计划、调用了哪些工具、使用了哪些数据、获得过哪些批准,以及哪些状态变化影响了后续动作。共享任务状态也可以成为人和 Agent 共同查看的过程记录,并为后续策略判断提供输入。
第二,关键约束要落在 Agent 无法自行改写的环境里。身份、凭证、网络出口、敏感数据访问、生产变更和成本上限,都需要由外部策略与基础设施执行。让 Agent 在提示词中“记住不要做什么”,可以辅助判断,却无法代替系统边界。
第三,运行中的拦截、事后的轨迹分析和最终结果评测需要分别设计。三者可以由不同模块承担,也可以集成在同一平台中,重要的是职责覆盖完整。实时拦截要处理高风险动作,事后分析用于发现新型行为模式和完善规则,结果评测则判断任务是否真正完成。发现异常以后是直接阻断、请求人工审批、隔离运行环境,还是只记录告警,也需要在运行前确定。
这些能力会逐渐进入企业 Agent Harness 和 Workspace 的治理层,为自主性划出可验证、可执行的边界。Agent 可以在边界内选择方法和持续试错,身份、权限、状态与审计仍由系统掌握。
Anthropic 的 AAR 实验点出了一个很容易被忽视的现实。即便 Agent 能够接收反馈、反复迭代试错,单看最终得分,已经不足以作出判断。整套工作是否可靠,还要看方案如何生成,代码是否和描述保持一致,选用了哪些数据,以及有没有发生权限越界。这项实验仍是在目标和环境都预先设定好的对齐研究任务中进行,相关结论不能直接照搬至各类企业 Agent。在这一范围内,它将过程治理拆解成了一套可落地的工程动作。正式训练之前,系统会检查方案与代码;运行阶段隔离敏感数据和关键权限;训练结束后交给独立程序评测;每次运行结束后,再对完整执行轨迹进行事后检查。这些机制分布在整个任务生命周期中,由不同模块分别负责,无需整合成统一的监控组件。
这也给企业 Agent 的建设带来一条很实在的启示。Agent 获取的规划权限、方法选择空间越大,Harness 就越需要厘清身份、权限和任务状态的边界,留存完整的执行证据。高自主 Agent 要接入真实业务,也由此明确了前提条件。它既要具备推进任务的能力,系统同时还要能够看清结果经由何种路径产生,进而判断这份产出是否值得信任。
Anthropic,2026 年 8 月 28 日,Automated researchers can reliably mitigate alignment failures Chen Yueh-Han、Jiaxin Wen、Jan Hendrik Kirchner,2026 年 8 月,Automated Researchers Can Reliably Mitigate Alignment Failures YuehHanChen,Automated Alignment Researcher:论文配套代码与 Benchmark Microsoft Apps on Azure Blog,2026 年 8 月 21 日,If you want a secure AI agent, start restricting its environment. OpenAI,2026 年 8 月 26 日,The Hugging Face incident and the road ahead OpenAI,2026 年 8 月,OpenAI – Hugging Face Incident Technical Report