五度妙笔
 企业透视镜
 API商城

 数据库
让世界模型不再“迷路”:开源1600万数据集,大晓Puffin-World统一物理、几何与外观
视频生成模型的画质越来越逼真,但空间与方向却未必同样真实。
设想一台机器人走进一个陌生环境,它低头避开障碍,转身观察走廊,向前探索行进……每一次视线与机位的变换,都对模型的空间物理感知能力提出了考验:哪里是上?哪里是下?眼前的物体究竟有多远?换个角度看,三维空间能否保持几何一致?
当视频模型应用到具身智能,越来越多的从业者意识到,单纯生成一段看起来逼真、内部却毫无度量关系的二维像素视频,无法支撑真实的路径规划与空间交互。 缺乏底层物理约束的世界模型,极易在长距离轨迹下出现地平线漂移、几何畸变与视角失真。
针对这一瓶颈,大晓机器人联合南洋理工大学 S-Lab 等机构提出统一多模态世界模型框架 Puffin-World。该研究从底层重构表征,将外观、几何与物理三态纳入统一体系,打通了物理世界感知、自由视点空间仿真、三维生成与空间重建的链路。
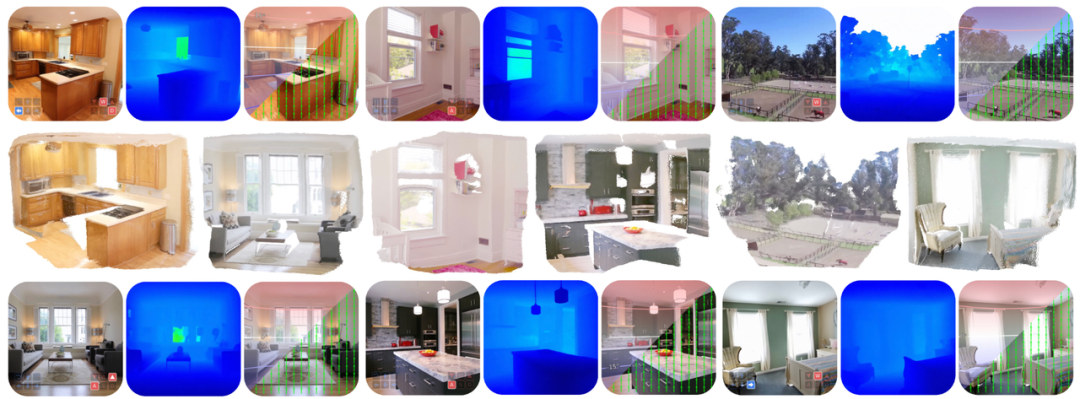
图 1|Puffin-World 联合建模外观、几何与物理这三类原生世界状态,并将生成的多视角观测整合为可交互的三维重建结果
该框架在生成一个新视角时,能同时预测“看见什么”“空间有多深”,并用重力参照约束“以什么姿态看”。目前,团队已同步公开代码、模型与千万级 Puffin-16M 数据集,并为 28 个公开数据集、约 4450 万张图像补充相机物理量标注。
对世界模型而言,大范围、持续性的视角变化是一场对空间一致性的大考。
从正面看是一张桌子,绕到侧面,桌面的高度与位置应当保持合理;相机向右倾斜,画面中的地平线也应随之变化;镜头抬起,新的观察需要符合目标俯仰角。
这些变化同时涉及相机运动、场景结构与重力方向。仅靠连续生成 RGB 图像,这些信息往往隐藏在模型内部,缺少明确的对应关系。尤其是在单张未标定图像、大幅旋转或长轨迹运动下,问题更容易暴露:单帧看起来合理,连续观察却可能出现地平线漂移,或者生成视角偏离指定轨迹。
这里存在一个容易忽略的区别:知道相机“转了多少”,还需要知道它最初“朝向哪里”。
相对运动可以描述前后两个视角的变化,却无法独立确定初始相机相对于重力的朝向。初始参照不明确,后续生成就更难稳定地保持方向关系。
同时,机器人需要空间距离来理解环境。只有颜色和纹理,还不足以直接获得用于三维重建的几何结构。
为此,Puffin-World 抛弃了传统“生成视频后再外挂深度模型”的拼接思路,把建模对象扩展为三种相互关联的世界状态:
• 外观状态:用 RGB 图像表达场景内容、纹理与视觉细节。
• 几何状态:用深度描述空间远近,为多视角观测和三维重建建立联系。
• 物理状态:用重力场与纬度图表达观测相对于重力和水平面的方向。
三者共同回答:眼前有什么、它们如何分布,以及当前相机以怎样的姿态观察这个世界。
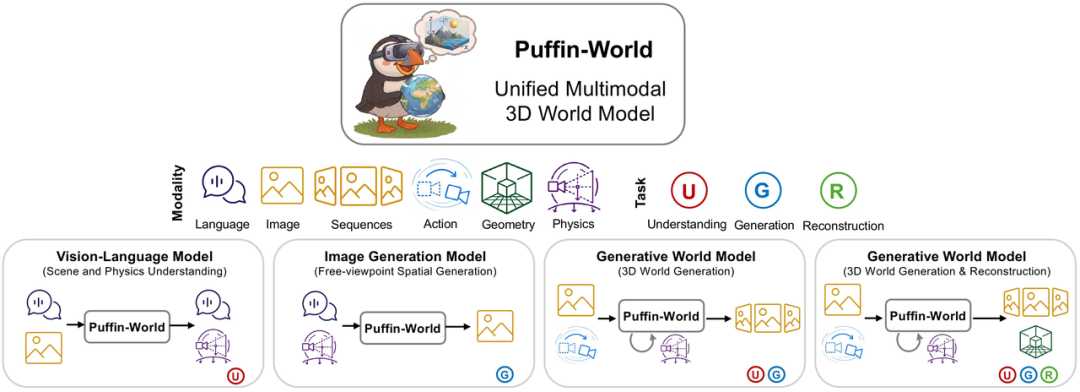
图 2|三种状态共同参与世界理解与生成,为视觉内容建立几何和方向参照。
要让世界模型生成的场景摆脱“平面画卷”的局限,模型必须同时理清两个关键问题:相机在重力坐标系下的绝对朝向,以及画面背后的真实三维距离。
为此,团队在架构中打通了三大核心设计,将机位控制、重力约束与空间深度统筹进同一个生成流程:
统一相机语言(Omni-Camera 表征):
团队设计了一套九通道表征,作为完整的“拍摄说明”:既记录相机相对于物理世界的方向,也描述不同视角之间的空间关系。
其中,绝对物理方向包含二维上方向向量与纬度角,把观测机位牢牢校准在地球重力与水平面下;相对空间几何则记录射线起点与视向,实现对旋转、平移及视场角(vFoV)的精细控制。
跨视角物理传播机制:
模型先从单张参考图像中解析出初始重力方向;一旦相机发生位移,便通过已知的相对运动关系,将该方向严密投影到目标相机的坐标系中,生成对应的重力场与纬度图作为条件先验。
这相当于在视角不断变化时,始终保留一份可追踪的方向参照。
即便机位发生剧烈横滚或大角度俯仰,画面的倾斜也会严格遵循重力规律,从根源上避免了视线漫游时的地平线漂移与空间失真。
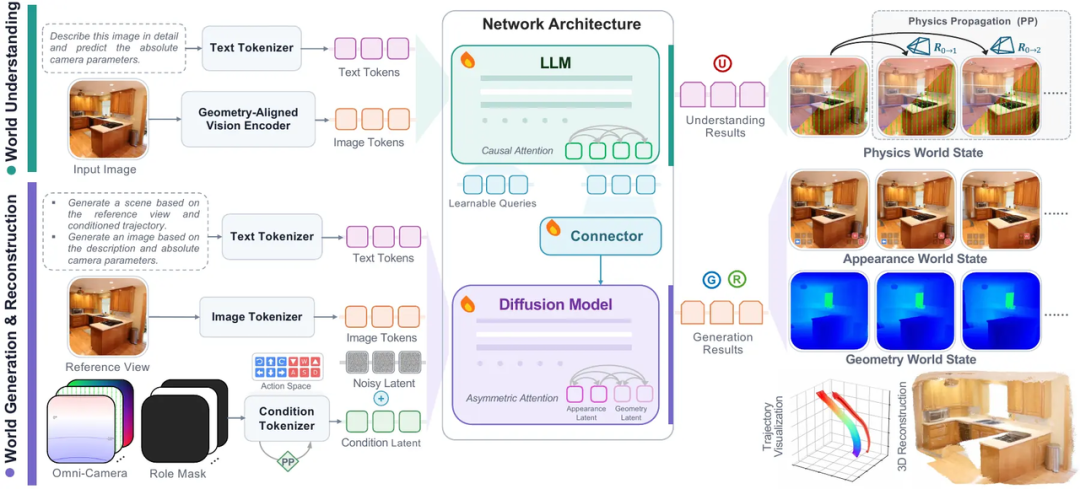
图 3|模型从参考图像感知物理方向,结合相机运动将物理参照传递到目标视角,并同步生成外观与深度
外观与空间深度同步解算
确定朝向之后,另一个问题是:生成的画面,如何变成有空间结构的场景?
Puffin-World 在同一个生成过程中联合预测目标视角的 RGB 图像与深度。结合相机参数,多视角图像和深度便可以进一步整合为三维场景,省去生成后再调用独立深度模型补估的步骤。
对下游研究而言,这意味着每次视角扩展都能同时获得视觉内容与几何信息,为重建和空间分析提供更直接的输入。
支撑这一过程的是统一的模型设计:图像与深度共享潜在空间,Omni-Camera 提供相机条件,角色标记区分参考视角、目标视角及不同状态。视觉编码器与语言模型负责理解,语言模型的隐藏状态经过连接模块,为扩散生成提供条件。
这种统一设计最终落在四类能力上。
第一类是单图物理感知。输入一张图像,模型根据地平线、垂直结构和场景构图等线索,预测相机横滚角、俯仰角与垂直视场角,并生成场景描述。它既分析图中内容,也估计拍摄这张图时的观测姿态。
第二类是自由视点空间仿真。用户可以同时提供文字和显式相机条件,让模型生成指定视角下的观察。相机参数由此成为直接的控制信号,参与决定画面如何呈现。
第三类是三维世界生成与重建。模型可以从图像或文字出发,沿指定轨迹生成新视角,同步输出外观与深度,再将多视角结果整合成三维场景。
第四类是闭环自校准探索。当当前视角偏离目标朝向时,模型先判断物理状态,再预测纠偏的相机动作,并生成调整后的观察,形成“感知—相机动作—生成”的交替过程。
论文还展示了模仿式世界探索:从共同的初始视角出发,按照给定相机轨迹扩展场景。
这些能力共享视觉、语言、相机与世界状态表示。切换任务主要通过改变输入条件和视图角色完成,让观察、运动与后续观察能够在同一框架内衔接。
空间能力的训练,需要足够丰富的视角变化。
现有三维或序列数据往往偏向水平拍摄、小幅旋转和以平移为主的运动。但主动探索可能包含连续抬头、低头、横滚,以及完整环视。训练数据对这些动作覆盖不足,模型就难以充分学习相应的视觉变化。
为此,团队构建了 Puffin-16M。
其中,Puffin-Cam-15M 包含约 1500 万组视觉—语言—相机三元组,覆盖多种场景、画幅比例、相机朝向与视场角,让图像内容、语义描述和观测条件对应起来。
Puffin-Traj-1M 则提供约 100 万条旋转轨迹,包含连续俯仰、顺逆时针旋转与完整环视,补充大幅旋转和长程视角变化的训练样本。
前者帮助模型理解“一张图是怎样拍出来的”,后者帮助模型学习“持续转动相机,观察会怎样变化”。
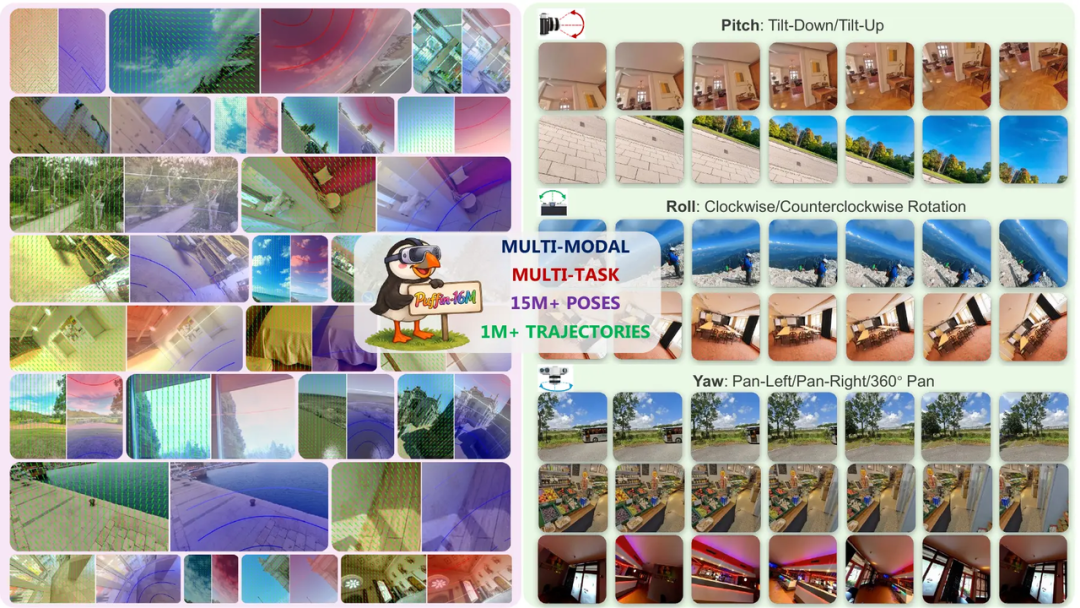
图 4|Puffin-16M 同时覆盖单视图相机条件与连续旋转轨迹。
此外,团队利用模型的物理感知能力,为 28 个公开数据集、约 4450 万张图像补充横滚角、俯仰角与垂直视场角标注。
这些标注为既有视觉数据增加了观测方向信息,可进一步用于机位分布分析、相机条件生成及空间理解研究。
论文从相机参数估计、相机可控生成和三维世界建模等方面评估了这一框架。
在 Stanford2D3D、MegaDepth、TartanAir 和 LaMAR 四个公开基准上,Puffin-World 在多数相机参数估计指标上取得领先表现。生成实验则同时考察图像质量、目标相机一致性与多视角一致性,检验模型能否让视觉内容服从指定空间条件。
这些评估对应着世界模型的一项实际要求:生成结果既要具备视觉质量,也要能够支撑后续的观察与重建。
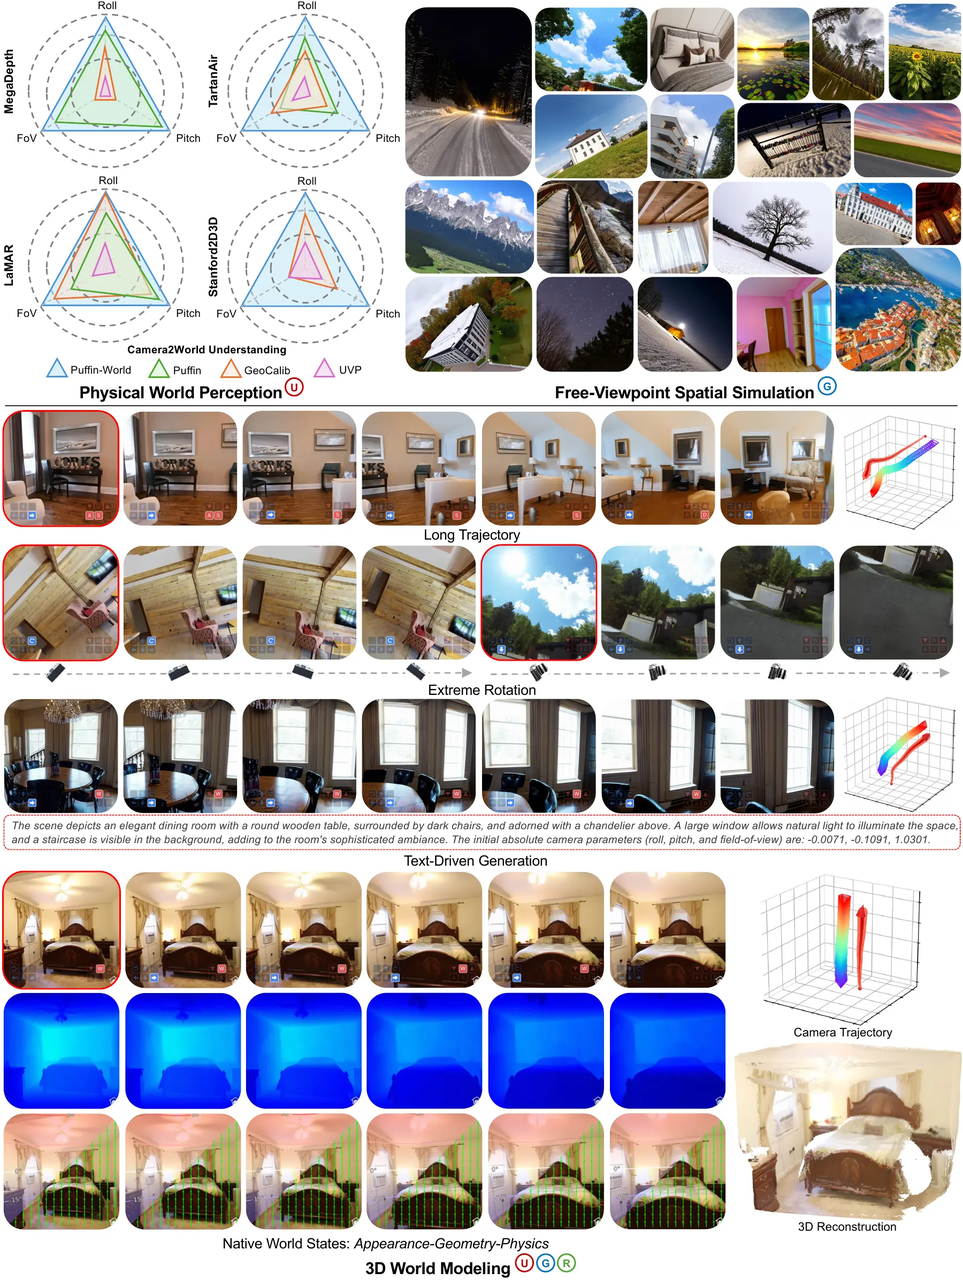
图 5|相机参数估计与生成实验,从方向理解、视角控制和视觉一致性等维度评估模型
目前,Puffin-World 主要面向静态场景,物理状态集中于重力与纬度。单图朝向估计仍有别于完整定位,未观测区域的生成也包含模型补全;闭环示例主要围绕相机动作展开,对真实机器人导航、抓取和复杂接触交互的帮助,还需要进一步验证。
它已经展示的进展,是让外观、深度与物理方向共同参与世界建模,并将感知、生成和重建连接起来。
对于具身智能,这提供了一个值得继续推进的起点:让模型在预测下一眼所见时,同时考虑这一眼背后的空间结构与物理参照。随着模型、数据和标注资源开放,研究者可以进一步检验,这种统一表示能在多大程度上帮助智能体理解和探索环境。
项目资源
论文:Puffin-World — Scaling a Unified Multimodal Model with Native 3D World States(https://arxiv.org/abs/2609.04196)
Puffin-World 项目主页(https://kangliao929.github.io/projects/puffin-world/):https://kangliao929.github.io/projects/puffin-world/
代码(https://github.com/KangLiao929/Puffin):https://github.com/KangLiao929/Puffin
模型(https://huggingface.co/ACERobotics/Puffin-World):https://huggingface.co/ACERobotics/Puffin-World
Puffin-16M 数据集主页(https://kangliao929.github.io/projects/puffin-16m/):https://kangliao929.github.io/projects/puffin-16m/
 会议推荐
QCon 全球软件开发大会·2026(上海站)将于 10 月 22 日—24 日举办。本届大会聚焦 Harness AI 时代的工程实践,从「构建 AI」到「驾驭 AI」,围绕 AI Native 架构、Agent Runtime、AI Infra、Agent 安全与可观测、Loop Engineering、具身智能与世界模型等热门技术方向,邀请全球技术社区与产业一线实践者,共同分享 AI Native 时代最具价值的工程经验。查看更多详情可扫码或联系票务经理 18514549229 进行咨询。
今日荐文
谷歌披露 RSI 最新进展:AI 不改模型参数,也能在“梦中”学会自我改进
神秘模型 Union Alpha 突袭!上线首日跑掉20亿Token,部分网友实测称性能直逼 Astra
刚刚!OpenAI与Anthropic CEO罕见同台,黄仁勋当场唱反调:AI到底要不要踩刹车?
129 亿美元卖身英伟达之后,是时候重新理解 Hugging Face 了
刚写完V4.1主算子就要“转业”?DeepSeek资深工程师深夜独白