五度妙笔
 企业透视镜
 API商城

 数据库
当Agent的能力不再写死在代码里:DSH插件化Harness技术解析与影响预判(上)
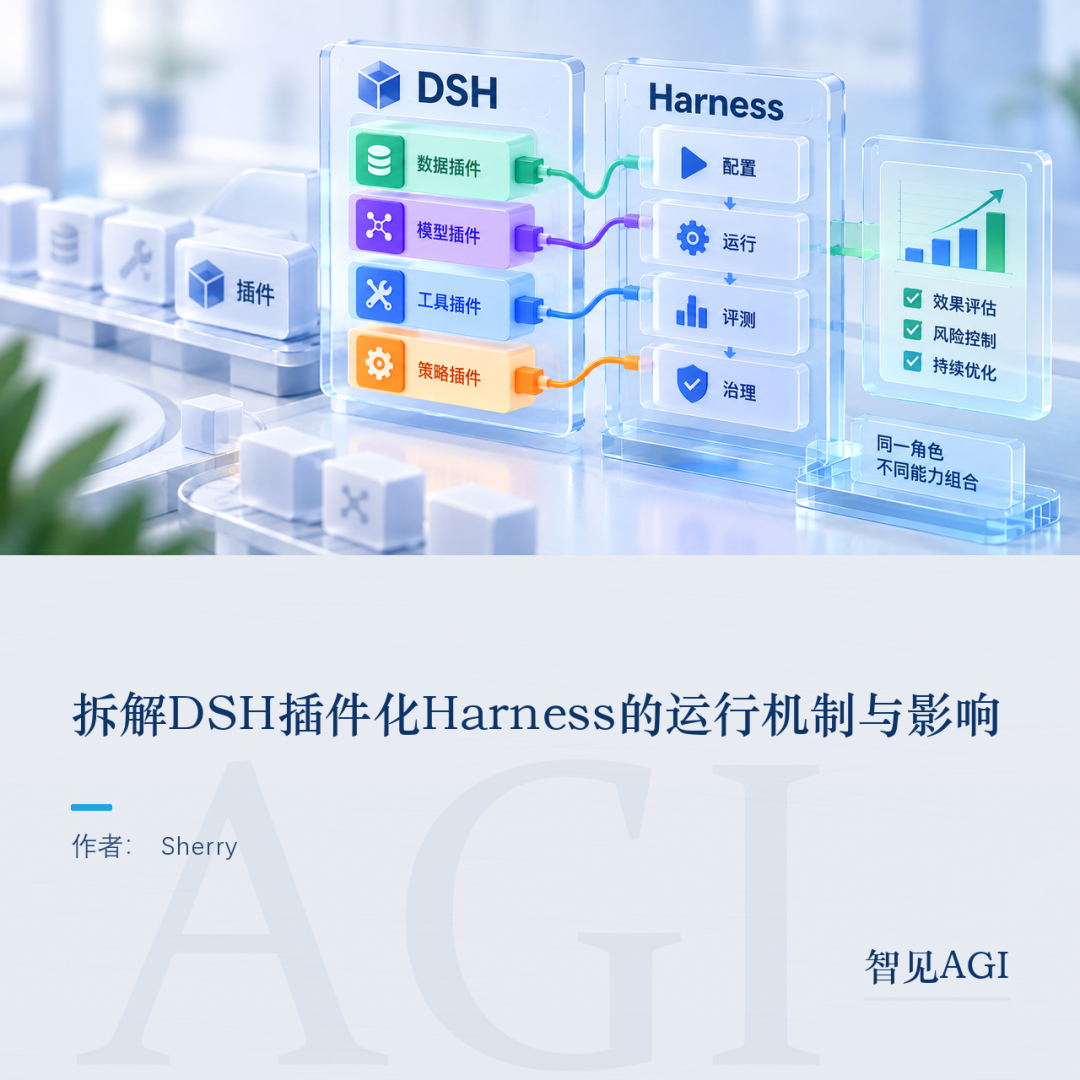
最近关注DeepSeek Harness(以下简称DSH)的人,大概都看到了它的插件化架构。模型适配器、工具注册表、会话记录、Agent Loop本身,在DSH里都被设计成插件,由Profile、Bundle和Patch组合成实际运行的插件树。
这套设计回答的核心问题是:Agent运行时的能力边界,应该在什么时候、由谁来改变。这篇先聊插件化Harness本身的技术逻辑,以及它可能带来的几个变化;下一篇再展开插件市场的现状,以及Workspace层和路由相关插件的具体讨论。
过去描述一个Agent,习惯把模型、角色设定、Prompt指令、工具、执行循环打包在一起,看成一个整体。DSH的插件化设计,把这个整体拆成了两层。
第一层是业务角色,回答"这个Agent在业务里负责什么"——研究Agent收集和分析证据,审核Agent检查事实和完成标准,投标Agent根据客户需求形成方案材料。
第二层是运行机制,回答"这个角色具体怎么完成任务"——用什么模型、走什么Loop、要不要拆解任务、调不调用子Agent、上下文怎么装配、能访问哪些工具、在哪里运行、什么操作需要审批、输出怎么验证、轨迹怎么记录。
两层拆开之后,同一个业务角色可以配不同的运行机制。研究Agent可以配快速检索策略,也可以配深度研究策略,还可以配多源交叉验证策略——业务定义保持稳定,运行方式则可以按任务调整。这个拆分本身,已经埋下了一个路由问题:给定一个任务,用哪套运行机制去跑同一个业务角色,这件事需要被决定,而不能写死在代码里。(第四节会展开这一点。)
DSH底层用的是Cordis框架,围绕"组件怎样在运行期安全地加入、退出、替换"这个问题,给出了五个技术机制。
配置驱动的插件树
系统启动时不会直接创建Agent,而是先读配置,算出需要哪些插件,组成一棵插件树。这里用"插件树"来形容,是因为插件之间存在父子关系:同一套基础设施下,不同Agent可以挂载不同的子插件集合,不需要各自起一个完整进程。
配置本身是分层叠加的:官方默认配置、启动模式配置、用户配置、本次启动的临时配置依次覆盖,后面的配置可以替换插件、改参数、加新插件、删掉某个默认插件。系统当前具备什么能力,取决于这份最终算出来的配置。
共享能力容器
插件之间需要互相发现。文件读取工具需要文件系统、权限策略、日志系统,理想情况下它不用自己创建这些对象,也不用直接绑死某个具体实现。DSH维护一个共享的能力容器,插件加载时可以声明"我提供文件系统能力",也可以声明"我需要文件系统能力"——这是一种依赖倒置,工具依赖的是抽象接口,接口背后可以是本地磁盘、Docker容器、远程服务器、云端沙箱中的任意一种实现。这也是插件化架构能做到"整体替换"的基础:把本地文件系统换成远程沙箱文件系统,工具这一端的代码完全不用动。
显式依赖关系
依赖是响应式的。文件读取工具依赖文件系统能力,文件系统插件被卸载,文件读取工具的依赖不再满足,它会自动从当前可用工具列表里消失;后面装回一个新的文件系统实现,依赖重新满足,工具重新对模型可见。这个行为很像显卡驱动和显示器的关系:驱动消失,显示功能暂时不可用;驱动装回来,显示恢复,中间这层联动是系统自动维护的。
可追踪、可撤销的副作用
一个插件加载时可能做好几件事:注册一个工具、加一个权限监听器、加一个UI展示组件。Cordis会把插件在加载期间产生的每一项注册都记下来,并且为每一项配一个对应的撤销操作——注册工具对应注销工具,加监听器对应移除监听器,开连接对应关连接。插件卸载时,运行时能找到它留下的全部注册,按照和创建相反的顺序统一撤销。这解决的是一个很实际的问题:插件对象被删掉了,它注册的定时器、监听器、后台任务如果没人管,插件其实还"活着",只是没人看得见它了。
运行时重新协调
前面四点合起来,才能支撑真正的热替换。把本地文件系统换成远程沙箱文件系统,正确的顺序是:找到依赖旧文件系统的插件,暂停或隔离这些插件,停掉正在进行的相关工作,撤销旧文件系统的注册并关闭旧资源,加载新文件系统,检查接口是否满足,最后重新激活依赖插件。外部看到的工具名字始终叫read_file,底层调用对象从本地磁盘换成了远程沙箱,业务侧完全无感。
这五个机制落到一次真实请求里,最直观的体现是:Agent每次调用模型之前,都会重新计算一遍"模型现在应该看到什么",包括应该看到的历史、应该遵守的规则、现在可以用的工具。工具列表根据当前活动的插件在每次模型调用前重新算一次,这样才能保证插件卸载之后,模型立刻看不到已经不存在的工具。
这个设计对动态卸载很关键,也带来一个容易被忽略的边界情况:如果模型请求已经发出,工具列表里当时还有read_file,随后这个插件被卸载,模型稍后返回"调用read_file",这时候模型手里拿的是一份旧快照,系统里已经是新状态。所以工具执行之前,框架必须再检查一遍工具是否还存在,组装请求时校验一次还不够,真正执行前还要再校验一次。类似的边界情况还包括:工具正在执行时插件被卸载,系统能做到的是不再接受新调用、撤销注册的能力、发出取消信号,但已经在跑的异步操作能不能立刻停下来,取决于这个工具本身有没有做协作式取消,这是JavaScript、Python这类异步系统的通用规律,外部通常没法把一个正在运行的异步任务瞬间抹掉,只能要求它自己检查取消信号并退出。
有一点值得单独说一下:插件卸载只影响未来的能力,不会影响已经发生的历史。read_file插件卸载之前如果已经读过一次文件,这次调用和它的结果会保留在对话记录里,Agent之后还能引用这段历史,UI也还能正常回放,就像医院淘汰了一台CT设备,之前做过的CT报告仍然留在病历里。
优化对象从Prompt扩展到整个运行系统。 过去优化一个Agent,常见动作是改Prompt、换模型、补知识库、换工具。插件化把运行时拆成了可替换组件之后,能调的变量变多了:模型路由策略、Agent Loop本身、上下文装配方式、工具集合、工具描述、任务并行方式、Reviewer机制、停止条件、Sandbox策略、审批规则、异常恢复方式,都成了可以单独拿出来试验和替换的对象。这已经比较接近软件系统工程的调优思路,调试的粒度比一条Prompt要细得多。
路由要解决的问题,可能会往运行时内部下沉一层。 之前讨论Agent路由,讨论的大多是任务级和工具级的选择,用哪个Agent接这个任务,调用哪个工具,走哪条通信拓扑。插件化Harness把模型、Loop、上下文策略这些原本焊死在Agent内部的东西也变成了可替换组件之后,同一个业务角色配哪套运行机制,本质上也是一次路由决策,只是决策对象从"选Agent""选工具",往下挪到了"选运行时配置"这一层,同一个研究Agent,这次任务该配快速检索策略还是深度研究策略,这个选择本身需要被路由。工具列表在每次模型调用前重新生成,也可以看成一种粒度更细的运行时路由:模型这一轮能看到哪些工具,实际上是当前插件状态实时算出来的结果。这条线往后延伸,会牵出执行策略、Runtime Profile这些概念,也是下一篇要展开的部分。
真正的瓶颈可能会落在"怎么判断变好"上。 插件化解决的是组件怎么组合、怎么运行、怎么隔离、怎么撤销这一层的问题,可以局部替换某个组件,可以把Profile和插件组合版本化,可以在卸载时撤销副作用回到原状,可以用同一份任务输入,跑不同的Profile组合做对照评测。这些能力让"试验一个新的运行时配置"这件事的工程成本明显降低了。但"新配置是不是真的比旧配置好",衡量标准是成功率、成本、周期还是事实准确率,这几个指标经常互相冲突;有没有可能优化上去了评测指标,反而伤了真实业务效果;涉及工具写操作、权限、客户数据的时候,谁有资格把候选版本推上生产。这些问题插件化架构本身给不出答案,需要在它之上再搭一层评价和治理机制来回答。
这篇主要梳理了DSH插件化Harness的技术逻辑:把Agent拆成业务角色和运行机制两层,靠五个机制支撑运行时的动态组合,工具列表现算而不是定死,再往外延伸出优化对象扩大、路由粒度下沉、评价瓶颈前移这几个可能的影响。
下一篇打算聊聊插件市场目前的现状,以及Workspace这一层具体怎么和运行时配置对接,包括几个和路由相关的插件放在这套架构里大概会长什么样子。
参考文献
《A Programming Paradigm for Spatiotemporal Composability》(Cordis 底层设计论文) DeepSeek Harness 官方仓库(DSH 插件化架构、README 说明)