五度妙笔
 企业透视镜
 API商城

 数据库
不踩点不微调!Figure最新模型盲测30个家庭:首次实现零样本全身泛化
从人类身上学到的动作经验,真的能让机器人迁移到陌生环境吗?
近日消息,人形机器人公司 Figure 发布最新端到端具身模型 Helix 2.5,并让搭载该模型的人形机器人(Figure 03)在旧金山湾区的 30 套陌生住宅里接受了一场真实的“上岗盲测”。
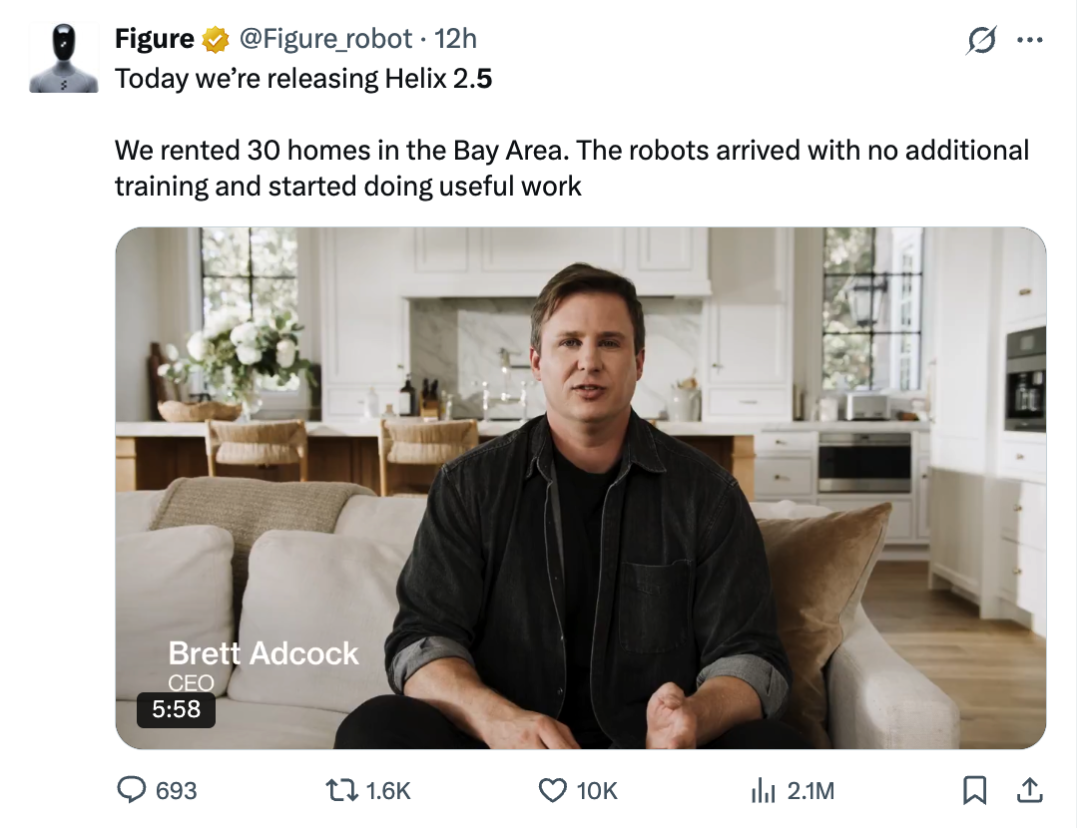
在 420 次全盲测试中,机器人面临整理客厅、折叠毛巾和铺床三项长程家务挑战,最终交出一份56%的端到端成功率。而在完全相同的测试条件下,对照组从随机权重开始训练,成功率只有 9%。
47 个百分点的差距,测出了Index 预训练的真正价值:Helix 2.5 能够将在离线数据中学到的全身行为,直接迁移到全新的空间布局、未知物品和身体站位中,极大降低了为每个新场景重新采数和训练策略的工程成本。
在真实的家庭场景中,人形机器人必须不断调整全身姿态,才能在狭窄、杂乱的动态空间中探查、触及并操作物体。由于涉及全身高维度的协同控制,这对模型的零样本泛化能力提出了苛刻的要求。
对此,Figure 选择了整理客厅、折叠毛巾、铺床三项需要全身参与的家务进行测试,覆盖感知、移动、操作能力、双手协调以及全身控制等不同难点。
为保证评估标准一致,Figure 为三项任务分别设置了明确的时间限制和失败条件,其中若因安全原因发生人工介入,同样按失败处理。
整理客厅:散落在地面的 13 至 15 个玩具必须全部识别捡起并放入收纳筐,漏掉一个即判失败;
叠毛巾:所有毛巾均需在规定时间内完成折叠并整齐收纳进篮;
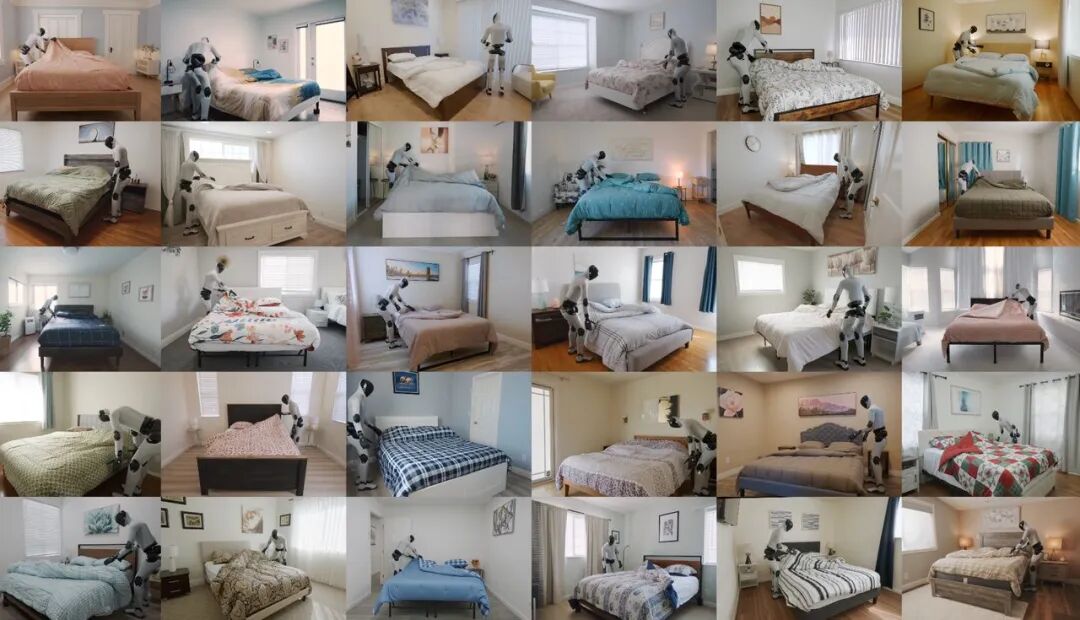
铺床:两个枕头和被套两侧均需被拉至床头区域,并将褶皱被面整体拉平顺。
视频|一些场景被重置为不受控制的初始状态的例子,用于零样本评估。
这里值得我们细究的是“零样本”的边界和定义,它主要用于评估环境和操作对象:
Figure 强调团队从未在 30 套被测住宅采集过训练数据;
测试使用的玩具、毛巾和床品在实验前被单独隔离,在实验开始前,经过模型筛查与人工复核,确保未出现在任务适配数据中;
机器人抵达现场后,不进行任何现场环境建模或权重微调,全凭离线习得的经验进行实时感知与控制。
为了避免“边测边挑、定向挑选最优模型”,每项家务均采用同一个固定模型版本跑满 30 套住宅,现场评测结果不作为后续模型筛选的依据。
视频|在 Index 数据集上预训练的 Helix 2.5 模型能够应对三种全身位置操控任务。
在这一严苛标准下,搭载 Helix 2.5 的机器人 Figure 03 在 420 次尝试中成功 237 次,整体成功率为 56%。三项子任务的成绩呈现出明显的分布差异:
• 铺床:完成 94/140 次、达到 67%;
• 折叠毛巾:完成 87/140 次、为 62%;
• 整理玩具:只完成 56/140 次、降至 40%。
铺床与折叠毛巾的成功率均突破了 60%,原因在于这两项任务的操作目标相对单一,机器人在较为局限的工作空间内进行连续动作,误差扩散相对可控。
而整理客厅的成功率暴跌了 20 多个百分点,根源在于任务结构的根本差异:整理客厅包含大范围的自主移动、反复下蹲起立,以及长达 15 轮的重复抓取操作。
在极其漫长的时序链条中,任何一次识别漂移、走位偏离或滑脱,都会引发连锁反应导致任务崩溃。不过,由于 Figure 尚未公布分步骤的数据统计,目前尚无法量化主要失误集中在感知、导航还是末端抓取环节。
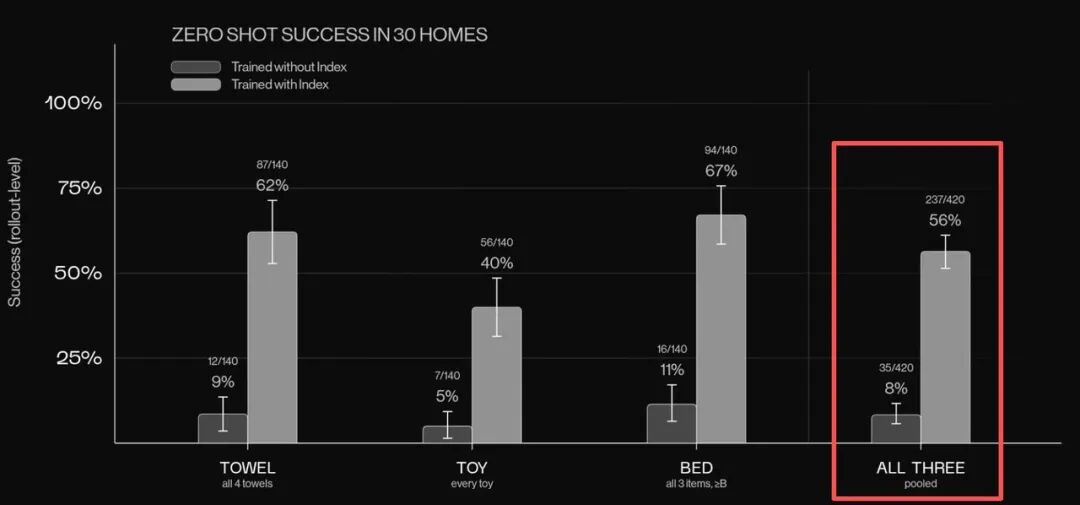
图|Index 预训练与随机初始化策略在 30 套住宅中的零样本成功率。
实验表明,Helix 2.5 能够在 30 套未见住宅中执行三项长时序任务,无需针对评估环境或被操作物体额外采集数据、微调或适配。Figure 称,这是首次在如此规模上实现人形机器人零样本全身行为泛化能力的演示。
Helix 2.5 的泛化能力究竟来自具体家务的专项适配数据,还是源于 Index 预训练?Figure 通过一组严格的控制变量实验给出了定论。
两组实验采用了完全一致的任务适配数据、网络架构、优化器、超参数与评估流程。唯一的区别在于:一组模型直接从随机权重开始训练,另一组则基于 Index 预训练后的 Helix 2.5 权重进行初始化。
结果展现了悬殊的落差:随机初始化组的完整任务成功率仅为 9%,而 Index 预训练组达到了 56%,性能提升超过 6 倍。
视频|Helix 2.5 在执行定位操作以及主动感知任务时的定性行为表现。
面对这一结果,行业普遍关心的核心疑问是:Index 数据集里是不是悄悄塞进了大量“测试原题”?
为了验证模型是否在“背答案”,Figure 从视觉特征与文本语义两个维度对 Index 进行了聚类分析:
• 一方面直接提取每段视频的视觉表征;
• 另一方面让视觉语言模型为每个片段生成活动和物体描述,再将这些文字转成语义表征。
结果显示,铺床、折叠毛巾和整理客厅中的任何一项任务,在预训练数据中的占比都没有超过 1.90%。
这一数据有力地证明,评估任务并未主导预训练集。模型获得的并不是针对特定家务的流程记忆,而是人类在物理世界中沉淀的通用交互机理——例如如何接近障碍物、双臂协同发力、控制柔性形变以及根据重心调整下肢站位。
这些底层的物理经验,构成了跨场景泛化的坚实地基。
此外,与上一代 Helix 02 直接借用开源视觉语言模型(VLM)权重不同,Helix 2.5 彻底摆脱了外部 VLM 底座,完全从零在 Index 数据集上学习视觉、语言与物理动作的跨模态对齐。
除了 30 套住宅的盲测数据,Figure 此次还同步披露了关于数据效率、行为涌现与 Scaling Law 的三组扩展结论。
第一组是数据利用效率的大幅提升。
对比上一代依赖现场部署采集的 Helix 02,Helix 2.5 在下游任务适配中仅使用了一半的机器人专属数据,不仅在整体成功率上打平,更展现出了此前不具备的跨场景泛化能力。
第二组是定性行为层面的涌现:也就是自我纠错。
当抓取动作不理想或受阻时,机器人会自主后退、重新寻找站姿,甚至绕行到床的另一侧变换角度继续操作。对于长时序任务而言,这类错误恢复尤其重要。人类在训练时并没有教过机器人“犯错后如何补救”,但机器人却能根据物理反馈调整后续规划。
Figure 认为,这种从错误中恢复并继续推进任务的能力,是 Index 预训练带来的重要效果之一。
视频|全身错误恢复机制——机器人会后退一步,重新定位自己,然后围绕环境移动,以纠正错误并完成那些需要长期规划的任务。
第三组是首次在具身领域验证了人类经验的“迁移 Scaling Law”。
在固定模型参数规模与下游微调流程的前提下,Figure 将预训练数基于1-8个倍增档位,阶梯训练了四个不同数据档位的模型,观察模型在留出评估集上的动作预测损失。
实验呈现出严格符合幂律分布的下行曲线。更具工程价值的是其前向外推精度:研发团队仅依据小规模训练拟合出的趋势线,便能提前推演出最大规模下的模型损失收敛值,且实际观测值与预测值的偏差,仅相当于整个 8 倍区间损失变动幅度的 0.54%。
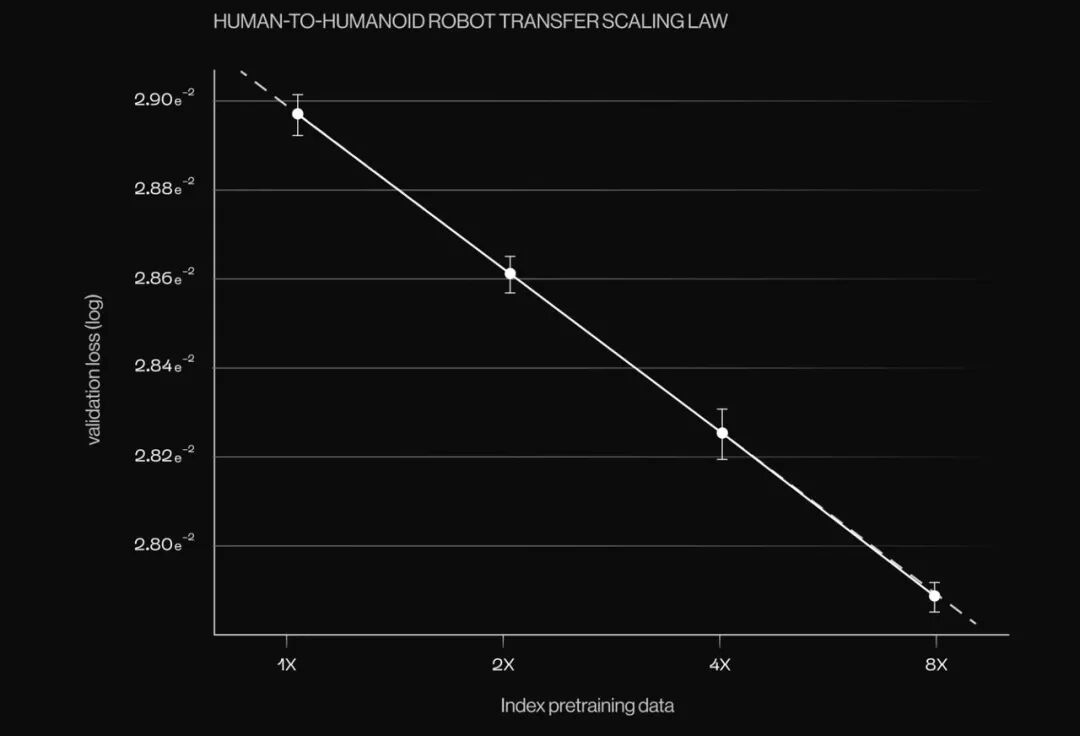
图|仅利用小规模实验趋势线,即可提前预测 8× 训练损失,外推误差仅 0.54%
这证明在大语言模型上已被验证的 Scaling Law 同样适用于物理世界:将人类日常行为经验压缩进神经网络的过程,存在高度可量化、可预测的规模效应。 团队无需盲目试错,在投入下一阶段数采与算力前,即可精确折算其对预训练表征的边际收益。
Figure 此次发布的亮点,并非又一场吸引眼球的机器人家务 Demo,而在于用严格的控制变量证明:人形机器人具备脱离现场微调、依靠人类物理常识实现跨场景迁移的工程可行性。
但 56% 同样冷峻地指出了当前的物理边界。它意味着在近一半的尝试中,任务依然以卡死、超时或安全中断收场;尤其整理客厅 40% 的表现,印证了多节点误差在长时序链条中存在累积效应。
资料参考:
Figure|Helix 2.5: Zero-Shot 30-Home Generalization(https://www.figure.ai/news/helix-2-5-zero-shot-30-home-generalization)
Brett Adcock|原始评估素材(https://x.com/adcock_brett/status/2100657393923445017)
声明:本文为 AI 前线原创,不代表平台观点,也不构成投资建议,未经许可禁止转载。
 会议推荐
QCon 全球软件开发大会·2026(上海站)将于 10 月 22 日—24 日举办。本届大会聚焦 Harness AI 时代的工程实践,从「构建 AI」到「驾驭 AI」,围绕 AI Native 架构、Agent Runtime、AI Infra、Agent 安全与可观测、Loop Engineering、具身智能与世界模型等热门技术方向,邀请全球技术社区与产业一线实践者,共同分享 AI Native 时代最具价值的工程经验。查看更多详情可扫码或联系票务经理 18514549229 进行咨询。
今日荐文
“只剩一群用 LLM 的菜鸟”:顶级黑客怒退 PS5 Linux 项目,几个月心血全打水漂
谷歌终于支棱起来了?Gemini 4 Pro疑空降Arena榜单,13项跑分碾压GPT-6和Fable
谷歌披露 RSI 最新进展:AI 不改模型参数,也能在“梦中”学会自我改进
神秘模型 Union Alpha 突袭!上线首日跑掉20亿Token,部分网友实测称性能直逼 Astra
刚刚!OpenAI与Anthropic CEO罕见同台,黄仁勋当场唱反调:AI到底要不要踩刹车?