五度妙笔
 企业透视镜
 API商城

 数据库
Figure AI 宣称找到了机器人版 scaling law,同行却说它其实根本不会泛化
具身智能现在太吵了。
行业里的人各自笃定,声音大的先被听见。最响的那些声音,往往离真实的进展最远。
真正在往前推的人,看的是谁在践行非共识,什么在真的往前走,以及谁心里有一张完整的图,而不是走一步看一步。
这些东西不会上热搜,但它们决定这个行业的下一步。
我们一直探寻这些。如果你也是——
欢迎来到极客公园 In The Loop。👇
「这是 Figure AI 成立以来最重要的项目。」
在 Helix 2.5 的发布视频里,Figure AI 创始人 Brett Adcock 把话说得很满。
Figure AI 目前估值达到 390 亿美元,是全球最贵的未上市人形机器人公司,致力于以人形完成人类的日常任务。
过去几代 Helix 的发布都留下了颇有记忆点的画面:两台机器人合作拉平被子,或者在腾不出手时用屁股顶上洗碗机。不过,此前的 Helix 虽然已经能够自主工作,收获的最大诟病之一就是,每次的 demo,总在一个光线良好的样板间工作。
Helix 2.5 此次想跨过这一步。Figure AI 在旧金山湾区租下 30 套住宅,将机器人直接运到现场,让它整理客厅、铺床和折叠毛巾。
不得不说,看完视频,笔者感觉这仍然很像 30 个光线良好的样板间。
但仍然是一个很厉害的进步,Figure AI 称,没有针对这些住宅和物品进行任何训练或适配,30 套住宅里都出现了成功案例。
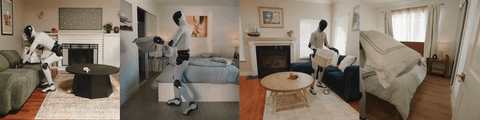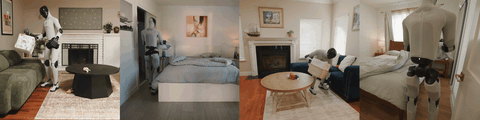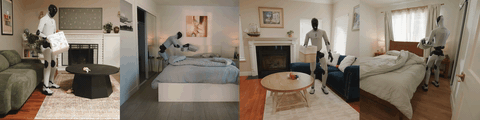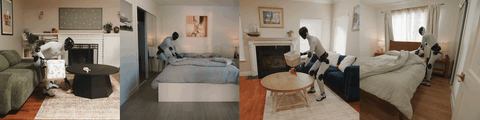
「Helix 2.5 要在一套从未进入过的房子里,折叠它从未见过的毛巾。」Brett 表示。
在 Figure AI 的讲述里,机器人领域长期追逐的泛化能力终于开始出现了:机器人不再只会重复某个实验室里学过的动作,而是能把此前积累的经验带到一个陌生地方。
随后,Figure AI 在 Helix 2.5 的技术博客里公布了完整测试数据。420 次测试,成功 237 次。完整任务成功率为 56%。
不过,有趣的是,一种过往在机器人行业相当少见的情况出现了:同行没有像往常一样留下一句「了不起的工作」,再回自己的实验室暗暗较劲。
Sunday Robotics 联合创始人 Tony Zhao 直接指出,237 次成功也意味着机器人接近一半时间会失败。Stealth CEO Nikolai Ensslen 的说法更加尖锐:这组数据恰恰证明,Figure AI 使用的模仿学习系统不能泛化。
Figure AI 觉得自己摸到了机器人版 scaling law,两位同行看到的却是一条可能根本走不通的路线。
向 zero-shot 的圣杯迈了一步
Figure AI 新发布的 Helix 2.5,首先改变了 Helix 学习任务的方式。
此前的 Helix 02 从一个已经完成预训练的视觉语言模型出发,再使用机器人数据学习动作。它虽然可以连续完成洗碗、物流分拣等长时程任务,但训练数据来自机器人最终工作的环境。机器人学会的是在这个厨房里洗碗、在这条产线上搬运;换一个地方,往往还要重新采集数据。
Helix 2.5 则从随机初始化开始,先在 Figure AI 的人类行为数据集 Index 上完成预训练,再使用任务数据分别适配整理玩具、折叠毛巾和铺床三种行为。
完成训练后,Figure AI 把机器人运进旧金山湾区 30 套住宅。团队此前没有进入这些住宅采集机器人数据,也没有针对里面的床、枕头、毛巾和玩具进行微调。每种行为都使用同一个固定版本完成测试,中途不会根据具体住宅重新训练。
这就是 Figure AI 此次所说的 zero-shot:它不是只听到一句自然语言指令,便自己想出了铺床的方法。Figure AI 仍然为三项任务提供了专门的训练数据。Helix 2.5 没见过的是测试住宅、房间布局以及其中使用的具体物品。
这个边界并不影响实验的意义。家庭很难像工厂一样被改造成完全一致的环境。床的高度、毛巾的材质、玩具散落的位置乃至机器人能够落脚的空间,到了下一套房子里都会发生变化。家用机器人如果每次上门都要先采集数据、重新训练,就很难成为一件可以直接交付的产品。
Figure AI 为三项任务各进行了 140 次测试。
整理客厅时,机器人必须把全部 13 至 15 件玩具放进篮子;折叠毛巾时,四条毛巾必须全部折好并放进篮子;铺床则需要满足枕头位置、被子方向和床面覆盖等要求。只要需要人工进行安全干预,或者超过规定时间,就会被记为失败。
铺床成功 94 次,成功率约为 67%;折叠毛巾成功 87 次,成功率约为 62%;整理玩具成功 56 次,成功率为 40%。三项任务合计完成 237 次,完整任务成功率为 56%。
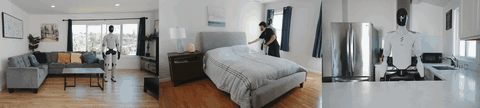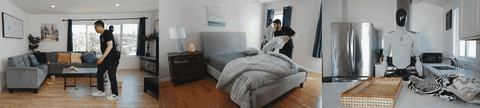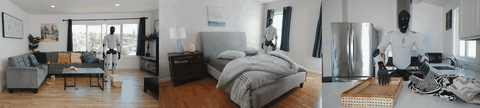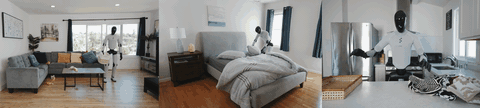
测试中,Helix 2.5 还表现出了一些全身纠错动作。机器人发现操作位置不合适时,会后退并重新调整站姿;处理床铺时,也会移动到另一侧继续完成任务。它不只是机械地播放一条预先录好的动作轨迹,而是在陌生布局里寻找继续完成任务的位置。
在相同测试中,没有经过 Index 预训练的对照模型只成功了约 9%;Helix 2.5 的成功率则达到 56%。这组对照让 Figure AI 相信,来自人类行为的预训练已经让机器人获得了跨住宅、跨物品迁移的能力。
至于这种能力能否随着 Index 数据增加而继续稳定提升,Figure AI 在技术博客里给出了另一个更大胆的答案:机器人也开始出现 scaling law 了。
Figure AI 也开始讲 scaling law 了
大语言模型让科技公司着迷的,不只是模型越来越聪明。
更诱人的地方在于,它的进步在很长一段时间里是可以预测的。增加数据、模型参数和计算量,训练损失就会沿着一条相对稳定的曲线下降。公司可以在完成最大规模训练之前,估算下一轮投入大概能够换来多少能力。
这让人工智能研发从一次次不确定的实验,变成了一项可以持续追加资本的工程。
机器人一直没有这么幸运。
机器人数据昂贵、规模小,而且来自不同硬件、任务和环境。一家公司即使把某个任务的成功率做到很高,也很难知道再增加十倍数据后,其他任务会不会一起变好。很多机器人能力更像手工作品:完成一次演示,再换一个场景重新解决一次。
Helix 2.5 的技术博客里,Figure AI 第一次明确宣称,它也看到了类似的 scaling law。Figure AI 将其称为第一条在人形机器人上测得的「人类到机器人迁移 scaling law」。
此前,把 scaling law 当成公司核心叙事的机器人创业公司主要是 Generalist。它在 2025 年发布 GEN-0 时,展示了预训练数据、模型规模和训练计算量与下游表现之间的关系,并宣称机器人也进入了类似大语言模型的预训练时代。此后的 GEN-1 和 GEN-1.5,继续围绕扩大数据和模型规模展开。
Figure AI 现在也加入了这套叙事。
公司用四个不同规模的 Index 数据集训练模型,数据量依次为 1 倍、2 倍、4 倍 和 8 倍。实验固定了模型大小、下游任务数据和评估方法,只增加人类行为预训练数据。
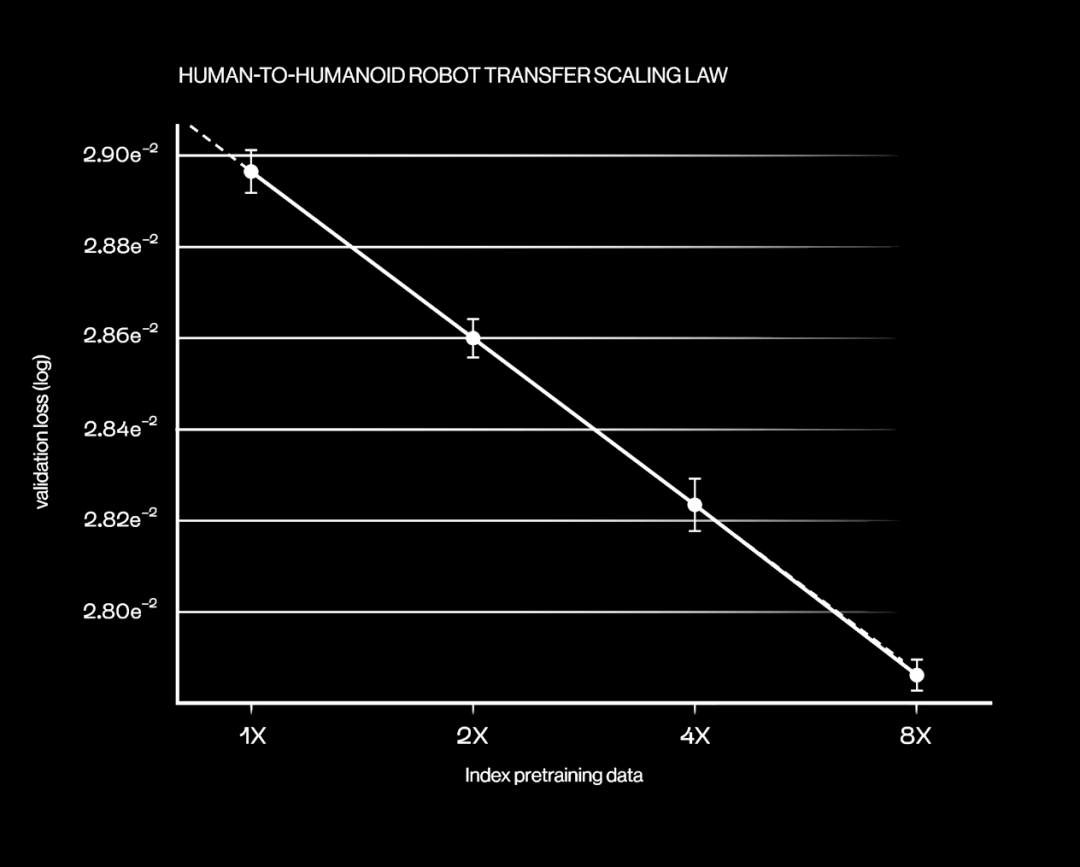
数据量每翻一倍,模型预测机器人下一步动作的误差都会继续下降。Figure AI 使用前三组实验预测最大规模训练的结果,最终误差只有整个变化区间的 0.54%。
Helix 2.5 同时提供了一个现实世界里的对照:其他条件保持不变,Index 预训练将完整任务成功率从约 9% 提高到了 56%。
Figure AI 已经准备为这个故事支付很高的成本。
公司与 Nscale 签署的合作协议包含 35 亿美元初始算力承诺,计划从 2027 年下半年开始部署,长期目标最高达到 10 万块英伟达 Vera Rubin GPU。Index 则继续以每秒约 35 分钟的速度收集人类经验。
如果 Figure AI 的判断成立,Helix 2.5 当前的失败更像一个规模问题:数据还不够多、模型还不够大、计算量还不够高。继续扩大三者,56% 就会像早期大语言模型的能力一样不断向上增长。
同行没有鼓掌
最近的具身智能领域,似乎不再像早年的一团和气。在 Helix2.5 发布之后,有两条批评马上进入了笔者的 X 主页。
Tony Zhao 的批评主要针对 56% 的可靠性。
Tony 是 ACT 和 ALOHA 系统的核心作者之一,目前担任 Sunday Robotics 联合创始人兼 CEO。他在 Figure AI 发布数据后写道:「有用的工作=泛化+可靠性。」
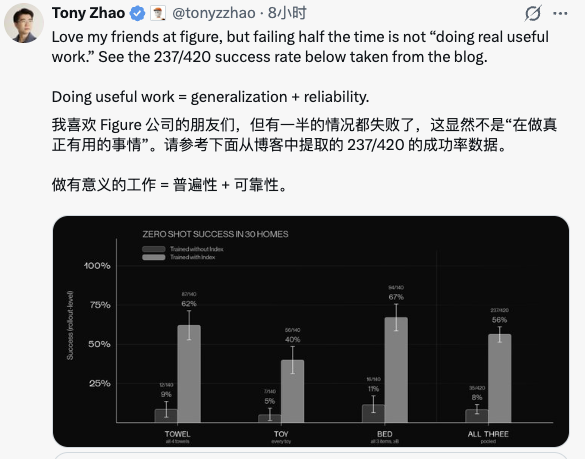
Figure AI 把 237 次成功理解为机器人可以在陌生环境中工作;Tony 将注意力放在另外 183 次失败上。在家庭环境里,机器人可能接触易碎物品,也可能与儿童和宠物共同活动。它能不能偶尔完成任务,和用户能不能放心让它独立工作,是两回事。
Sunday Robotics 此前发布的 ACT-2,在衣物折叠测试中完成了 785 次自主尝试中的 778 次,报告成功率为 99.1%。这组数据不能与 Figure AI 直接比较:Sunday 的一次测试对应一件衣物,Figure AI 的一次毛巾测试则要求机器人连续处理四条毛巾,并全部放进篮子。
但 Tony 选择用可靠性攻击 Figure AI 并不意外。Sunday 的产品 Memo 同样瞄准家用机器人,两家公司过去已经有过公开交锋。Helix 02 发布后,Tony 曾质疑 Figure AI 为什么只展示机器人处理塑料餐具,Brett 随后发布了一段处理玻璃器皿的视频回应。
Nikolai Ensslen 的批评更接近一场技术路线之争。
Nikolai Ensslen 是机器人运动控制公司 Synapticon 的联合创始人和前 CEO,目前正在开发 Physical AI 与人形机器人系统。他先肯定 Figure AI 愿意公开成功率,随后表示,这些数字本身就是模仿学习不能泛化的证据。
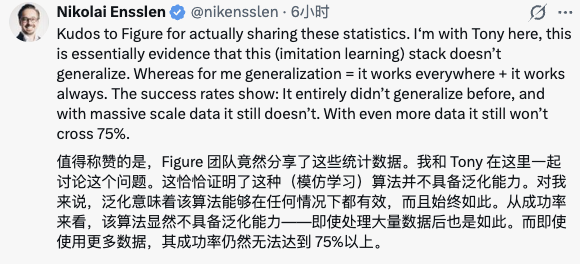
在他的定义里,泛化意味着系统换一个地方仍然能工作,而且每次都能工作。Helix 2.5 在 30 套住宅中的确出现了成功,但 44% 的任务没有完成,所以它「完全没有做到」。
这种评价放在几年前,会显得过于苛刻。对于人形机器人来说,能在 30 套陌生住宅中完成长时程全身任务,本身已经是明显进步。
但从某个角度讲, GPT-6 的出现,正在改变一部分从业者对「泛化」的预期。让行业受到冲击的不是 GPT-6 已经把机器人控制做到了多快、多稳定,而是它表现出的学习方式。
模型面对没有专门训练过的任务,会利用上下文理解目标,通过尝试获得反馈,再反思和修正动作。它对三维空间、任务语义和自身操作结果的理解,被不少从业者视为一种更接近智能涌现的能力。
传统视觉语言动作模型则更像是在学习视觉与动作轨迹之间的对应关系。训练中出现过的任务,它可以执行得很快;一旦进入没有覆盖过的情况,模型可能继续重复原有轨迹,而不是理解自己为什么失败。
在这样的背景下,Figure AI 的 56% 显得微妙。
支持者可以说,Helix 2.5 已经把大规模人类经验迁移到了全尺寸人形机器人上,而且不需要在每套住宅中重新采集数据。批评者也可以说,模型只是在更大的数据分布中学会了模仿。一旦场景偏离训练经验,它仍然缺少理解任务和摆脱失败的能力。
争议在于,这种迁移是否足以支撑 Figure AI 对未来的判断。
Figure AI 最新一轮融资超过 10 亿美元,投后估值达到 390 亿美元;公司还宣称已经生产超过 350 台 Figure 03,并把生产周期缩短到每小时一台。现在,它又把 35 亿美元初始算力承诺和不断扩大的 Index 数据押在了 Helix 上。
Helix 2.5 是 Figure AI 第一次把机器人送进 30 套陌生住宅,也是它第一次如此明确地宣称,自己找到了从人类数据通往机器人能力的 scaling law。
如果 56% 能随着 Index 扩大稳定地变成 80%、90% 甚至更高,Helix 2.5 会成为机器人预训练路线的一个起点。
如果成功率迟迟停在一半附近,那么 Tony Zhao 和 Nikolai Ensslen 的批评,就不只是一句不客气的评论,而会变成对整条与模仿学习相关的路线的质疑。
拓展阅读:
Figure AI 发布新 demo:两个机器人点头致意,我们一起把被子拉开
估值 390 亿美金,全球最贵的人形机器人公司在研究用脚关洗碗机
只用 13 天,OpenAI 做出了能听、能说、能自主决策的机器人大模型
OpenAI、英伟达重金下注,这家机器人公司凭什么估值 26 亿美元
*头图来源:Figure AI
本文为 In The Loop 原创文章,转载请联系作者