
 五度妙笔
 企业透视镜
 API商城

 数据库
OpenAI 攻克千禧年难题,数学圈却因「抄作业」撕起来了!
(来源:AI信息Gap)
什么,数学界的千禧年难题被 OpenAI 的下一代模型攻克了?!
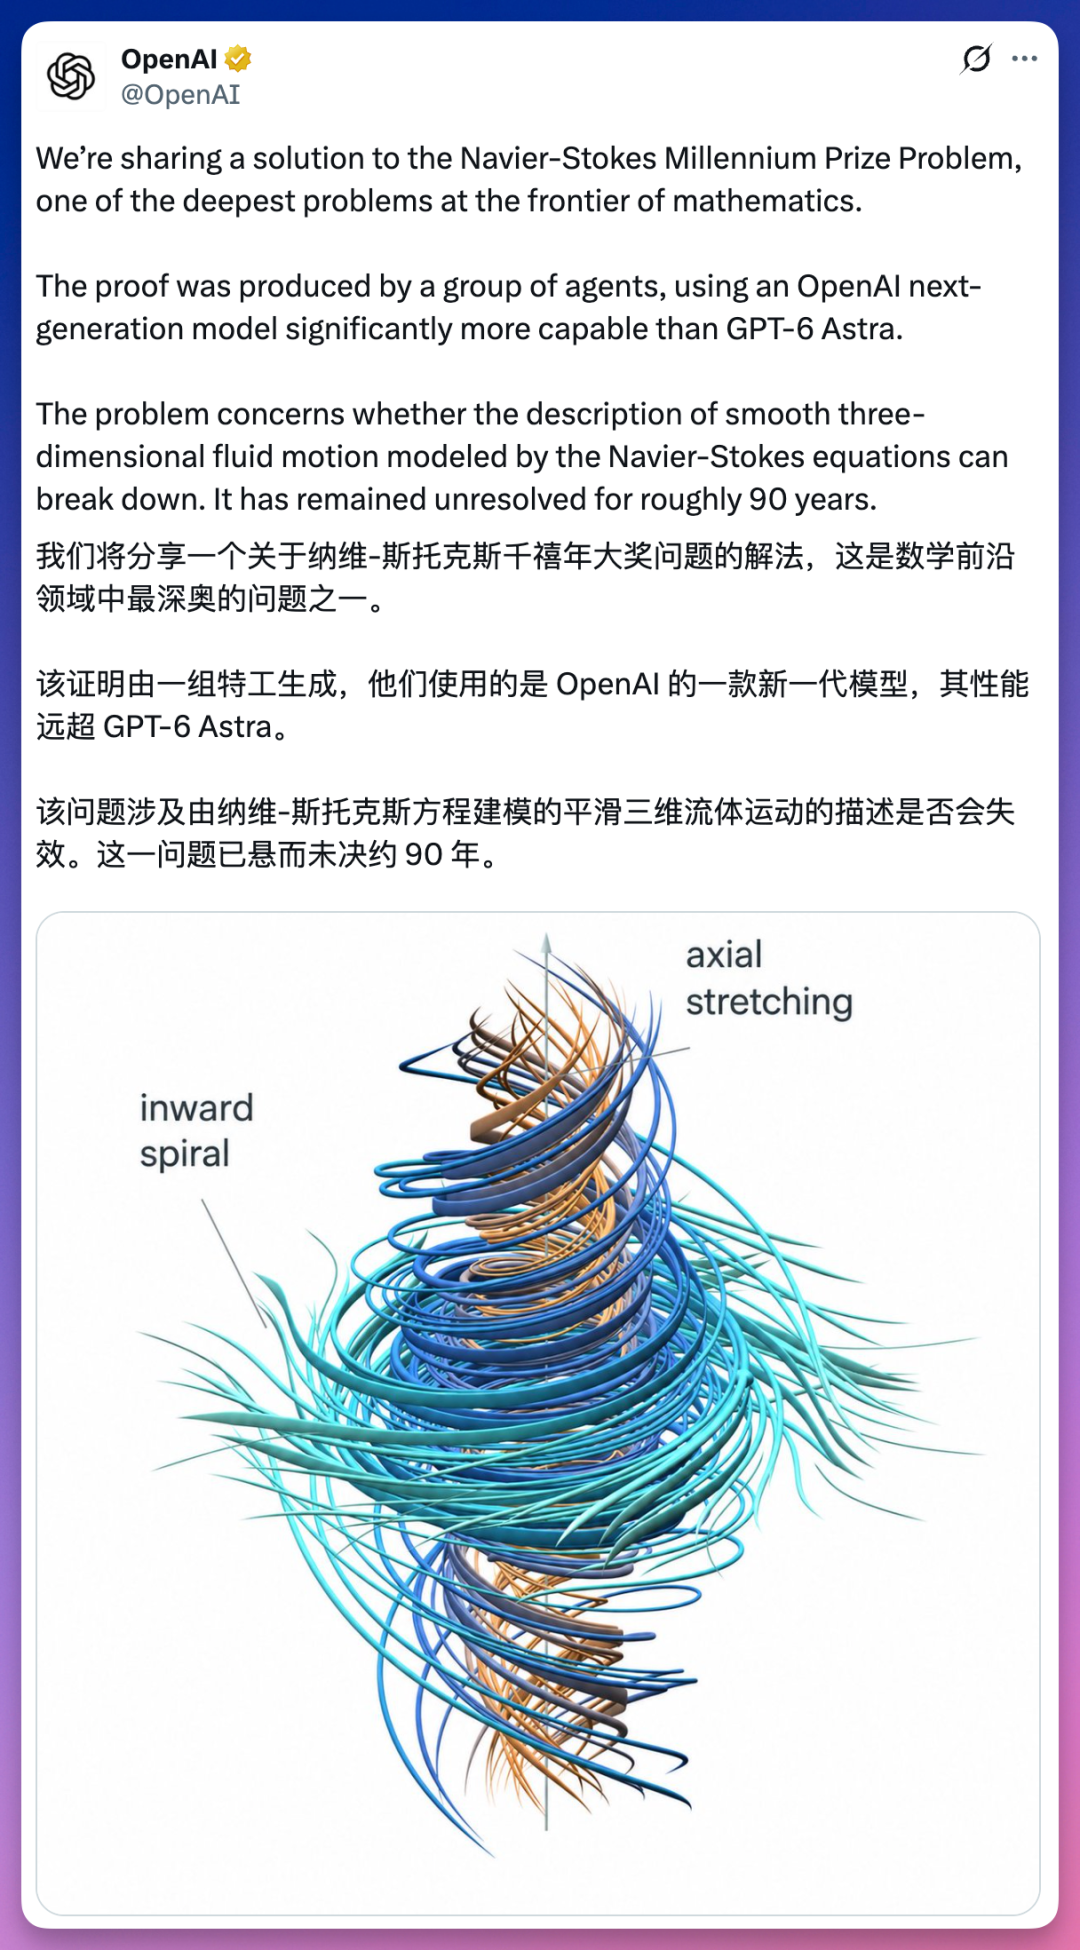
OpenAI 刚刚公开了一份「纳维-斯托克斯方程」的证明,165 页,Lean 形式化验证通过。而完成证明的是一个还没发布的新模型,OpenAI 官方称「它比 GPT-6 Astra 明显更强」。在整个证明过程中,大约 10,000 个智能体协作了 88 个小时,交流了 270 万条消息,消耗了约 1300 亿输出 token。
纳维-斯托克斯方程是克雷数学研究所悬赏 100 万美元的七大千禧年难题之一,26 年来只有庞加莱猜想被完全解决。OpenAI 明确表示「不申请克雷奖」。
Sam Altman 再次眩晕瘫坐在椅子上,盛赞「这是 OpenAI 历史上我个人最惊叹的时刻之一,没想到这种量级的研究成果会来得这么快。」
但这份证明背后的故事,远比证明本身有意思得多。来,吃瓜开始。
故事还要从一年前说起。
纽约大学数学教授 Tristan Buckmaster 和 Anthropic 的数学家 Levent Alpöge 私下合作了近一年,用 Claude 和 Codex 证明了三个流体力学方程的「光滑外力下有限时间爆破」,包括三维不可压缩欧拉方程,总共 245 页,Lean 验证全部通过。菲尔兹奖得主陶哲轩评价「了不起的成就」,他认为原则上看不出有什么能阻止这套方法一路推进到纳维-斯托克斯方程。
Buckmaster 和 Alpöge 走的是一条几乎没有其他人在走的证明路线,最早由马德里的 Córdoba 和巴塞尔的 Martínez-Zoroa 两位数学家提出。Buckmaster 后来说功劳归这两位,甚至认为 Martínez-Zoroa 应该得菲尔兹奖。
两人的合作纯属私交,Buckmaster 自掏科研经费,其中给 OpenAI 支付了一大笔。他们还说自己手里有一个更接近纳维-斯托克斯本体的证明结果,但 Lean 验证没跑完所以没发布。此时距离解决千禧年难题,仅一步之遥。
9 月 3 日,一个传闻开始在数学圈流传,Anthropic 解决了千禧年难题。同时,有知情人士告诉 Alpöge,「你们的研究进展已经被透露给了 OpenAI。」Buckmaster 主动给 OpenAI 一位数学家写信澄清。对方的回复很友好,说愿意提供算力。
三天后的周日,OpenAI 的 Sébastien Bubeck 加入讨论。Bubeck 是前微软研究院副总裁,2023 年那篇被引用近两千次的「Sparks of AGI」论文作者之一。
电话里 Buckmaster 被告知,OpenAI 内部模型已经完成了纳维-斯托克斯方程的完整证明。他一听立马感觉不对,因为对方走的恰好是他和 Alpöge 悄悄在攻克的那条冷门路线。对方开始时说「几乎没有人工参与」,但通话中透露出来的是一整个团队、多次尝试、算力用量高到离谱,而且 OpenAI 是在得知两人的进展几天后才开始研究这个问题的。
Buckmaster 追问模型有没有用他们在 Codex 里的对话记录训练过,被告知「模型不会查用户数据」。他再问训练的事,就没有然后了。
对于研究者来说,署名是个大问题。
Bubeck 给了 Buckmaster 两个方案,有一个共同条件,「把 Alpöge 从作者名单里拿掉」。Buckmaster 明确拒绝,并表示会公开这件事。
接下来就是互撕环节。
Buckmaster 的声明里写道,「Bubeck 反问我‘你为什么要毁掉自己的职业生涯?’然后说‘你要是不想好好说话,那我也没必要跟你客气。’」
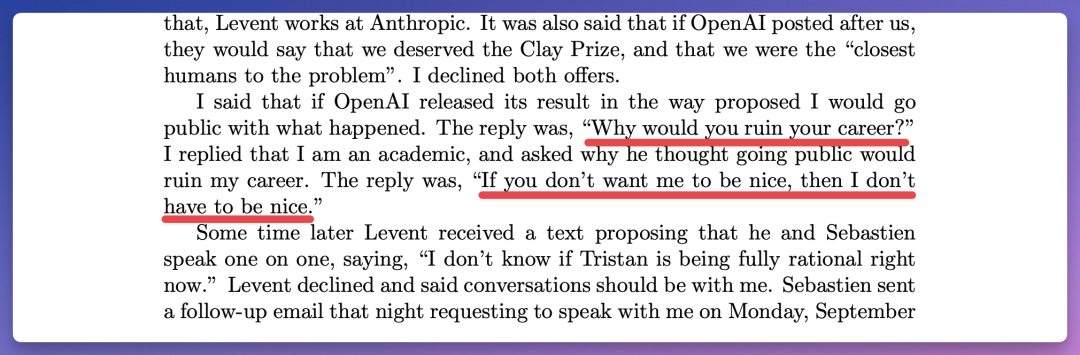
Bubeck 几小时前的回应则是另一个版本。
他说自己从没有要求把 Alpöge 从研究里除名,之所以提「要是 Levent 不在 Anthropic 就简单了」,是因为他觉得不合适让一个 Anthropic 员工来署名 OpenAI 的工作,况且 Alpöge 在证明欧拉爆破时承认用了 Anthropic 的内部模型,Bubeck 认为他不能算作独立的学术研究者。他还想提议给两人开放 OpenAI 内部模型的权限,让他们自己把欧拉和纳维-斯托克斯方程之间的差距补上,但话没说完就被打断了。至于那句「毁掉职业生涯」,他说当时是在劝 Buckmaster 不要因为毫无根据的指控毁掉自己的声誉,措辞很差劲,他深表歉意,并且说当场就收回了。
Bubeck 还公开了自己发给 Alpöge 的短信截图。短信里写道,「我想尽可能坦诚地和你讨论怎么协调我们各自研究成果的发布。我们这边一个内部模型完成了纳维-斯托克斯的证明(形式化和非形式化的都有),人工参与很少,但对我们来说最重要的是承认你的优先权,所有的学术荣誉都应该归你和 Tristan(Buckmaster)。」
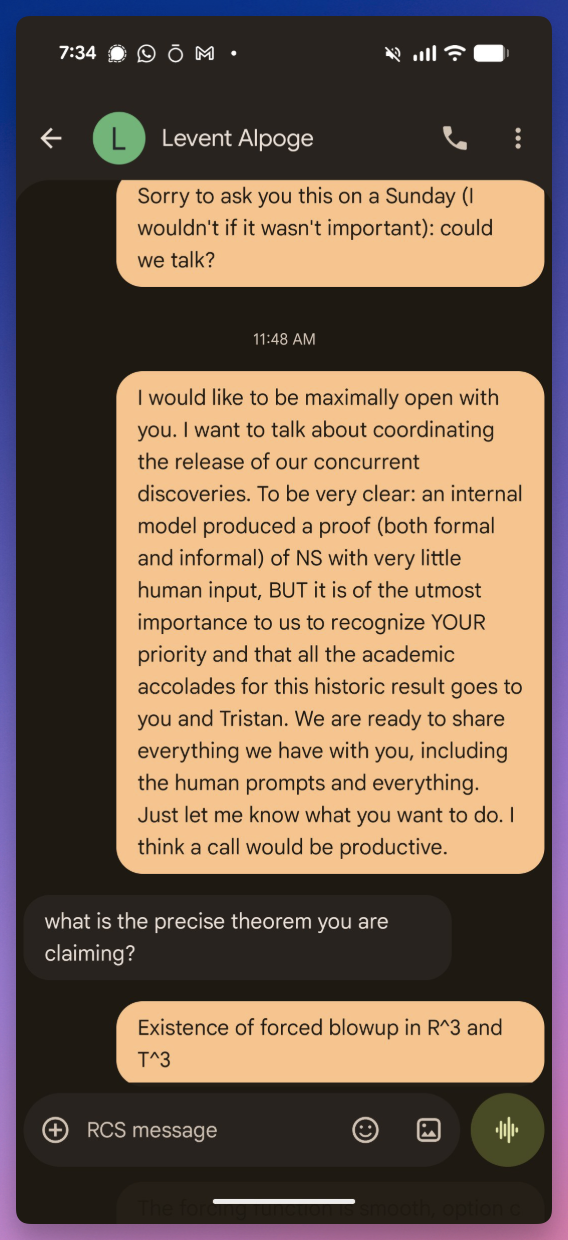 Bubeck 发给 Alpöge 的短信截图(Bubeck 本人公开)
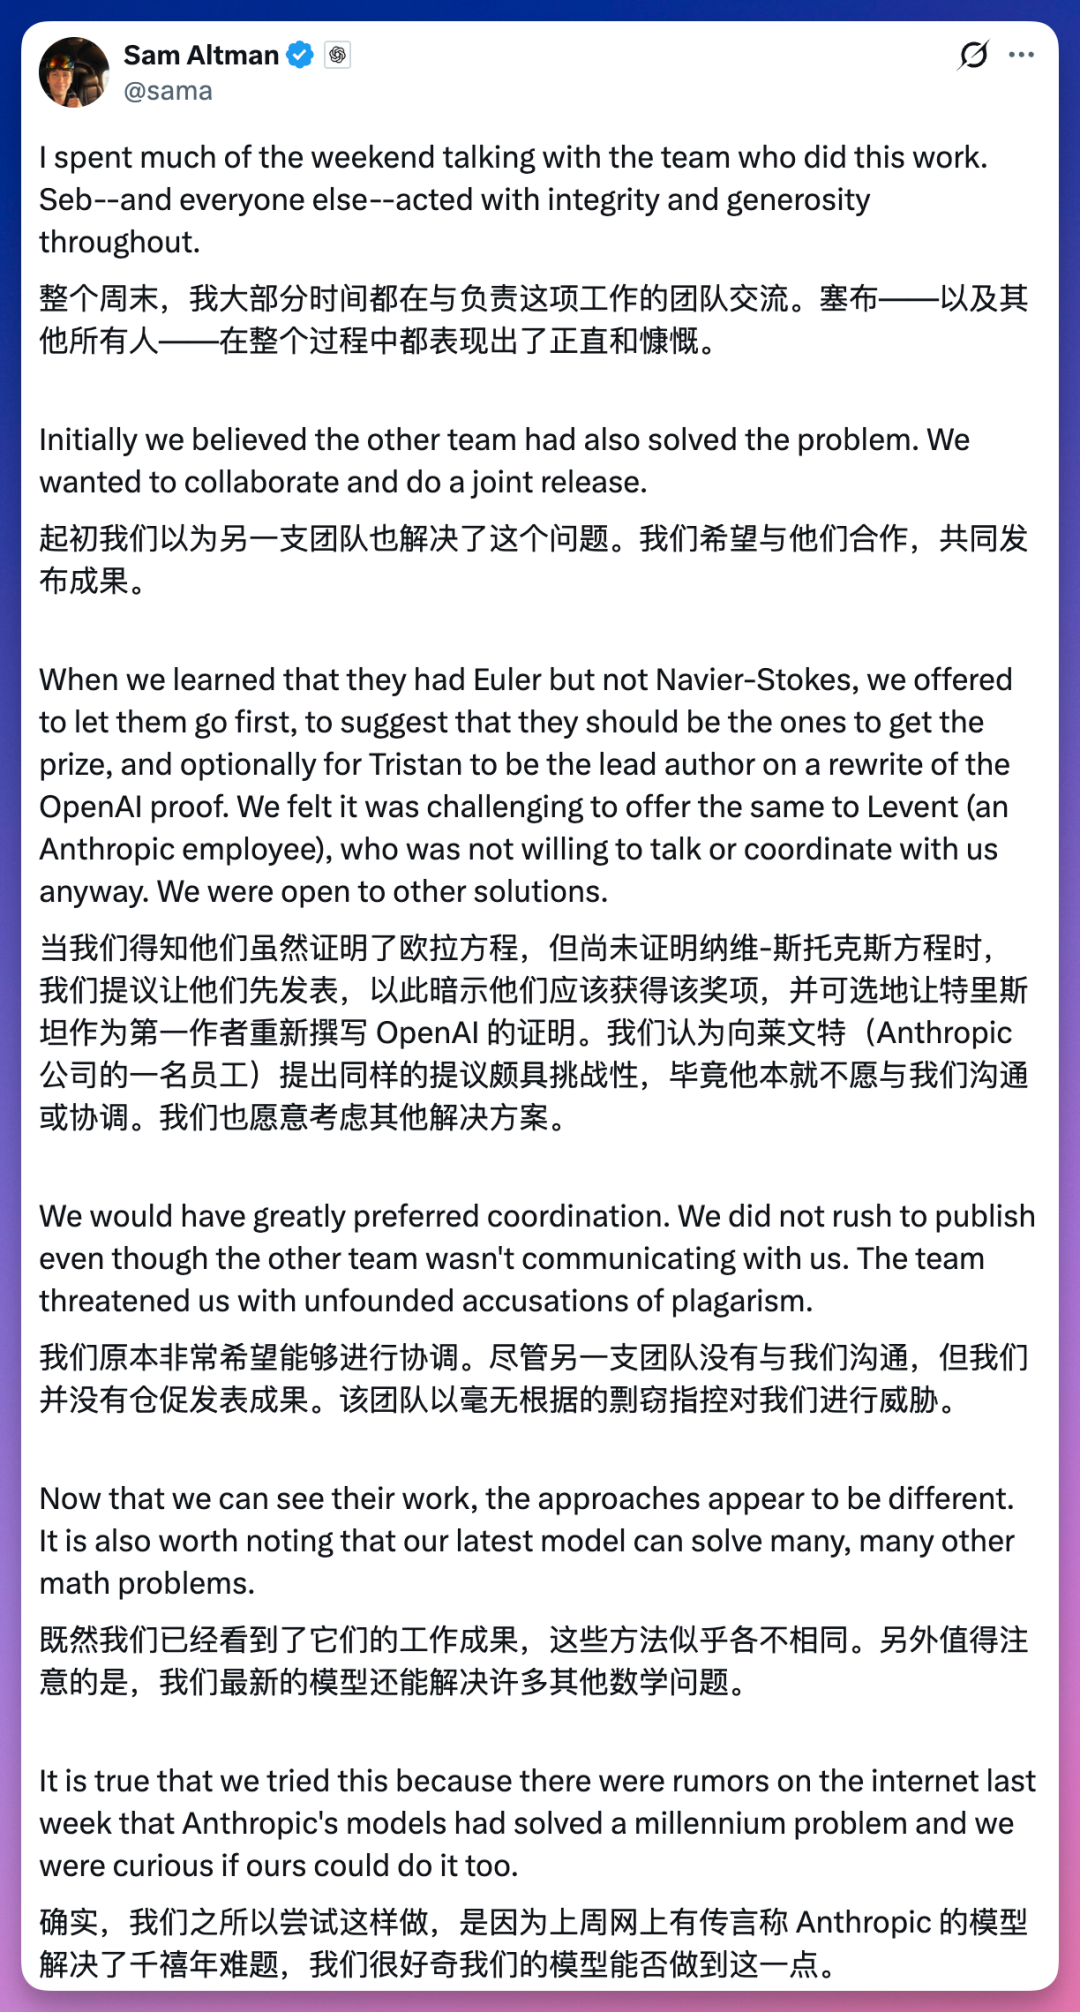
Sam Altman 也发了一篇小作文为团队背书,「我们本来想合作联合发布,后来得知两人做的是欧拉而不是纳维-斯托克斯,就提议让他们先发、OpenAI 后发,甚至建议他们申领克雷奖。」
「对方团队拿毫无根据的抄袭指控威胁了我们。」
「因为网上传言 Anthropic 解决了千禧年难题,OpenAI 好奇自家模型能不能做到,我们这才开始尝试的。」
OpenAI 的官方公告里有一句话值得细品。
「虽然可能性不大,但我们不能排除这种可能性:来自用户使用我们产品的去标识化数据,帮助改进了我们的模型。」
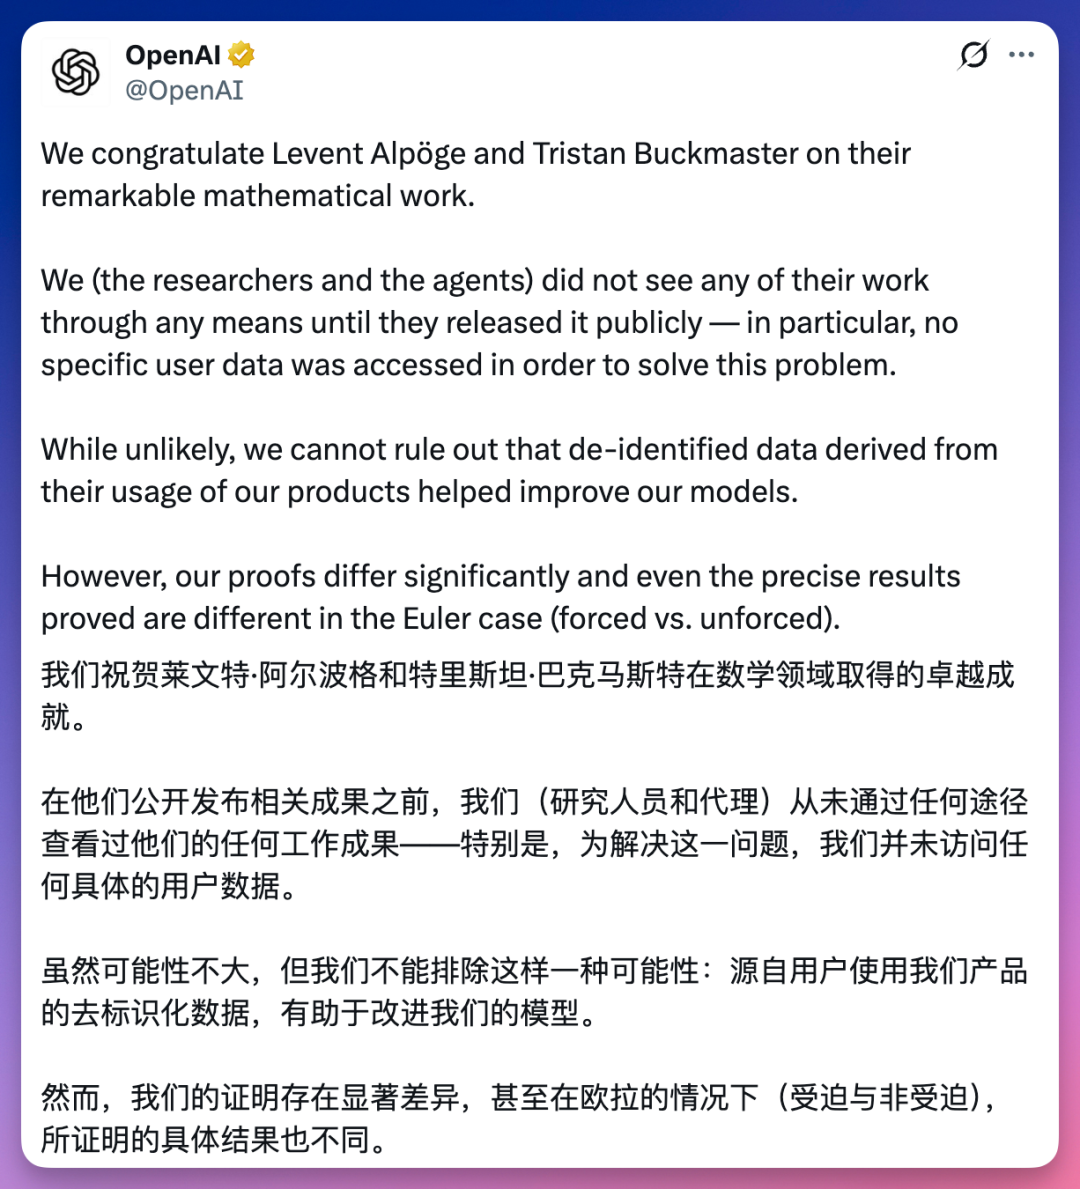
网友的翻译很到位,「我们没有抄你的作业,但你写作业的时候我们可能在旁边偷看了一眼。」
Buckmaster 在声明里说他没有看过 OpenAI 的证明,不知道对方的模型做了什么,也不知道自己的数据有没有被盗用。他没有指控任何人,只是把事情的经过原样写出来。
「如果 OpenAI 的模型真的补全了通往纳维-斯托克斯方程的最后一步,那是件了不起的事,应该由他们大声说出来,同时把事情的经过如实讲清楚。」


