
 五度妙笔
 企业透视镜
 API商城

 数据库
从数学原理看人工智能发展史
您想知道的人工智能干货,第一时间送达
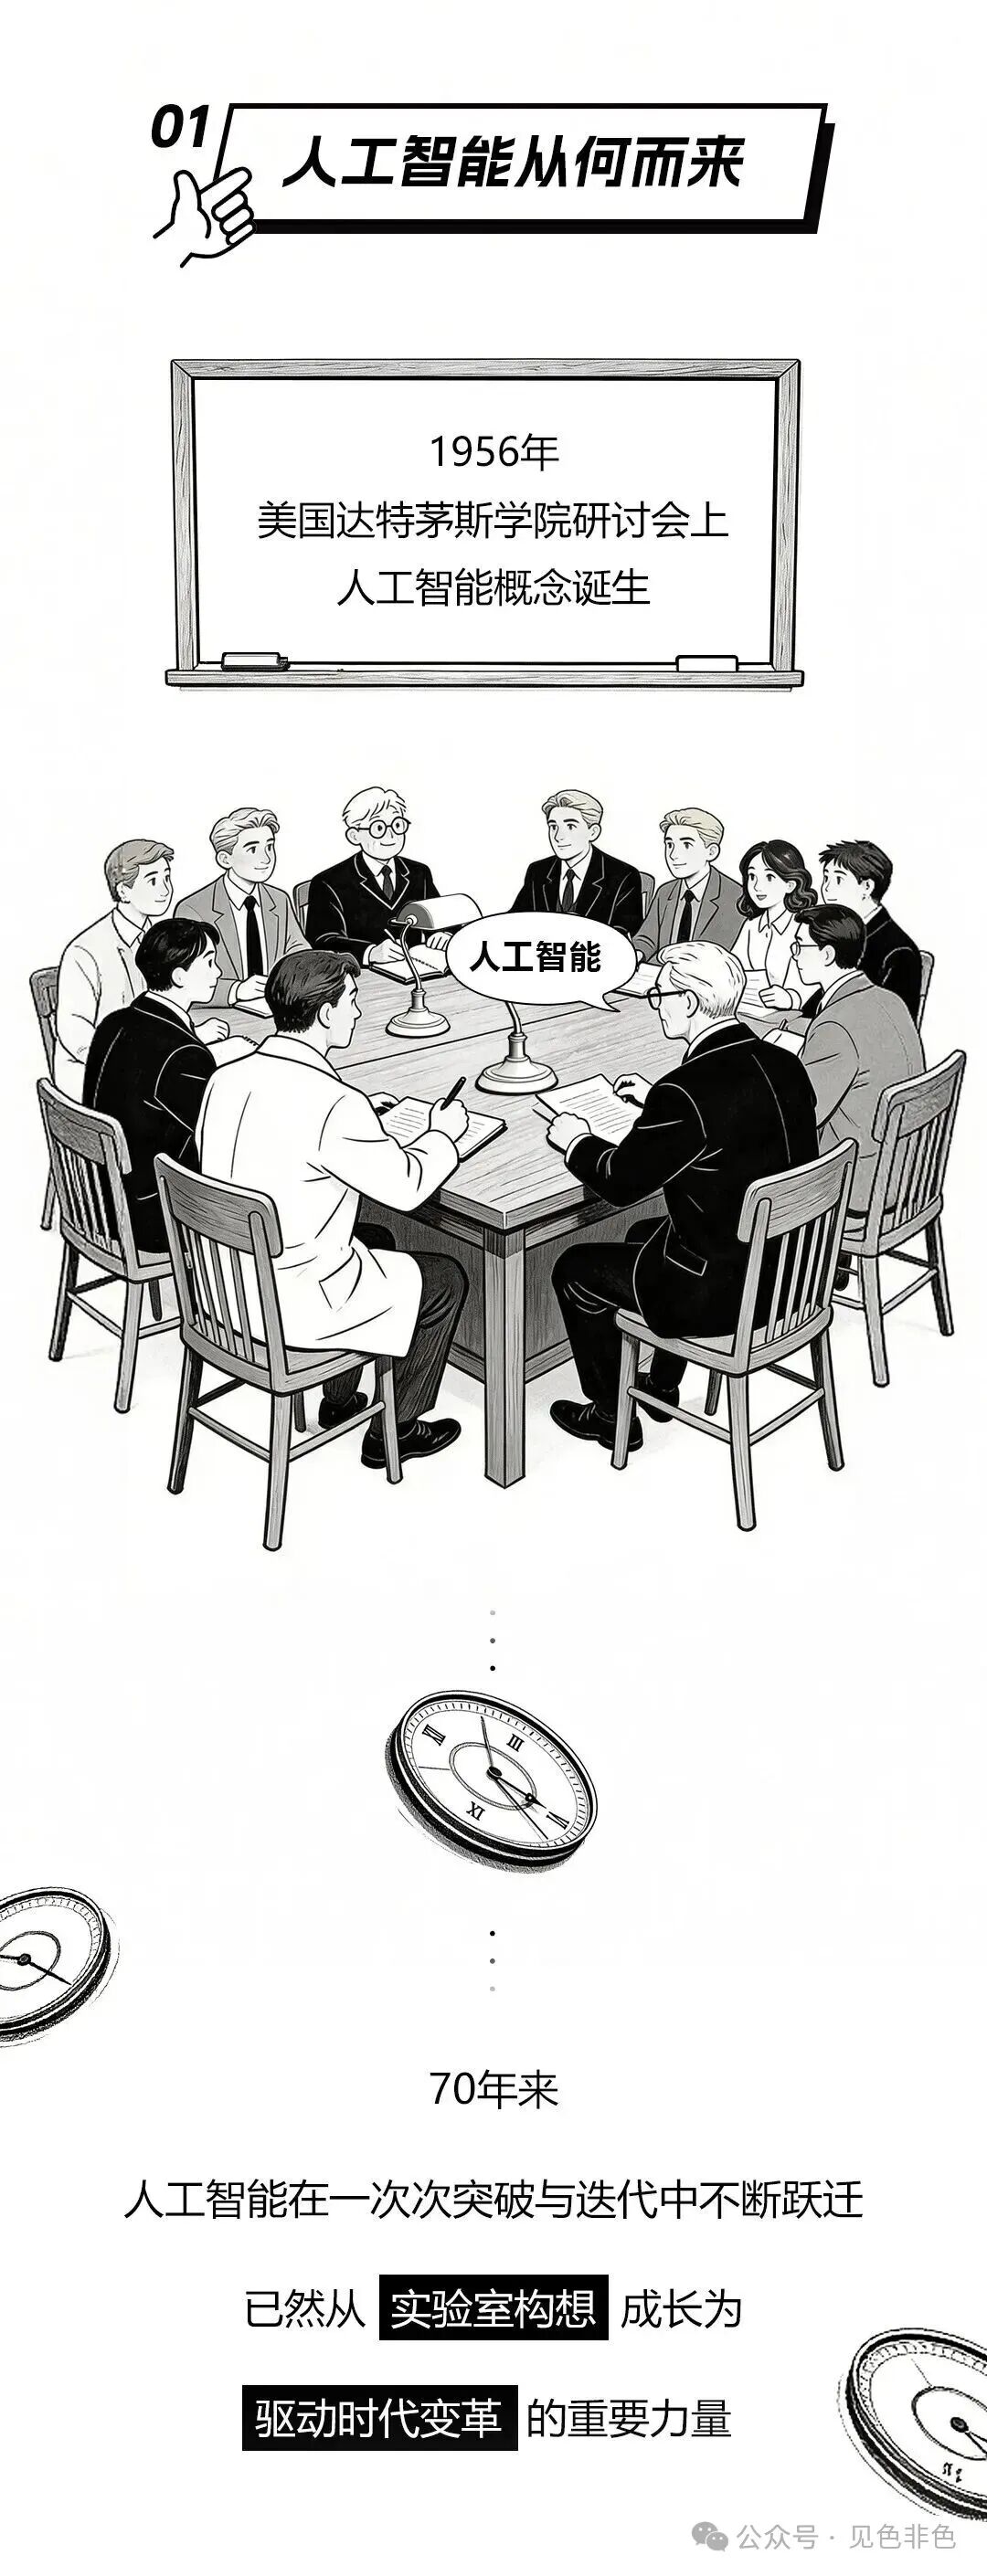
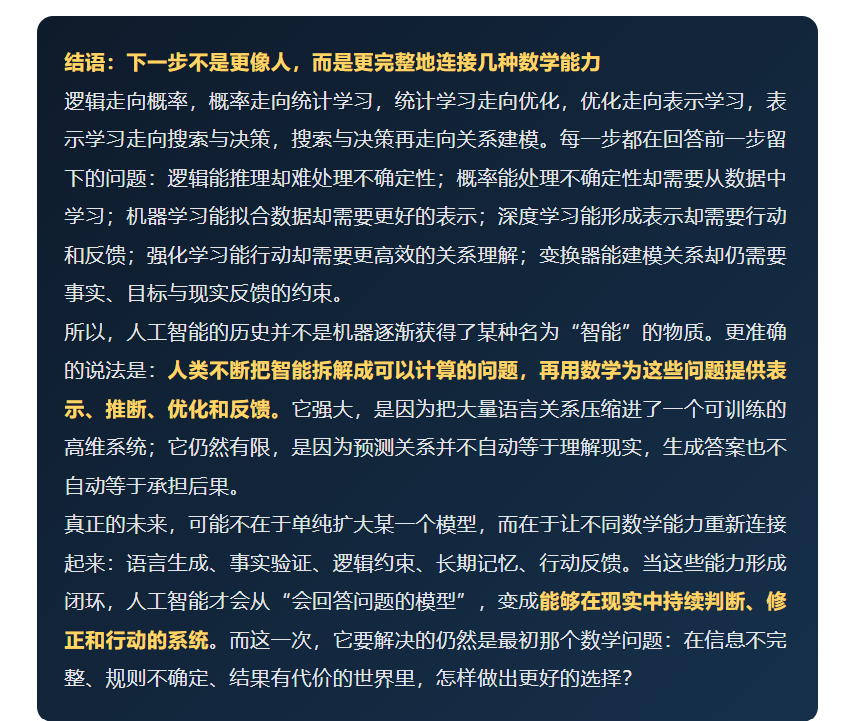
人工智能的历史,表面上看像一串越来越时髦的技术名词:逻辑推理、专家系统、机器学习、神经网络、深度学习、变换器、大语言模型。可如果把名词先放到一边,只盯住它们背后的数学,就会发现:这条历史并不是“机器越来越像人”的直线,而更像几条大河不断汇流。
今天的大模型能写会说,并不是忽然长出了某种神秘灵魂,而是这些数学思想在数据、算法和算力的共同推动下,终于汇成了一个足够大的系统。
最早的问题:智能能不能写成规则?
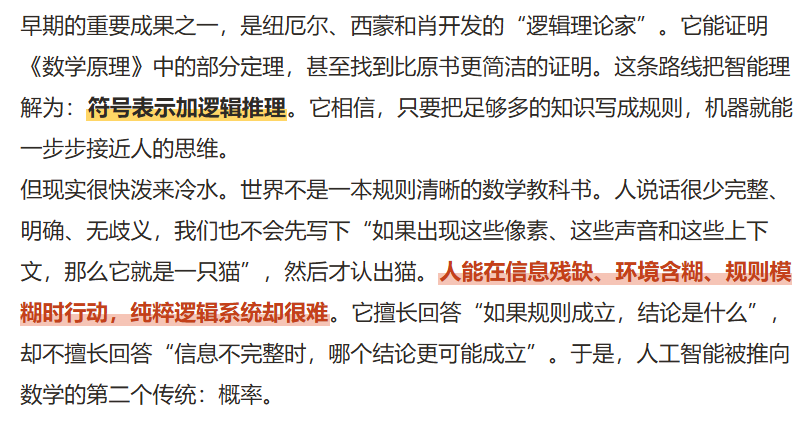
从“必然为真”到“可能为真”:概率进入 AI
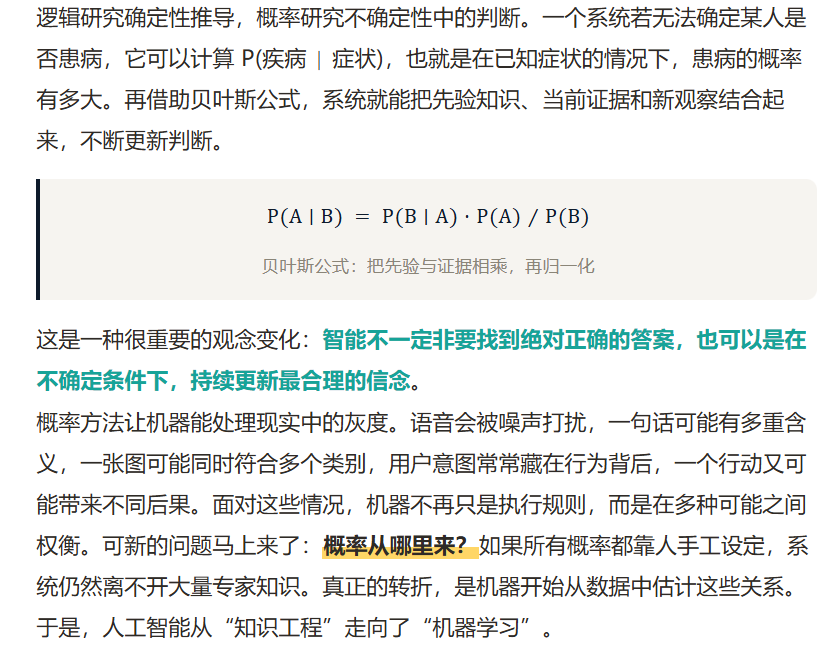
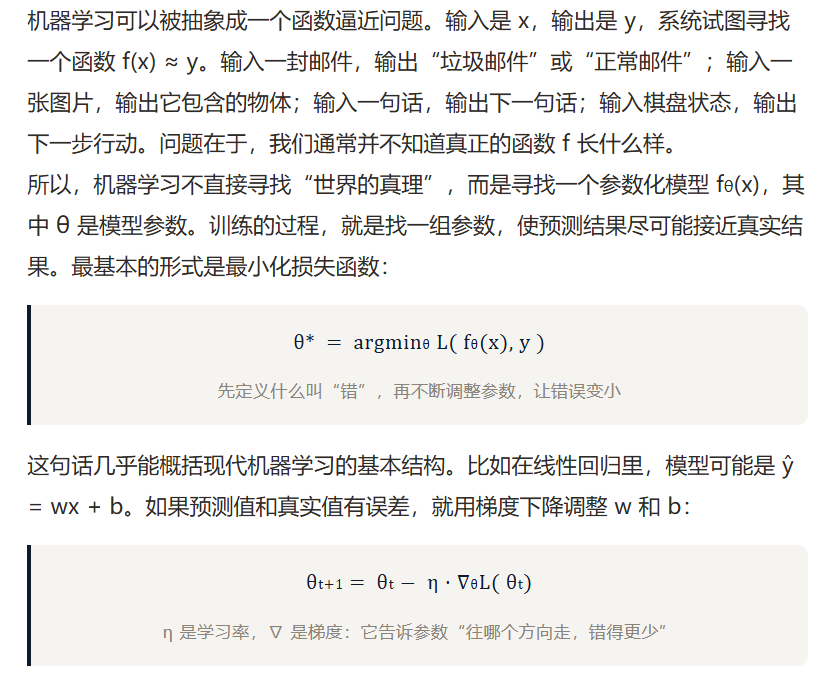
机器学习的核心:不要告诉系统规则,让它寻找函数
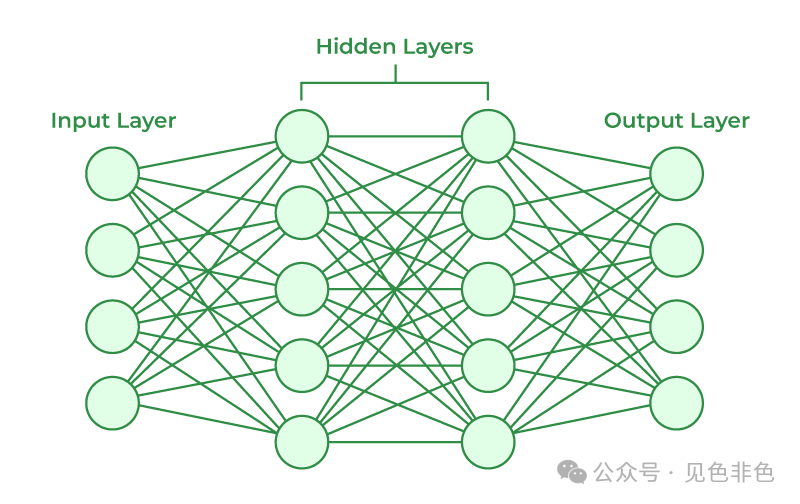
神经网络真正解决的,不只是分类,而是表示
早期神经网络曾遭遇严重挫折。单层感知机可以处理一些线性可分问题,却无法表示更复杂的关系。以异或问题为例,单个线性分类器无法用一条直线把结果分开。这暴露出一个关键限制:如果模型的表示能力太弱,再好的学习算法也得不到复杂答案。
解决方案不是简单增加规则,而是增加模型层次。多层神经网络可以写成:
真正重要的,不只是层数变多,而是模型可以自己学习“应该用什么特征表示问题”。
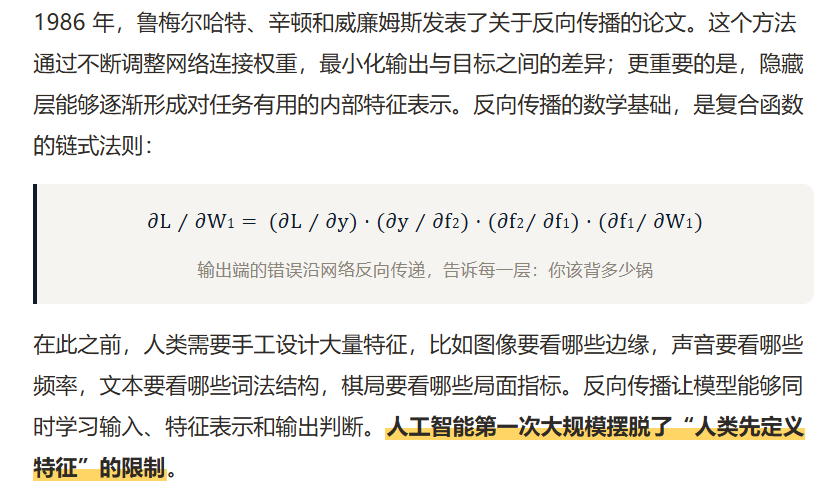
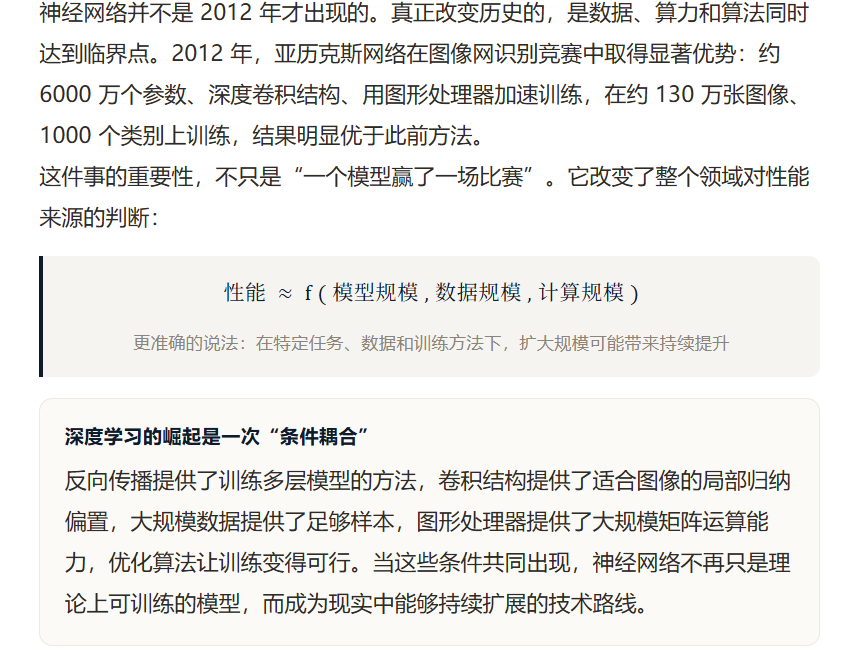
深度学习的突破:不是某一个算法赢了,而是三个条件同时成熟
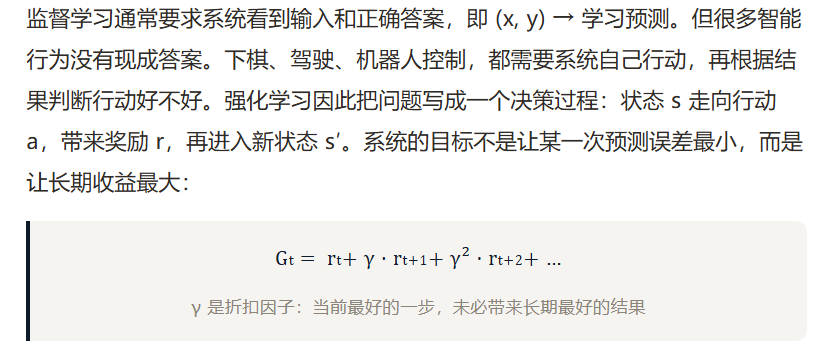
强化学习:从“预测正确”到“行动有效”
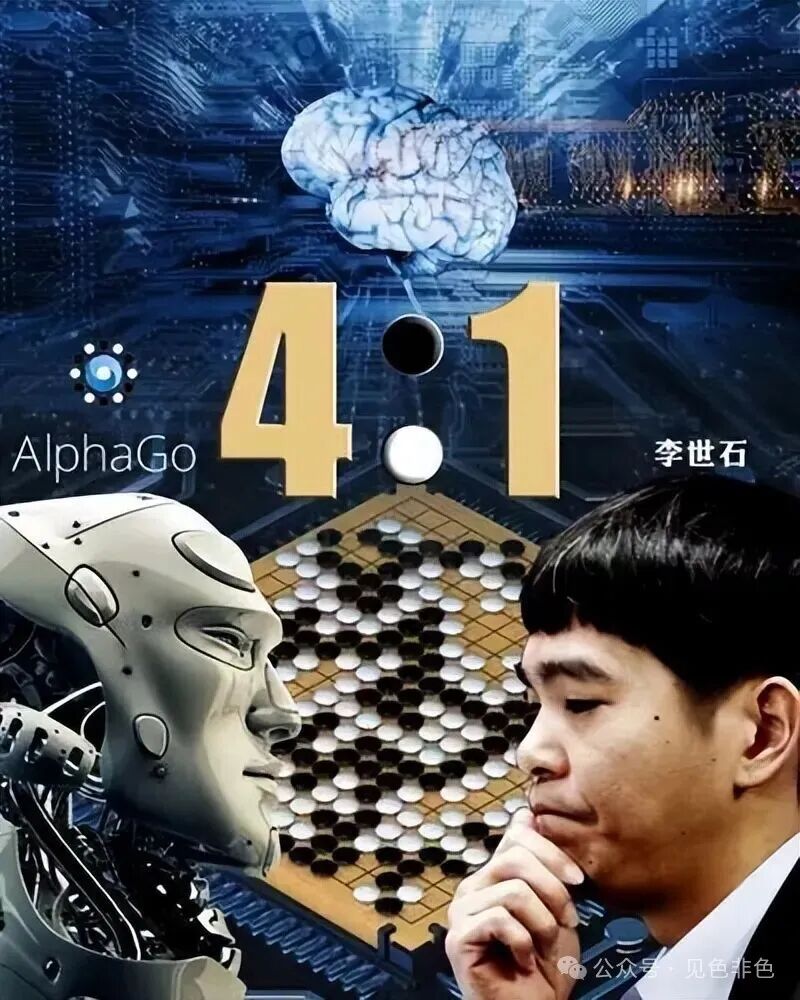
它把深度神经网络、蒙特卡洛树搜索和强化学习结合起来:神经网络负责评估局面与候选走法,树搜索负责在可能的行动空间中展开未来。其意义不在于“机器终于学会了围棋”,而在于展示了几种数学思想如何协同工作。单独依靠搜索,围棋的分支空间过于庞大;单独依靠神经网络,又可能缺少对未来后果的展开。
变换器:语言不再只是序列,而成为关系网络
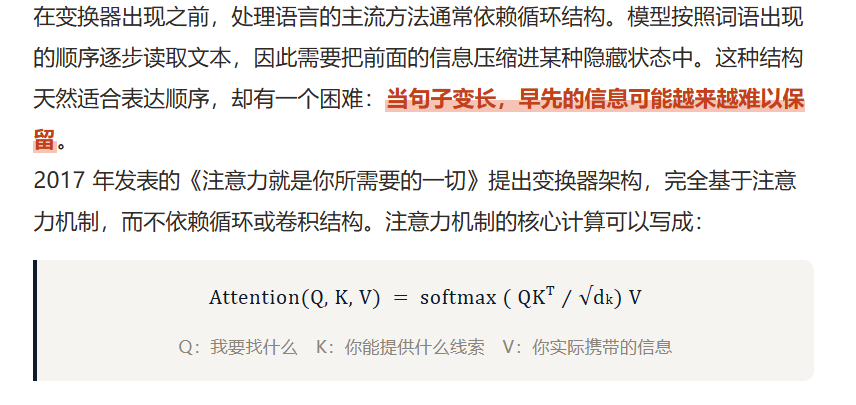
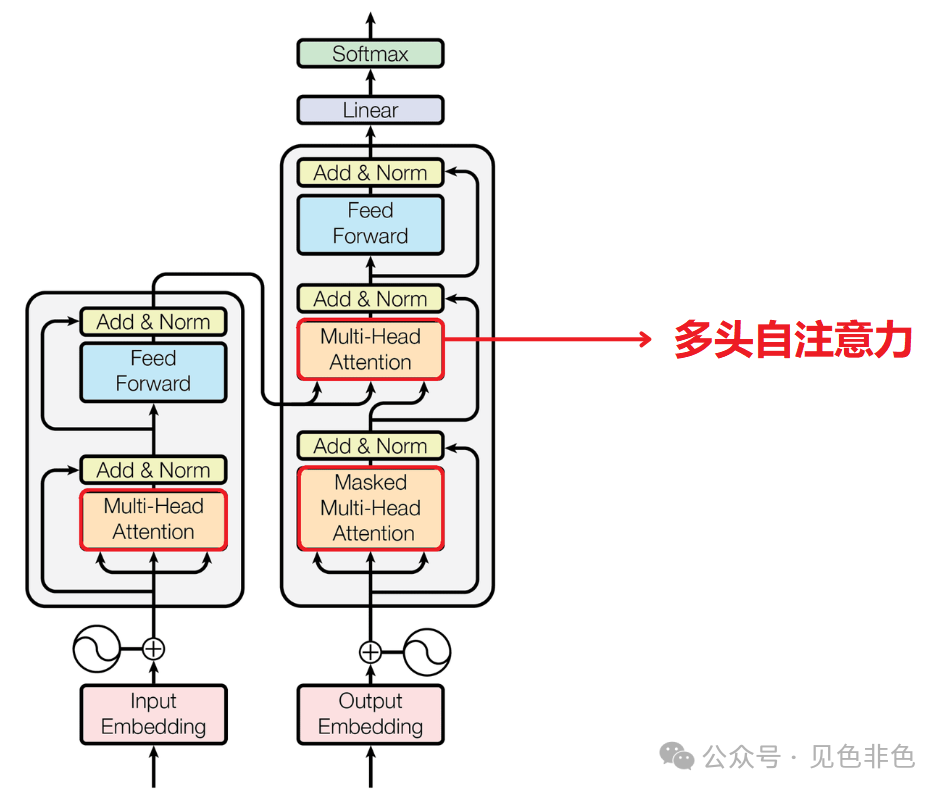
在“银行因为暴雨关闭了”这句话里,“银行”究竟指金融机构还是河岸,需要结合其他词来判断。注意力机制允许模型直接计算词与词之间的关系——模型不再只问“下一个词是什么”,它还会问“当前这个词,应该关注上下文中的哪些词”。
这带来了一次表示方式的变化:从序列处理走向关系建模。语言不再只是一个词接一个词的链条,也成为一个由多种依赖关系组成的结构。这正是变换器能够扩展到大语言模型的重要原因之一。
大语言模型究竟学到了什么?
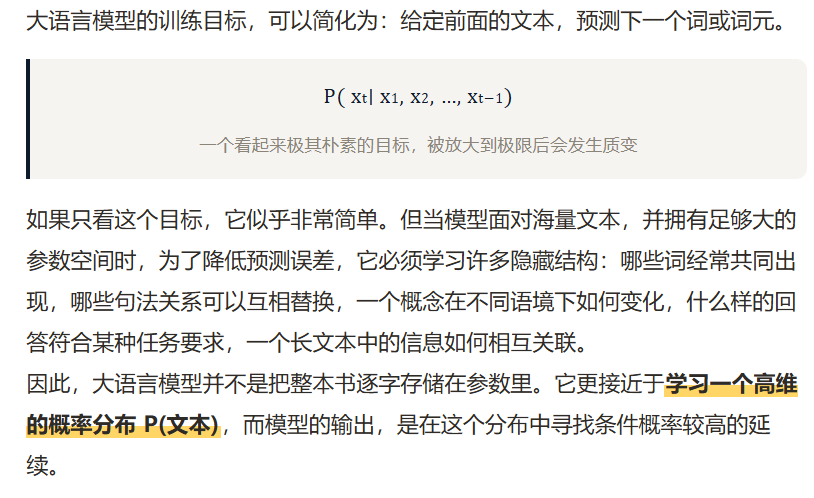
从几何角度看,模型会把词语、句子和概念映射到高维空间。语义相近的对象,往往会形成某种相近的结构;不同概念之间的关系,也可能表现为向量空间中的方向、距离和变换。但这仍然不等于人类意义上的理解。模型的核心任务是“根据上下文生成概率较高的输出”,而不是“确保每个输出都对应真实世界中的事实”。
回头看:真正变化的是“智能被放在哪里”
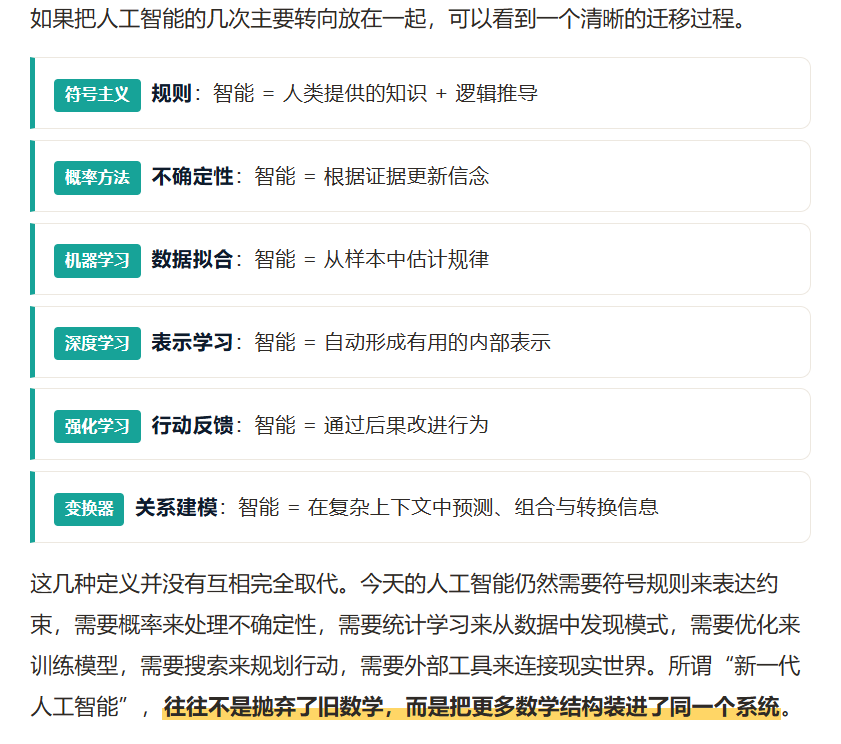
不是从规则走向无规则,而是从显式规则走向隐式结构
人们经常把人工智能历史讲成一场简单的替代:符号主义失败,神经网络胜利。但这并不准确。
真正的差异,不在于谁“更像智能”,而在于它们把结构放在了不同位置:符号系统把结构写在程序里,结构由人工规定;神经网络则把结构分布在参数中,结构从数据中学习。前者更容易检查,后者更容易扩展。这也解释了当代人工智能的核心矛盾:模型越强,内部结构越复杂;模型越灵活,行为越难以完全预测。
文章精选:
1.图灵奖得主姚期智最新演讲: AI有边界,恰恰是好事


