
 五度妙笔
 企业透视镜
 API商城

 数据库
高中背了三年的 sin 和 cos,原来是大模型记住"谁先谁后"的秘密
单击上方“图灵人工智能”,选择“星标”公众号
您想知道的人工智能干货,第一时间送达
为什么 Transformer 能知道"谁在前、谁在后"?为什么所有 Claude、GPT都要用三角函数?一篇文章用 PyTorch 代码讲透 sin、cos、旋转矩阵与 RoPE 的真正关系。
正弦、余弦、正切、和角公式、正弦定理……高中背了三年,考完只记得"sin30° = 0.5"。
因为老师只教你"查表算三角形",没告诉你两件事:
第一,sin 和 cos 的灵魂根本不是三角形,是"旋转"。
第二,今天每一个大模型Claude, GPT记住"哪个词在前、哪个词在后",
靠的正是给每个位置转一个角度——这套机制叫 RoPE(旋转位置编码)。这篇文章不背一个公式、不证一个定理,全部用能跑起来的 PyTorch 代码,
把三角函数最核心的"旋转"本质,一路接到大模型的 RoPE。
并且顺手回答四个灵魂拷问:
sin、cos 明明是算三角形的,怎么会和"位置""顺序"扯上关系? "给一个向量转一个角度"到底是什么意思?为什么要转? Transformer 不是号称"并行处理"吗,它究竟怎么知道哪个词在前、哪个在后? RoPE 公式里那些 sin(pos / 10000^...)到底在干嘛?
0. 一句话主线
如果只能留一句话,那就是这句:
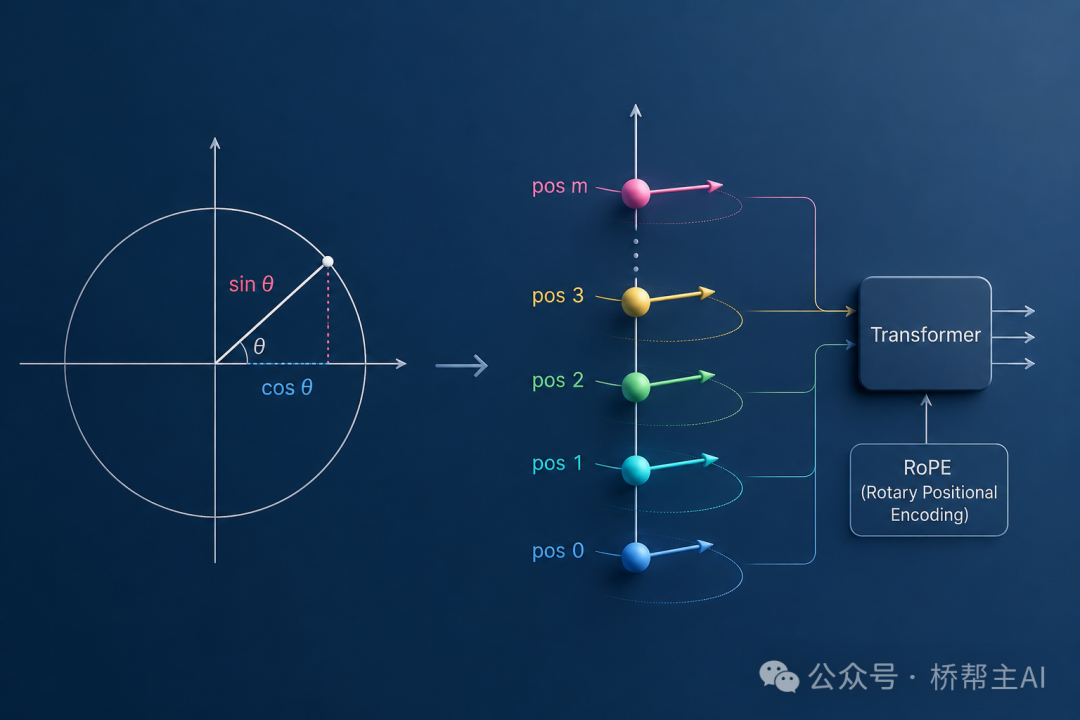
三角函数的灵魂是"旋转"。sin 和 cos,就是单位圆上一根转动的钟表指针的两个坐标(纵、横)。
一根指针从正右方(0°)开始转,转到角度 θ 时,它的指尖坐标正好是 (cos θ, sin θ)。
所以"sin/cos"根本不是三角形的边长比,而是**"转了 θ 角之后,落在了哪里"**。
大模型给第 m 个位置的词"转 m 个单位角度",就能把"它排第几"这件事,悄悄编码进向量里。
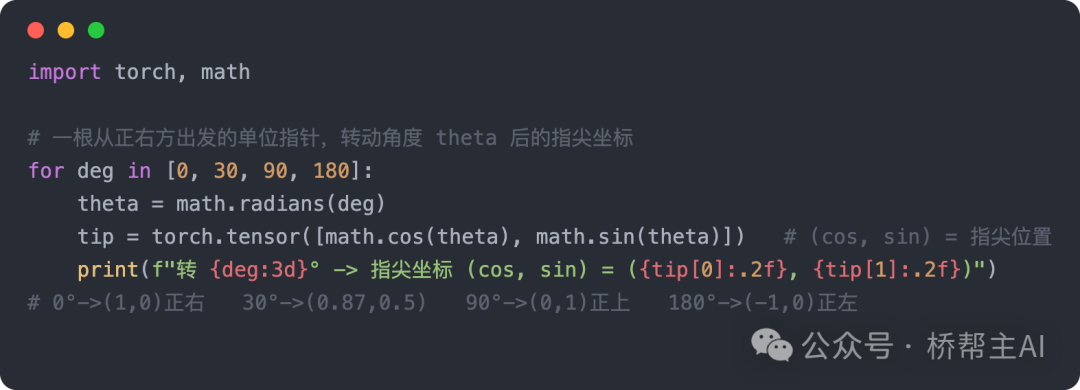
记住这个画面:cos 是指针的横坐标,sin 是纵坐标,它俩一起描述"转了多少"。
下面所有东西都挂在这根转动的指针上。
1. sin、cos 不是三角形,是单位圆上的钟表指针
高中把 sin 定义成"对边比斜边",把你锁死在一个直角三角形里。
但真正有用的定义是单位圆:让一根长度为 1 的指针绕原点转,转到哪,(cos, sin) 就报出它在哪。
这个视角一换,三角函数立刻从"算三角形"升级成"描述旋转":
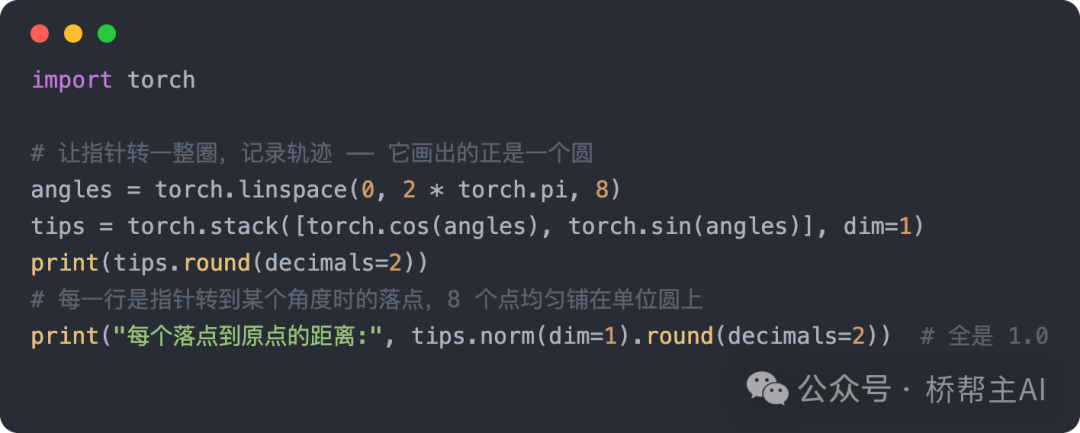
所有落点到原点的距离都是 1——它们严格躺在单位圆上。
这就是 sin/cos 的真身:一台"角度 → 坐标"的翻译机。喂进去一个角度,吐出来圆上的一个位置。
高中你被"对边斜边"框住了,其实只要记住:cos/sin = 转了 θ 角之后,指针尖在哪。
有了这个,下一节的"旋转"就水到渠成。
2. 旋转矩阵:把任意一个向量"转 θ 度"
指针能转,任意向量当然也能转。把一个向量转 θ 度,用的就是那个高中偷偷教过、却没说它多重要的旋转矩阵:

(如果你读过本系列《线性代数》那篇,这台"旋转机器"你已经见过 大学4年没讲明白的线性代数,被一段 PyTorch 代码讲透了)代码转一个向量看看:
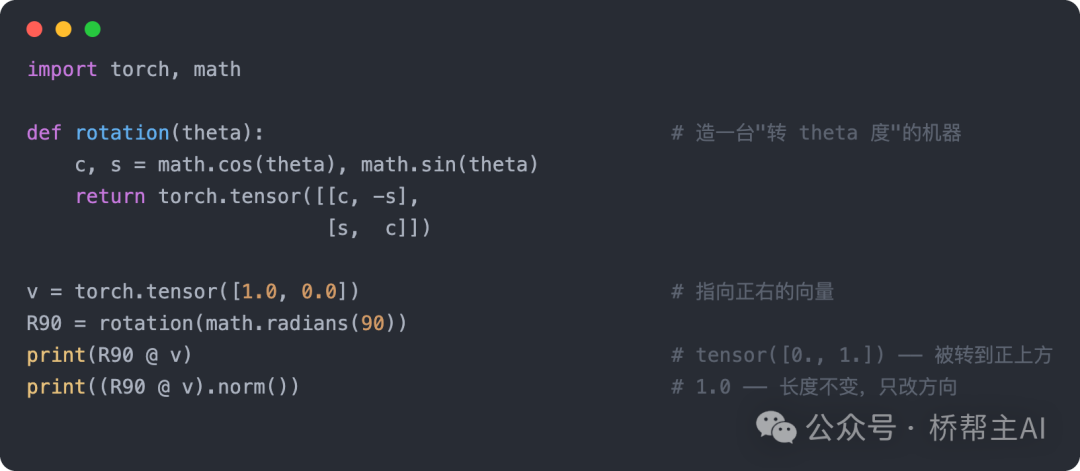
旋转矩阵只改方向、不改长度。 这一点后面是关键:位置编码只能"标记位置",
绝不能把词向量本身的大小改掉,否则语义就毁了。旋转恰好满足这个要求——它温柔地只动方向。
3. 旋转的黄金性质:转 a 再转 b = 转 (a+b)
这是整篇文章的枢纽,也是 RoPE 全部魔法的来源。三角函数的"和角公式"
(cos(a+b) = cos a cos b − sin a sin b 那一坨,你一定背过),翻译成人话就一句:
先转 a 度,再转 b 度,等于一口气转 (a+b) 度。角度是可以直接相加的。
用代码验证这个"角度可加"性质——它看起来平平无奇,却是位置编码能work的根基:
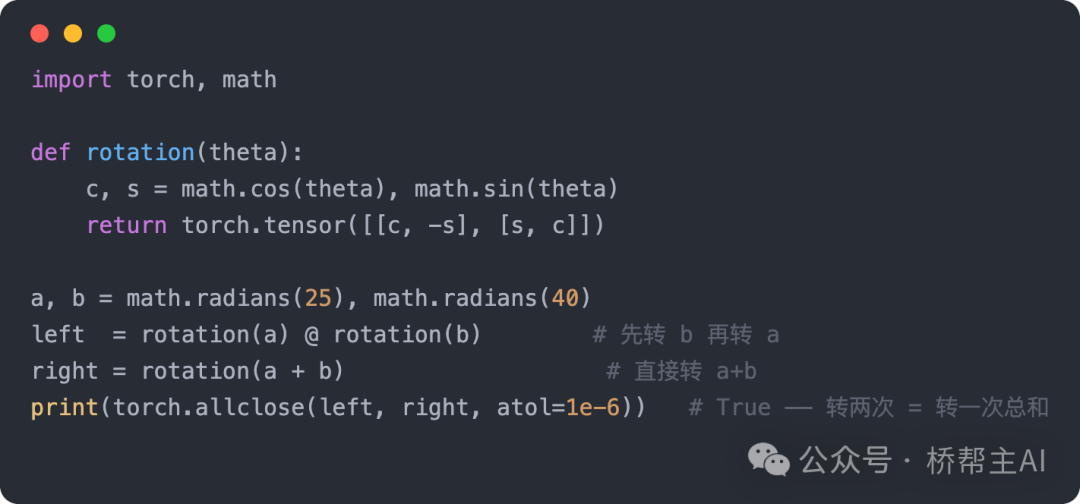
角度可加,意味着"位置 5"就是"位置 3"再多转 2 步——位置之间的关系,变成了角度之间的减法。
这正是我们想要的:一个能自然表达"谁比谁靠后多少"的机制。记住这句,第 5 节它会变成主角。
🤔 疑惑点一:Transformer 不是"并行"的吗?它到底怎么知道词的先后顺序?
默认情况下,它根本不知道——纯粹的自注意力是"集合运算",把词序打乱,输出只会跟着一起打乱,模型察觉不到顺序。所以必须人工把位置信息"注入"进去。
这是最反直觉的一点。注意力机制里,每个词和所有词算相关度、再加权求和,
这个过程对词的排列是"等变"的:你把输入的词换个顺序,输出也只是换同样的顺序,
没有任何一步依赖"绝对位置"。用代码把这个"顺序失明"证出来:
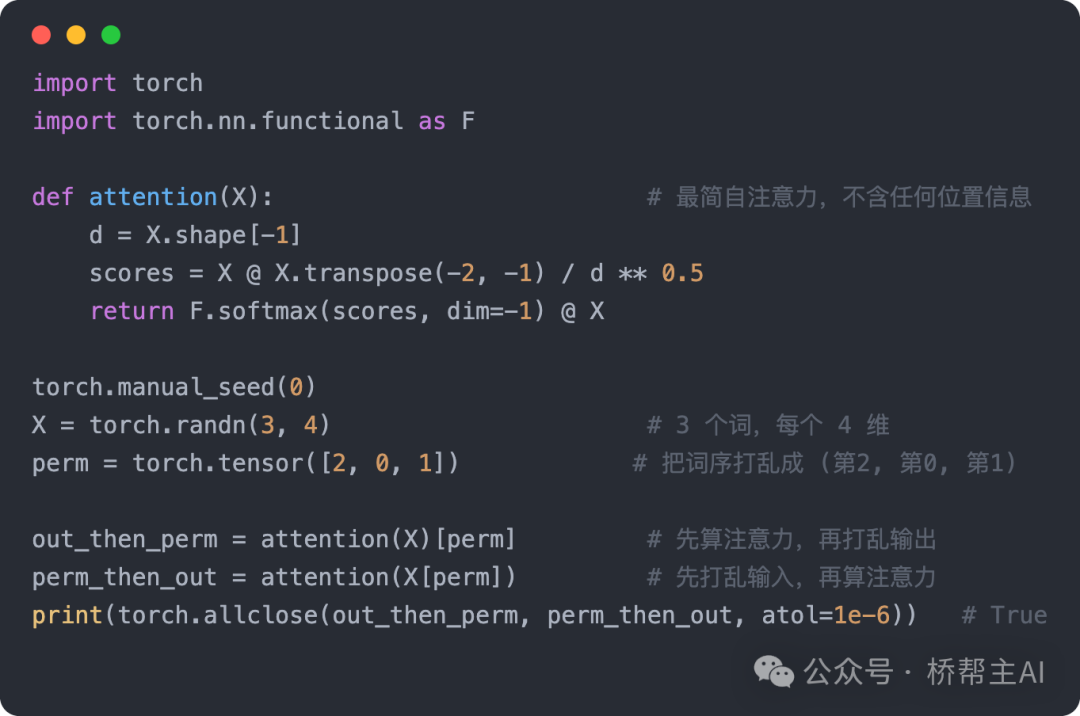
结果为 True 说明:打乱输入 = 打乱输出,注意力对"顺序"完全无感。
"猫追狗"和"狗追猫"在纯注意力眼里,只是同一堆词的两种摆法,算出的关系一模一样。
这显然不行——语言里顺序就是意义。所以我们必须主动给每个位置盖一个"第几号"的戳。
RoPE 盖戳的方式,就是第 0~3 节那根转动的指针。
4. RoPE:给第 m 个位置的向量,转 m 个单位角度
思路简单到令人发指:既然旋转能优雅地标记角度,那就让第 m 个位置的词向量,转 m × θ 度。
位置 0 不转,位置 1 转 θ,位置 2 转 2θ……位置本身,就变成了"转了多少圈"。
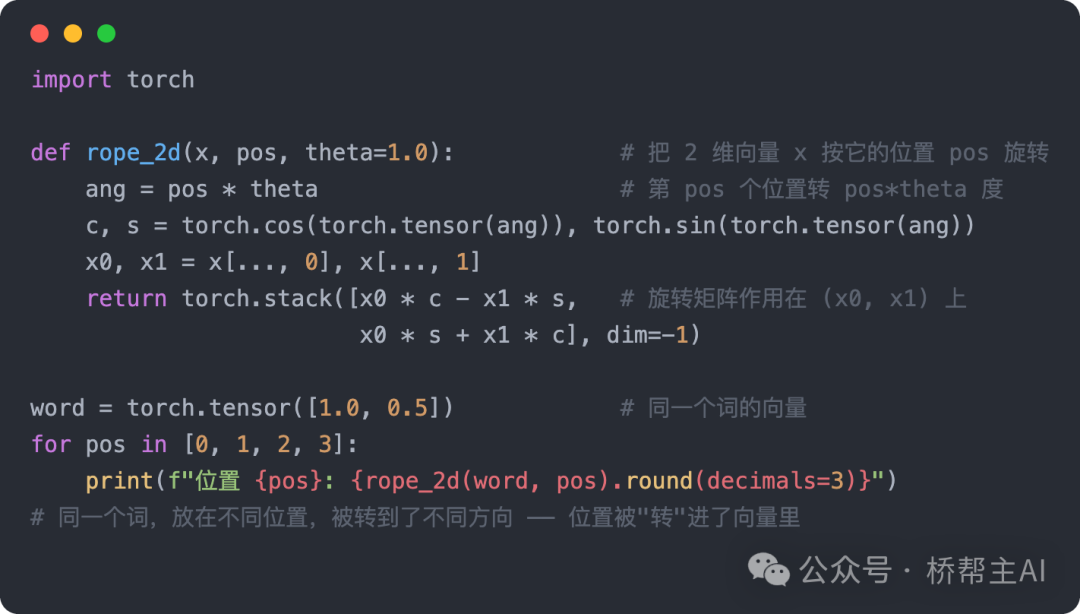
同一个词向量 [1.0, 0.5],放在位置 0、1、2、3,被转成了四个不同方向的向量。
"它排第几"这个信息,现在藏在"它被转了多少角度"里。 位置编码完成,而且没动向量的长度(第 2 节的好处)。
5. 为什么"转角度"这么妙:两个词的相关度,只取决于它们的相对距离
这是 RoPE 最漂亮的地方,也是它吊打老式位置编码的原因。注意力要算 query · key(第 1 节讲过,
点积衡量两个向量多相关)。当 query 在位置 m、key 在位置 n,各自被 RoPE 旋转后,它们的点积会神奇地只依赖 m − n(相对距离),而与它们各自的绝对位置无关。
回到第 3 节的"角度可加/可减":R(mθ)ᵀ R(nθ) = R((n−m)θ),所以旋转后的点积只剩下 (n−m) 这个相对量。空口无凭,代码验证——固定相对距离,绝对位置随便挪,点积纹丝不动:
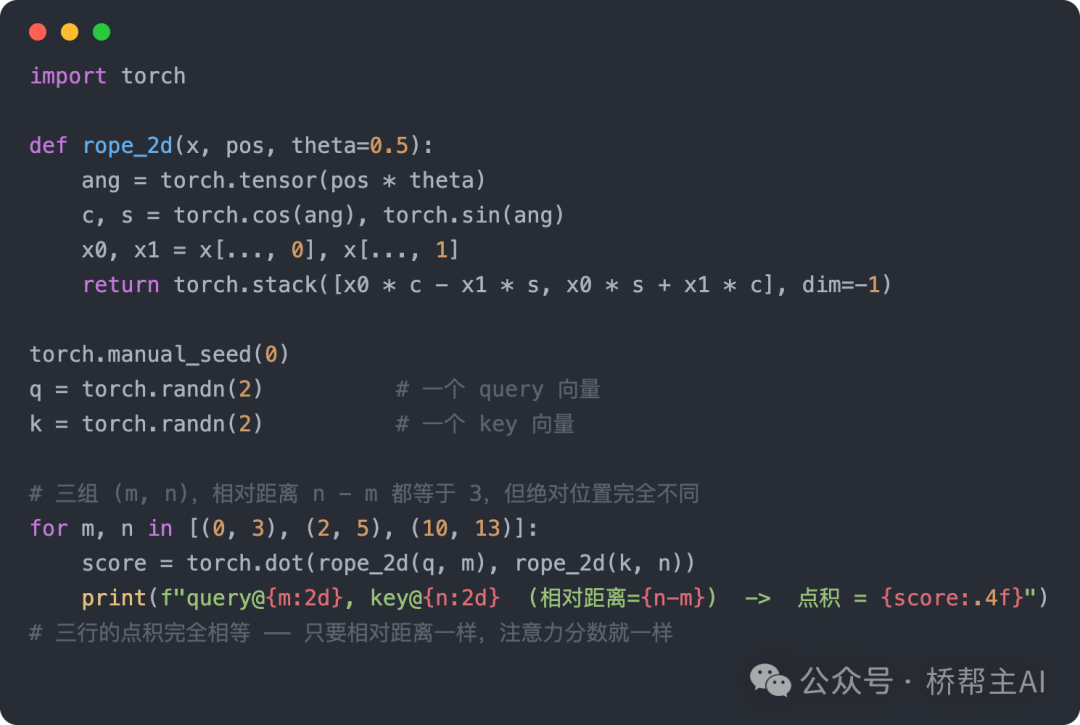
三行输出的点积一模一样。这意味着:RoPE 让模型天生理解"相对位置"——
它不在乎你这句话从第几个字开始,只在乎"这个词离那个词隔了多远"。
这正是语言的本质("形容词修饰它后面的名词"是相对关系,和整句话在文档第几行无关)。
老式的绝对位置编码做不到这一点,RoPE 靠一根转动的指针就做到了。
🤔 疑惑点二:RoPE 公式里那一堆 10000^(2i/d) 是什么鬼?
那是给向量的不同维度配上"不同的转速",像钟表的时针、分针、秒针——快针分辨相邻词,慢针记住远距离,组合起来就能覆盖从"隔壁"到"很远"的所有位置关系。
前面为了讲清楚,我们只转了一个 2 维向量、用了同一个转速 θ。真实的词向量有几百上千维,
RoPE 把它们两两配对,每一对用不同的角速度去转:低维配对转得快,高维配对转得慢。
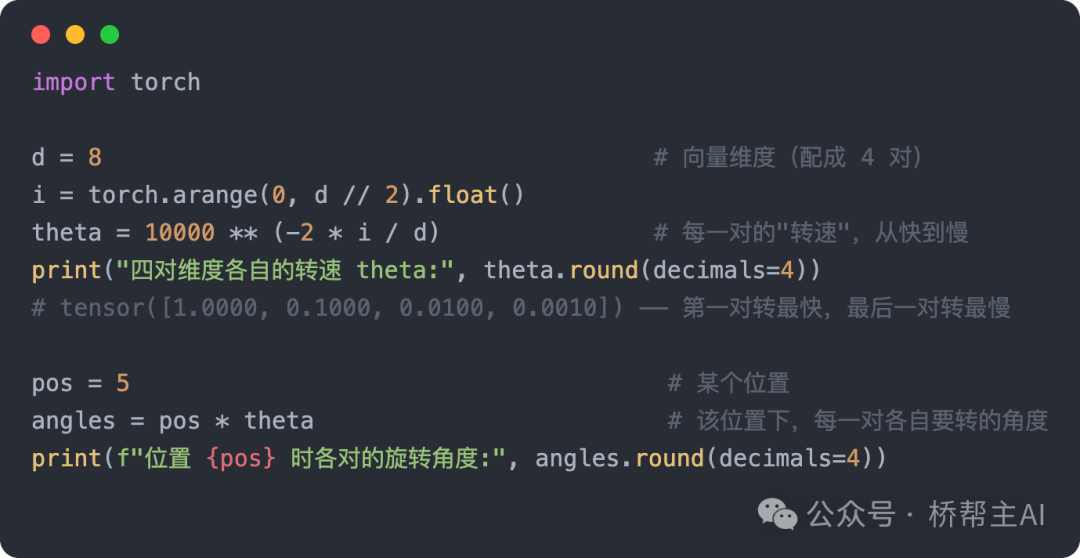
为什么要多个转速?打个比方就懂了——这就是钟表的智慧:
秒针转得飞快,用来分辨"1 秒 vs 2 秒"这种近距离差别;
时针转得极慢,用来记录"3 点 vs 9 点"这种大跨度。
只有一根针,要么分不清相邻、要么表示不了大范围。
RoPE 给向量配上一整套"快慢不同的指针",于是它既能分辨相邻词,又能记住隔了几十上百个词的远距离关系——用一组三角函数,把从近到远的所有位置尺度一网打尽。
这就是那个吓人的 10000^(2i/d) 的全部含义:它只是在给每一对维度分配一个转速,凑齐一套时针分针秒针。
🎬 动手:一个最小 RoPE,看位置如何"转"进注意力
把上面所有画面缝进一个能跑的最小 RoPE,作用在一串词上,然后看注意力分数如何随相对位置变化:
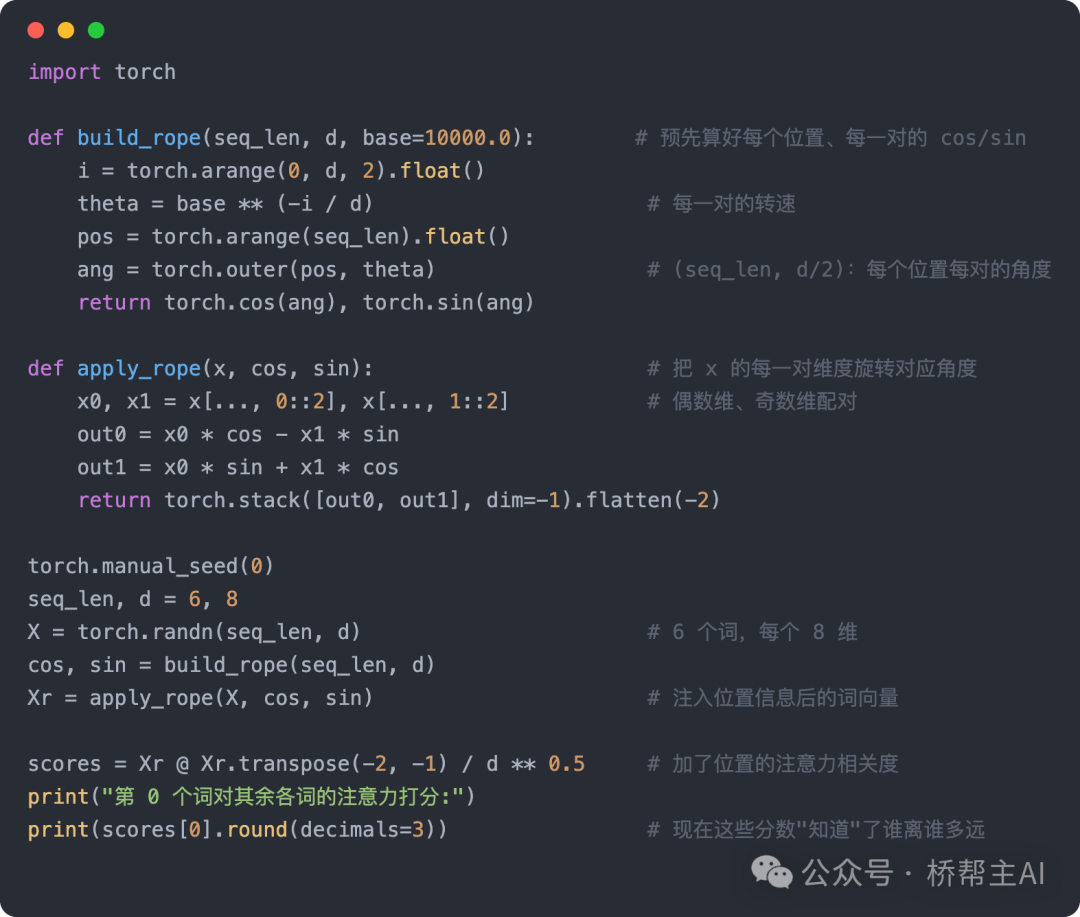
和"疑惑点一"里那个顺序失明的注意力对比一下:现在 scores 里已经悄悄编码了相对位置,
打乱词序结果就会变了——模型终于长出了"顺序感"。
仓库里的动画脚本把这根"转动的指针"画了出来:python scripts/rope_rotation_visualization.py
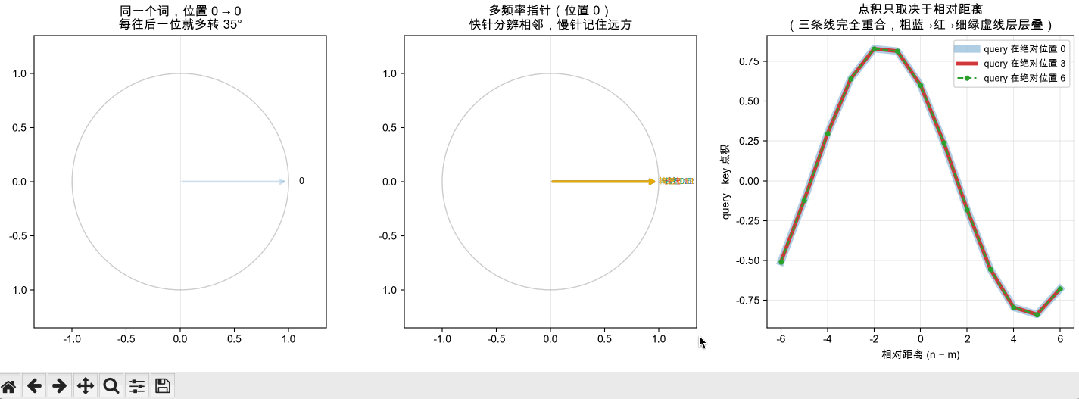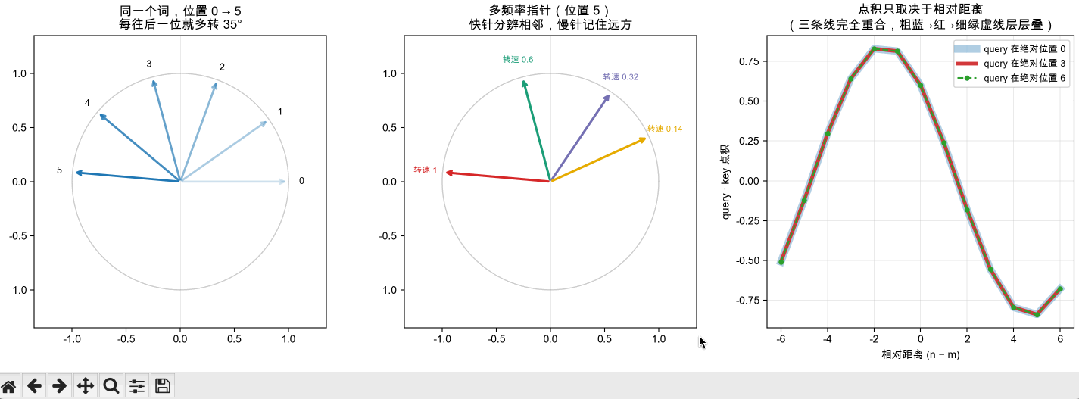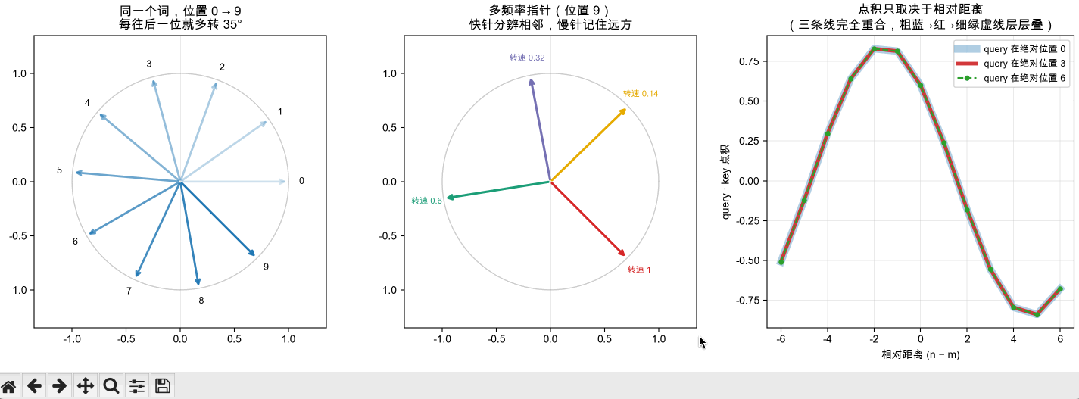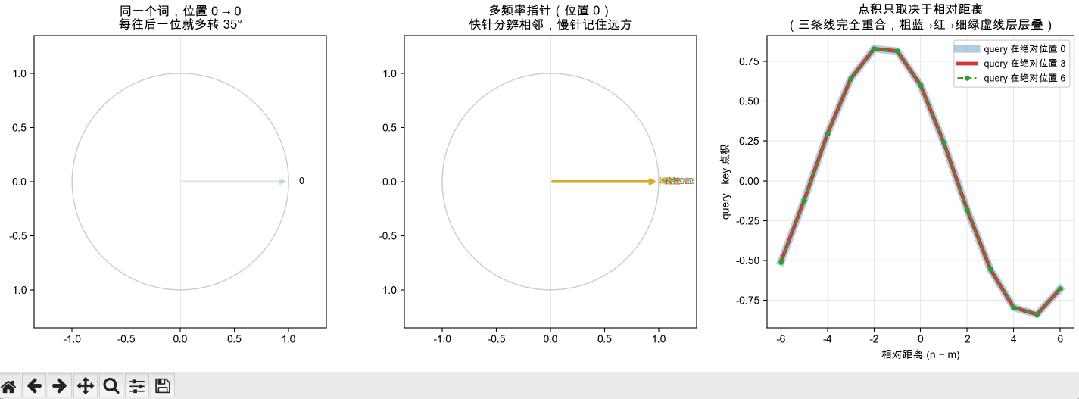
画面里,同一个词向量被放在位置 0、1、2、3……你会看到它像钟表指针一样,
每往后挪一个位置,就多转一个固定的角度;而多频率那一版里,几对指针以不同转速同时旋转,
快的负责相邻、慢的负责远方。最后一幅图把"点积只依赖相对距离"画成一条曲线——
无论绝对位置怎么平移,曲线的形状纹丝不动。
缝合:把所有画面接起来
回到开头,现在每个概念都有了画面和代码出处:
| sin / cos | |||
| 旋转矩阵 | |||
| 和角公式 | cos(a+b)=… | ||
| 多个频率 | 10000^(2i/d) | ||
| 点积 | a·b = |a||b|cosθ |
三句话总结这篇文章:
三角函数的灵魂是"旋转"——sin/cos 是单位圆指针的坐标,不是三角形的边(第 0、1 节);
旋转能优雅地把"位置"编码成"角度",而"角度可加"让位置关系变成相对减法(第 2、3、4 节);
于是 RoPE 让注意力天生理解"谁离谁多远",这就是今天所有主流大模型记住词序的秘密(第 5 节、疑惑点二)。
当年三角函数背得那么苦,不是因为它难,是因为没人告诉你:
那根在单位圆上转啊转的 sin/cos 指针,最后转进了每一个大模型的注意力里,
成了它记住"谁先谁后"的办法。
现在把上面每段代码跑一遍,比高中刷十套三角卷子都值。
文章精选:
1.图灵奖得主姚期智最新演讲: AI有边界,恰恰是好事


