 五度妙笔
 企业透视镜
 API商城

 数据库
从星球到街景一键生成!高德新世界模型来了,消费级显卡可跑
智东西(公众号:zhidxcom)
作者 | 江宇
编辑 | 李水青
智东西9月10日报道,刚刚,高德正式推出
新一代3D原生城市世界模型ABot-Earth 0.7
,并将这套世界模型进一步用进
飞行街景2.0、导航Live、避雷指南
等AI服务中。
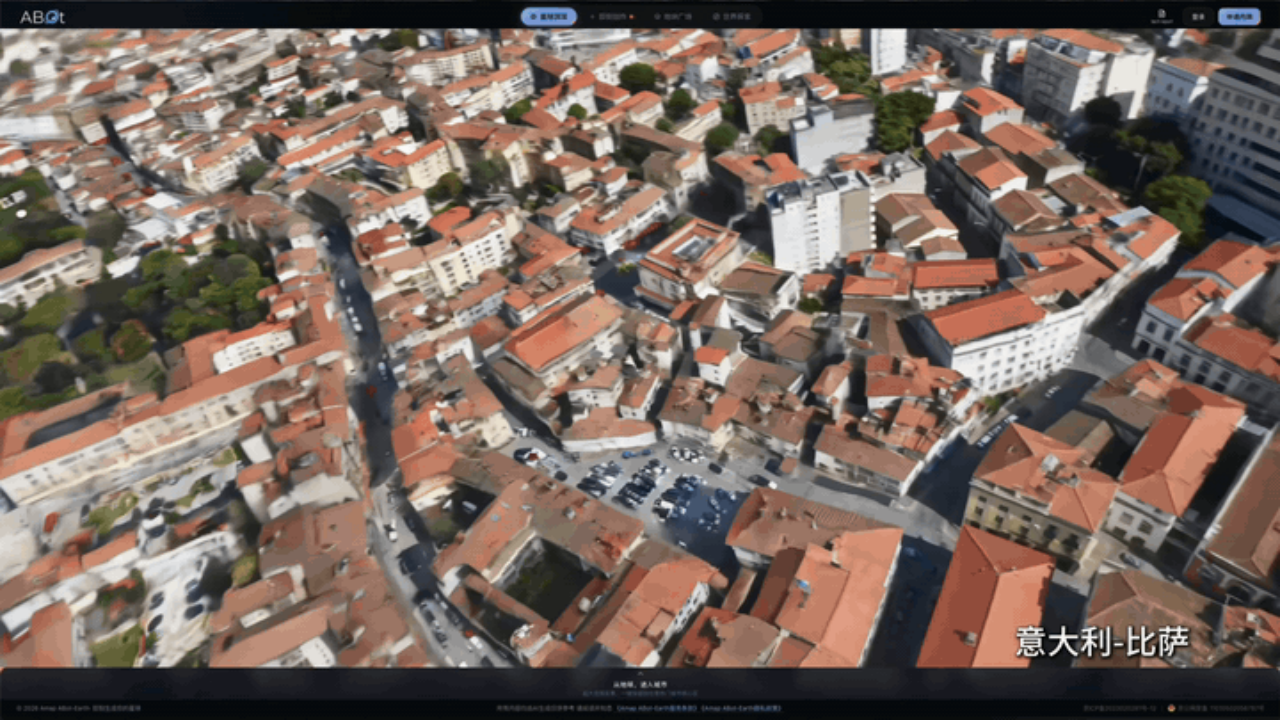
ABot-Earth 0.7可以从一张卫星图像或一段文字出发,
在单块消费级GPU上约10分钟生成公里级3D城市场景
,生成效率相比传统模式提升
1000倍
,并支持从
星球、城市一路到街景地标
的连续生成。
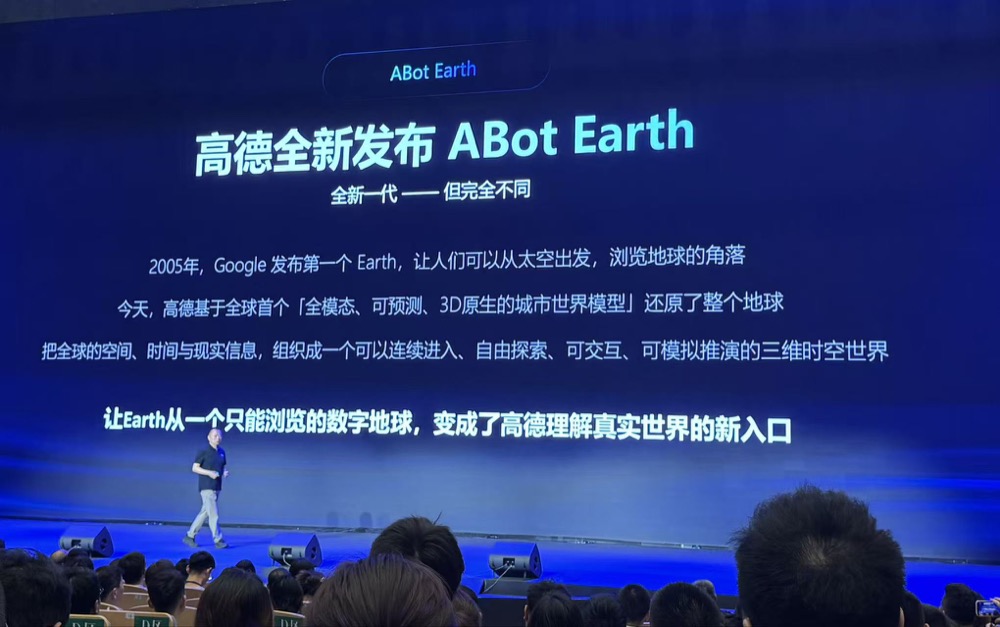
这是高德世界模型时隔约3个月的再次升级。6月8日,高德刚刚推出ABot-Earth 0.5,其已经构建覆盖190多个国家和地区的3D地图。
今天的0.7版本进一步覆盖超过196个国家和地区,并把重点从“大范围3D地图”推进到了
3D原生生成、自由探索和实时交互
。
现场,高德CEO郭宁率先登台,他提到:“大模型理解语言,高德空间智能理解世界。”
围绕这一思路,高德今天同时把多项空间智能能力装进了扫街榜:
飞行街景2.0
允许用户在出发前自由进入目的地的三维空间;
避雷指南
通过时空推演提前检查行程中的时间冲突、拥堵和闭店风险;
导航Live
则把实时感知、自然语言交互和导航连接起来,让AI可以在开车、步行、进入景区等不同场景间继续保持上下文。
这三项能力是高德扫街榜2026此次重点推出的AI原生服务。
一、世界模型再升级,消费级GPU 10分钟生成公里级3D城市
过去二十多年,数字地球主要依赖卫星影像、航拍、街景和点云等数据进行拼接和重建。用户看到的是现实世界被采集之后形成的数字版本,能够观看的位置、路线和角度,也往往受原始采集素材限制。ABot-Earth 0.7选择了不同的技术路径。
这款模型采用3D原生架构,直接使用包含空间、时间等信息的时空数据进行训练
,使模型建立对三维空间结构的理解,再
端到端生成3DGS
(3D Gaussian Splatting,三维高斯泼溅)格式的场景。
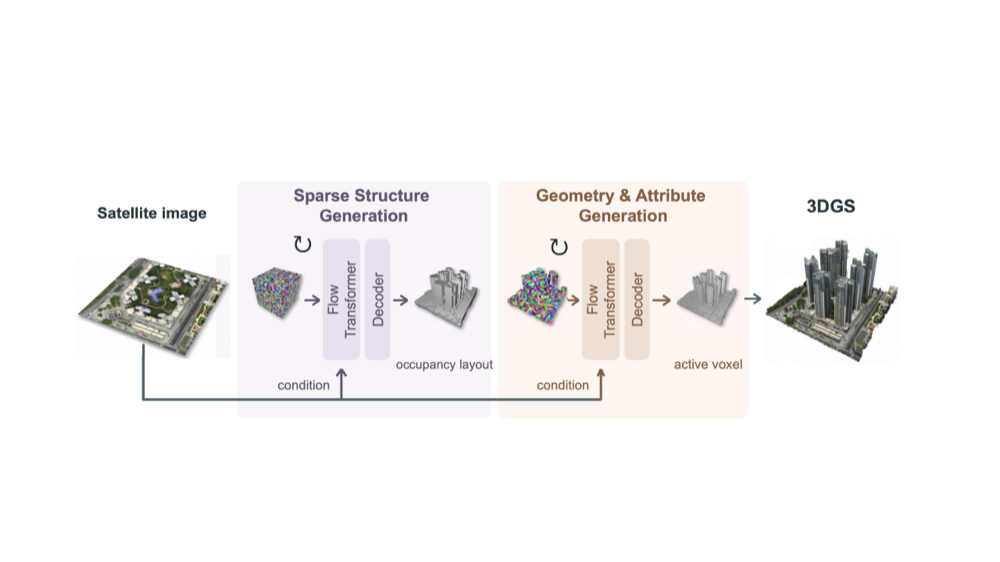
输入端则可以非常简单。用户只需要提供一张卫星图像或者一段文字描述,模型就可以生成完整的三维城市场景。
按照高德公布的数据,在一块消费级GPU上,生成一片公里级3D城市场景约需10分钟,效率相比传统方式提升1000倍。
除此以外,ABot-Earth 0.7可以用同一套模型覆盖从星球到城市,再到街景和地标近景的不同尺度。在城市尺度能够维持道路、街区、建筑群的空间关系,当镜头进一步推进到单体建筑附近,又可以补出建筑几何结构、立面和材质纹理。
二、世界模型进产品,买票前先“坐”进剧场
除世界模型之外,高德给出的第一个落地产品是
飞行街景2.0
。
今年1月,高德曾推出飞行街景1.0,让用户可以从第一视角浏览城市街区、查看道路和店铺。此次2.0版本进一步接入ABot-Earth 0.7,把原本相对固定的浏览过程变成一个可以自由控制的三维空间。
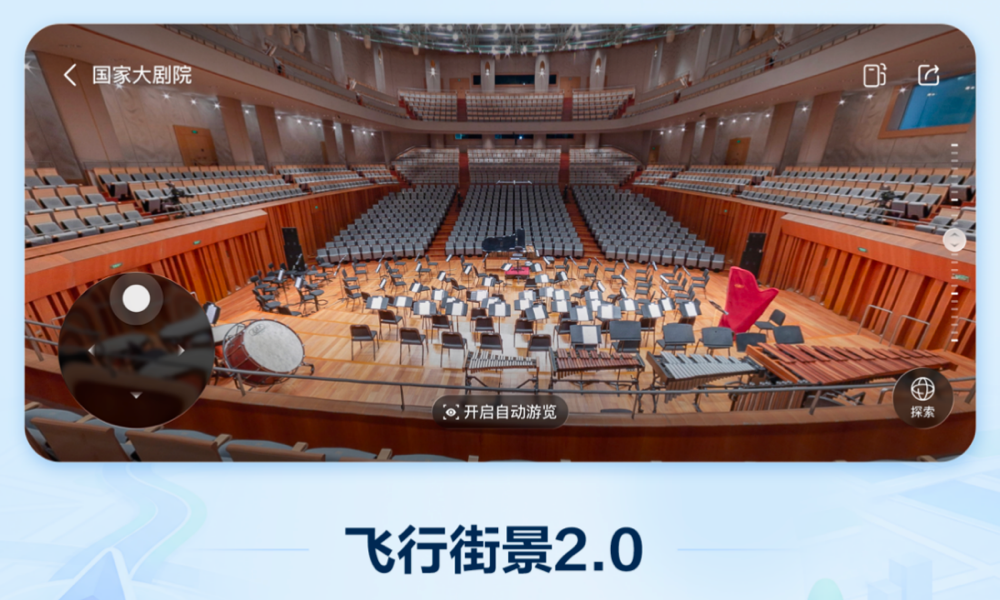
现场演示的一个场景是
购买演出票
。
过去买票时,用户看到的通常只有二维座位图,很难判断某个座位距离舞台究竟多远、视角是否偏斜。接入飞行街景2.0后,
用户可以提前进入场馆三维空间,自由切换不同座位的观看位置和角度,在买票前直接查看不同位置对应的空间视野。
类似能力还可以进入大型商场、景区以及结构更加复杂的建筑空间。
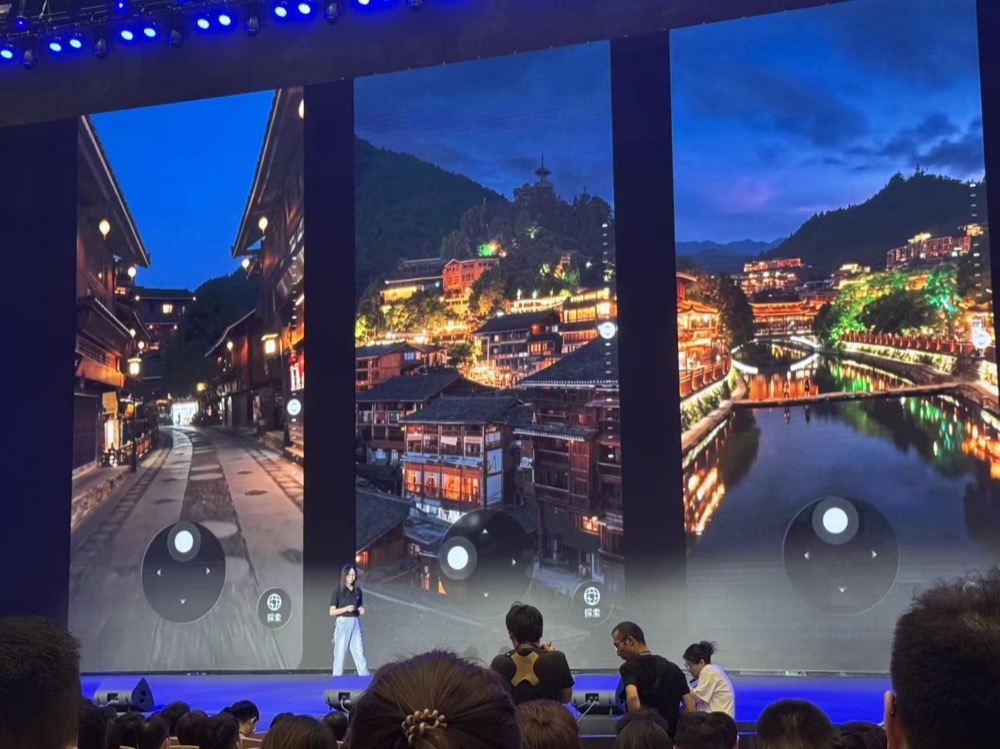
在ABot-Earth 0.7的框架下,
楼层、高度、坡度、室内外关系以及复杂动线等信息
被重新组织成三维空间。至此,用户的身体还没有真正出发,但可以提前进入目的地,对空间建立更加完整的认知。
三、导航Live来了,AI开始持续理解人和环境
除了生成三维世界,高德今天另一项AI方向,是让模型持续感知真实环境的变化。
高德新推出的
导航Live
支持
全双工自然对话、全模态空间理解以及跨场景连续导航
。
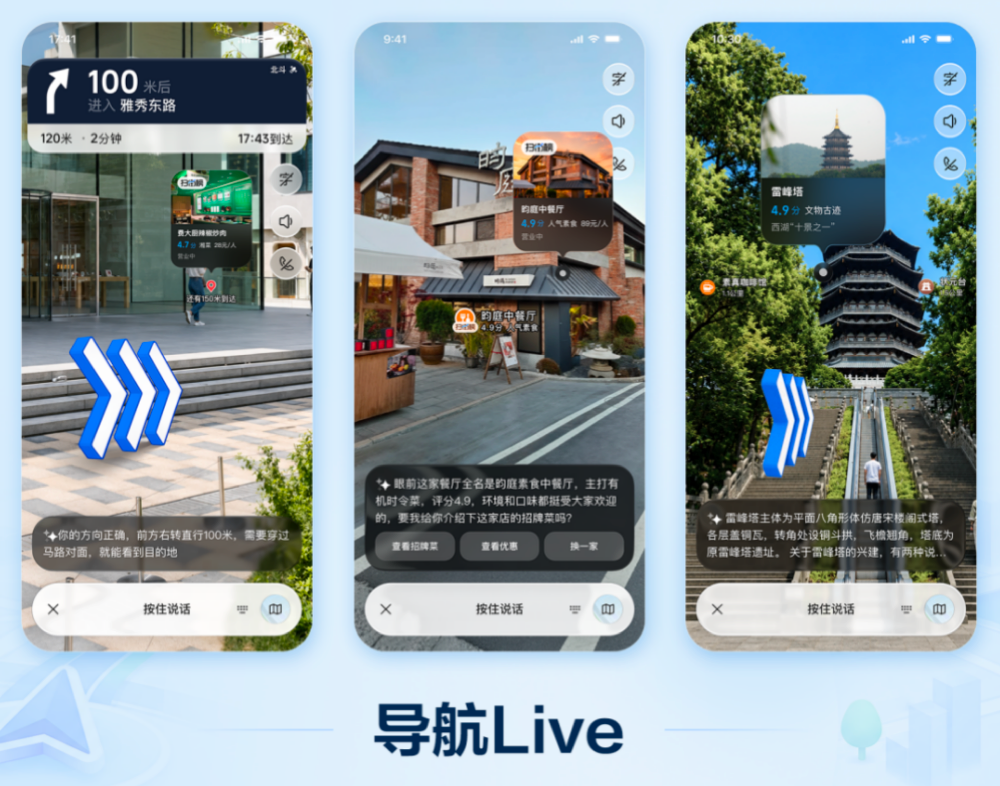
用户举起手机后,
摄像头可以直接参与环境感知
。高德将其形容为把镜头变成“真实世界的搜索框”:AI可以识别用户眼前的建筑、店铺、景点等内容,并结合当前位置继续提供导航和信息服务。
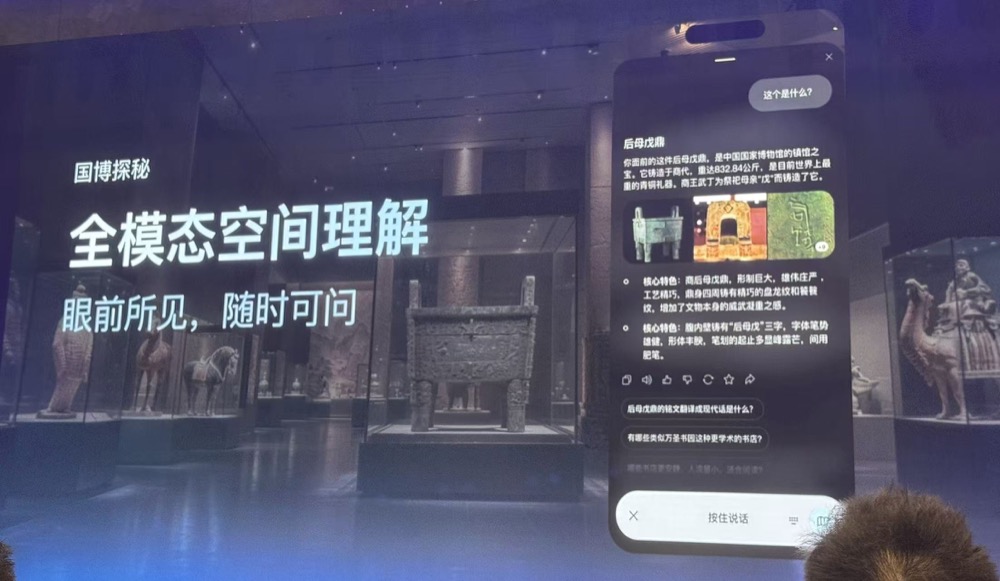
开车过程中,
导航Live也可以持续感知车辆周围环境
,对施工等情况进行识别和提醒;车辆停下之后,系统可以继续接力步行导航;进入街区后,还可以进一步提供实景指路、菜单识别以及文物古迹讲解等能力。
高德把导航Live定位为一个具备空间感知和行动能力的
长程智能体
。这里和普通对话式AI一大不同,是其
在上下文里增加了现实世界的空间和时间信息。
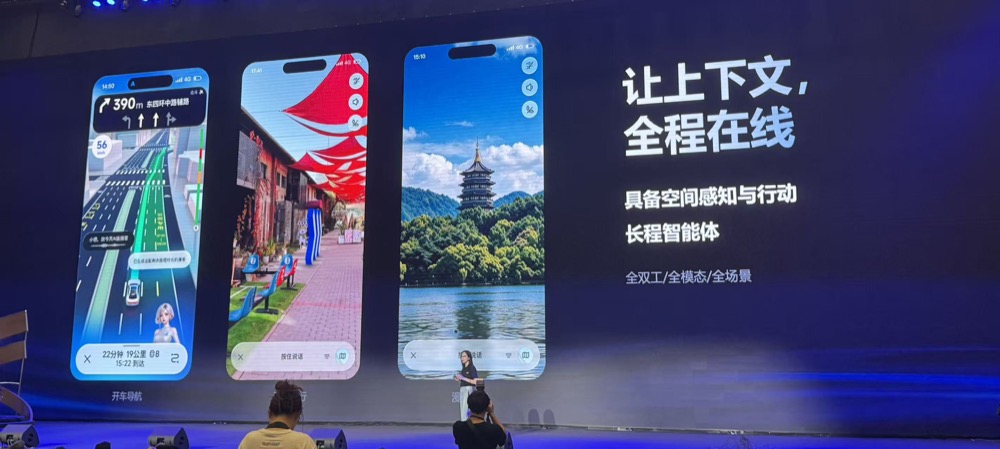
例如人在车内询问一个问题时,系统不仅要理解语言,还需要知道车辆在哪里、道路当前发生了什么;下车之后,用户所处空间发生变化,但此前的目的地、需求和行程不能因此丢失。
四、AI生成攻略容易?导航先替用户“跑”一遍
高德此次还推出了
避雷指南
。
这项能力将
实时动态感知和时空推演
结合起来,从营业时间、行程节奏、停车、拥挤程度等15个维度检查整段行程,提前识别时间冲突、道路拥堵、闭店等风险。
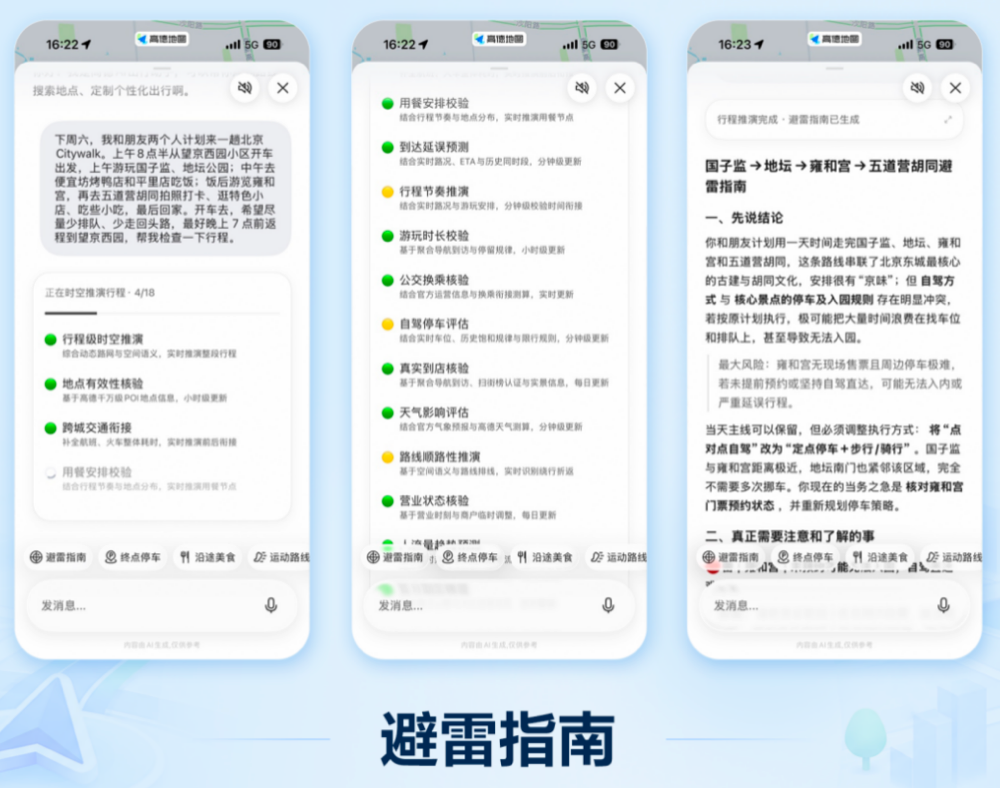
在现场,高德就拿旅游攻略举例。
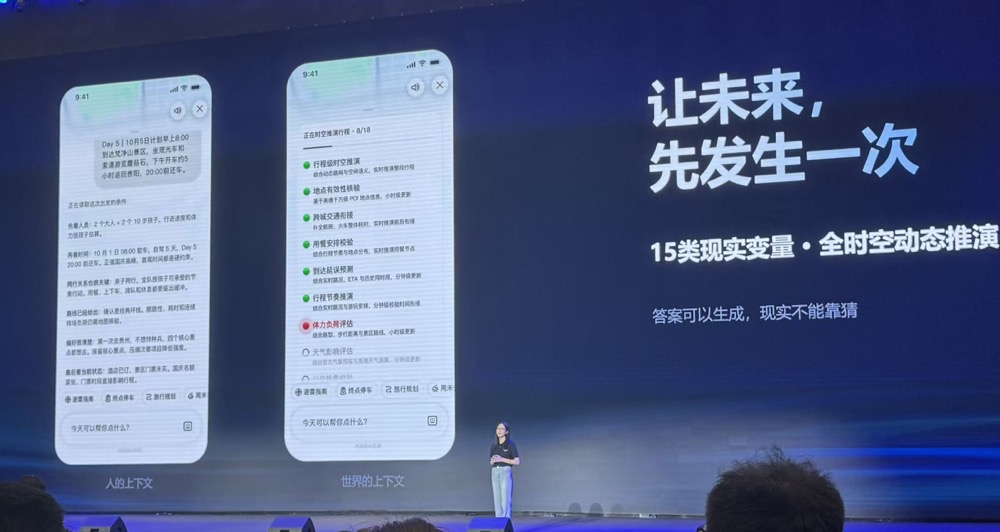
通用大模型可以非常快速地根据目的地、日期、人数生成一套行程,但一旦把假期拥堵、景区预约规则、同行人员体力等真实条件加入进来,原本排得严丝合缝的行程可能就会失败。
高德的思路是把“人的上下文”和“世界的上下文”一起参与计算。
前者包括出发时间、同行人员、老人儿童等个人条件;后者则涉及历史路况、天气、景区饱和度、停车情况以及开放规则等动态变量。当其中一个环节发生变化后,系统再对后续预约、路线以及替代方案重新计算。
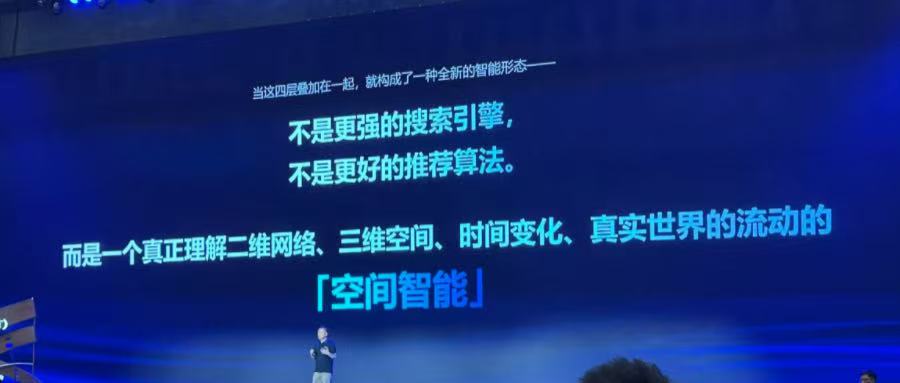
五、从3D生成到时空推演,空间智能拆出三层能力
围绕ABot-Earth 0.7,高德今天也第一次更加完整地解释了自己对“空间智能”的理解。
高德将其拆成三层能力。
最底层是
三维空间表达
,也就是把从地球、城市、道路到建筑、室内的空间结构数字化;
再往上是
动态感知
,持续理解车流、人流、路况、商户以及昼夜变化;
最上层则是
时空推演
,把用户、环境和时间放进同一个系统中,预测接下来可能发生什么,并据此进行决策。
ABot-Earth 0.7承担的是三维世界表达这一层。
而高德过去20年积累的导航、定位和时空数据,则被用于继续向动态感知和时空推演延伸。高德披露,其日调用北斗卫星定位峰值已接近万亿次,服务范围覆盖全球200多个国家和地区。
这些能力目前也正在
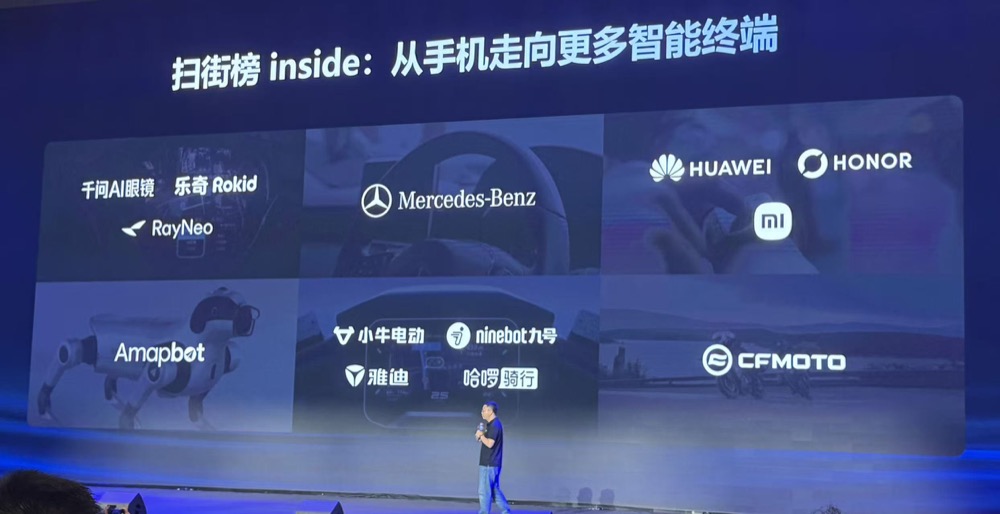
从手机延伸到车机、智能眼镜、智能手表和具身机器人
等终端。会上,高德还宣布梅赛德斯-奔驰成为扫街榜全球首个汽车合作伙伴。
结语:世界模型走出Demo,开始进入真实出行
世界模型正在成为今年AI行业里越来越热的方向,但不同公司的切入点正在明显分化。高德此次给出了另一条路线:利用长期积累的真实时空数据,把3D世界生成、实时动态感知和时空推演连接起来,再直接装进地图和导航产品。
接下来更值得观察的是,这套空间智能在复杂真实环境中能否持续保持空间一致性、实时更新动态信息,并稳定完成长时间跨度的推演和交互、真正进入物理世界。


