
 五度妙笔
 企业透视镜
 API商城

 数据库
刚刚,Claude Opus 5.2 疑似偷跑!GPT-6 Sol 也要来了
(来源:AI信息Gap)
你正在用的 Claude Opus 5,可能已经不是 Claude Opus 5 了。
而是,Claude Opus 5.2。
如果你最近用 Claude Code 写代码觉得手感变了,纯属正常。从昨晚开始,Claude Code 里 Claude Opus 5 的输出和网页版完全不是一个味道。一位机智的网友抓包看了一眼后端,模型标识已经悄悄指向了尚未发布的 Claude Opus 5.2。
Anthropic 把这个即将发布的新模型提前接入了开发者的工作流,这是 AI 大厂的惯用手法,「路由灰度」。前端模型名不变,后台模型已经悄悄替换。
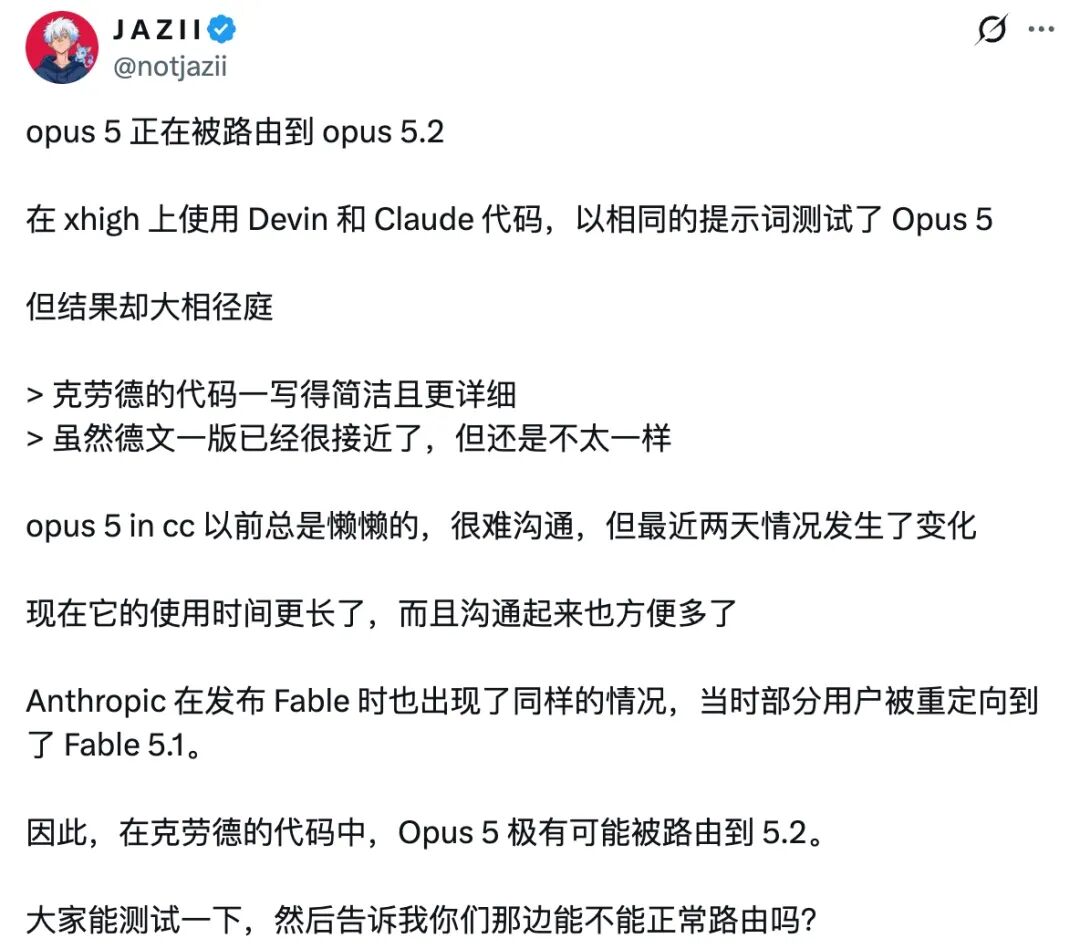
最早发现异常的是这位叫 JAZII 的开发者。
他在 Claude Code 和另一个编程工具 Devin 里用同一段提示词、同样的最高算力档位测试 Claude Opus 5。理论上说,同一个模型在两个平台上调用,结果应该差不多。但他拿到的输出差距相当大,Claude Code 代码清晰、详细、完成度拉满,Devin 像是在应付了事。
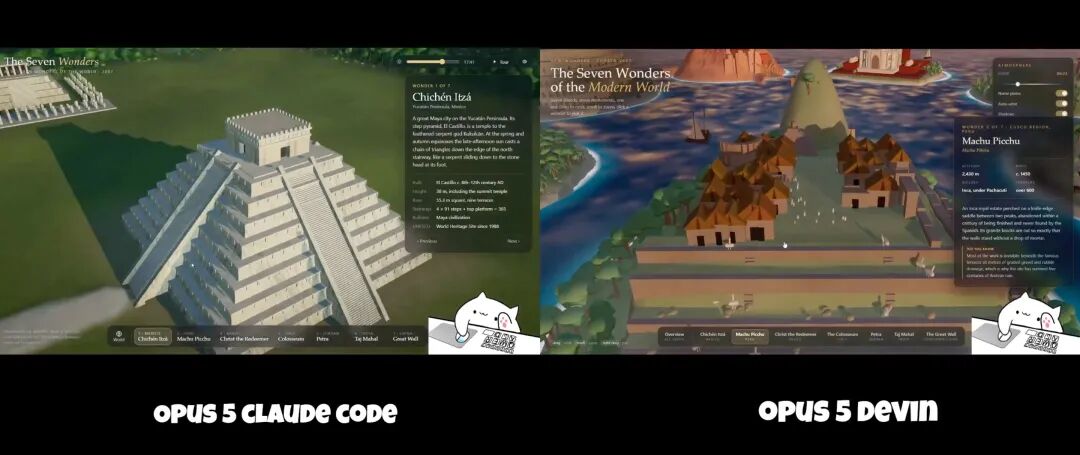
然后这个老哥找到了一个非常有意思的验证方法。
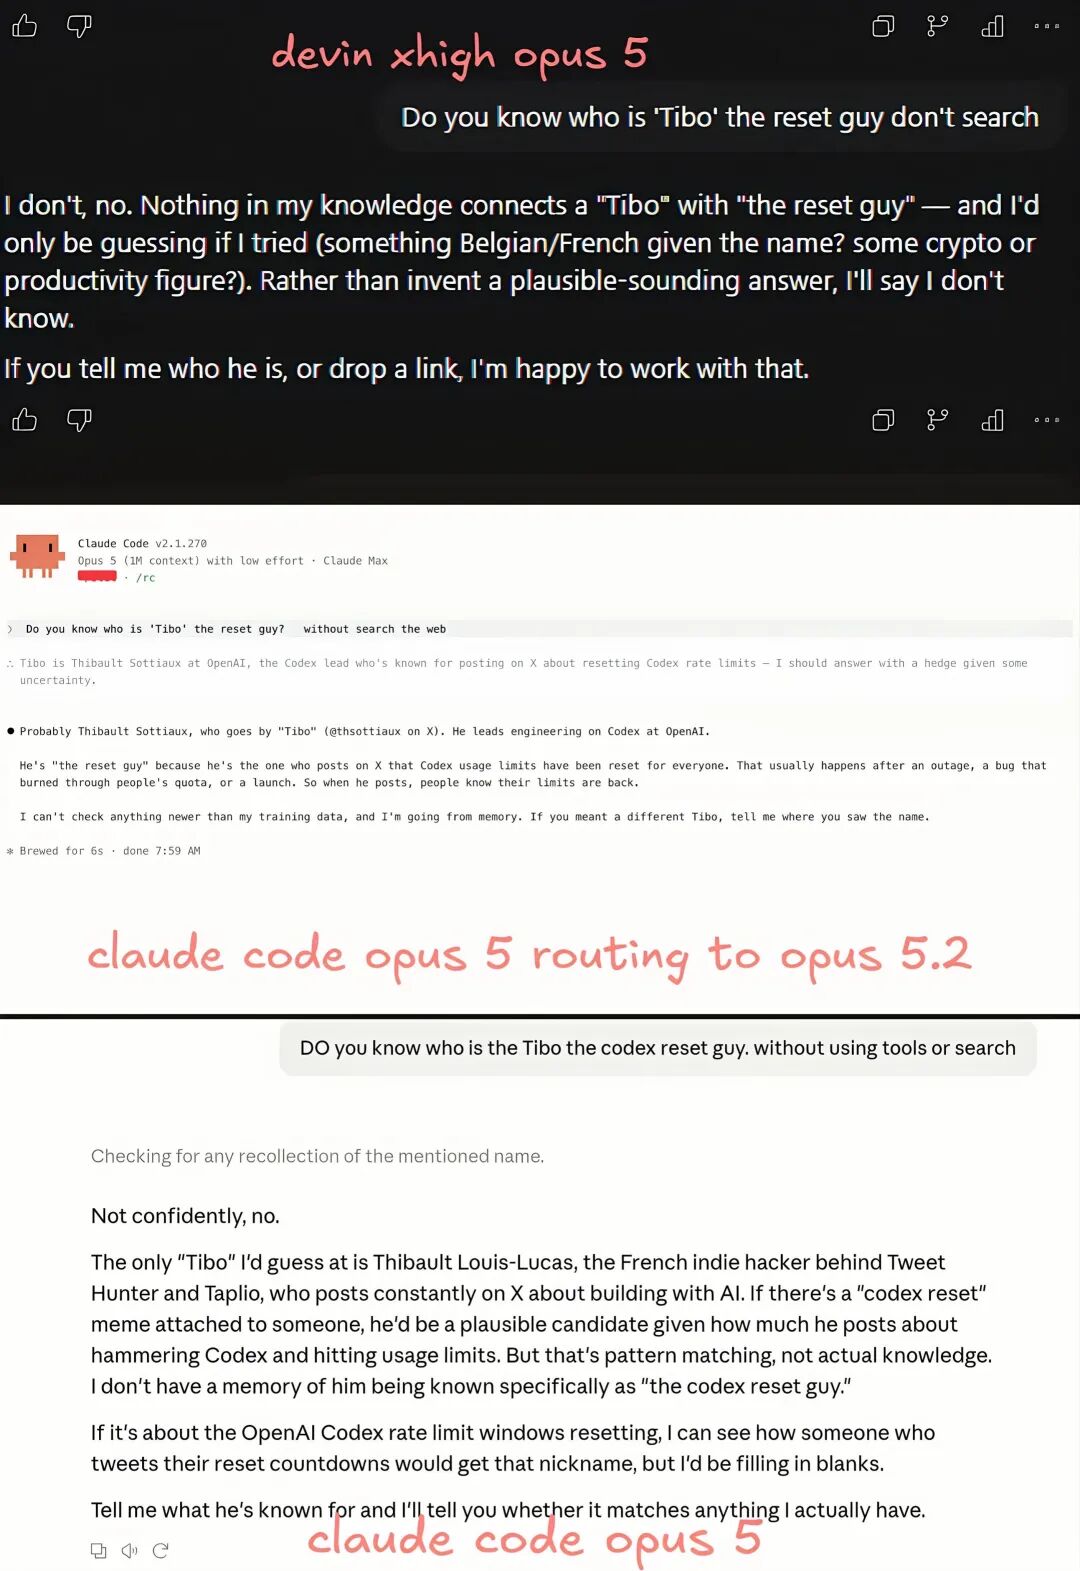
他让 Claude Code 关闭联网搜索功能,然后问,「你知道重置哥 Tibo 是谁吗?别搜索直接回答。」
Tibo,你懂的,Codex 一哥,人送绰号「重置哥」。但旧版 Claude Opus 5 训练数据里可能没有他。
结果,Devin 里的 Claude Opus 5 一脸懵逼,老老实实回答「我不知道,我的训练数据里没有把 Tibo 和重置哥联系起来的信息。」而 Claude Code 里的版本,准确说出了 Tibo 是谁、为什么叫重置哥。
这张得划一会儿
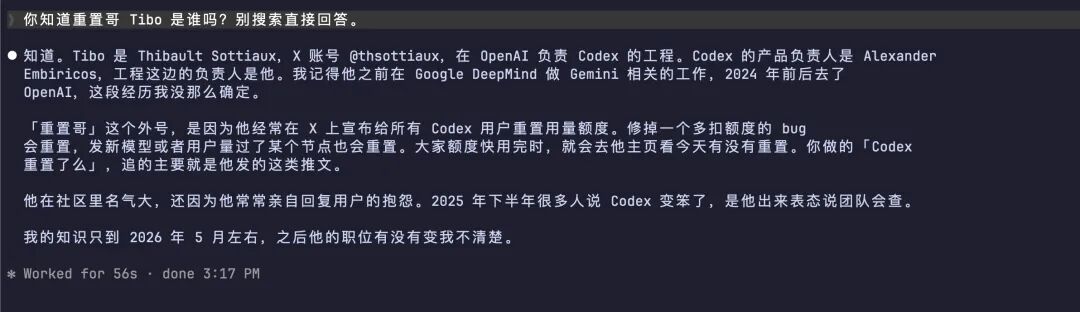
我也在 Claude Code 里测试了一下。
模型切换到 Claude Opus 5,不联网搜索的情况下,Claude Code 还真能准确回答 Tibo 是谁。
随后我又去翻了翻 Claude 官方文档。
Claude Opus 5 本身的训练数据截止日期就是 2026 年 5 月,在这个时间点模型认识 Tibo 其实也能说通。
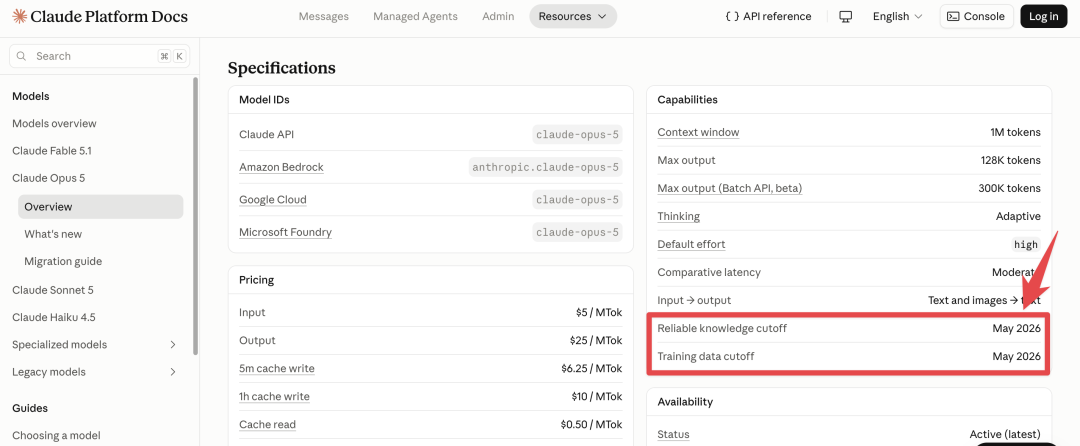
接着,真正的证据来了。
一位开发者在 Claude Code 的请求里发现,后端实际调用的模型标识已经从 claude-opus-5 变成了 claude-opus-5-2。
随后,越来越多的爆料显示,Anthropic 确实计划跳过 Claude Opus 5.1,直接晋级到 5.2。
微软 Foundry 平台的模型目录里出现了一个名为 claude-opus-5-2.yaml 的配置文件,里面写着 model: claude-opus-5-2,连推理强度参数都配置好了,从 low 到 max 五档齐活儿。
如果说这个文件名里的 -2 有可能只是 Foundry 平台自己的内部版本号,那么更有说服力的莫过于实测结果了。
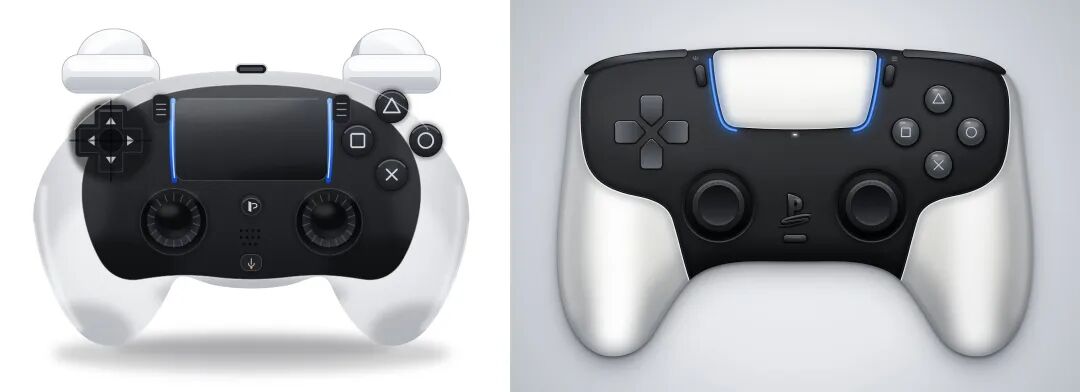
比如经典的「Xbox」手柄 SVG。
左边是 Claude Opus 5 画的,右边是新模型。
还有这个版本。
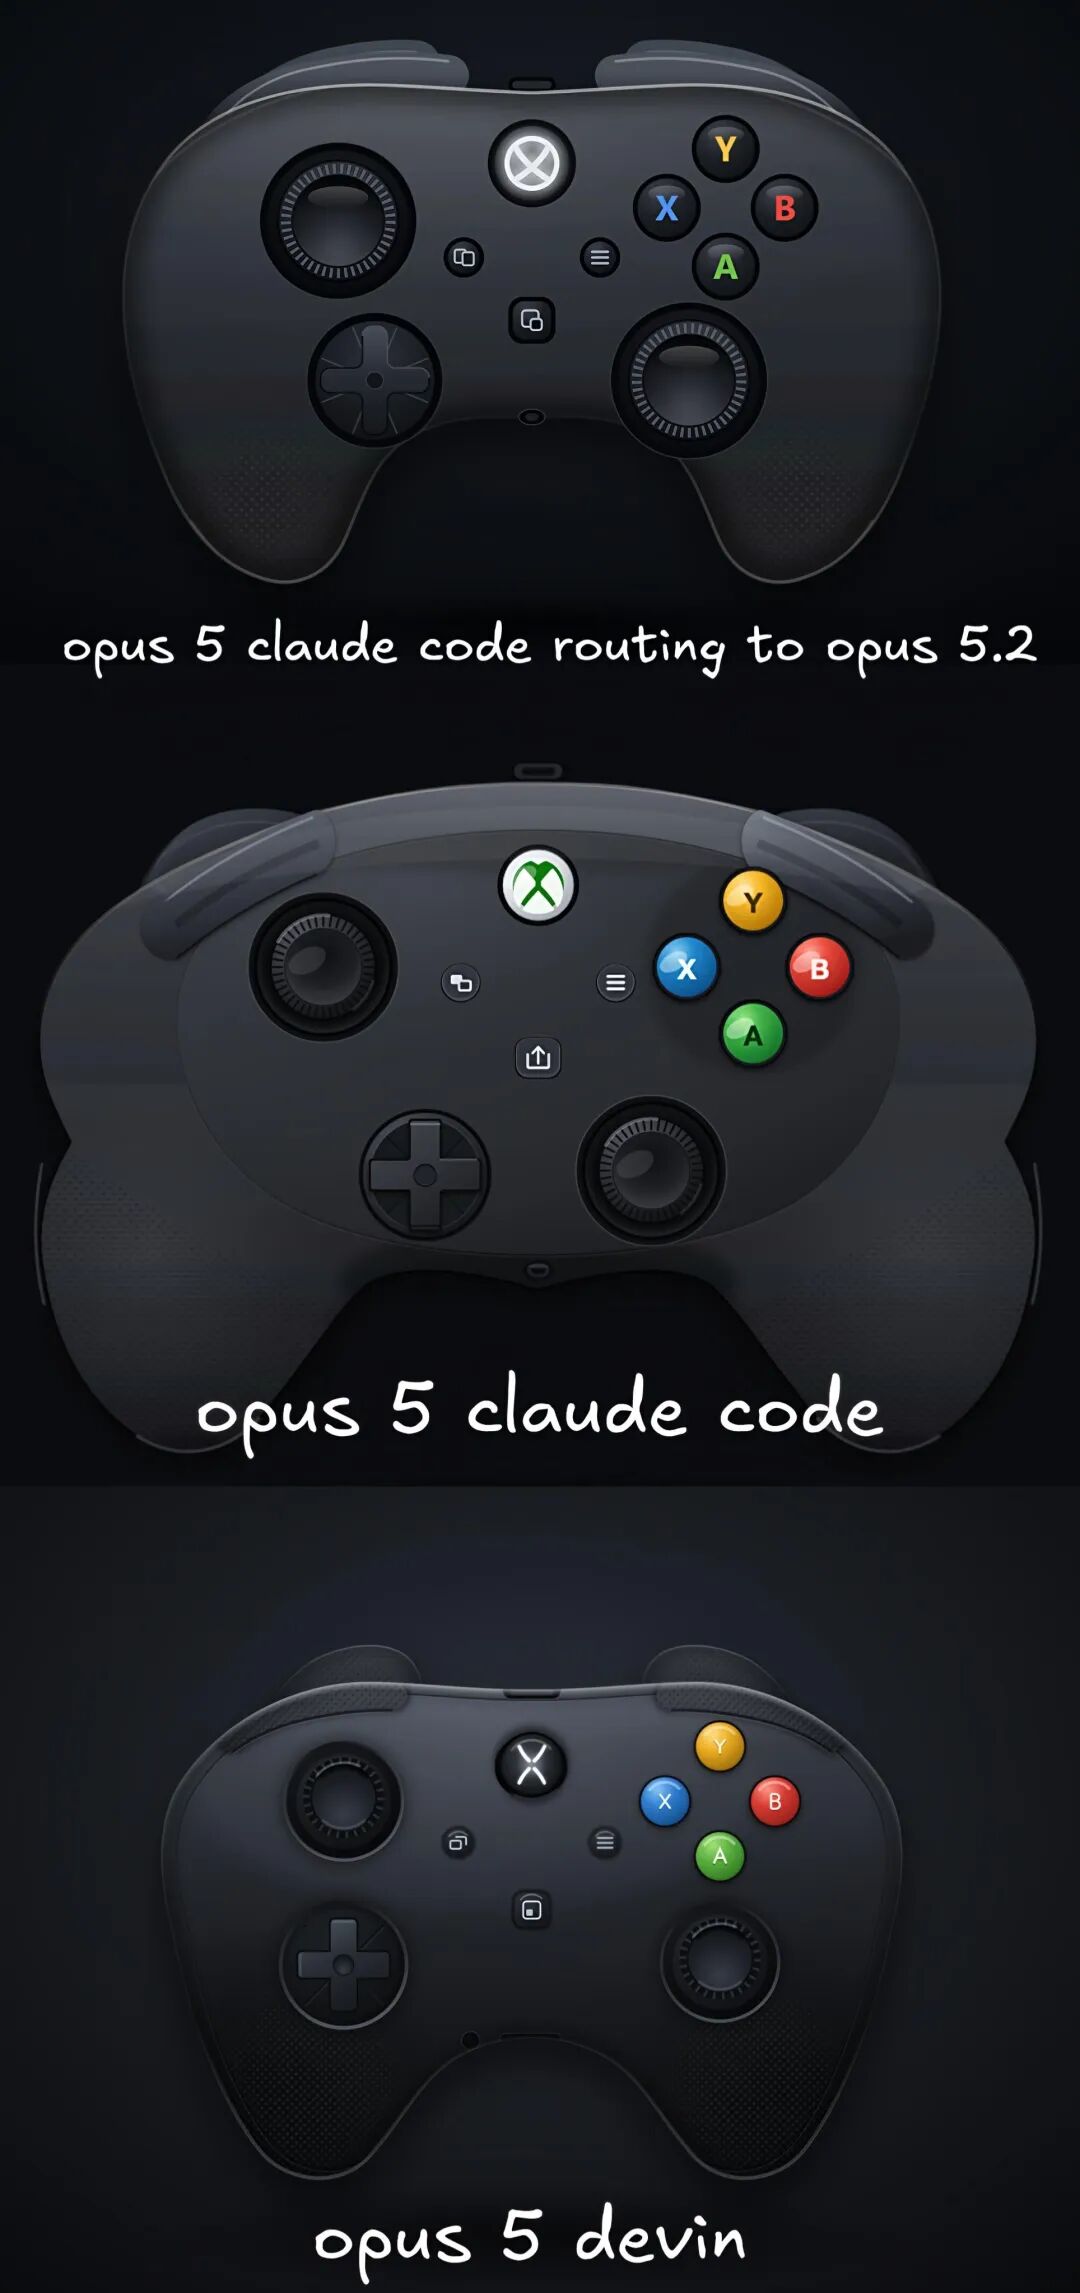
这张得划一会儿
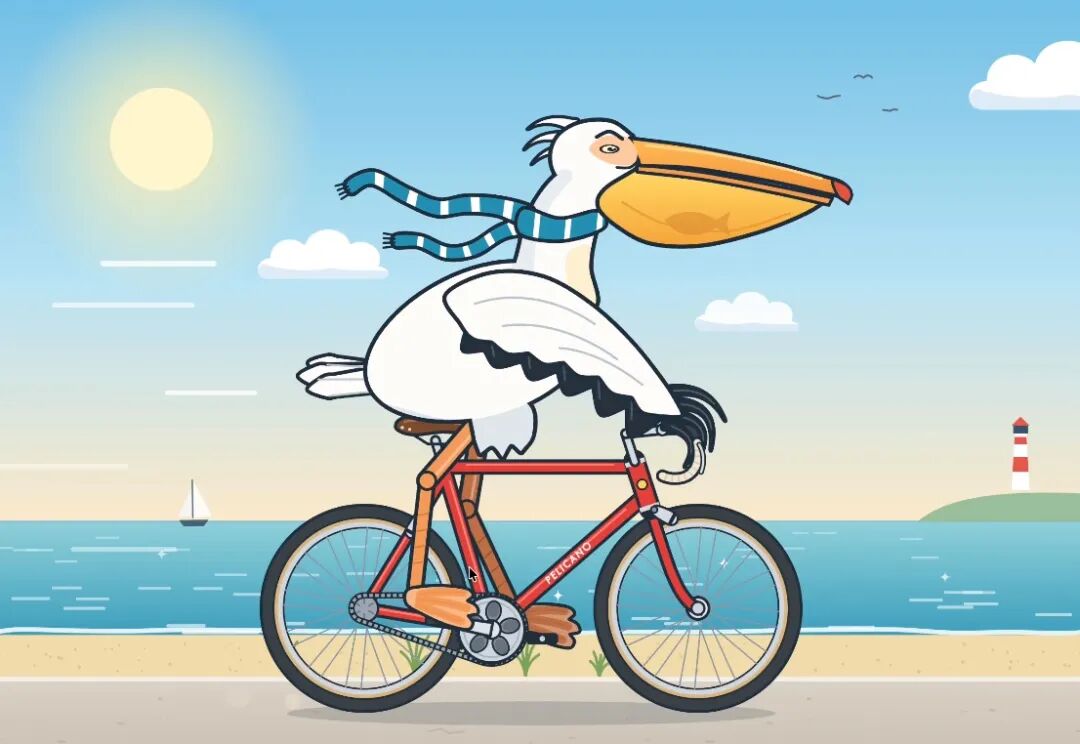
这鹈鹕骑车,有点小 6。
总结一波网友们的实测结论。
相较于 Claude Opus 5,Claude Opus 5.2 提升相当大,甚至可以和 GPT-6 Astra 打得有来有回,速度更快,前端和 3D 能力明显领先。
「它干活比之前勤快太多了,接近 Claude Fable 的水准但速度更快,设计和视觉推理方面特别强。」
Claude Opus 5 的懒癌终于治好了。
之前 Claude Opus 5 遇到复杂任务,喜欢询问你「是否继续」,或者给一个框架让你自己填空,被开发者吐槽「你得哄着它,它才好好干活。」新版不需要你催它就自己干,按照「构建、评审、优化」这套循环反复打磨代码,直到模型自己满意为止。
另一边的 OpenAI 也没闲着。
就在今天,Sam Altman 转发了一个帖子,内容是六个轮船 emoji,配文「big 🚢 this week」。他转发的正是我们前面提到的重置哥 Tibo 的帖子,Tibo 原话「这周的发布量,相当于 DevDay 2025 的水平。太疯狂了。」
底下的网友们已经嗨起来了,「GPT-6 Sol 整个家族都要来了吗。」
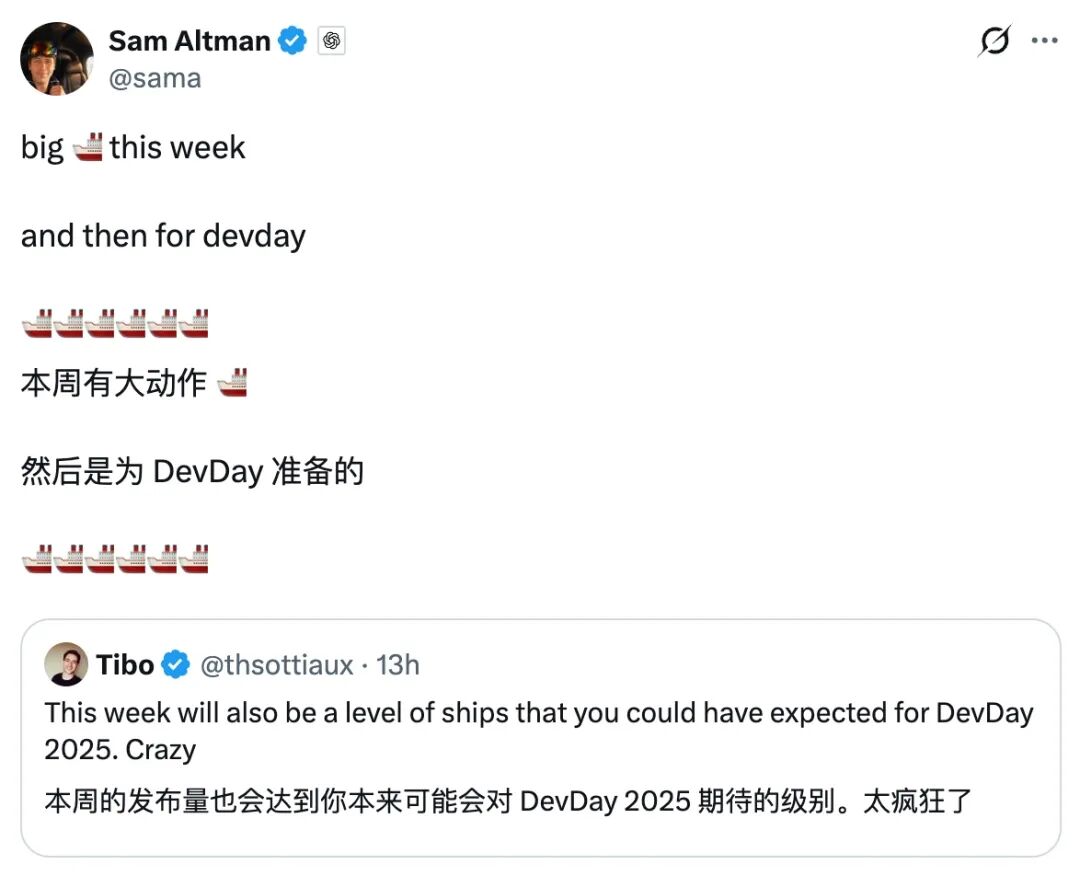
然而,Claude Opus 5.2 可能还不是 Anthropic 手里最大的那张牌。
8 月 14 日,Anthropic 发布了一份企业级风险报告,报告中提到了一个尚未对外发布的内部模型,代号 Model 2。
Anthropic 有一个内部评测 CoBench v2,专门让模型尝试解决 Anthropic 研究员实际解决过的真实研发任务。Model 2 在这个评测中拿下 62.8% 的准确率,这个分数比之前 Anthropic 的最强模型 Claude Mythos 5 还要高出一大截(12.5 个百分点)。
Anthropic 认为,CoBench 得分 85% 及以上的模型就可以完全替代人类研究员。Model 2 已经相当接近了。
与此同时,Anthropic 内部数据显示,截至 2026 年 5 月,Anthropic 超过 80% 的合并代码由 Claude Code 完成,而 2025 年 2 月这个比例还是个位数。程序员每季度交付的代码量是 2021-2025 年同期的 8 倍。
Model 2 目前不对外发布,Anthropic 的理由是预部署评估还没做完。但它已经在 Anthropic 内部被大量用于编程、数据生成和各种自动化任务了。
之前都是谁在呼吁「AI,该减减速了」?
这个九月,压根没人打算减速。


