 五度妙笔
 企业透视镜
 API商城

 数据库
15秒视频,54秒生成!AI视频创作的“等待焦虑”,被RunningHub这套开源方案治好了
智东西(公众号:zhidxcom)
作者 | 杨京丽
编辑 | 李水青
智东西9月11日报道,上个月,MiniMax开源通用视频模型
MiniMax H3
。在第三方评测平台Artificial Analysis上,该模型一度
登顶有声视频编辑榜榜首
,Elo得分达到1130。凭借开放权重、视频生成质量和性价比,H3很快在开发者社区
内衍生出大量适配和新玩法
。
模型开源解决了“能不能部署”的问题,但距离真正真正进入创作流程,中间还有一道
速度门槛
。对于需要反复调整画面的创作者来说,生成速度直接影响创作节奏。
针对这一痛点,RunningHub近期推出并开源了H3视频生成加速方案
H3 Lightning
。在一组5秒视频生成对照测试中,RunningHub将H3的生成耗时
从348.8秒缩短至28.7秒
,整体推理速度达到基础方案的约
12倍
,等待时间减少约
92%
。
目前,相关技术方案和复现说明已经在GitHub公开。有多卡设备的用户可以参考方案进行
本地部署
,没有设备的普通创作者也可以
直接在RunningHub上使用
。
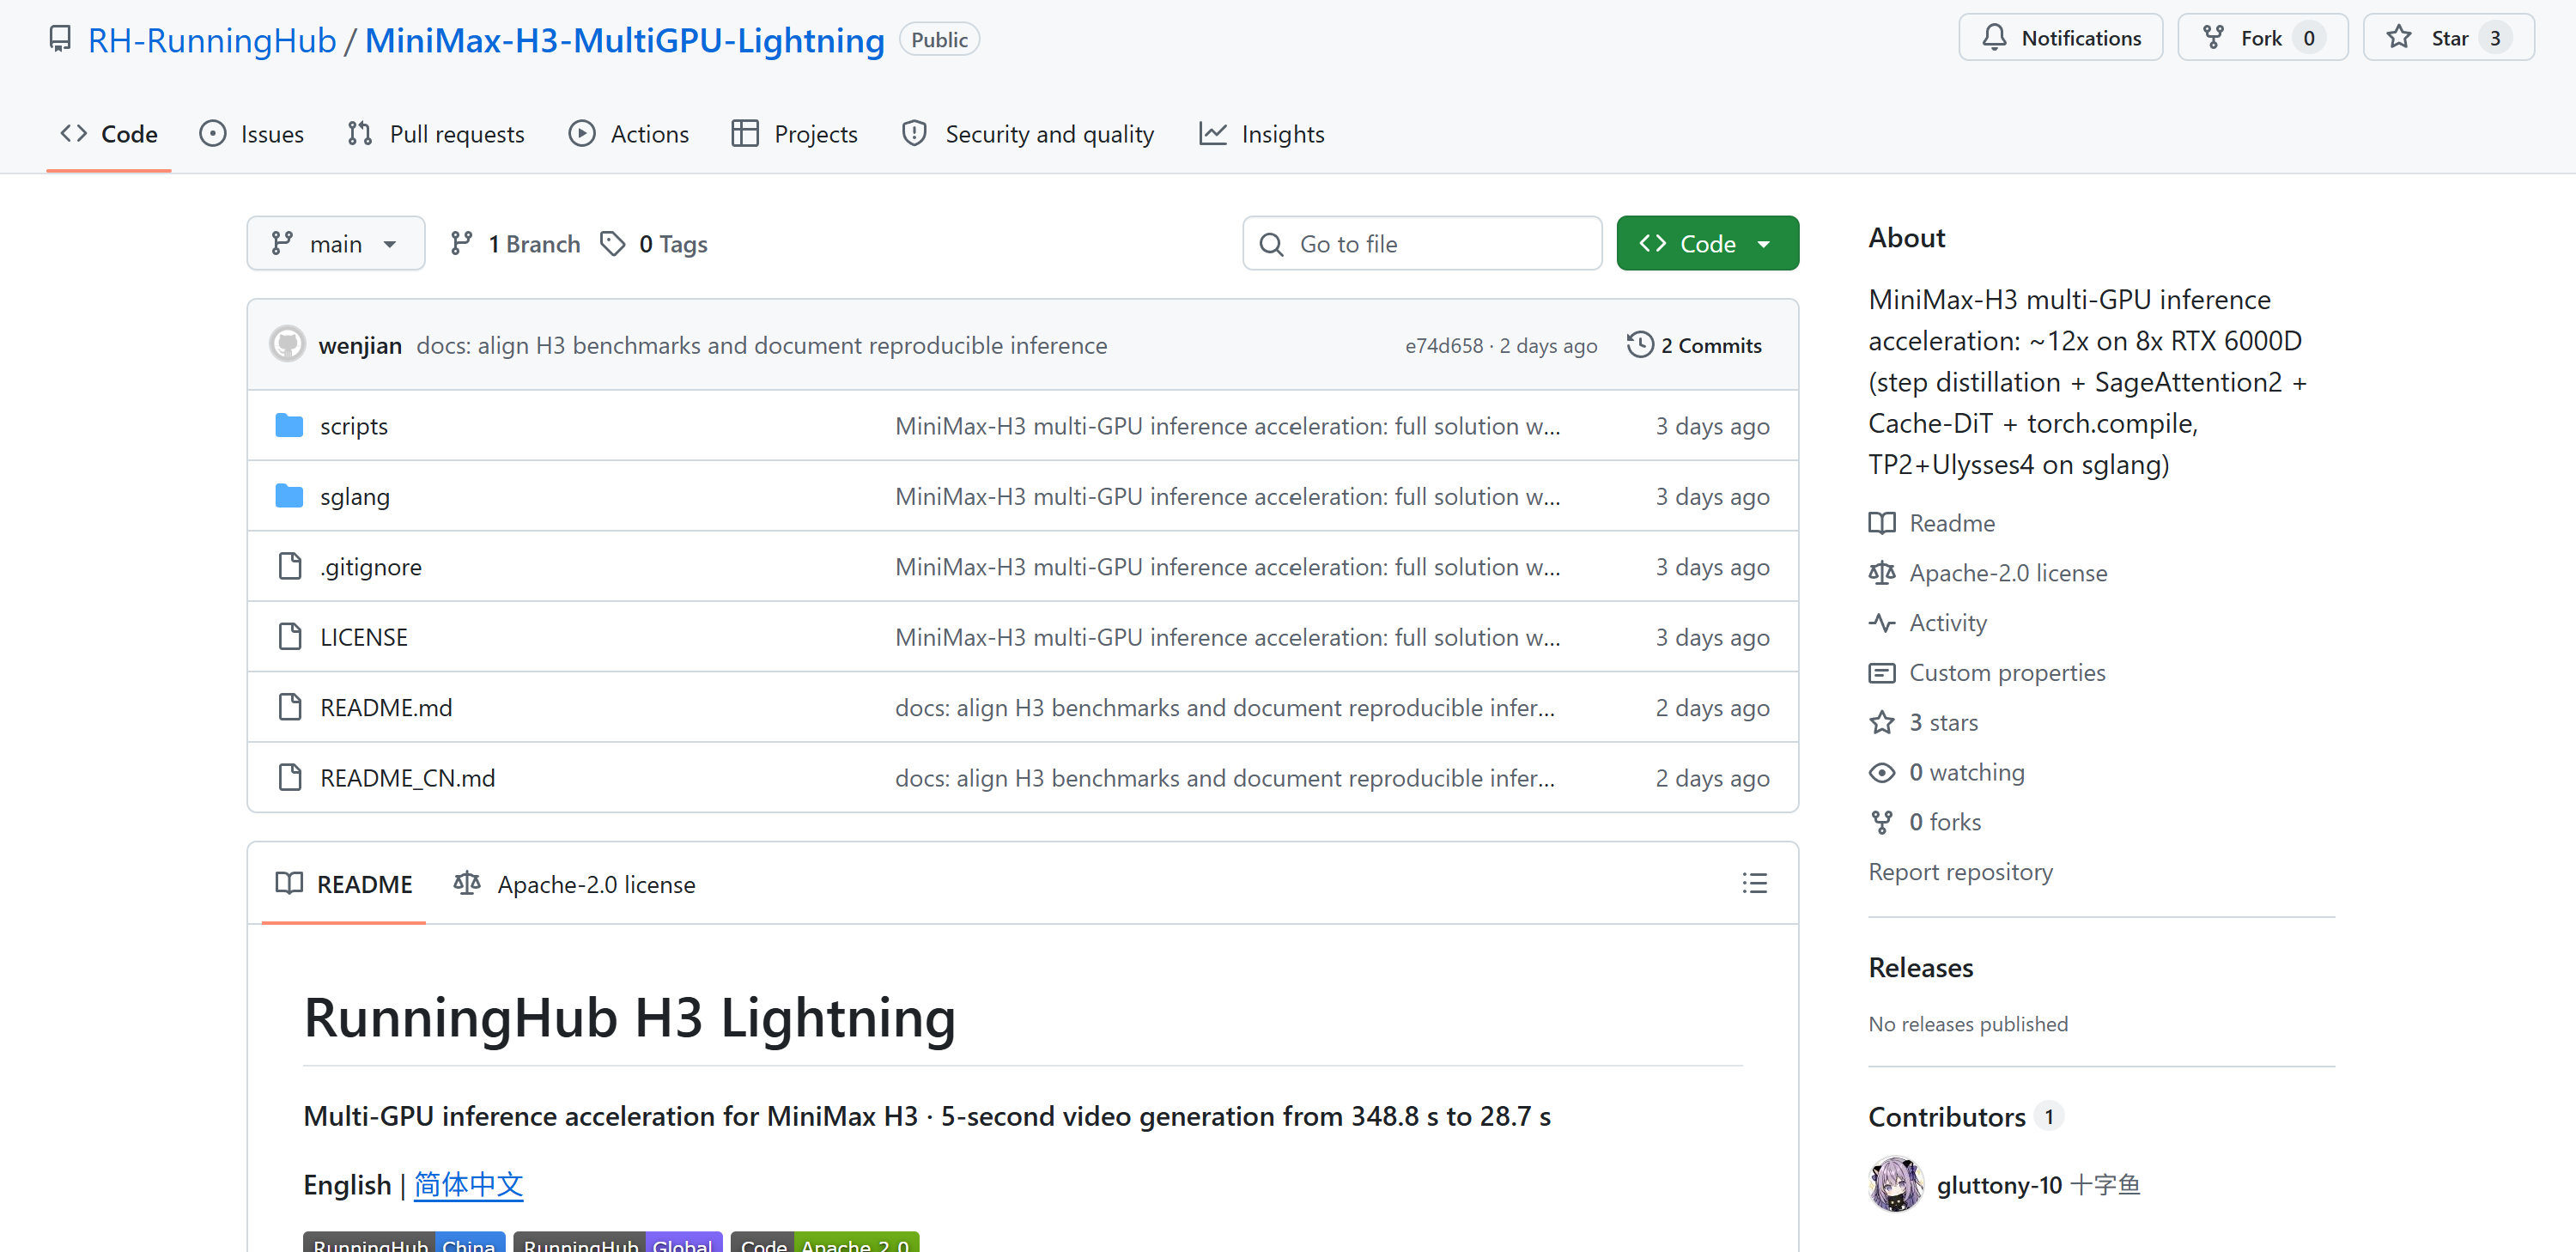
项目开源地址:
一、5秒视频不到半分钟生成,等待时间减少92%
H3开源后迅速受到创作者关注,但实际部署后,一个问题随之显现:模型权重虽然可以下载,生成速度却依然影响使用体验。
在RunningHub的一组对照测试中,测试环境配备
4张NVIDIA RTX 6000D
专业显卡,生成一段5秒、1344×768分辨率的视频。采用BF16基础方案,完成这一过程需要50步,耗时348.8秒,
接近6分钟
。
RunningHub首先引入
RH后训练加速模型
,将生成步数
从50步压缩至9步
,用更少的计算轮次完成视频生成。在这一配置下,生成耗时
缩短至60秒
,速度达到基础方案的
5.8倍
。
在此基础上,RunningHub进一步
叠加算子和编译优化
,将生成耗时继续压缩至
28.7秒
。相较基础方案,整体推理速度
提高约12倍
,等待时间
减少约92%
。
为验证这一能力,智东西也在RunningHub平台进行了测试,我们先让H3生成了一段
5秒的视频
,内容是一只流浪猫吃猫粮,平台用时
28秒
完成生成,整体过程较为流畅。
▲5秒视频生成用时28秒(生成过程经倍速处理)
随后,我们提高测试难度:
将视频时长增加到15秒
,让模型生成一段发生在高级餐厅的都市短剧,角色变多、还加上了台词。
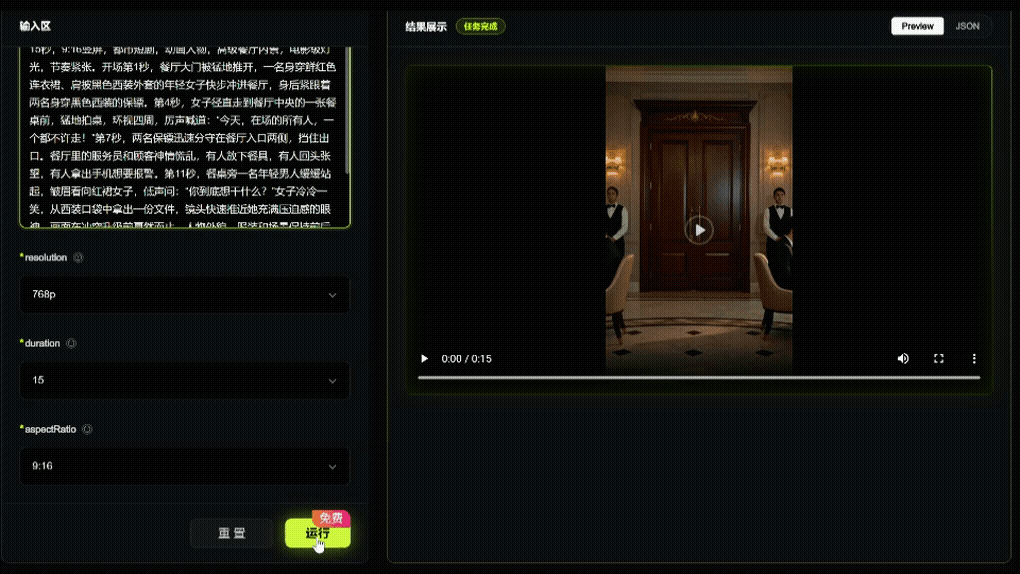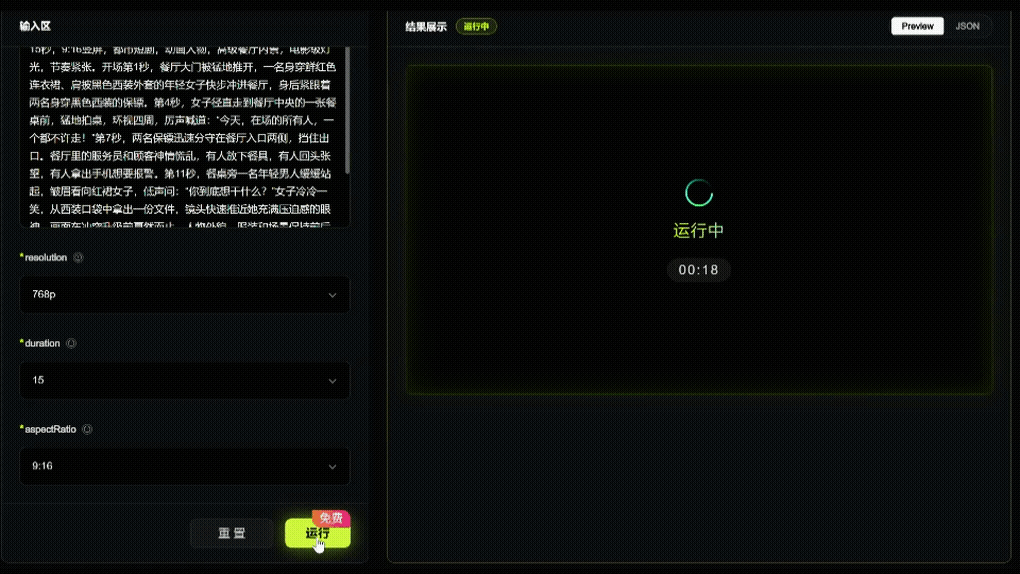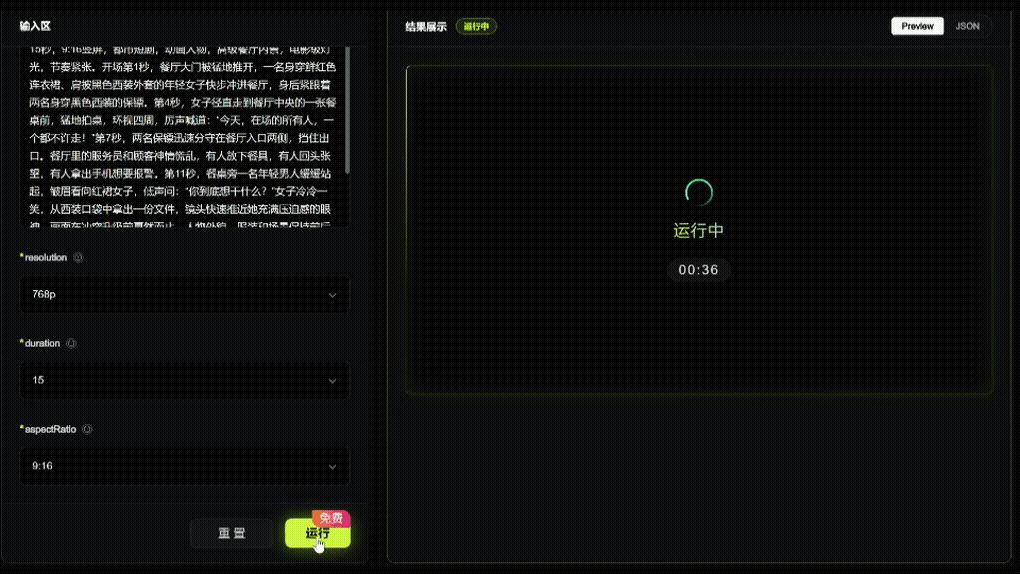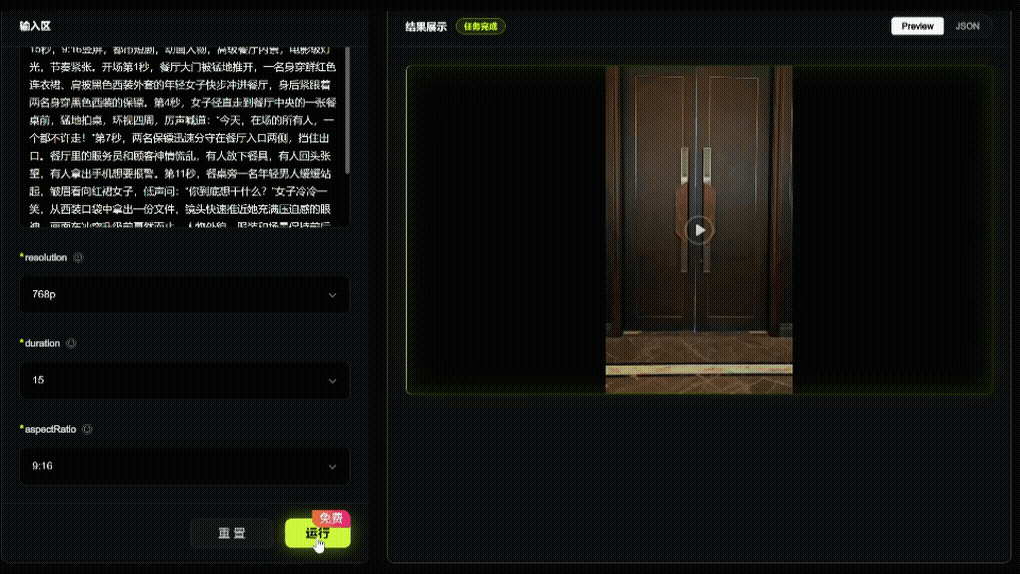
▲15秒视频生成用时54秒(生成过程经倍速处理)
这段视频用时
约54秒完成
。视频中,一名身穿红裙、披着西装的女子带着两名保镖愤怒地冲进餐厅,宣布“在场的所有人,一个都不许走”,现场气氛迅速变得紧张。实测来看,画面整体完成度较高,角色
动作衔接自然
,
人物表情
能够配合情节变化,
台词、口型与画面基本匹配
,声音也较为清晰,很有短剧的感觉。
除了文生视频,RunningHub这套加速方案还可用于
多参考图视频生成
。在另一组测试中,RunningHub使用
8张RTX 6000D
显卡,以4步生成15秒、768×1344分辨率的竖屏视频。其中,文生视频耗时约
48秒
,根据两张参考图生成视频耗时约
73秒
。
值得注意的是,H3 Lightning在提高速度的同时兼顾生成效果,
仍保留BF16数值精度
,且各项配置均经过组合测试和画质验收。
生成时长缩短,意味着创作者可以更快看到生成结果、调整提示词并尝试下一个版本。对于依赖反复迭代的AI视频创作,单次等待时间的缩短,最终会转化为整个
创作流程效率的提升
。
二、从50步压到9步,三层优化实现12倍提速
从近6分钟缩短至不到30秒,背后是一套覆盖
模型计算和硬件协作的系统优化
。
首先,视频生成需要经过多轮计算逐步形成画面,通常生成步数越多,耗费的时间越长。RH后训练加速模型将
对照测试的生成步数从50步压缩至9步
,使耗时由348.8秒缩短至60秒,率先
实现5.8倍提速
。
减少生成步骤之后,RunningHub继续
提高剩余计算的执行效率
。
SageAttention2
用于加快注意力计算,
Cache-DiT
通过缓存复用部分中间结果,减少后续步骤中的重复计算,
torch.compile
则对模型的计算流程进行编译优化,使其以更适合GPU的方式执行。
三项技术与RH后训练加速模型叠加后,5秒视频的生成耗时由60秒进一步
缩短至28.7秒
,相较BF16基础方案实现
约12倍的整体加速
。
最后一层优化,是让
多张显卡配合
得更好。多卡视频生成不仅需要拆分计算任务,还需要在不同显卡之间交换数据。显卡之间如何分工,会直接影响生成速度、通信开销和显存占用。
针对主要通过PCIe连接、没有NVLink高速互联的多卡环境,RunningHub选择了TP2+Ulysses4的并行组合。在8张RTX 6000D的测试中,这一组合相比TP4+Ulysses2
快
约12%
,同时
减少约14GiB显存占用
。
RunningHub将后训练加速、注意力优化、计算缓存、编译优化和多卡并行等方法
统一整合进SGLang的multimodal_gen推理引擎
,由同一套推理流程完成调度和执行。
三、适配RTX 6000D多卡环境,人人可用本地可部署
一套加速方案的实际价值,不只体现在跑得多快,也取决于它能落到什么样的硬件上,以及普通创作者能否真正用起来。
目前,不少视频生成加速方案多建立在B300等高端数据中心GPU上。此类硬件虽然性能强,但
采购和部署门槛较高
,普通工作室和创作者较难按照公开配置复现。
在上面测试中,RunningHub采用8张RTX 6000D专业显卡,这些显卡主要通过PCIe连接,不依赖NVLink高速互联,就实现了生成速度的大幅提升,成本更低,
更贴近工作室的硬件条件
。
为了让本地部署更方便,RunningHub在GitHub中提供了
环境安装、模型下载、服务启动和推理测试步骤
。有多卡设备的用户可以参考公开方案,
在自己的服务器上部署H3
,并将模型接入已有的创作流程。没有多卡设备的普通创作者,也可以
直接在RunningHub上使用
,可以说是实现了
人人可用,本地可部署
。
这也不是RunningHub第一次参与H3开源生态建设。H3上线后,RunningHub先完成模型接入,随后开放全套ComfyUI节点,此次又进一步公开H3 Lightning加速方案。
据RunningHub披露,H3上线以来,RunningHub平台上已有上千名创作者开源近万条相关工作流,覆盖
电商、短剧、漫剧、声音克隆、动作克隆和音频驱动等场景
。节点、工作流和加速方案的持续开放,也为开发者进一步创作和开发提供了基础。
目前,RunningHub的企业级API已接入上千家企业,日均调用量达到
千万级
。从模型接入、工具封装到推理优化,RunningHub在H3生态中的角色,也逐步转向技术方案贡献者。
四、十年GPU调度积累,搭建AI产品矩阵
H3 Lightning的推出,离不开RunningHub母公司海马云十余年的GPU工程积累。海马云成立于2014年,是一家覆以GPUaaS为底座,业务
覆盖基础设施、模型服务和智能体应用的原生AI公司
。
随着AI技术正从基础设施建设走向应用爆发和原生应用形成,行业关注的问题也从智能能否被规模化供给,转向这些智能如何被调用、如何被组织成真正能够完成任务的产品。在这一过程中,算力始终是支撑模型运行和应用落地的基础。
过去十余年,海马云围绕GPU容器调度、图形虚拟化和实时流媒体等环节进行技术投入,并在
国内建设60余个边缘节点,为超过3000万月服务用户提供云渲染服务
。在这一过程中,海马云积累了GPU资源调度、多任务并发和内容实时分发等工程能力,并逐步将这些能力延伸至AI推理。
在此基础上,海马云形成了
从底层算力到上层应用的AI产品矩阵
。其中,RunningHub已面向全球140多个国家和地区提供服务,接入170余个模型API;HaimaAPI面向企业聚合350余个主流模型;RHTV、RHStory和VibeX等智能体工具,则进一步将模型能力延伸到视频及其他内容生产环节。
海马云不直接训练基础模型,其重点是
解决模型发布和开源之后的运行问题
,包括新模型如何快速接入、如何在有限的硬件条件下提高推理效率,以及如何转化为创作者可以直接使用的产品。
具体到H3,RunningHub先完成模型接入,随后开放ComfyUI节点,再进一步公开H3 Lightning加速方案。这一过程也体现了海马云在发展过程中的能力演进:从解决高性能内容“怎么跑”,到解决AI模型“怎么调用、怎么落地”。H3 Lightning正是其GPU工程能力在AI推理环节的一次具体应用。
结语:开源之后,推理优化成为视频生成提速的关键
模型开源,给了开发者自行部署、修改和二次开发的选择;推理优化,则进一步影响每次生成需要等待多久、消耗多少计算资源。当视频生成从尝鲜走向日常生产,生成质量之外,速度、稳定性、成本和部署条件,也会直接影响创作者的选择。
RunningHub的H3 Lightning,推进模型权重走向实际生产:有多卡设备的创作者可以参考公开方案本地部署,没有设备的创作者也可以在线使用。随着开源模型越来越多,推理加速、硬件适配和工作流生态,正在成为决定模型能否真正进入创作流程的关键环节。


