
 五度妙笔
 企业透视镜
 API商城

 数据库
图生视频10月榜单发布:MiniMax H3总榜第一,长时序生成拉开模型差距

随着视频生成模型从短时动态生成向长时序控制与实际应用场景拓展,图生视频对模型的运动表现、内容一致性、动态控制和场景应用能力提出了更高要求。本期,我们更新SuperCLUE-I2V图生视频测评10月榜单,围绕基础能力与应用能力两大方向,新增长时序生成、首尾帧控制、广告营销、教学演示任务,并设置5秒、10秒、15秒不同时长的生成要求,综合考察模型在短时动态生成与长时序连续控制中的表现。
提示词:以输入图片作为首帧,按三个镜头组织日落摄影叙事。镜头一采用侧后中远景:米色外套摄影师从双手低持黑色相机的初始状态举起相机,对准远处橙红落日及层叠山脊,稳定握持后用右手食指按下快门,不在举机前就出现拍摄完成的照片。镜头二切为肩后近景:摄影师将同一相机放低但保持双手托持,操作回放按钮使原先暗屏显示刚拍摄的橙红天空照片,屏幕中山脊轮廓与镜头一对准的远景相符,机身、镜头和背带连接不变。镜头三采用双人侧后中景:摄影师朝右侧绿色外套同伴走近一步,仍握住同一相机并把后屏转向对方,同伴弯腰靠近观看后点头。三镜头按拍摄、回看、分享顺序连续,照片内容不换成无关风景,相机不换手、不增殖,人物衣物及安全站位、山谷地理与落日光照继承,避免人物转正脸。
首帧图片:

头部模型效果展示
「过往文章介绍」
1.【2026年4月图生视频测评文章】图生视频4月中文测评榜单发布 | PixVerse V6引领发展,国产模型百花齐放!
2.【2025年6月图生视频测评文章】图生视频6月中文测评榜单发布:6大任务,11款模型对决

榜单地址:www.superclueai.com
测评摘要
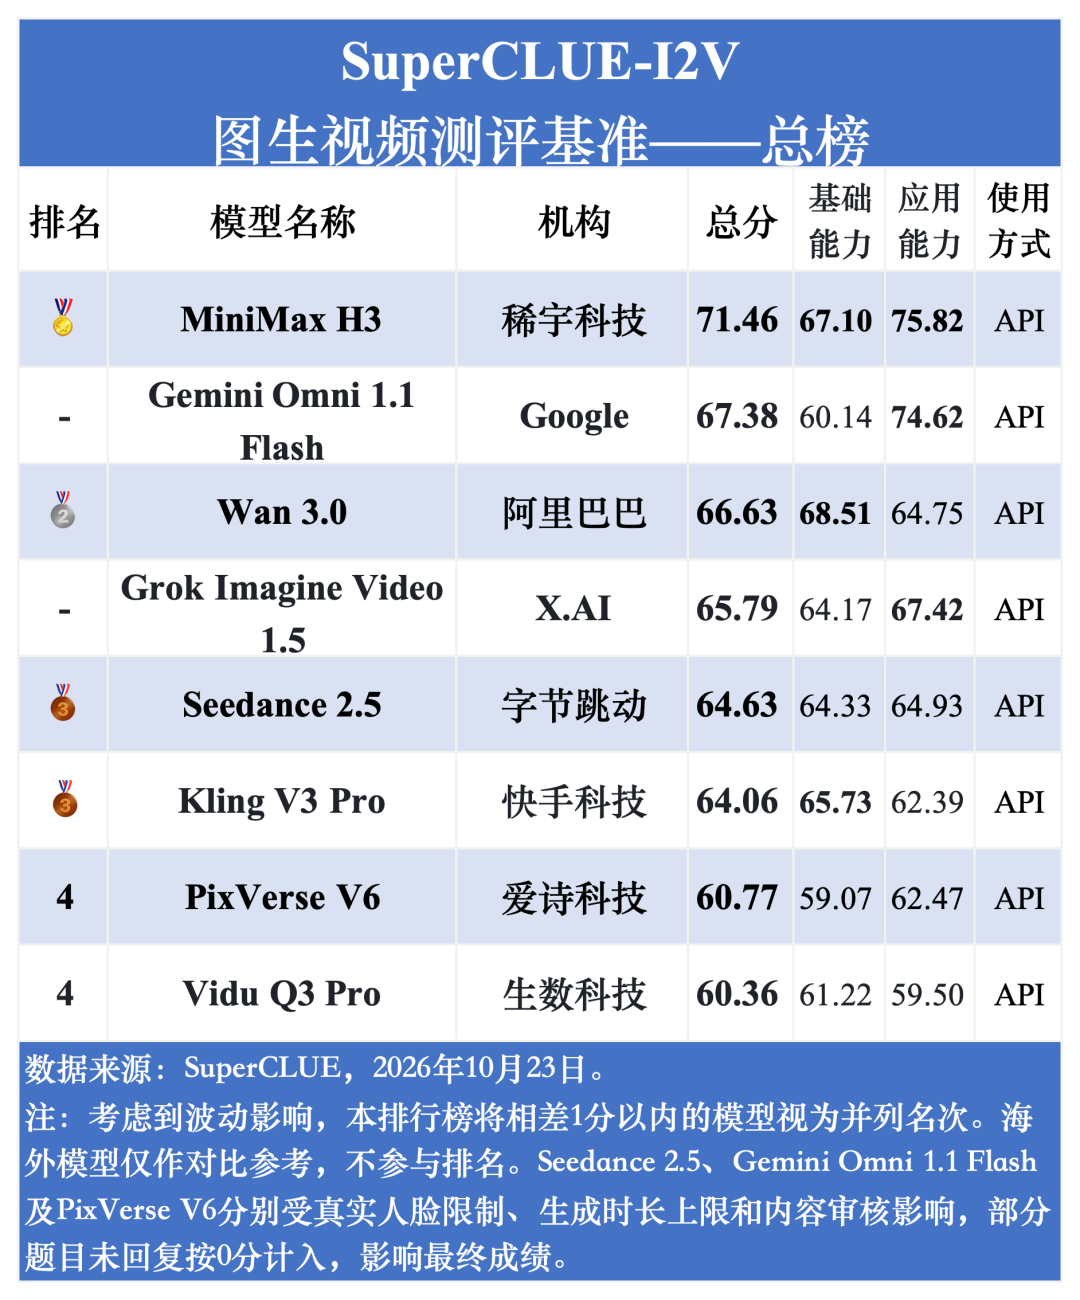
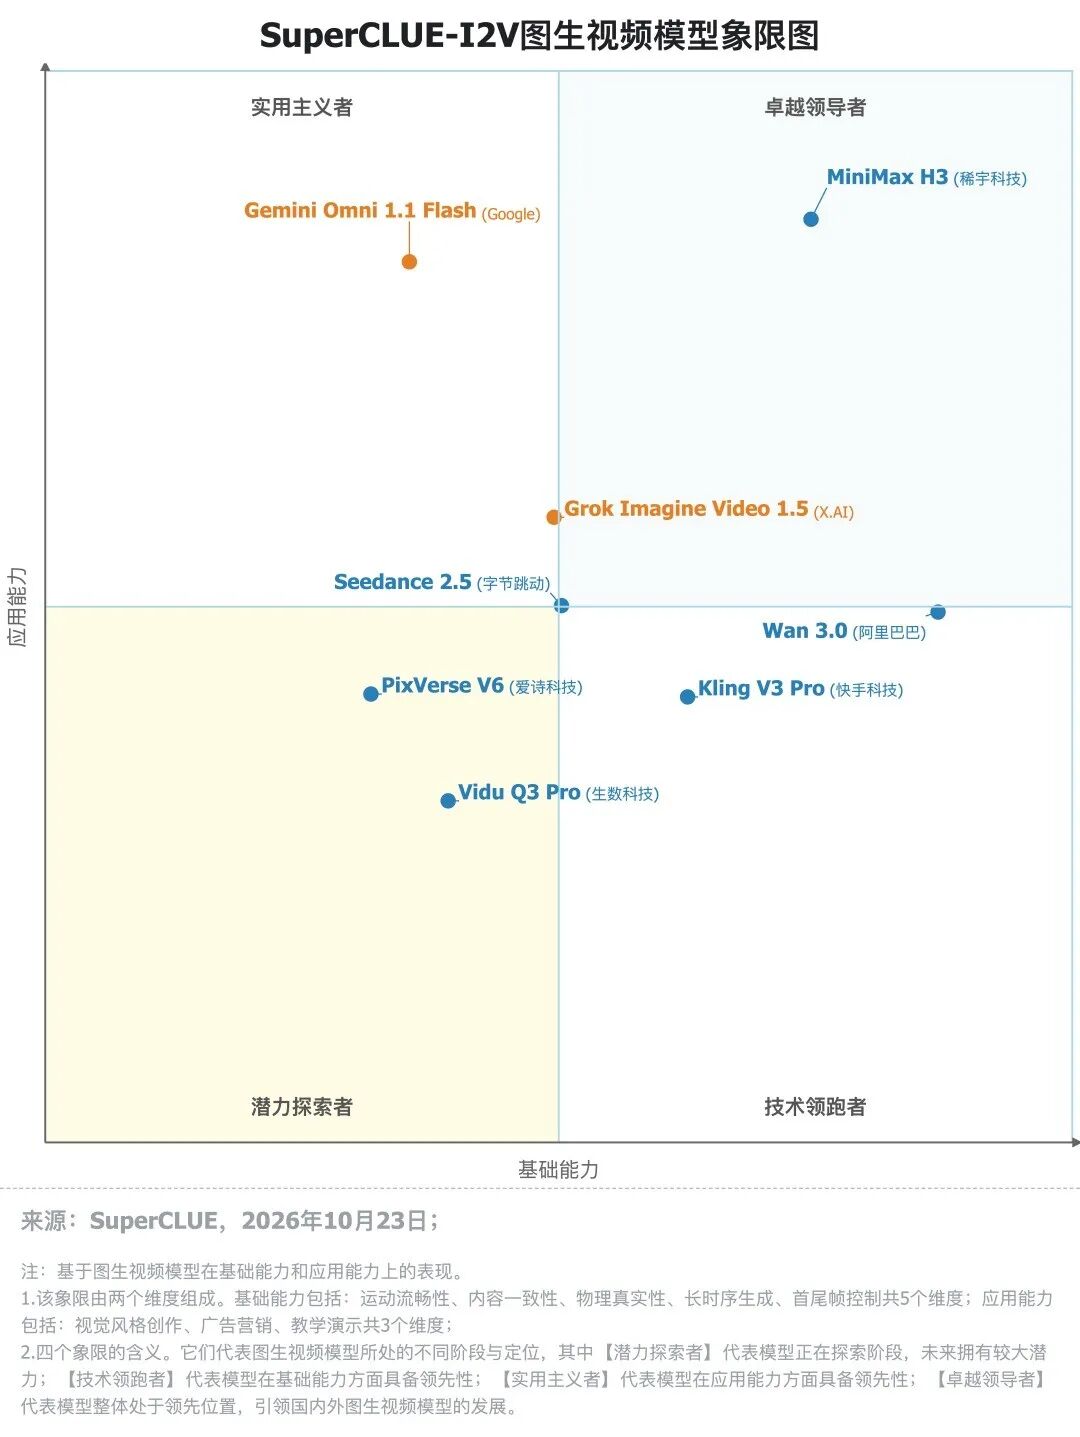
MiniMax H3以71.46分位居总榜国内第一。分榜中,Wan 3.0以68.51分领跑基础能力,MiniMax H3以75.82分位居应用能力第一。
2. 长时序生成拉开模型差距,复杂动态控制仍是短板
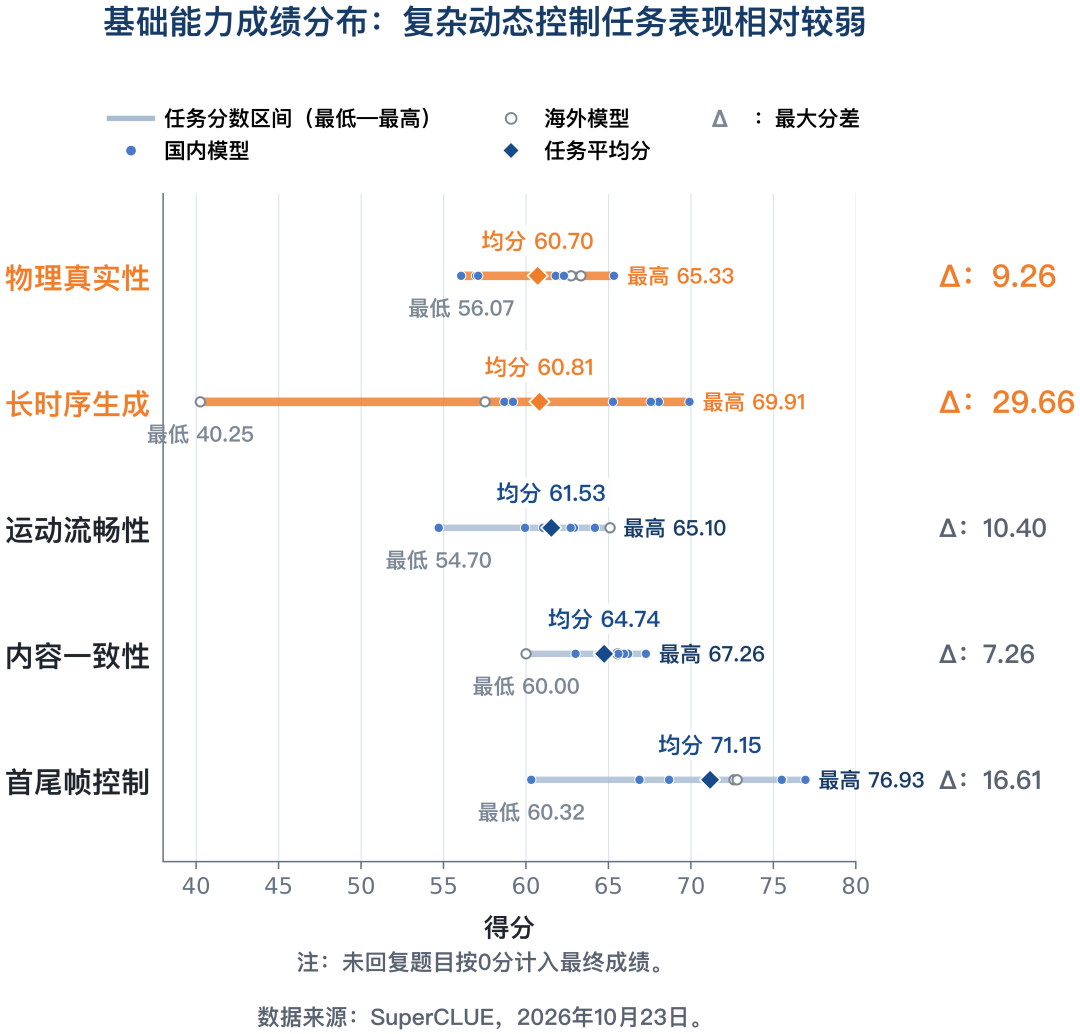
Wan 3.0以69.91分领跑长时序生成,模型最大分差达29.66分;物理真实性平均分仅60.70分,连续动作执行、跨时间状态保持及物理逻辑仍需提升。
3. 教学演示任务分化显著,多能力协同仍需加强。教学演示最大分差达44.43分,MiniMax H3以86.97分领先。此类任务需协同完成知识理解、步骤组织与动态表达,多数模型的综合执行能力仍有不足。
相较于上一期,本期将“动漫风格”、“写实风格”、“奇幻风格”合并为“视觉风格创作”,原有考察点与评价方式保持不变;同时新增“广告营销”、“教学演示”两项应用能力任务,以及“长时序生成”、“首尾帧控制”两项基础能力任务。
各任务详细介绍可回顾:图生视频测评10月体系升级!新增四项一级任务

【测评维度】:应用能力—视觉风格创作
【提示词】:男子目视前方,用双手整理着领口。
【裁判模型打分】:
第一轮评价
-----评价开始-----
**初步质量定性 (0.0-1.0分档):** 优秀/接近完美 (0.9-1.0档)
**基础要求检查:** 完全满足。视频主体与首帧图像高度一致,且精准完成了“目视前方”和“整理领口”的动作指令。
标准 1 <写实风格> 的评价:视频的写实感极强,皮肤质感、光影效果以及衬衫的褶皱动态都非常逼真。人物整理领口的动作逻辑通顺,双手没有出现常见的肢体崩坏或多余手指现象。唯一的扣分项在于背景细节在动态过程中的稳定性略欠,但作为核心评价的主体部分几乎完美。
基于标准 1 的得分:【0.94】
**综合得分计算:**
计算过程:(0.94) / 1 = 0.94
综合得分:【0.94】
-----评价结束-----
第二轮评价
-----评价开始-----
**初步质量定性 (0.0-1.0分档):** 优秀 (0.8-0.9分档)
**基础要求检查:** 完美满足“输入图像+文本指令”的基础要求。人物一致性高,动作完全符合描述。
标准 1 <写实风格> 的评价:视频在写实度上表现优秀。人物皮肤质感、卷发的蓬松程度以及衬衫的白色色调都得到了很好的还原,背景的虚化与光影也保持了自然。虽然在手部与衣物的动态交互上存在AI生成中常见的面料形变和纹理闪烁,但从宏观语义和动作连贯性来看,这仍然是一个高质量的生成结果。由于画面比例的改变和手部交互的轻微违和,未达到0.9以上的卓越水平。
基于标准 1 的得分:【0.82】
**综合得分计算:**
计算过程:(0.82) / 1 = 0.82
综合得分:【0.82】
-----评价结束-----
第三轮评价
-----评价开始-----
**初步质量定性 (0.0-1.0分档):** 优秀/卓越档 (0.9-1.0)
**基础要求检查:** 完全满足。视频首帧与输入图像特征高度一致,且完美执行了“双手整理领口”的动态指令,动作连贯且具有明确的逻辑性。
标准 1 <写实风格> 的评价:视频展现了极高的写实精度。人物的皮肤质感、卷发的蓬松度以及白色衬衫的棉质纹理均表现得非常自然。光影随着手臂的抬起和领口的折叠而发生实时变化,阴影过渡平滑。对比同类模型,其在处理“手部与细小物体交互”这一难点上表现极其出色,手指的关节点和运动轨迹符合物理规律。未达到1.0满分仅因为极细微的手指尖端闪烁。
基于标准 1 的得分:【0.96】
**综合得分计算:**
计算过程:0.96 / 1 = 0.96
综合得分:【0.96】
-----评价结束-----
【综合得分】:(0.94+0.82+0.96)/3≈0.91分
# 参评模型


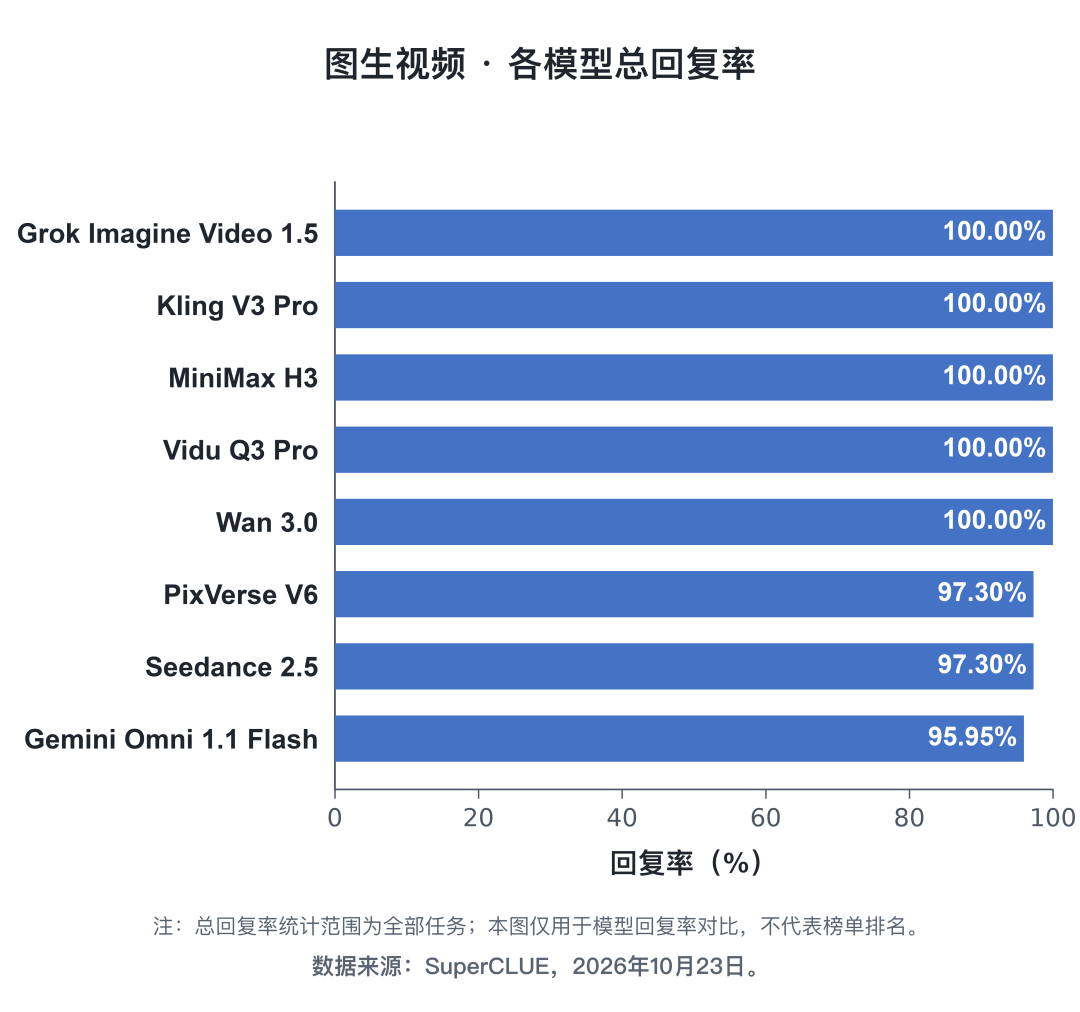
由于不同模型在内容安全审核、生成限制等方面存在差异,部分题目可能出现未能成功生成视频的情况。本期对未回复题目直接计0分,并纳入最终成绩计算,不再额外进行回复比例加权。
Seedance 2.5对包含真实人脸的输入图片存在生成限制;Gemini Omni 1.1 Flash最长仅支持生成10秒视频,无法完成部分15秒任务;PixVerse V6则因少量题目的图片或提示词触发平台内容审核而未能生成结果。由于本期未回复题目直接计0分,上述情况对三个模型的最终成绩存在一定影响。
1. MiniMax H3领跑总榜,国内头部模型呈现差异化竞争格局
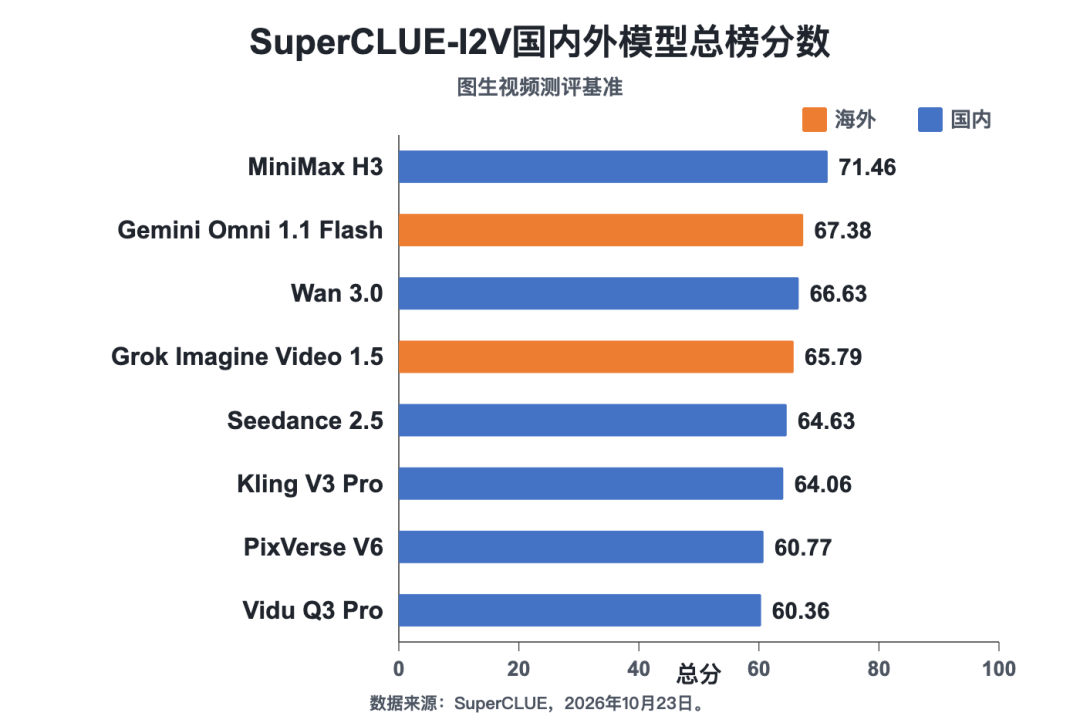
本期测评中,MiniMax H3以71.46分取得国内总榜第一,领先第二名Wan 3.0达4.83分;Seedance 2.5和Kling V3 Pro分别以64.63分和64.06分并列国内第三。分榜表现呈现明显差异:Wan 3.0以68.51分领跑基础能力榜,MiniMax H3则以75.82分位居国内应用能力第一。海外模型Gemini Omni 1.1 Flash和Grok Imagine Video 1.5分别取得67.38分和65.79分。整体来看,头部模型尚未形成全面领先的格局,不同模型在基础控制与场景应用上各具优势。

从基础能力看,物理真实性和长时序生成的模型平均分分别为60.70分和60.81分,处于各基础任务的较低水平,最高分也仅为65.33分和69.91分。相比之下,首尾帧控制平均分达到71.15分,反映出不同动态控制任务之间仍存在能力差异。长时序与物理交互不仅要求动作自然,还需要持续保持对象状态、正确继承前序事件,并符合合理的物理关系。这表明,复杂过程中的状态一致性、连续动作执行与物理逻辑仍是基础能力需要重点提升的方向。
本期应用任务中,广告营销和视觉风格创作的模型最大分差分别为7.83分和9.42分,而教学演示的分差高达44.43分,成为模型表现分化最明显的任务。其中,MiniMax H3以86.97分领先,Gemini Omni 1.1 Flash取得80.23分,其余6款模型均未达到66分。相比常规视觉呈现,教学演示还要求模型准确理解知识或故事内容,合理组织关键步骤,并通过动态画面与必要的图示完成信息传达。这说明,多数模型在复杂应用场景中的综合完成能力仍有提升空间,尤其需要加强内容理解、事件逻辑组织及信息表达的准确性与完整性。

4. 基础能力优势未必转化为应用领先,复杂任务的多能力协同仍需加强
本期测评中,Wan 3.0的基础能力领先MiniMax H3达1.41分,但应用能力反而落后11.07分,其中教学演示一项相差26.83分。这说明,运动控制、物理真实性和内容保持等基础能力表现较强,并不必然意味着复杂应用任务同样领先。
其关键在于,基础任务更侧重特定能力的执行,而复杂应用需要将任务理解、步骤组织、状态保持与视觉表达有机结合。模型不仅要正确生成单个动作或画面,还需要确保不同事件围绕同一目标、按照合理顺序连续发生,并最终完成任务。因此,跨时间状态保持、事件因果关系建模及复杂指令的分步执行,是提升模型综合应用能力的重要方向。

# 示例1 长时序生成—多镜头叙事
【提示词】:
以输入图片作为首帧,按三个镜头组织快递交付叙事。镜头一从店外侧后方拍摄:深蓝工作服快递员用右臂稳定抱住带红色条码贴纸的唯一纸箱,以空闲左手操作门把将玻璃门向店内推开,然后带同一纸箱跨过门槛进入,门扇绕原铰链转动。镜头二转为收银台侧后中景:快递员双手托住纸箱,将红色贴纸一面朝向店内接收者递出,对方双手接稳后快递员才松手,交接中箱子不悬浮、不复制。镜头三为柜台近景:接收者把同一纸箱放到台面,拿起原有笔,在原有签收单指定位置落笔签名,快递员在旁确认。全过程保留三次镜头及进入、交付、签收先后,纸箱数量与贴纸位置、服装和柜台布局跨镜头一致,交付后纸箱不能瞬间回到快递员怀中。人物采用背面或侧后取景,保持摄影细节和合理身体比例。
【视频时长】:10s
【首帧图像】:

【Wan 3.0生成视频】:0.79分。
【Gemini Omni 1.1 Flash生成视频】: 0.56分
镜头一:没有遵循提示词“推门”,并且身体与门发生了穿模;镜头二:红色标签没有对着店内签收者;镜头三:签收者从女性变成了男性,形象发生了变化。
# 示例2 首尾帧控制—首尾状态过渡
【提示词】:
以输入首帧中桌面散放的四色木积木和尾帧中整齐搭起的小塔为约束。一只手从桌面边缘伸入,依次拿起底部的宽木块、中央的两块方木块和最上方的尖顶木块,沿桌面中心位置快速但自然地搭建成稳定小塔,完成后手离开画面。每块木块的颜色、数量和几何形状保持一致,搭建过程必须体现取放与承重接触,不能让积木自行瞬移拼成高塔。最终结构的层次、朝向和位置准确匹配尾帧。
【视频时长】:5s
【首帧图像】:

【尾帧图像】:

【Wan 3.0生成视频】:0.82分
【PixVerse V6生成视频】:0.61分
没有单手操作,违反了题目的首尾帧过渡要求。
# 示例3 教学演示—原理过程演示
【提示词】:
以输入图片为起点,采用三维动画风格,向初学者解释图中的撬杆为什么能够省力。结合实验动作,自行设计必要的图示和简短说明,使观众能够理解原因。
【视频时长】:10s
【首帧图像】:

【MiniMax H3生成视频】:0.95分
【Vidu Q3 Pro生成视频】:0.36分
原理演示完全无法展示出省力的原理。
# 示例4 广告营销—图文动效
【提示词】:
以输入的中文室内音乐会宣传海报为基础,原有活动名称、时间、地点、票务说明和主视觉人物位置全部保持不变。背景的五线谱先由暗到明,几个音符按照从左到右的顺序产生轻微上下律动,海报边缘的暖色光圈逐渐扩散后收敛,最后恢复接近首帧的平稳构图。文字不得重新生成、错字或拉伸变形,活动主标题不随音符移动,所有动效限定在装饰层,不发生海报整体翻页或额外广告信息出现。
【视频时长】:5s
【首帧图像】:

【MiniMax H3生成视频】:0.74分
【Wan 3.0生成视频】:0.60分
图像中原本的音符没有遵循指令“上下律动”,而是生成了新的音符;海报边缘的暖光圈没有遵循指令“扩散后收敛”,而是生成了新的光圈。
# 加入社群

扩展阅读
[1] CLUE官网:www.CLUEBenchmarks.com
[2] SuperCLUE排行榜网站:www.superclueai.com
[3] Github地址:https://github.com/CLUEbenchmark


