五度妙笔
 企业透视镜
 API商城

 数据库
中文长程软件工程测评发布!DeepSeek-V4.1新轻量版领跑国内榜单|SuperCLUE-DeepSWE

# 测评背景
SuperCLUE-DeepSWE 是面向中文真实开发场景的长程软件工程基准,重点评测大模型在智能体框架驱动下,从需求理解、仓库探索到代码实现、测试验证和完整交付的能力。模型需要在真实代码库中完成一项新功能,不仅要让代码运行起来,还要完整满足需求、确保模块协同,并在引入新功能的同时保持原有行为正确。
本次测评中,各模型平均每任务需进行约 150 轮交互,平均运行时长约为 80 分钟,单任务限时3小时。模型需要在持续交互中完成需求分析、仓库探索、代码修改与测试验证,考察的是长程工程任务中的持续执行与完整交付能力。
此前,我们发布了《中文场景软件工程测评升级 |SuperCLUE-DeepSWE》,介绍面向中文真实开发场景的长程软件工程基准。
# 榜单概览


↔ 左右滑动查看四张象限图
测评摘要
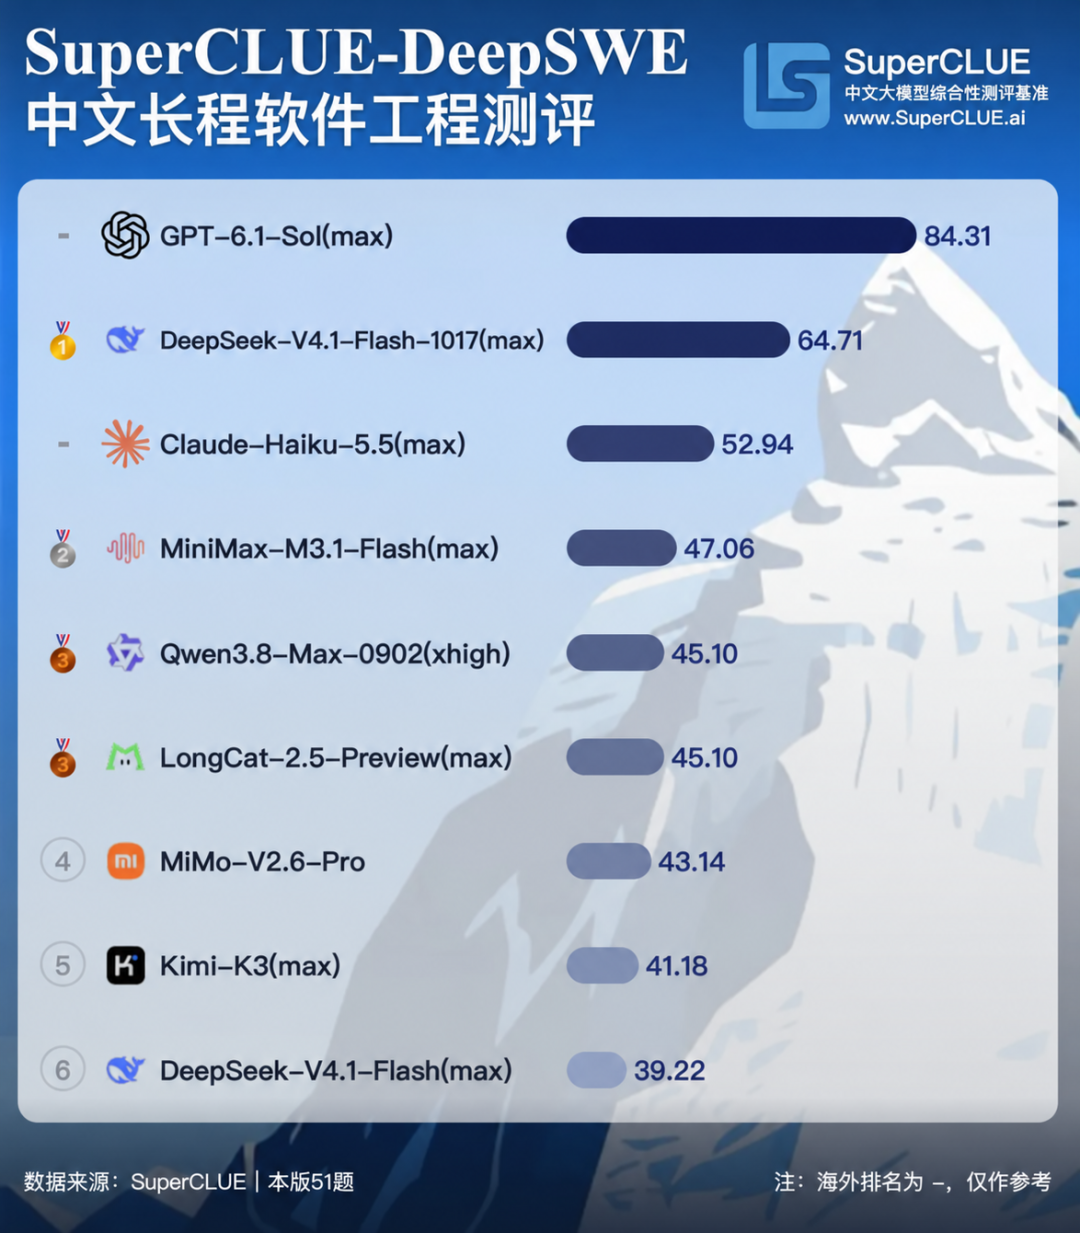
DeepSeek-V4.1-Flash-1017 获 64.71 分,领先国内第二名 MiniMax-M3.1-Flash 17.65 分;平均每任务 API 等价费用为 1.84 元,运行时间为 35.50 分钟,在本轮国内参评模型中同时取得最高分、最低平均费用和最短平均耗时。
2. 第二梯队得分接近,成本与运行效率呈现明显差异。
MiniMax-M3.1-Flash 获 47.06 分,位居国内第二;Qwen 与 LongCat 均获 45.10 分。三者分差较小,但通过的任务各有不同,执行耗时和费用也存在明显差异。
3. 更多资源投入未必带来更高得分,完整交付仍是关键。MiMo-V2.6-Pro 获 43.14 分,Kimi-K3 获 41.18 分,前一版本 DeepSeek-V4.1-Flash(max) 为 39.22 分。更长的运行时间和更多 Token 消耗,并不保证实现更完整。
4. 国内领先模型已展现竞争力,与海外高分参考仍有差距GPT-6.1-Sol 获 84.31 分,Claude-Haiku-5.5 获 52.94 分,两者仅作参考,不参与国内排名。国内第一名 DeepSeek-V4.1-Flash-1017 的得分高于 Claude-Haiku-5.5,但仍低于 GPT-6.1-Sol,表明国内模型在中文长程工程任务的完整交付能力上仍有提升空间。
# 模型测评设置
本次测评结合常用开发方式与框架适配情况,GPT 使用配套的 Codex,其余模型均适配 Claude Code,因此统一采用该框架,以提高测评配置的一致性与成绩的可比性。GPT、MiniMax、Qwen 和 Kimi 通过套餐接入,DeepSeek 两个版本、Claude、LongCat 和 MiMo 通过 API 接入;套餐模型的费用按实际 Token 用量及对应 API 单价统一折算。

# 基准升级点
1.从“公开修复复现”升级为“原创问题求解”
SuperCLUE-SWE主要评测 Agent 对公开 Issue 和 PR 中已有问题的修复能力;SuperCLUE-DeepSWE 则在真实开源仓库中设计没有公开答案的中文原创新功能。Agent 需要自主理解需求、探索仓库并完成跨模块实现,重点考查原创长程工程问题的求解能力,详细对比如下表所示。

2.从“短补丁”升级为“长程工程链路”:
SuperCLUE-DeepSWE 的题目不是只改一个函数或提交一段局部补丁,而是要求 Agent 在现有开源仓库中完整实现一项原创新功能。每道题通常涉及多个文件和模块,需要新增或修改数百行代码;Agent 需要从中文需求出发,自主定位相关模块,理解仓库已有约束,完成接口设计、核心实现、跨模块接入、兼容性处理和测试验证。
3. 从“匹配某个历史实现”升级为“验证可观察行为”
SuperCLUE-DeepSWE 围绕每道题的中文需求单独编写行为验证器,从公开 API、程序输出、文件系统副作用和资源生命周期等外部可观察结果判断新功能是否正确,并通过原有功能测试检查是否引入回归。评分不比较候选代码与参考补丁,也不要求使用固定的私有 helper、文件路径或实现结构;只要完整满足题面约定的功能行为,并且不破坏原有功能,不同的设计和实现方式都可以通过。
# 基准创新点
1. 中文需求与国际代码库的跨语言工程评测
使用中文描述真实开发需求,设计长程任务,评测模型能否将中文产品语义准确转化为跨模块工程实现。
2. 用完整功能开发替代零散代码修改
传统代码题通常只要求修改一个函数,SuperCLUE-DeepSWE 则要求模型像真实工程师一样,在大型项目中完成一项可交付的新功能,覆盖接口设计、跨模块开发、兼容处理和测试验证。
3. 专门检验模型能否把复杂需求“做全、做对”
题目不仅测试主功能,还加入边界情况、异常流程和新旧功能兼容等真实工程难点,能够识别“看起来已经完成、实际上仍遗漏关键要求”的答案。
# 基准任务介绍
SuperCLUE-DeepSWE面向真实开源仓库设计原创软件工程任务,以实现原创新功能为主,覆盖前端、开发者工具、Web 基础设施、数据库、文件系统、分布式系统、数据校验和算法等技术领域。每道题归入一个主要领域,并根据实际考查内容标注事务、并发、状态机、资源治理、API 设计等能力标签。
仓库的选择标准为:
- ⭐ Star 数超过 4,000
- 💻 覆盖 Python、TypeScript、Go、Rust、Java、JavaScript等语言
- 🧪 具备单元测试和 CI
- 🌏 适合设计中文原创需求
- 📄 许可证允许评测和分发
- 📦 环境及依赖可固定复现
- 🚫 不依赖真实云服务或专用硬件
包括但不限于以下技术领域和参考仓库:

SuperCLUE-DeepSWE 以困难题为主。题目通常需要跨多个文件和模块(至少4个)进行修改,并新增或调整数百行代码(至少400行)。
# 测评流程与评分方法
测评流程
下图展示了SuperCLUE-DeepSWE从任务准备、智能体作答到独立验证与评分的完整流程。智能体首先在隔离的无网络Docker环境中根据任务描述修改代码,系统随后提取代码补丁,并在全新的无网络Docker容器中运行隐藏的 F2P 功能测试和 P2P 回归测试。

评分方法
每个任务采用二元评分:只有全部 F2P 测试(验证功能修复)和全部 P2P 测试(验证无功能回归)均通过时得 1 分,否则得 0分;补丁无法应用、测试缺失或被跳过也视为失败。F2P、P2P 通过率和 partial 仅用于诊断,不计入最终成绩。模型最终成绩为所有任务得分的平均值,即:
最终成绩的计算
最终成绩= 得分为1的任务数/ 参评任务总数*100%
高分模型的优势,体现在更完整地满足需求、处理边界情况并守住回归测试。DeepSeek-V4.1-Flash-1017 保留了前一版本已通过的全部 20 道任务,并新增通过 13 道,成绩提升至 64.71 分。MiniMax-M3.1-Flash 在线程池重入清理、取消处理和内容超限后的提前终止等复杂路径中表现更完整,最终通过 24 道任务,获得 47.06 分。
较低得分模型的主要问题,是主体功能已实现,但仍遗漏少数关键约束。例如,LongCat-2.5-Preview 在 SQLGlot 任务中通过了 125/126 项功能测试,仍因一项边界行为不符而失分;Kimi 在 Ajv 任务中通过全部新功能测试,却因破坏一项原有行为而未能通过整题。这说明,“接近完成”仍不等于通过验收,更长的运行时间或更多 Token 投入,也不保证补齐最后的工程缺漏。
2. 性价比:模型间成本差异显著,更高花费未必带来更高通过

注:套餐模型按实际输入、缓存命中及输出 Token 用量,依据对应 API 单价折算费用,不采用套餐实际扣费;黄色为海外参考
DeepSeek-V4.1-Flash-1017(max) 以 1.84 元/任务取得 64.71 分,在本轮国内模型中同时具备最低的平均费用和最高的得分,体现出较强的成本效益。MiniMax 以 3.50 元/任务取得 47.06 分,也在较低费用水平下获得了较好的成绩。这表明,较高的工程任务完成水平并不必然依赖更高的费用投入,关键在于模型能否将资源消耗有效转化为满足完整验收要求的交付结果。
不同模型之间,费用与得分并不呈简单的正相关关系。LongCat 与 Qwen 同为 45.10 分,平均费用却分别为 2.71 元/任务和 30.61 元/任务,相差约 11.3 倍;MiMo 以 2.25 元/任务取得 43.14 分,Kimi 则以 45.45 元/任务取得 41.18 分。因此,性价比需要结合费用和最终得分共同判断。同时,费用差异不仅取决于 Token 总量,也受到模型单价、缓存利用及输入输出结构的影响。实际选型应综合考虑任务适配性与预算约束,评估模型在目标场景中的交付表现。
3. 运行效能:更快交付与更高得分可以同时出现

DeepSeek-V4.1-Flash-1017(max) 平均每任务运行 35.50 分钟,取得 64.71 分;MiniMax-M3.1-Flash(max) 为 47.30 分钟、47.06 分,均在较短运行时间下取得较高得分。相比之下,LongCat-2.5-Preview(max)、MiMo-V2.6-Pro、Kimi-K3(max) 的平均耗时分别为 86.41、92.73、95.08 分钟,Qwen3.8-Max-0902(xhigh) 则达到 136.36 分钟。更长的执行时间并未对应更高成绩,模型能否有效推进实现、完成验证并及时收敛,是影响交付效率的重要因素。
在每任务 3 小时的时限下,Qwen 出现 15 项任务超时,Kimi 和 LongCat 分别为 4 项、3 项;新版 DeepSeek、MiniMax 和 MiMo 没有超时。其中,Qwen 有 6 项超时任务的最终代码仍通过验收,超时不等于任务的失败(可能实现了核心功能,在测试阶段超了时),最终得分仍取决于交付代码的验收结果。这里的耗时涵盖模型交互、工具执行、编译与测试等环节,反映的是完整工程流程的运行效率,不能直接等同于模型的 Token 生成速度。
4.Token 用量:更多上下文投入,不保证更多任务通过

按非缓存输入、缓存命中及输出 Token 相加,DeepSeek-V4.1-Flash-1017(max) 平均每任务约消耗 1,755 万 Token,取得 64.71 分;Qwen3.8-Max-0902(xhigh) 约为 1,876 万 Token、45.10 分,DeepSeek-V4.1-Flash(max) 约为 1,966 万 Token、39.22 分。三者的累计 Token 投入相对接近,但得分差距明显,说明资源投入能否转化为完整交付,比消耗总量本身更值得关注。
MiniMax-M3.1-Flash(max) 与 LongCat-2.5-Preview(max) 平均每任务分别消耗约 2,717 万和 2,844 万 Token,得分为 47.06 分和 45.10 分,在更高的累计消耗下,得分仍低于新版 DeepSeek。不过,总 Token 包含多轮调用中累计计入的缓存命中量,不能直接理解为单次上下文长度或有效推理量。不同厂商的缓存计量、上下文管理和智能体实现也存在差异,因此应结合最终得分、Token 构成及对应计费结构,综合评估模型的资源利用效率。
5.交互轮数:交互投入与交付成效并不成正比,模型执行效率存在明显差距
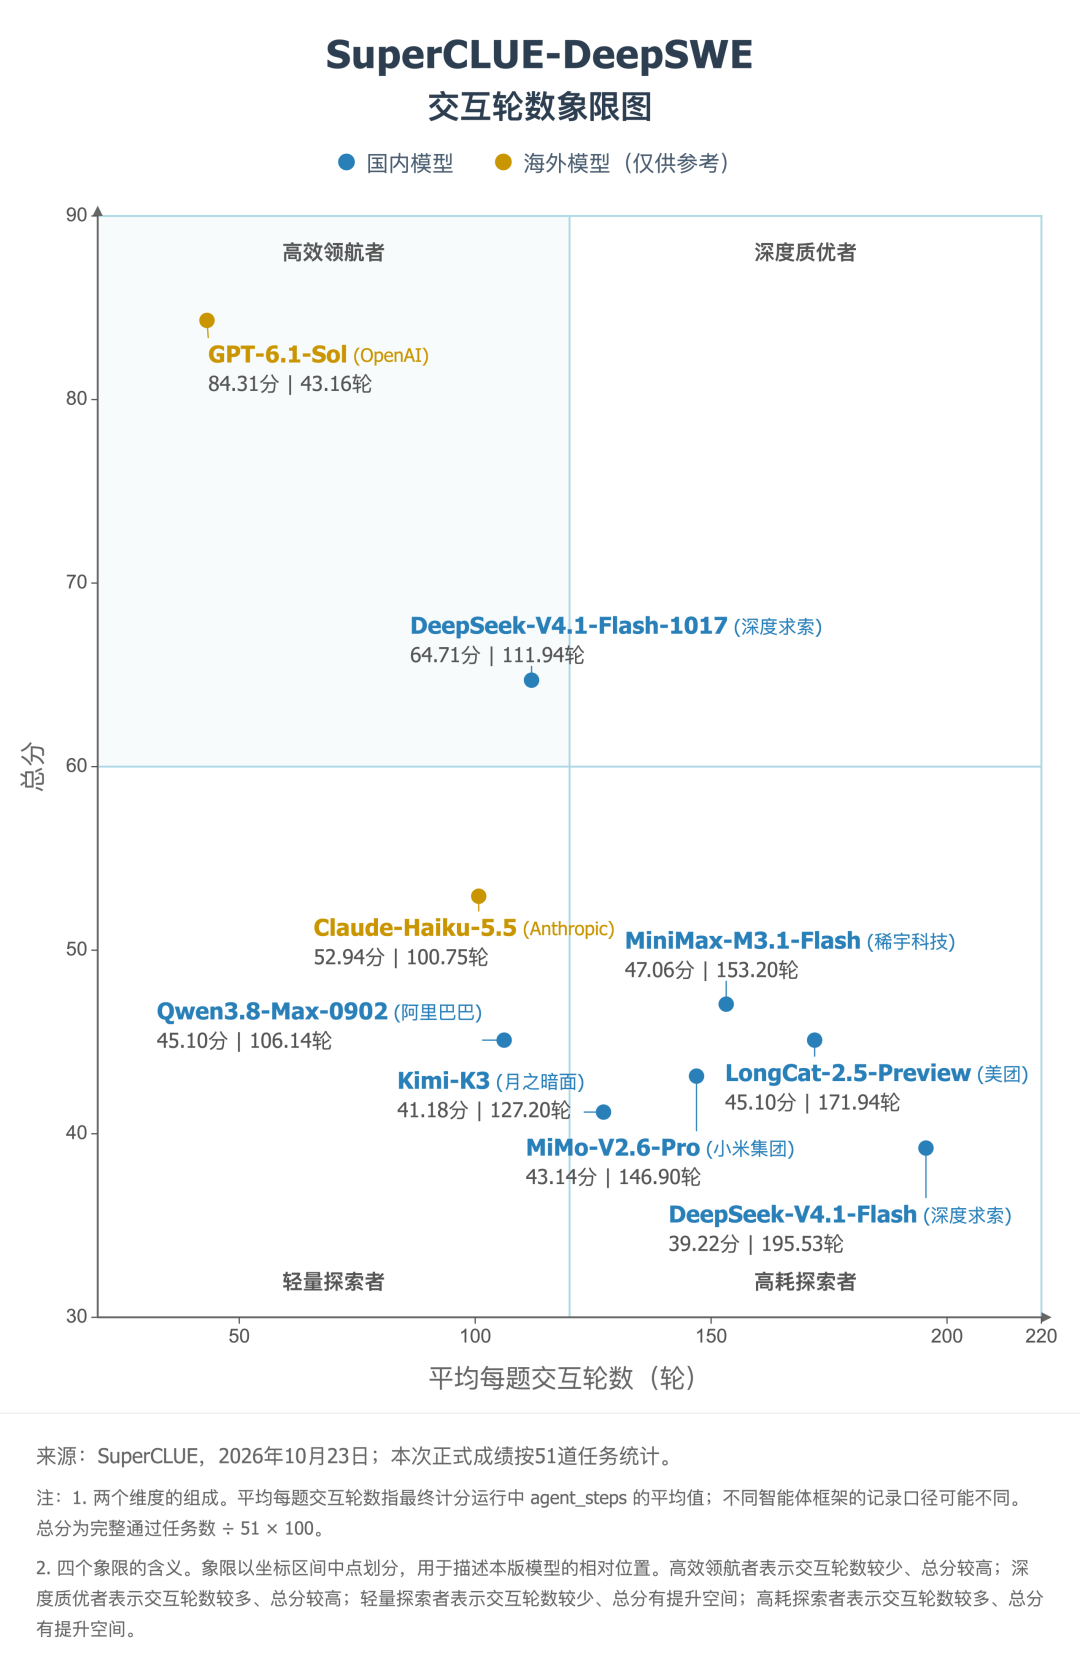
DeepSeek-V4.1-Flash-1017(max) 平均每任务交互 111.94 轮,前一版本 DeepSeek-V4.1-Flash(max) 为 195.53 轮,减少约 43%,得分却从 39.22 分提升至 64.71 分。新版在本轮评测中以更少的交互投入取得了更好的交付结果。交互轮数衡量的是执行投入,只有这些交互能够有效推进实现、补齐约束并完成验证,才能转化为最终成绩。
交互轮数也需要与运行耗时结合理解。Qwen3.8-Max-0902(xhigh) 与 LongCat-2.5-Preview(max) 同为 45.10 分,平均每任务分别交互 106.14 轮和 171.94 轮,但对应耗时分别为 136.36 分钟和 86.41 分钟。Qwen 的轮数更少,实际运行时间却更长,少轮次并不直接等于更快交付。评估执行效率,应综合考察交互轮数、耗时、Token 消耗与最终得分;本图轮数依据最终计分运行记录统计,不同智能体框架之间的记录口径可能存在差异。
# 对比示例展示
【任务名称】:为部署流水线导出完整的锁文件子集
【类别】:包管理与部署
【参考仓库】:denoland/deno
【语言】:Rust
【标签】:Deno、锁文件、依赖图、workspace、npm/JSR、平台兼容性
【输入指令内容】:
# 为部署流水线导出完整的锁文件子集我们有一个 Rust 构建服务,直接使用仓库里的 `deno_lockfile`。一个 monorepo 共用`deno.lock`,但每个部署镜像只需要其中几个 workspace 成员。现在手工删 JSON 很容易漏掉 JSR 转 npm 的依赖、npm alias/peer 实例或平台相关依赖;保留整个锁文件又会让无关服务的升级影响部署产物。请给这个库增加一个纯内存的部署投影 API。调用方需要以下公开接口(从 crate 根导出);类型至少实现 `Debug`、`Clone`,options还要有 `Default`,默认所有集合为空、`include_root` 为 false、`target` 为 None:```rustpub struct LockfileProjectionTarget { pub os: String, pub cpu: String,}pub struct LockfileProjectionOptions { pub include_root: bool, pub members: Vec<String>, pub links: Vec<String>, pub specifiers: Vec<deno_semver::jsr::JsrDepPackageReq>, pub remote_roots: Vec<String>, pub target: Option<LockfileProjectionTarget>,}impl Lockfile { pub fn project( &self, options: &LockfileProjectionOptions, ) -> Result<Lockfile, LockfileProjectionError>;}```使用场景例如选择 `members: vec!["services/api".into()]`,额外加入构建器发现的registry specifier 和 HTTP 模块入口,再指定 `linux` / `x64`。请按下面的约定实现:- `members`、`links` 精确匹配锁文件 workspace 中的键;未知键报错,重复选择无影响。 root 只由 `include_root` 选择。每个被选成员的 Deno 和 package.json dependencies 都是入口。links 是调用方明确提供的额外入口:锁文件没有足够信息推断路径归属, 不要把所有 links 或 root 自动加入。保留被选 workspace 记录,去掉未选记录;root 的 overrides 仅在选择 root 时保留。- 只用已有锁定结果计算闭包,不查询 registry、不重新解版本。保留实际用到的 specifier 映射、JSR 包及其依赖、npm 普通/optional/optional-peer 依赖;同一包的 不同 peer 上下文是不同实例,npm 依赖的别名也必须保留。完整 npm ID 是不透明标识, 实际依赖边来自记录,不能仅靠拆 peer 后缀猜依赖。没有用到的 specifier 映射即使 指向已保留包也应删除。环和共享子图必须正确处理,深链不能导致栈溢出。- 不指定 target 时保留所有平台的可选依赖。指定时,os/cpu 分别匹配后取交集:空 列表不限制,`!value` 否决该值;存在正项时还必须命中一个正项。值按 Node 平台名 精确匹配。只允许删除直接指向不兼容包的 optional/optional-peer 边,并同步删除 这条边的记录;该包若仍从必需边或入口可达则必须报错。一个兼容的可选包内部的 必需依赖仍按必需边处理。被选 link 的 optionalDependencies,以及 peerDependenciesMeta 中 `optional: true` 的 peer,也遵守此规则;去掉后者时 同步移除其 meta 条目。meta 用带 scheme、无版本的键(如 `npm:/peer`), 与该 link 中同 scheme、同包名的 peer 对应。不要访问已被过滤分支里的依赖。- 被选入口或保留边缺失 specifier 映射、包记录时都报错,包括可选边:缺记录不能 被当作平台不兼容。未被访问的无关残留记录不能让投影失败。错误实现 `std::error::Error`,信息能区分原因并指出出错的键/请求/包或 URL。- `remote_roots` 是调用方收集的所有 HTTP 模块入口,用锁文件现有 redirects 一直 跟到 remote checksum;只保留经过的重定向与终点 checksum,支持共享尾部, 遇到环或缺失终点报错。URL 键精确匹配;一个键若同时有 redirect 和 checksum, 优先跟 redirect。不要推测锁文件没有记录的 HTTP import 边。- 保留下来的 integrity、tarball、安装标志、平台约束及未被删除的 workspace/link 元数据保持原样。输出沿用现有标准锁文件格式,可被现有 reader 读回;重复投影 和输入选择顺序变化应产生相同字节。空选择得到空锁文件。成功与失败都不能改变 原对象、写磁盘或访问网络;结果保留 filename/overwrite,`has_content_changed` 等于原有标记或序列化内容发生变化,并继续遵守 `resolve_write_bytes` 的行为。这次范围是库 API,不需要新增 Deno CLI 命令。请在现有库结构中完成可维护的实现、补充使用文档和相关测试,保持已有读取、升级格式、配置变更清理及序列化测试通过。实现结构和错误类型的具体组织由你决定;遇到未约定的兼容性问题可以提出权衡。仓库在 `/app`;环境已准备好 Rust 工具链与该库的离线依赖,可用`cargo test --locked --offline -p deno_lockfile` 验证。请提交你的改动到 git。
实现完成并已提交。## 变更内容**新增 `libs/lockfile/projection.rs`**- 公开 API:`LockfileProjectionTarget`、`LockfileProjectionOptions`(`Default` 全空、`include_root=false`、`target=None`)以及 `Lockfile::project`。- 入口解析:members/links 按锁文件键精确匹配并去重,未知键报错;root 仅由 `include_root` 选择;额外 `specifiers` 与 `remote_roots` 作为显式入口。- 闭包计算:完全基于已有 `specifiers`/`jsr`/`npm` 记录,用迭代式 BFS(无递归)处理环、共享子图与深链;只保留实际使用的 specifier 映射,npm 完整 ID 作为不透明键,保留 alias 与不同 peer 上下文实例。- 平台过滤:实现 npm 的 os/cpu 语义(空列表不限制、`!` 否决、正项白名单、两者取交集);仅删除直接指向不兼容包的 optional/optional-peer 边并同步删除边记录;必需边/入口可达不兼容包时报错;被过滤分支的依赖不再访问。- link 处理:可选依赖与 `peerDependenciesMeta.optional: true` 的 peer 同样过滤,删除 peer 时同步删除 meta 条目。- remote 投影:沿 redirects 跟进到 checksum,保留路径上的 redirect 与终点 checksum,支持共享尾部,检测环与缺失终点;redirect 优先于同键 checksum。- 结果保留 `filename`/`overwrite`,`has_content_changed` 为原标记或序列化内容变化;空选择输出空锁文件;原对象、磁盘与网络均不受影响。**错误与导出**- 新增 `LockfileProjectionError`(实现 `std::error::Error`,`Debug`/`Clone`),各变体区分未知键、缺失 specifier/包记录、非法版本、必需包不兼容、重定向环/缺失终点,并携带出错的键、请求、包或 URL。**文档与测试**- README 增加投影 API 的使用说明与语义说明。- 新增 27 个集成测试,覆盖闭包/环/万级深链、specifier 裁剪、平台矩阵与否定语义、alias 与 peer 实例、link 可选 peer/meta、重定向共享尾部与错误、root/overrides、序列化回读、确定性、重复投影、不可变性及写回行为。## 验证- `cargo test --locked --offline -p deno_lockfile`:全部通过(24 单元 + 3 集成 + 27 新测试 + 37 spec tests + doctest)。- `cargo clippy --locked --offline -p deno_lockfile --all-targets`:无错误。- `cargo fmt -p deno_lockfile -- --check`:通过。提交:`723f8f08 feat(lockfile): add pure in-memory deployment projection API`
【对 DeepSeek-V4.1-Flash-1017(max) 的评测结果】:
{ "parser_results": { "empty_selection_and_default_flags":"passed", "workspace_selection_closes_mixed_cycle_and_preserves_metadata":"passed", "multi_root_preserves_distinct_peer_instances_and_alias_edges":"passed", "root_links_and_extra_specifiers_are_independent":"passed", "unknown_selectors_are_exact_and_diagnostic":"passed", "only_used_specifiers_survive_even_when_same_resolved_package_is_kept":"passed", "required_platform_conflict_is_not_optional":"passed", "ordinary_edge_to_incompatible_package_errors":"passed", "compatible_optional_package_keeps_its_required_edges_required":"passed", "excluded_optional_branch_does_not_validate_broken_descendants":"passed", "missing_optional_records_cannot_be_silently_skipped":"passed", "platform_lists_use_veto_and_positive_intersection_without_order_dependence":"passed", "link_optional_and_peer_metadata_are_projected_together":"passed", "missing_link_optional_mapping_is_an_error":"passed", "link_required_peer_incompatibility_errors":"passed", "missing_selected_registry_records_are_errors_but_unreachable_damage_is_not":"passed", "malformed_visited_jsr_resolution_is_diagnostic":"passed", "remote_shared_tail_and_direct_root_preserve_only_reachable_checksums":"passed", "redirect_precedes_checksum_and_errors_are_atomic":"passed", "missing_direct_remote_root_and_self_loop_fail":"passed", "dirty_and_overwrite_flags_follow_existing_write_protocol":"passed", "long_package_and_redirect_chains_are_iterative":"passed", "generated_graph_closure_matches_independent_reachability_model":"passed", "peer_suffix_is_identity_not_an_additional_dependency_source":"passed", "all_root_categories_combine_as_a_union":"passed" }, "summary": { "new_feature_tests": "25/25", "upstream_regression_tests": "64/64", "final_reward": 1 } }
【Qwen3.8-Max-0902(xhigh) 最终的回复内容】:
完成。已提交 `3a875bc4` 到分支 `feat/lockfile-deployment-projection`(基线 `c8401c52`),`cargo test --locked --offline -p deno_lockfile` 全绿:46 个单元测试、6 个集成测试、37 个既有 spec 测试、1 个 doctest,`cargo fmt`/`cargo clippy` 干净。## 实现内容**新增 `libs/lockfile/projection.rs`**(`lib.rs` 仅加 4 行:`mod projection;` + 3 个 re-export),公开接口与要求完全一致:`LockfileProjectionTarget`、`LockfileProjectionOptions`(`Debug + Clone + Default`)、`LockfileProjectionError`(thiserror,实现 `std::error::Error`)、`Lockfile::project(&self, &options) -> Result<Lockfile, LockfileProjectionError>`。核心是一个**迭代式**(显式 worklist,10 万层深链测试不爆栈)的闭包遍历:- **入口**:被选 root/成员的两类 dependencies、被选 link 的 deps/peers(meta 标 `optional: true` 的 peer 与 `optionalDependencies` 作为可选入口)、`options.specifiers`。所有 req 经 specifiers 映射解析(精确键匹配),JSR→npm 依赖、npm peer 实例(id 视为不透明,边只来自记录)、别名全部保留;只保留实际用到的 specifier 映射。- **平台过滤**:os/cpu 按 Node 语义分别匹配取交集(空表不限、`!v` 否决、有正项须命中)。只删直接指向不兼容包的 optional/optional-peer 边(含 link 层,删 peer 时同步删 meta 条目),被删分支不再深入;缺记录一律报错而非当作不兼容;兼容可选包内部的必需依赖按必需边处理。- **remote_roots**:redirect 优先于 checksum,只保留经过的 redirect 与终点 checksum,支持共享尾部,环/缺终点报错,URL 精确匹配。- **输出保证**:标准 v5 格式可被 `Lockfile::new` 读回;字节级确定性(重复投影、选择乱序结果相同);空选择得空锁文件;纯内存不改原对象;结果保留 `filename`/`overwrite`,`has_content_changed` = 原标记 ∨ 序列化变化,`resolve_write_bytes` 行为不变。workspace 记录、integrity/tarball/scripts/bin/os/cpu 等元数据原样克隆。**测试**:22 个模块内单元测试(覆盖上面每条规则、错误信息、确定性、纯度)+ `tests/projection_test.rs` 3 个走公开 API 的集成测试(含任务描述的 services/api + linux/x64 场景、读回 round-trip)+ rustdoc 可运行示例;README 增加了完整使用文档。## 一个需要说明的解释性取舍「该包若仍从必需边或入口可达则必须报错」我按字面语义实现:**报错条件是"某条指向不兼容包的可选边被删除"且"该包仍从必需边/入口可达"**(两个方向都会检测,与遍历顺序无关)。因此一个不兼容包若*仅*经必需边可达、且没有任何可选边指向它,会被原样保留而不报错——因为规范明确"只允许删除可选边",必需结构不做二次猜测(真实 npm 锁文件中必需依赖几乎不会带平台约束,平台相关的都在 optionalDependencies)。如果你希望更严格的语义(不兼容 ∧ 必需可达 ⇒ 一律报错,无论是否存在被删的可选边),改动很小:在 `visit_npm_required` 里去掉 `pruned_targets` 条件即可,我可以补一个提交。
【对 Qwen3.8-Max-0902(xhigh) 的评测结果】:
{ "parser_results": { "empty_selection_and_default_flags":"passed", "workspace_selection_closes_mixed_cycle_and_preserves_metadata":"passed", "multi_root_preserves_distinct_peer_instances_and_alias_edges":"passed", "root_links_and_extra_specifiers_are_independent":"passed", "unknown_selectors_are_exact_and_diagnostic":"passed", "only_used_specifiers_survive_even_when_same_resolved_package_is_kept":"passed", "required_platform_conflict_is_not_optional":"passed", "ordinary_edge_to_incompatible_package_errors":"failed", "compatible_optional_package_keeps_its_required_edges_required":"failed", "excluded_optional_branch_does_not_validate_broken_descendants":"passed", "missing_optional_records_cannot_be_silently_skipped":"passed", "platform_lists_use_veto_and_positive_intersection_without_order_dependence":"passed", "link_optional_and_peer_metadata_are_projected_together":"passed", "missing_link_optional_mapping_is_an_error":"passed", "link_required_peer_incompatibility_errors":"failed", "missing_selected_registry_records_are_errors_but_unreachable_damage_is_not":"passed", "malformed_visited_jsr_resolution_is_diagnostic":"passed", "remote_shared_tail_and_direct_root_preserve_only_reachable_checksums":"passed", "redirect_precedes_checksum_and_errors_are_atomic":"passed", "missing_direct_remote_root_and_self_loop_fail":"passed", "dirty_and_overwrite_flags_follow_existing_write_protocol":"passed", "long_package_and_redirect_chains_are_iterative":"passed", "generated_graph_closure_matches_independent_reachability_model":"passed", "peer_suffix_is_identity_not_an_additional_dependency_source":"passed", "all_root_categories_combine_as_a_union":"passed" }, "summary": { "new_feature_tests": "22/25", "upstream_regression_tests": "64/64", "final_reward": 0 } }
评测说明:Qwen3.8-Max-0902(xhigh) 通过了 22/25 项新功能测试和全部 64 项原有功能回归测试,但有三项平台兼容性检查失败:普通必需依赖不兼容、兼容可选包内部的必需依赖不兼容,以及 link 的必需 peer 不兼容。对应失败日志均显示:应返回错误时,候选实现返回了成功结果。模型在最终回复中说明,它把报错条件收窄为“已经删除过指向该包的可选边,且该包仍从必需边或入口可达”。按本任务验收口径,这一判断遗漏了应当报错的必需依赖路径,因此单任务得分为 0。
【对比结论】:两者均完成了主体实现并通过原有功能回归测试,分歧集中在必须依赖的平台兼容性边界。这一案例展示了主体功能可用与完整满足验收要求之间的差距;任务采用全通过规则,因此最终判定DeepSeek-V4.1-Flash-1017为通过,Qwen3.8-Max-0902为未通过。
联系我们