一周AI丨马斯克将向全美儿童赠送SpaceX股票;OpenAI发现PHP致命漏洞;Anthropic捐赠Agent Skills标准;DeepSeek开源内部推理框架……
发布时间:2026-10-25来源:世界人工智能大会
 “现代史上最大规模财富捐赠”:马斯克等AI三巨头拟投入近3000亿美元做慈善
OpenAI发现PHP重大安全漏洞,成为影响力最大的漏洞之一
谷歌开源王牌框架Harness²:无需改模型权重,让AI运行中自我修补Anthropic捐赠Agent Skills开放标准,70+平台已集成
字节跳动Seedance 2.5 4K发布,面向影视级画面生成
DeepSeek宣布将内部推理框架DeepInfer全面开源,目标实现大模型普惠田渊栋创业后首个模型Flint发布:RSI从零开始训练,4个月完成
全球参数规模最大的开源模型再突破!月之暗面发布Kimi K3.1 Pro
MiniMax发布M3.1 Flash:成本降七成,确认Space Bunny身份
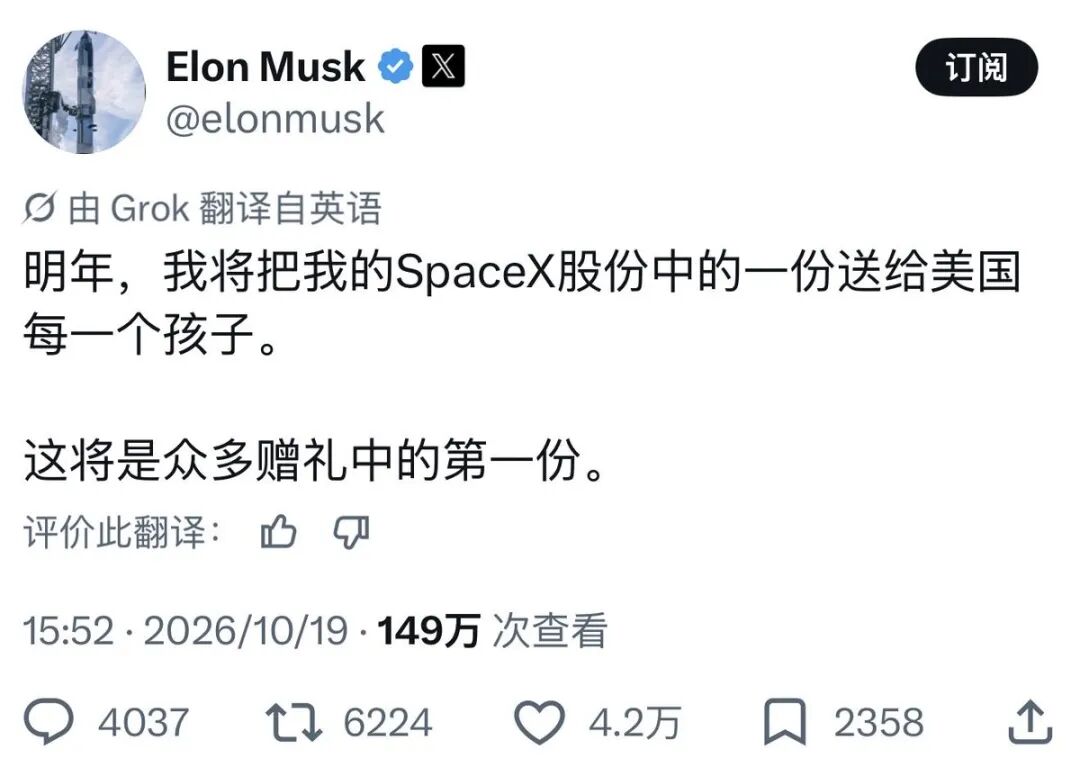
“现代史上最大规模财富捐赠”:马斯克等AI三巨头拟投入近3000亿美元做慈善
10月22日,《华盛顿邮报》昨日发布博文,报道称Anthropic、OpenAI和SpaceXSI三家AI巨头正酝酿“现代史上规模最大的财富捐赠”,规模可能接近3,000亿美元。
Anthropic宣布,将把公司5%股份捐入一个新的公益基金。若该公司上市时估值达到2万亿美元,该基金规模可达1,000亿美元;其七位创始人还承诺捐出个人财富的80%。这笔资金可能用于补贴受AI自动化影响的特定人群,并资助相关研究。
Anthropic称,公益基金将进一步拓展其在人工智能安全、生物医学研究等领域的工作。该公司表示,这将使其能够对人工智能导致的失业等问题采取更大胆的做法,并可能考虑向传统非营利组织大额捐款,或直接向特定人群发放资金。
今年夏天,OpenAI曾讨论提案,考虑将公司约5%的股份交由公众持有。当时,该公司正面临美国政府更严格的审查,以及美国政府对其最先进模型发布的管控。OpenAI基金会持有OpenAI略高于四分之一的股份,价值超过1,800亿美元,并已投入8.55亿美元用于公益项目。
马斯克则表示,计划明年向“美国每个孩子”赠送一股SpaceX股票。截至6月,他持有该公司约64.2亿股股票。美国人口普查数据显示,美国有7200万儿童,按当前股价计算,马斯克的赠送价值约为110亿美元。
不过该媒体也指出这里的“捐赠”大多是未上市股权或未来承诺,实际可支配金额高度取决于Anthropic、OpenAI的IPO估值和SpaceX股价。
该媒体对此解读认为,这次慈善捐助一方面推动技术商业化,而更重要的是回应其对就业、收入分配和社会稳定可能造成的冲击,淡化“AI冲击就业”影响。
就在马斯克宣布这一计划的几个月前,白宫推出了“特朗普账户”计划。这是一项覆盖从出生到成年的投资计划,将为2025年至2028年出生的美国公民提供一个由政府注资1000美元的投资账户,家庭可以在此基础上继续追加资金。
由于个人和企业可以选择向这些账户捐赠股权,包括戴尔、Visa、美光科技和达美航空在内的许多美国顶级公司已承诺通过雇主配捐或额外出资来支持该计划。
对于科技巨头的捐赠行为,也存在批评声音,有评论认为如果将公共福利替换为个别富豪选择性分发的股票,不仅存在不确定性,也容易模糊私人资本与公共治理的边界。
马斯克向特朗普账户捐80亿美元背后的图谋
OpenAI发现PHP重大安全漏洞,成为影响力最大的漏洞之一
10月22日,OpenAI与谷歌旗下网络安全公司Wiz披露,研究人员借助AI发现了PHP中的严重安全漏洞。美国国家安全局(NSA)已发布紧急建议,要求相关机构尽快更新系统,如果无法立即更新,建议暂时下线系统,直至风险得到充分缓解。
PHP是一种广泛用于网站和网络应用的服务器端编程语言,WordPress、Drupal以及维基百科使用的MediaWiki等软件均依赖它。此次披露的问题位于PHP核心引擎,涉及内存泄露和未经身份验证的远程代码执行。攻击者成功利用后,可能控制受影响服务器,或读取密码、身份验证令牌及API密钥等敏感信息。
据报道,荷兰、芬兰、法国、德国等国的部分政府网站及公共服务平台采取了临时下线措施。
荷兰暂时关闭了政府门户网站、鹿特丹港网站,以及部分医院和政党网站;芬兰国家信息技术服务提供商Valtori暂停部分政府公共网络服务;法国部分地方行政机构网站进入维护状态;德国联邦信息技术服务提供商ITZBund也关闭了部分网站。这些措施主要是为了在安全更新部署完成前降低风险。
PHP开发团队已于10月21日发布安全更新。据互联网情报公司Censys的数据,在约260万个运行PHP的主机中,其中约158万个能够识别PHP版本号。
此次漏洞发现涉及多支使用AI的研究团队。OpenAI表示,安全公司Calif参与其“Patch the Planet”计划,使用GPT-5.6 Sol发现了一项关键漏洞;Wiz也独立发现并报告了两项漏洞。PHP维护者负责修复和发布,OpenAI、Wiz及其他合作方参与研究、补丁验证和防护协调。
Wiz披露,其研究使用了Wiz Atlas安全智能体、Gemini 4 Argon和GPT-5.6 Sol。研究人员指出,这类内存漏洞过去需要复杂的分析、测试和调试,针对不同服务器环境还要反复调整。AI降低了这些工作的难度,使长期存在、过去难以实际利用的问题变得更具攻击可行性。
OpenAI称,据其掌握的信息,研究人员在攻击者之前发现了这些漏洞,为维护者提前准备修复和防护措施争取了时间。不过,同样的AI能力也可能帮助攻击者更快开发利用工具。随着漏洞细节公开,网站运营者能否及时部署安全更新,成为接下来降低风险的关键。
新闻拓展:
AI挖出藏了十几年的底层PHP漏洞,网络安全也回不去那个旧时代了。
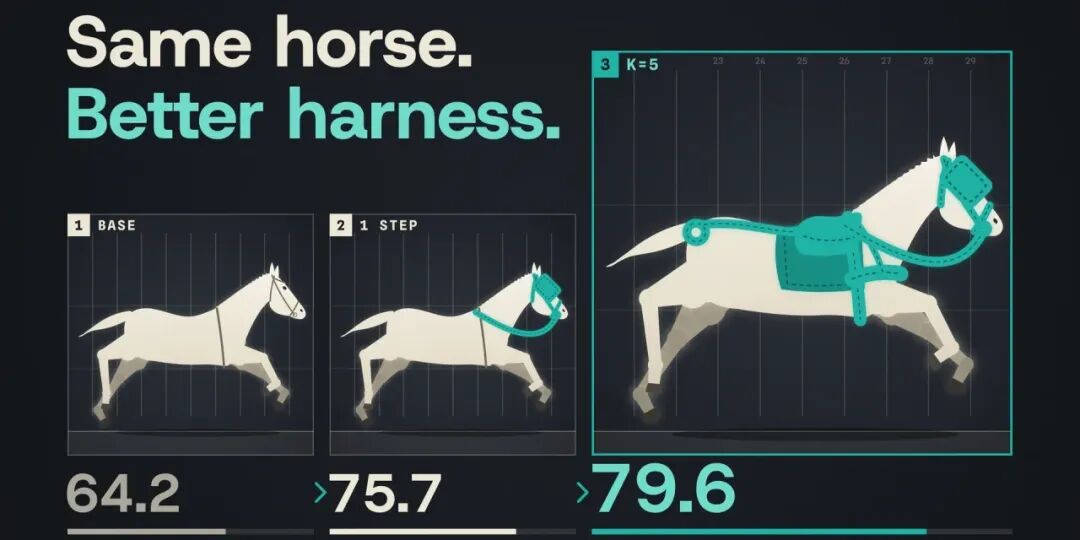
谷歌开源王牌框架Harness²:无需改模型权重,让AI运行中自我修补
10月19日,谷歌研究团队开源了一套名为Harness²的智能体框架,试图让AI Agent在不修改模型权重的情况下,通过持续调整系统提示词、记忆、工具指导、skill、子智能体等外部组件,实现递归式能力提升。
目前,Harness²已在GitHub以Apache 2.0协议开源,支持OpenCode和Codex,默认使用OpenCode,也可以切换至Codex。Google Research同时强调,Harness²仍属于研究项目,并非谷歌官方支持的产品。团队将这套可修改的Harness拆成8类组件,包括系统提示词、护栏、记忆、工具指导、子智能体、Skills、脚本和插件。这些组件共同决定Agent如何构建上下文、调用工具、委派任务,以及如何在多轮工具调用中完成工作。Harness²全称为“面向开放世界的递归智能体Harness(Recursive Agent Harnessing for an Open World)”。第一层发生在单个任务内的“任务级递归”。当Agent遇到一个Harness设计阶段没有见过的新任务时,系统不会完全依赖预先写好的固定策略,而是执行一轮“提出—探测—组合”:先生成多个Harness修改方案,让不同版本实际执行同一个任务,再观察它们产生的行为差异,最后重新组合出一套更合适的Harness。特别的是,Harness²并不要求任务一定存在明确的标准答案。第二层则发生在任务之间的“Harnessing 级递归”。Harness²不会在一个任务结束后把刚刚得到的经验全部丢掉,而是维护一个持续存在的Improvement Harness,将此前采用过的Harness方案以及有执行证据支持的经验保存下来,用于指导之后的优化。由此,可以形成一个闭环:Agent面对任务、修改执行方式、实际运行验证修改结果、保留有效经验,再利用这些经验指导下一轮Harness调整。Google Research已经在JobBench、LAB和WorkBuddy-Bench三类专业任务Benchmark,以及4种“模型—Harness”配置上测试Harness²,使用的基础模型包括GLM-5和Gemini 3.5 Flash。结果显示,仅进行一步Harness²优化,在模型权重保持不变的情况下,WorkBuddy-Bench成绩最高提升11.5分,JobBench最高提升4.5分,LAB部分通过率最高提高11.8个百分点。继续增加任务级递归预算后,性能还会进一步提升。
谷歌开源Harness,支持 OpenCode 和 Codex:国内开发者接入Jev实测“真行”
Anthropic捐赠Agent Skills开放标准,70+平台已集成
10月22日,Anthropic发布公告,宣布向Linux基金会旗下的Agentic AI Foundation(AAIF)组织捐赠Agent Skills开放标准,让其从单一公司项目转为社区共治的AI智能体能力标准。
AAIF于2025年12月9日成立,由Linux基金会运营,由Anthropic、Block和OpenAI共同创立,负责托管和治理AI智能体生态中的开放协议、标准与开源项目。Anthropic此前已将Model Context Protocol(MCP)捐赠至该组织。Agent Skills可理解为面向AI智能体的“说明书”,旨在让AI智能体以统一、可移植的方式获得特定领域知识和工作流程。一个Skill通常是一个文件夹,其中包含SKILL.md文件,以及智能体执行任务所需的脚本、参考资料和其他资源。智能体可以在需要时加载这些内容,从而获得处理编程、数据分析、企业流程等具体任务所需的“程序性知识”,而不必把所有指令永久写入系统提示词。Anthropic表示,Agent Skills最初源于Claude Code的开发。Claude Code能够处理一般知识工作,但在真实商业任务中经常缺少具体、可重复的操作流程。2025年10月相关产品发布后数周内,开发者便在GitHub上发布了数以千计的Skills,并为Codex、Cursor和OpenCode编写加载器。2025年12月,Anthropic将其整理为独立的开放标准、GitHub组织和专属域名,使不同厂商的智能体都能够使用同一套格式。作为开放标准发布以来,ChatGPT、Cursor、GitHub Copilot、VS Code等70多个智能体平台已集成Agent Skills。Anthropic表示,公开的Skills 数量已达到约100万个,累计安装次数约2.8亿次。后续标准将由来自Anthropic、Google、OpenAI等公司的工程师以个人身份共同维护,重点推进版本管理、规范提案流程及安全指导。本次捐赠除了规范本身外,还涵盖Agent Skills的名称、标志、GitHub组织以及agentskills.io域名。Anthropic强调,未来该标准将保持开放、社区主导和供应商中立;即使不加入AAIF,开发者和企业仍可继续使用或贡献该标准。刚刚,你每天在用的Skills发生了一件大事
字节跳动Seedance 2.5 4K发布,面向影视级画面生成
10月23日,字节跳动旗下火山引擎正式发布Seedance 2.5 4K,通过专项训练,Seedance 2.5 4K更充分地学习了人物表情、细微动作与画面细节,是Seedance 2.5这一代中最强的模型。
据介绍,Seedance 2.5 4K支持Draft(样片)模式,终端用户可先用480P样片快速验证分镜、反复打磨镜头,确定满意的效果后再生成4K正片。在该模式下,480P以更优成本给足创意探索空间,4K负责呈现极致的视觉效果。Seedance 2.5 4K让画面中的纹理、轮廓与细节得到更充分的呈现,整体画面更清晰;再加上10-bit色深带来的丰富色彩层次与平滑的渐变过渡,画面质感更能胜任大荧幕。在影视客户的文戏测试中,4K版本对人物细微反应的呈现更充分,使得观众更容易读到台词之外的情绪,人物的表演也更有层次、更生动。在参考生成和视频编辑时,Seedance 2.5 4K能更好地保持上传素材的画质、清晰度与色彩,一致性的保持经得起大荧幕考验。对于海报、商品包装等包含小字的参考素材,也更加清晰可辨。此次4K版本采取定向邀请模式,优先给到全球20家影视工作室和导演,用来尝试电视剧、电影镜头的前期制作。试用资源与具体影视作品绑定,意味着模型能力将优先投入实际项目制作,而不是以普通公测或开放注册的方式向市场普遍提供。目前已有20部作品在使用Seedance 2.5 4K。公开信息显示,相关项目覆盖卫视S级IP作品和全球大IP电影,其中最早一批内容预计在下个月播出。不过,报道尚未披露参与试用的工作室、导演、具体片名、项目预算以及企业获得的调用额度,字节也未公布面向更大范围企业开放试用的确切时间。字节跳动于6月23日首次发布Seedance 2.5,7月13日率先向头部企业客户开放API,7月16日扩展至普通开发者,7月31日同步上线即梦网页端和移动App的C端入口,8月7日正式放开Seedance 2.5商用API调用权限。
新闻拓展:
Seedance 2.5最炸裂的升级,根本不是30秒
DeepSeek宣布将内部推理框架DeepInfer全面开源,目标实现大模型普惠
10月20日,DeepSeek官宣,在此前开源一系列大模型、TileLang编译工具及推理算子库的基础上,决定进一步将内部推理框架DeepInfer全面开源。
DeepSeek官方表示,大模型的能力边界由模型本身划定,但如何以合理成本提供超大规模的模型服务,还取决于一个长期未被公众了解的中间层:推理框架。训练使模型学有所成,推理则让模型为人所用。面对如今海量的用户调用,推理框架负责统筹调度庞大的算力集群,其效率直接决定了AI服务的算力成本与电力消耗。DeepSeek希望通过分享内部的部署经验,帮助开发者与企业组织优化大规模推理的吞吐与延迟,从而高效构建私有化及公有云部署,降低算力成本、减少能源消耗,让智能以更低的价格触达更广泛的人群,实现真正的大模型普惠。基于DeepInfer,DeepSeek官方已实现DeepSeek V4.1 Flash高吞吐、低延迟的大规模推理服务。未来,DeepSeek新模型的推理代码及后续优化也将在此持续更新。DeepInfer推理框架:集成高性能算子与深度优化的推理引擎,支持分布式推理、推测解码、SWA Bounded Replay、结构化输出等能力,兼容英伟达与华为昇腾平台。deepseek-recipe编解码组件:同步开源的生产级Token编解码组件,与DeepSeek官方API处理逻辑完整对齐,确保社区获得与官方部署一致的API体验。谈及未来展望,DeepSeek表示,借助全面开源的模型、算子库与推理框架,我们期待着在不远的未来,能够看到全球AI服务的范围与质量获得前所未有的扩展与提升,变得更加公平、透明、可信赖,进而实现在全社会范围内加快技术迭代、减少能源浪费,让有限的资源以更高的效率在基础设施与用户终端之间流转,以每个人都能够负担的成本传递更加强大的智能,以及伴随着智能的善意和无限可能性。新闻拓展:
DeepSeek 又一开源重器!深挖 DeepInfer 究竟藏着多少技术狠活?
田渊栋创业后首个模型Flint发布:RSI从零开始训练,4个月完成
当地时间10月21日,AI创业公司Recursive发布了开源模型Flint。Flint-40B-A2B是一款速度快、专为本地硬件运行的智能体编程模型,它由Recursive自研的自动化研究系统Eureka Machine全程参与打造。
Recursive由前Salesforce首席科学家理查德·索切尔(Richard Socher)创立,前Meta首席研究员、YOLO算法原创作者田渊栋也是联合创始人。作为一个混合专家(MoE)模型,Flint的总参数量为400亿,每生成一个Token只激活25亿参数。在少量员工和AI智能体的共同参与下,从零开始,仅用不到4个月就完成了这款模型。在SWE-Bench Pro v2、Terminal-Bench 2.1和SWE-Bench Verified等智能体编程基准测试中,Flint的表现超过了总参数量低于500亿的其他MoE模型。它的编程能力也能与总参数量为250亿至400亿的稠密模型相媲美,运行速度却快了5倍以上。推理引擎也做了专门优化。在较短的上下文下,Flint在搭载M4 Pro芯片的MacBook Pro上,生成速度超过每秒125个 Token;在配备64GB内存的NVIDIA RTX Spark 上,超过每秒150个Token。相比同类模型,速度最高可提升2倍。Flint在MacBook Pro M4 Pro上,把本地模型的速度与能力之间的平衡推到了一个新的水平。开发Flint也是对大规模自动化AI研究与开发系统Eureka Machine的一次实际检验。这套系统帮助Recursive完成了Flint模型构建流程中几乎所有环节的研发,包括数据处理、训练方案、基础设施和推理优化。目前,Flint的模型权重已在Hugging Face上开放,采用了Apache 2.0许可证。下载模型后,就可以在本地运行,让数据留在自己的设备上,也可以根据具体应用需求进行调整。Flint还兼容了多种工具和框架,包括llama.cpp、Ollama、Unsloth、LM Studio、vLLM和SGLang。另外, 开源的轻量级推理引擎rec专门针对Flint在M4 Pro和M5 Pro/Max芯片上的运行进行了优化,并提供了简单的配置流程,方便用户快速上手。有开发者在搭载64GB内存的MacBook Pro M5 Max上,实测Recursive Flint的生成速度达到每秒114~132个Tokens。另有开发者在一张只有12GB显存的RTX 3060上,成功跑起了这款400亿参数的编程模型,支持256K上下文,生成速度达到约46 Token/s。新闻拓展:
4个月RSI从0训练!田渊栋创业首个模型来了:MacBook Pro可跑,已开源
全球参数规模最大的开源模型再突破!月之暗面发布Kimi K3.1 Pro
10月24日,月之暗面(Kimi)发布新一代开源模型Kimi K3.1 Pro。该模型为3万亿级参数规模,支持100万词元上下文窗口,继续成为全球参数规模最大的开源模型。
数据显示,Kimi K3.1 Pro综合智能水平已接近全球领先的闭源模型,价格仅为GPT 6 Astra的五分之一。月之暗面表示,完整模型权重将于11月4日前发布。据权威榜单Artificial Analysis,Kimi K3 Pro在智能指数中排名第4,位居全球开源模型之首。据介绍,Kimi K3.1 Pro大幅增加强化学习环节的算力投入,让模型在数百个领域的反复训练中越练越聪明,拥有智能“大脑”的基础上,长出更多“手”,具备更强的专业工具调用能力,在代码编写、3D创作、金融研究和其他长程Agent的能力提升,可完成更长时间的多步骤复杂任务。在代码、Agent和知识类基准上,K3.1 Pro达到或接近最强闭源模型的水平。在编程领域,Kimi K3.1 Pro能熟练使用专业的设计和开发工具,并结合网络搜索与3D生成做出完整体验,为游戏和网页带来更专业的视觉呈现,产出的页面和交互场景在构图、排版、动画效果和完成度上都有明显提升。尤为值得一提的是,长程编码能力经大规模强化学习进一步增强。在一次内部测试中,研发人员让Kimi K3.1 Pro搭建一个模拟人体行走的系统,通过持续分析实验结果、定位问题并迭代优化行走控制器,推动仿真人体从最初几步之内便倒地,进步到能够交替迈步、连续行走11.2 秒,并修正肩部肌肉力臂计算中的36 处错误,随后重新训练控制器。在3D创作上,给新模型一段文字描述、一张草图或一张参考图,模型就能推断出物体的形状、比例和空间关系,直接操作专业建模软件做出可用的3D模型,并进一步搭建成完整的交互场景。新模型擅长机械零件、建筑模型、定制家具等建模,并支持在线预览和编辑3D模型,做好的模型可以直接下载进行3D打印。在金融领域,从检索资料、跨文档核对数据,到搭建财务模型、开展标的筛选与盈利分析,该模型都能端到端完整交付。在Office QA Pro v2和SpreadsheetBench v2两项测评中,Kimi K3.1 Pro均取得全球最佳成绩,超过Opus 5.5、Fable 5.1和GPT 6 Astra等闭源模型。此前7月16日,Kimi推出2.8万亿参数的Kimi K3,成为全球参数最大的开源模型,曾经瞬间震动全球——发布48小时后,用户请求量逼近集群承载极限。K3已经实现全面开源。据介绍,每个人都可以下载并部署Kimi K3模型,无论是用于内部研发,还是嵌入面向终端用户的产品中,均可自由使用。Kimi K3.1 Pro:月之暗面端出第一个Pro
MiniMax发布M3.1 Flash:成本降七成,确认Space Bunny身份
10月19日,MiniMax正式发布新一代Flash模型M3.1 Flash。据MiniMax介绍,M3.1 Flash在复杂Agent任务、电脑操作、软件开发及网络安全等方面取得大幅提升,在面向需要多步骤规划、连续调用工具和长程执行的任务上表现效果突出,同时线上推理速度提升了近3倍,使用成本降低了70%。
同日早些时候,MiniMax官方账号发布了一段短视频,一枚胡萝卜造型的火箭点火升空,此举被视为官方认领匿名模型“太空兔”(Space Bunny),而Space Bunny便是MiniMax M3.1 Flash的早期版本。在制造商保持匿名期间,该模型已处理超过200万亿个token。官方数据显示,相较于上一代模型,M3.1 Flash在处理Agentic任务时运行成本降低70%,推理速度提升近三倍,日常峰值输出超过每秒200个token。尽管性能大幅优化,其参数量仍保持在4280亿左右。MiniMax 将速度提升归因于推理阶段更激进的空稀疏性策略。该模型支持文本、图像和视频输入,上下文窗口长达100万token,并提供从低到高的五个推理努力等级供开发者选择。在基准测试中,M3.1 Flash在评估计算机操作能力的OSWorld V2上得分61.7,MiniMax称这是中国模型在此项测试中的最好成绩;在银行工作流测试BankerToolBench中得分为76.2。安全性方面,其在CyberGym基准测试中得分82%,展现出代码审计、渗透测试及恶意软件分析等能力。M3.1 Flash的输入定价为每百万token 15美分,直接对标DeepSeek的V4.1-Flash模型,后者在非高峰时段费率相同。值得注意的是,DeepSeek声称其模型在DeepSWE v1.1软件工程测试中解决率为77%,而M3.1 Flash为73.7%,两项数据均未经独立验证。目前,M3.1 Flash已通过MiniMax API、M Plan订阅计划及MiniMax Code桌面应用提供服务。输出费用为每百万token 60美分,缓存输入费用为1.5美分。公司表示,未来将发布模型权重,并正在开发功能更强大的Pro版本。新闻拓展:
不到72小时,DeepSeek和MiniMax双双交卷,Flash集体挑战旗舰
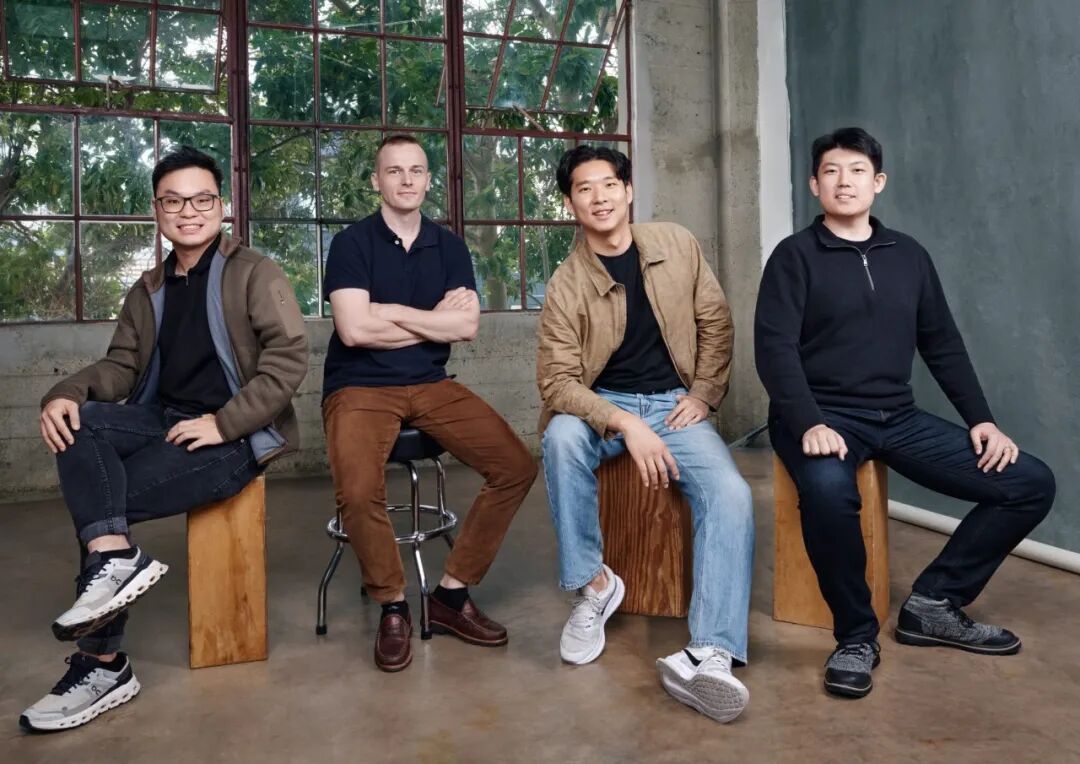
当地时间10月19日,美国具身大脑公司Dream Labs宣布完成9000万美元种子轮融资。
本轮融资由B Capital领投,Kindred Ventures、A.Capital Ventures、Unusual Ventures、SV Angel、Wing Venture Capital、Scribble Ventures和Adrian Aoun参与投资。并且,Dream Labs还公布了多位天使投资人,包括Hugging Face联合创始人兼首席科学官Thomas Wolf、前Google Android副总裁Dave Burke、前腾讯CXO David等。与此同时,该公司还通过上线Dream API,向全球用户开放世界动作模型Dream-1。该模型能够控制从未见过的机器人,执行从未接触过的任务,其运行成本低至每小时3美元。团队将Dream-1设计成即插即用的产品,只需为Dream-1接入一台全新的双臂机器人,并配备平行夹爪,再连接该公司的Dream API,就能直接开始执行任务。无需微调,无需提供该机器人此前的操作示范,也不需要用户具备机器学习专业知识。Dream Labs创立于2026年,总部位于旧金山。该公司共有12名研究人员和工程师,成员来自英伟达、谷歌DeepMind、Ai2、丰田研究院(TRI)以及斯坦福大学等顶尖机构。2026年2月,该团队发布DreamZero论文,首次提出世界动作模型。联合创始人兼CEO Joel Jang,曾任英伟达GEAR实验室的高级研究科学家,负责领导 Project GR00T的世界模型团队。联合创始人兼CTO Yunhao Ge,博士毕业于南加州大学,并在读博期间前往斯坦福大学进行为期一年的访问研究,2025年9月加入英伟达,担任研究科学家。联合创始人兼首席机器人官You Liang Tan,曾担任英伟达研究院GEAR实验室的高级研究工程师,在Jim Fan和Yuke Zhu领导的Project GR00T团队中负责机器人基础模型研究。联合创始人兼首席科学家Scott Reed,博士毕业于密歇根大学,在英伟达任职期间担任首席研究科学家,专注于通用具身智能体研究。英伟达班底出走,卖起了机器人的大脑
转载说明:本文系转载内容,版权归原作者及原出处所有。转载目的在于传递更多行业信息,文章观点仅代表原作者本人,与本平台立场无关。若涉及作品版权问题,请原作者或相关权利人及时与本平台联系,我们将在第一时间核实后移除相关内容。

 五度妙笔
 企业透视镜
 API商城

 数据库