五度妙笔
 企业透视镜
 API商城

 数据库
中文长程软件工程测评更新|Kimi-K3.1-Pro获70.59分登顶国内榜单
SuperCLUE-DeepSWE是面向中文真实开发场景的长程软件工程基准,重点评测大模型在智能体框架驱动下的持续执行与完整交付能力。模型需要在真实代码库中完成一项新功能,并保持原有功能正确。测评中,各模型平均每任务约进行150轮交互、运行约80分钟,单任务限时3小时。
相关文章参考:
中文长程软件工程测评发布!DeepSeek-V4.1新轻量版领跑国内榜单|SuperCLUE-DeepSWE
中文场景软件工程测评升级 |SuperCLUE-DeepSWE
# 测评总榜

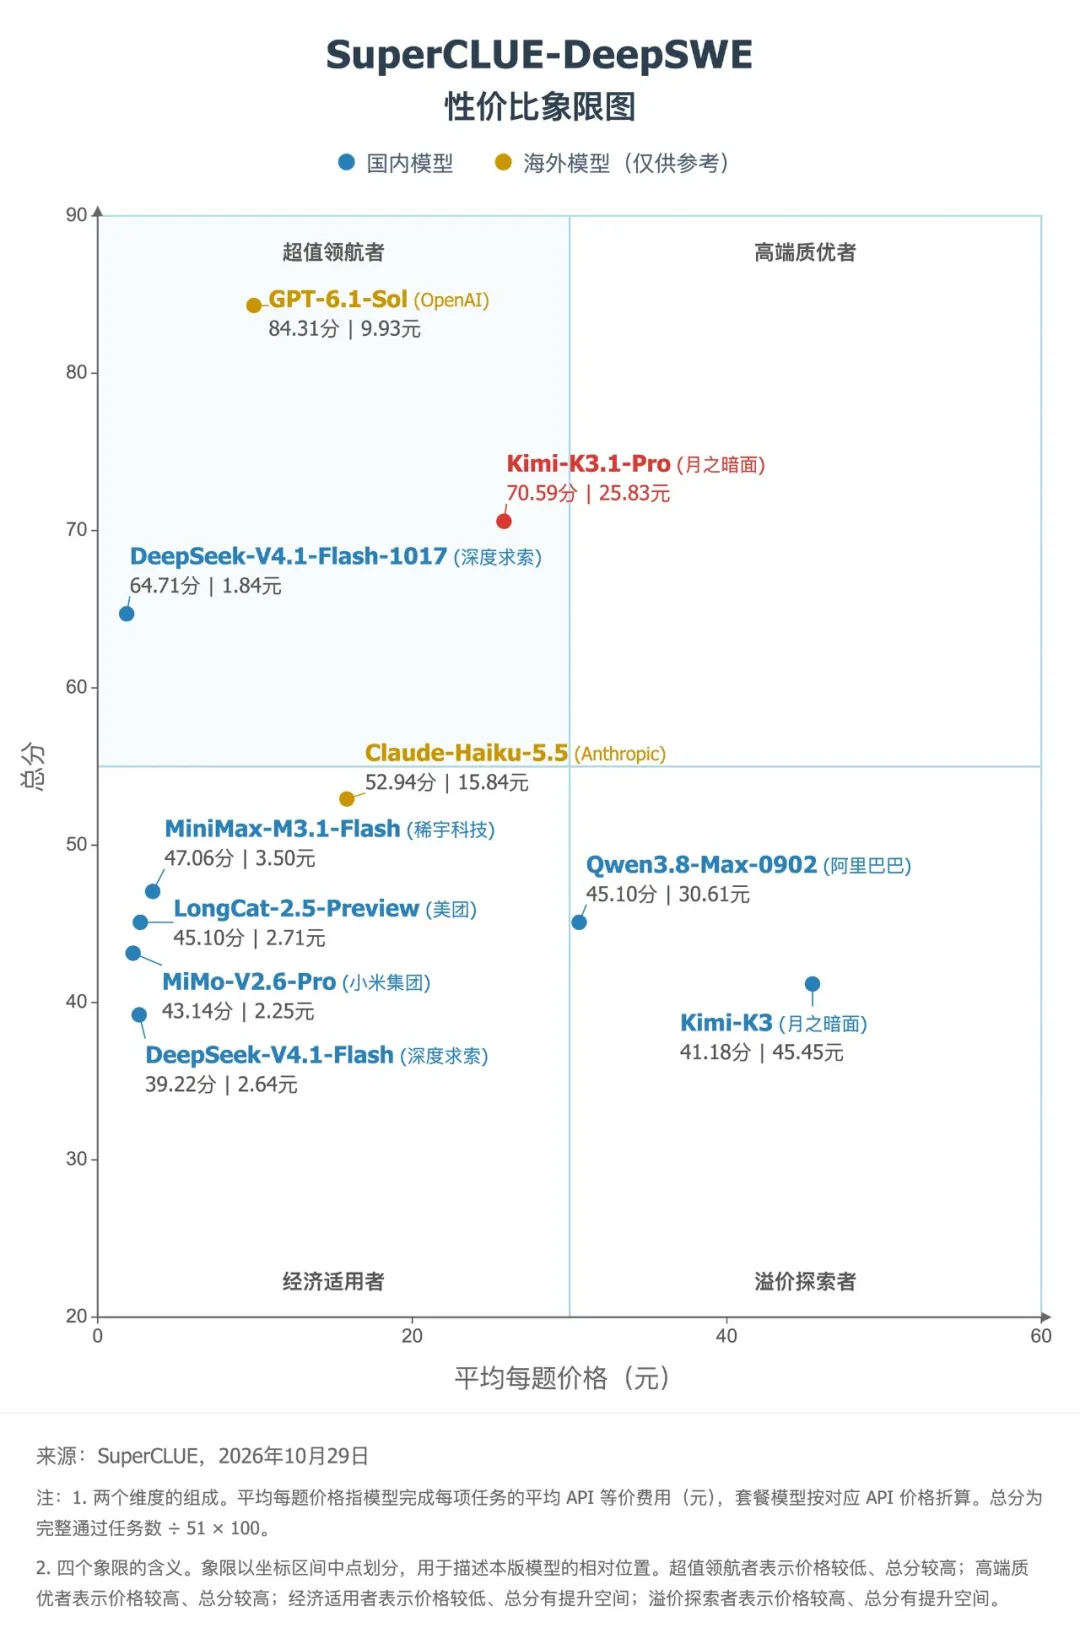
# 测评象限图


← 左右滑动查看四张图 →
Kimi-K3.1-Pro(max)以70.59分领跑国内榜单,较DeepSeek-V4.1-Flash-1017(max)的64.71分高出5.88分。MiniMax-M3.1-Flash(max)为47.06分;Qwen3.8-Max-0902(xhigh)与LongCat-2.5-Preview(xhigh)均为45.10分。
本次Kimi-K3.1-Pro(max)采用套餐API进行测评,智能体框架使用Claude Code。其他模型的智能体框架与测评方式,详见此前发布的《中文长程软件工程测评发布!DeepSeek-V4.1新轻量版领跑国内榜单|SuperCLUE-DeepSWE》。
1.Kimi-K3.1-Pro:复杂软件工程能力显著提升
相较上一代Kimi-K3(max),Kimi-K3.1-Pro(max)得分由41.18分升至70.59分,提高29.41分。从测评表现看,核心提升在于复杂约束下的完整交付:事务与并发状态处理更严谨,取消、异常和资源清理等边界覆盖更充分,同时兼顾新功能实现与回归兼容性。
2.性价比:Kimi得分提升、成本下降
Kimi-K3.1-Pro平均每任务成本为25.83元,较上一代Kimi-K3的45.45元降低43.17%,得分由41.18分升至70.59分。新版本在提高任务完成质量的同时,也降低了平均任务费用。
与DeepSeek-V4.1-Flash-1017相比,Kimi得分更高,但平均任务成本也更高:25.83元对1.84元,约为后者的14.04倍。DeepSeek以64.71分保持较强交付表现,仍是榜单中平均任务费用最低的模型。两者分别体现了更高通过率与更低成本的优势。
3.运行效能:Kimi较上一代模型平均耗时接近减半
Kimi-K3.1-Pro平均每任务耗时49.43分钟,较上一代的95.08分钟缩短48.01%,并且没有出现任务超时现象。在得分明显提升的同时,平均执行时间接近减半,体现了更好的长程任务交付效率。
横向比较,DeepSeek-V4.1-Flash-1017平均耗时35.50分钟,仍短于Kimi;MiniMax-M3.1-Flash为47.30分钟,与Kimi较为接近。耗时包含模型交互、工具执行、编译与测试等完整流程,反映端到端执行效率,不直接等同于模型的Token生成速度。
4.交互效率:Kimi-K3.1-Pro较Kimi-K3交互更少,完成率更高
Kimi-K3.1-Pro平均每任务交互110.76轮,较上一代的127.20轮减少12.92%,得分则从41.18分提升至70.59分。与DeepSeek-V4.1-Flash-1017的111.94轮相比,两者交互投入接近,Kimi在本轮取得了更高的任务通过率。
5.Token消耗:从用量构成看Kimi-K3.1-Pro的任务成本
按非缓存输入、缓存命中与输出Token相加,Kimi-K3.1-Pro平均每任务累计消耗约1429.78万Token,较上一代的1587.48万降低9.93%。其中,非缓存输入约21.75万、缓存命中约1400.98万、输出约7.04万,累计用量主要来自多轮交互中的缓存读取。DeepSeek-V4.1-Flash-1017平均每任务约消耗1755.00万Token,高于Kimi,但任务费用更低。
联系我们