五度妙笔
 企业透视镜
 API商城

 数据库
SWE-Agent中文软件工程测评更新:10款模型全新题目实测
本次测评针对 Agentic 环境下的中文软件工程任务开展测试,选取 10 款国内模型作为参测对象,采用一批全新题目,全程在断网环境下完成。
测评统一使用 mini-SWE-Agent 智能体框架,模型通过多轮交互完成软件工程任务,每道题平均运行约 100 步。
相关文章参考:
SWE-Agent中文软件工程最新补测结果出炉!
Agentic Coding软件工程中文测评-案例研究(SC-Agent)
# 榜单概览

一、统一智能体框架,以全新题目评估中文软件工程能力
所有参测模型统一使用 mini-SWE-Agent 智能体框架。 该框架组织模型与开发环境之间的命令行交互,将模型决策、命令执行与结果反馈串联起来,支持模型通过多轮操作查看代码、修改实现和运行测试。框架的工作方式可参见 mini-SWE-Agent 官方文档。
测试在断网环境下开展,以任务通过情况统计得分。模型版本及思考档位按成绩表原始名称标注,结果反映各参测配置在任务集上的表现。
各项指标的含义如下:
- 得分
:通过任务数 ÷ 测试任务数 × 100,采用百分制,作为榜单的排序依据。 - 单题平均步数
:按运行记录统计的平均交互步数,反映任务执行的交互规模。 - 单题平均输入、输出 Token
:按成绩表统计;图中单位为百万 Token,即 M。 - 单题平均价格
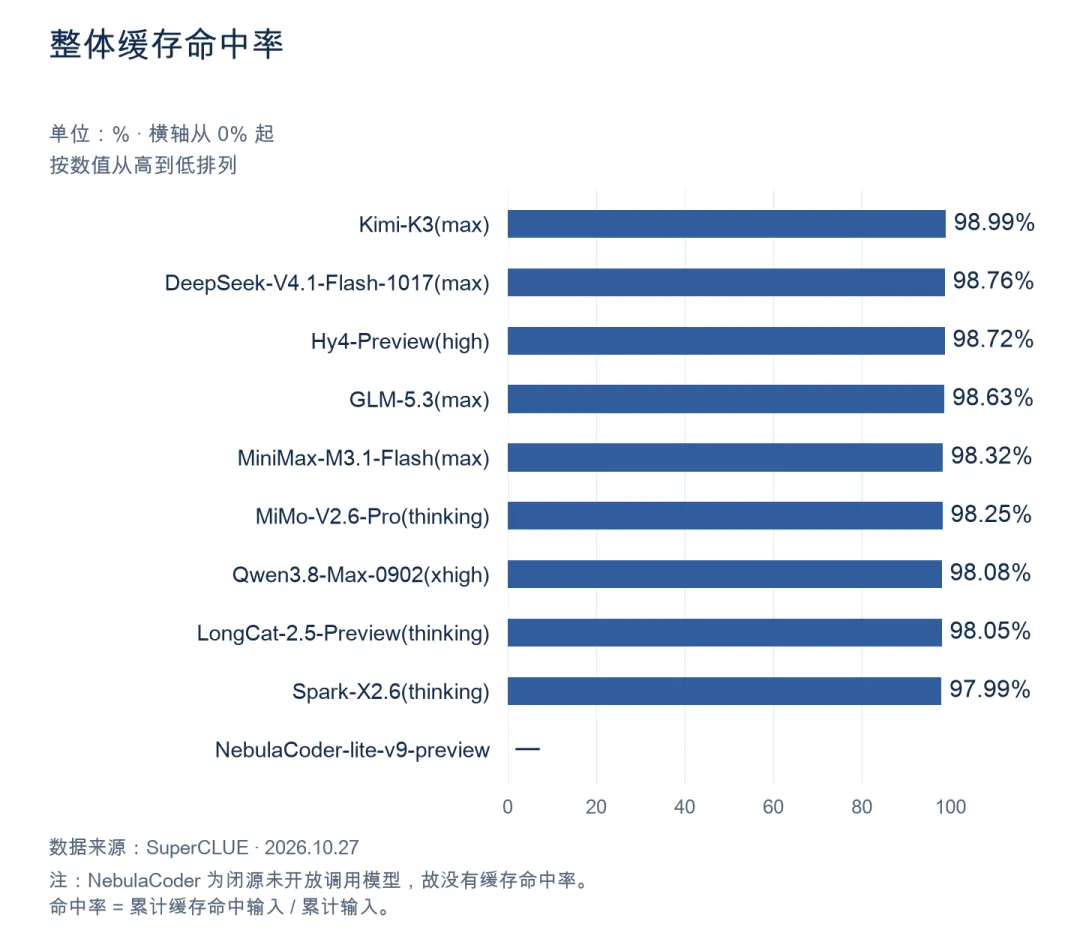
:采用 API 原价口径,按每题平均调用费用展示。 - 整体缓存命中率
:累计缓存命中输入 Token 占累计输入 Token 的比例。
二、DeepSeek得分领先,模型间任务完成表现存在差异

DeepSeek-V4.1-Flash-1017(max) 的得分为 60,领先 GLM-5.3(max) 和 Kimi-K3(max) 4 分。GLM 与 Kimi 均为 56 分,构成第二名组。
NebulaCoder-lite-v9-preview 与 Qwen3.8-Max-0902(xhigh) 均为 52,并列第三。其中,NebulaCoder-lite-v9-preview 的模型大小为 125B。MiniMax-M3.1-Flash(max) 与 Spark-X2.6(thinking) 同为 48 分;MiMo-V2.6-Pro(thinking) 与 Hy4-Preview(high) 同为 44 分;LongCat-2.5-Preview(thinking) 为 36 分。
从任务完成情况看,榜单前五款模型均超过 50 分,已能完成过半测试任务,说明多款模型具备在统一智能体框架下处理这批中文软件工程问题的能力。
三、多数模型单题平均交互超过百步

Hy4-Preview(high) 的单题平均步数为 137.0 步,是本次测试最高值;Spark-X2.6(thinking) 为 129.9 步,Kimi-K3(max) 为 123.5 步。DeepSeek 的平均步数为 73.8 步,是本次测试最低值,同时取得了最高得分。
四、不同模型的Token投入呈现明显分化
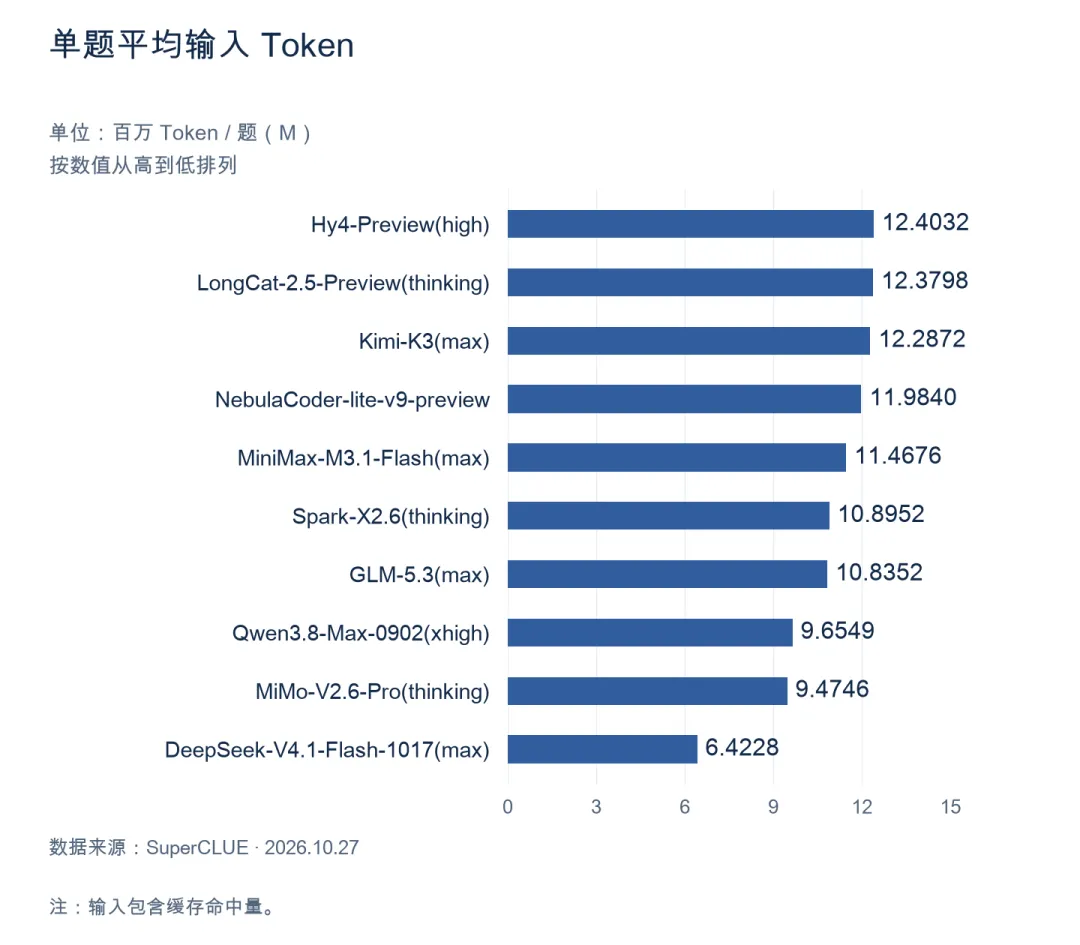
单题平均输入量最高的是 Hy4-Preview(high),为 12.4032 M;LongCat 为 12.3798 M,Kimi 为 12.2872 M。DeepSeek 为 6.4228 M,是这次测试最低值。
同分模型之间,输入投入呈现出清晰差别。GLM 与 Kimi 同为 56 分,平均输入分别为 10.8352 M 和 12.2872 M,GLM 每题少输入 1.4520 M Token。NebulaCoder 与 Qwen 同为 52 分,前者平均输入比后者多 2.3291 M Token,而平均交互步数仅相差 1.8 步。在这两组对照中,GLM 与 Qwen 以更低的平均输入开销取得相同得分;NebulaCoder 与 Qwen 则在接近的交互步数下,呈现出不同的累计输入规模。
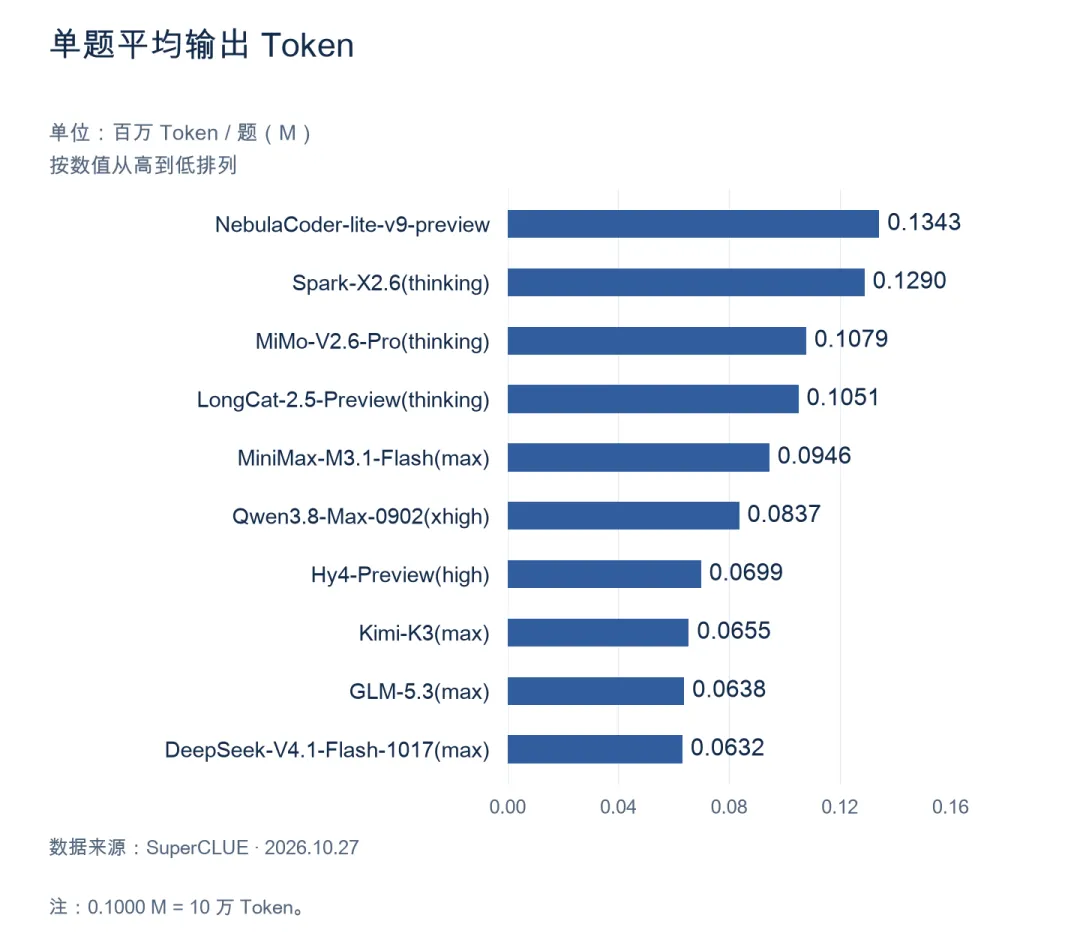
输出方面,NebulaCoder 的单题平均输出量为 0.1343 M,即约 13.43 万 Token,是这次测试最高值;Spark 为 0.1290 M,MiMo 为 0.1079 M。DeepSeek 与 GLM 分别为 0.0632 M 和 0.0638 M。
NebulaCoder 与 Qwen 的得分相同,但前者输入为 11.9840 M、输出为 0.1343 M,均高于 Qwen 的 9.6549 M 和 0.0837 M。这表明,同等任务得分可以对应不同的交互和 Token 用量结构。
五、DeepSeek以最低单题费用取得最高得分
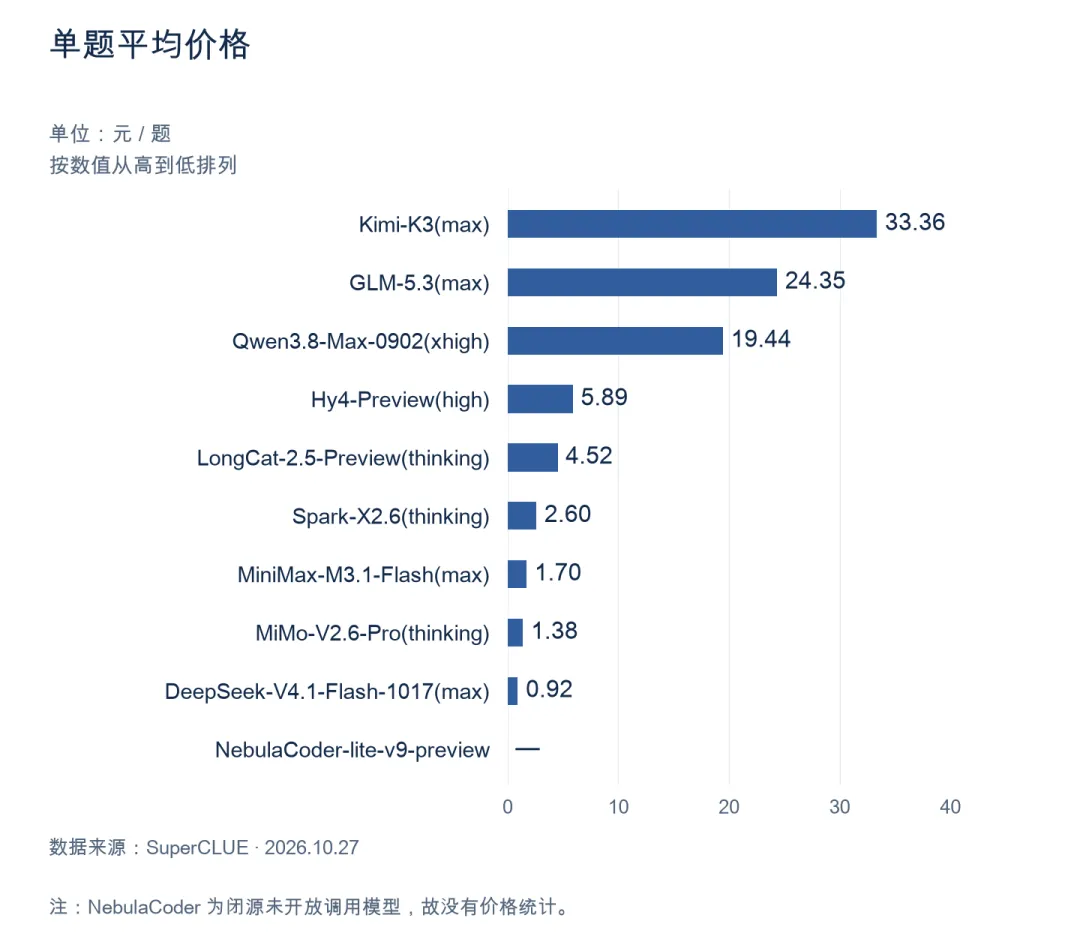
在已提供价格的 9 款模型中,Kimi 为 33.36 元/题,GLM 为 24.35 元,Qwen 为 19.44 元;DeepSeek 为 0.92 元/题,MiMo 为 1.38 元,MiniMax 为 1.70 元。
DeepSeek 同时取得最高得分和最低单题平均价格。Kimi 与 GLM 同为 56 分,但单题平均价格分别为 33.36 元和 24.35 元,说明相同得分下仍需单独比较调用成本。