
 五度妙笔
 企业透视镜
 API商城

 数据库
2026年11月中文大模型基准测评结果发布!Kimi-K3.1-Pro国内第一,韩国模型Darwin首次上榜!

SuperCLUE团队
2026/11
点击 文末阅读原文 或 复制下方网址到浏览器 即可跳转SuperCLUE官网查看完整的测评内容:
SuperCLUE官网地址:www.superclueai.com

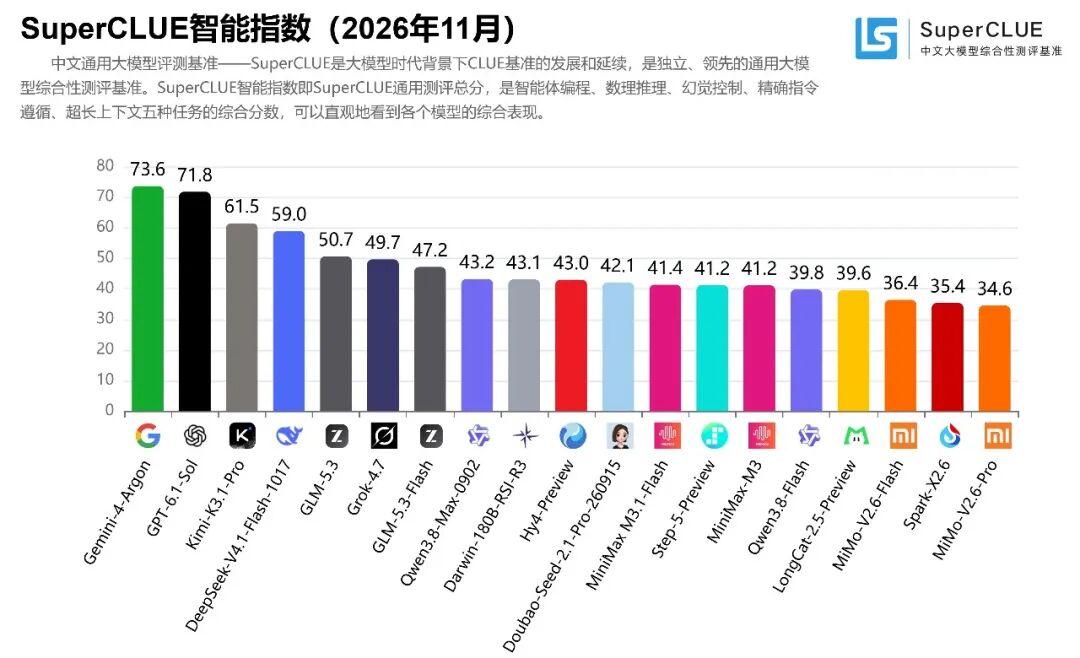
一、SuperCLUE智能指数(2026年11月)

三、实际花费数据统计(2026年11月)


中文大模型测评基准SuperCLUE持续对国内外大模型的发展趋势和综合效果进行实时跟踪,本次2026年11月通用基准测评共有19个国内外模型参与,测评集包括五大任务:智能体编程、数理推理、超长上下文、精确指令遵循、幻觉控制。
本次测评权重向智能体编程能力适度倾斜(30%),突出模型在编程智能体场景中的表现;数理推理(24%),强调逻辑推导、定量分析;幻觉控制与精确指令遵循各占18%,关注可靠性及规范准确遵循;超长上下文占10%,在保留对长文本理解与信息关联能力考察的同时,考虑到不同模型支持的上下文窗口长度存在差异。最终权重占比为:
智能体编程:30%
数理推理:24%
幻觉控制:18%
精确指令遵循:18%
超长上下文:10%


测评摘要
Gemini-4-Argon(73.62分)位居总榜第一;Kimi-K3.1-Pro(61.46分)位列国内第一,DeepSeek-V4.1-Flash-1017(58.95分)位居国内第二。
2. 编程能力分化明显,头尾差距显著。
GPT-6.1-Sol以69.23分领先,DeepSeek-V4.1-Flash-1017以65.38分位居国内第一,超80%模型得分低于60,模型间梯队差异明显。
3. 五类任务分化不一,国内模型仍有较大进步空间。
综合五类任务来看,国内头部模型在超长上下文、指令遵循与幻觉控制三大任务上与Gemini等国外顶尖模型相比差异突出,需重点提升指令执行准确性、减少幻觉,并增强长文本处理的稳定性。
测评结果与分析
一、智能体编程对比分析
1. GPT-6.1-Sol领跑,DeepSeek位居国内第一,超八成模型低于60分。

题目超时表现:GPT与Kimi零超时,部分模型超时占比过半
本次测评以单题3小时为答题时限,超过时限仍未完成的题目记为超时,视为未能在规定时间内正常完成该题。
从超时统计来看,Qwen3.8-Max-0902的超时题目占比最高,达69.23%,Spark-X2.6以57.69%次之,两者均有超过半数题目触发超时;Grok-4.7与MiMo-V2.6-Pro的超时占比分别为42.31%和38.46%,也处于较高水平。部分模型仍需优化任务规划与时间预算管理,提升执行效率,以提高规定时限内的任务完成率。

交互轮数与任务表现:更多交互不等于更高得分
从交互效能来看,GPT-6.1-Sol以14.58轮/题的最低交互量取得69.23分,位居编程榜首;Kimi-K3.1-Pro以20.62轮/题取得57.69分,位居国内第二,两者的交互轮数均低于整体均值。相比之下,Step-5-Preview平均交互88.88轮/题,为全场最高,编程得分为46.15分;MiniMax-M3平均交互59.96轮/题,得分42.31分。这表明,较多的交互轮次并不必然转化为更高的任务得分。

Token消耗差异显著:最高约为最低的13倍
各模型在单题平均总Token消耗上呈现明显差异:GPT-6.1-Sol以30.89万Tokens/题位居最低,Kimi-K3.1-Pro以42.73万Tokens/题次之;Step-5-Preview以402.91万Tokens/题位居最高,约为GPT-6.1-Sol的13.04倍。结合编程成绩来看,GPT-6.1-Sol在本次测评中同时取得最高得分、最少交互轮数和最低总Token消耗,展现出较好的任务执行效率。

二、模型对比分析
1. 国内模型梯队格局清晰,Kimi-K3.1-Pro领跑国内模型,DeepSeek紧随其后。
Gemini-4-Argon以73.62分领跑榜单,Kimi-K3.1-Pro以61.46分位居国内第一,DeepSeek-V4.1-Flash-1017以58.95分排名第二,两者相差2.51分;GLM-5.3以50.66分位列第三,GLM-5.3-Flash以47.18分排名第四;中部模型如Qwen3.8-Max-0902(43.22)、Darwin-180B-RSI-R3(43.08)、Hy4-Preview(42.96)、Doubao-Seed-2.1-Pro-260915(42.06)等模型分数接近,分差较小。国内榜单呈现头部模型领先、中游模型分数接近的梯队格局,多款模型之间竞争密集。

2. 六大任务对比图
(1)智能体编程
GPT-6.1-Sol以69.23分领跑智能体编程榜单,DeepSeek-V4.1-Flash-1017与Gemini-4-Argon均获65.38分,并列第二,其中DeepSeek位居国内第一。Kimi-K3.1-Pro以57.69分位列国内第二,GLM-5.3以53.85分位列国内第三,智能体编程能力呈现梯队分化格局。

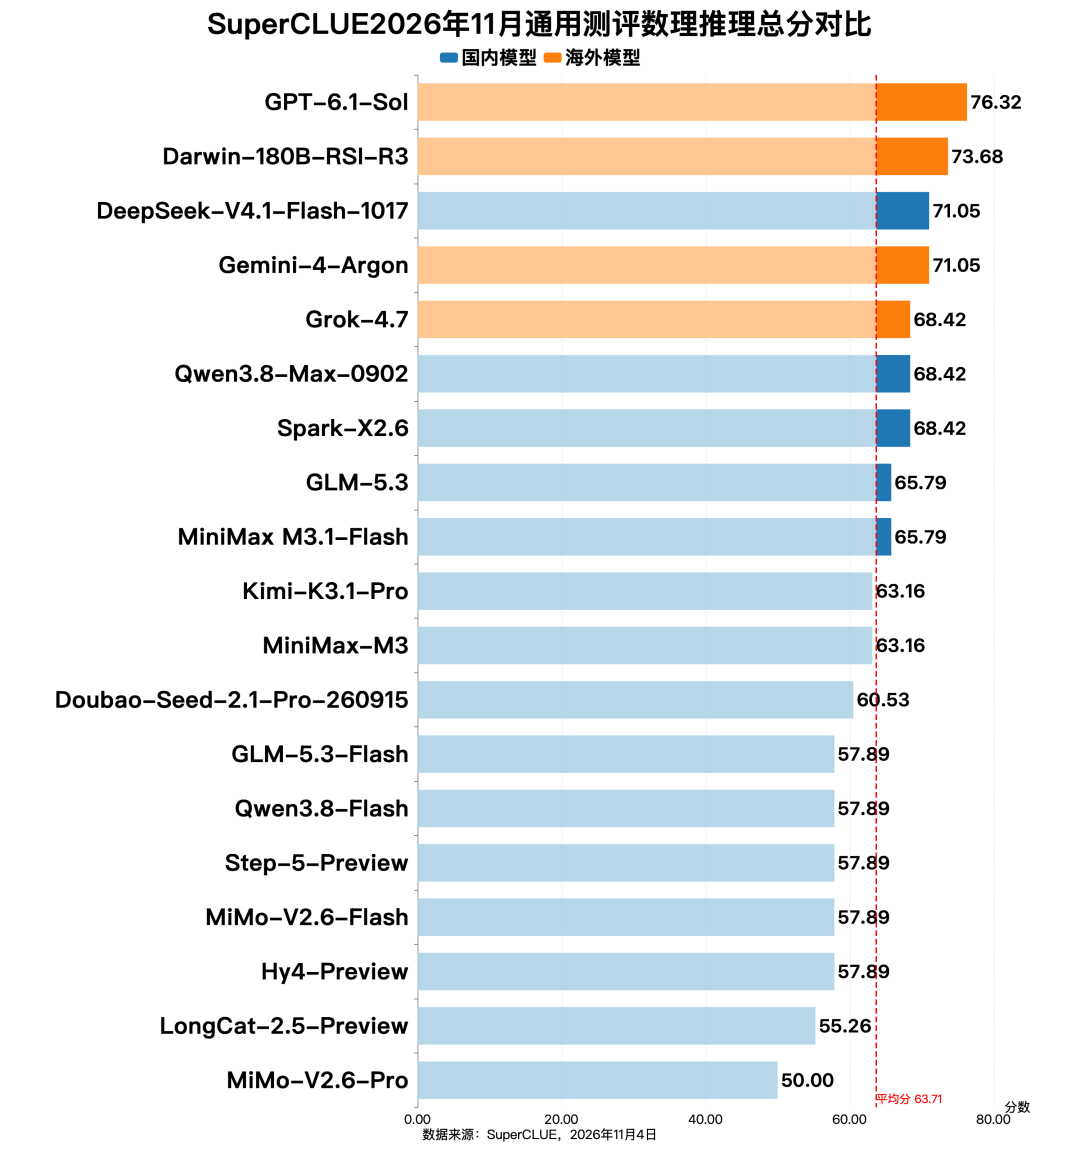
(2)数理推理
GPT-6.1-Sol以76.32分领跑数理推理榜单,Darwin-180B-RSI-R3(73.68分)位列第二,DeepSeek-V4.1-Flash-1017与Gemini-4-Argon均获71.05分,并列第三,其中DeepSeek位居国内第一。Grok-4.7、Qwen3.8-Max-0902与Spark-X2.6紧随其后,头部模型竞争较为接近。
(3)超长上下文
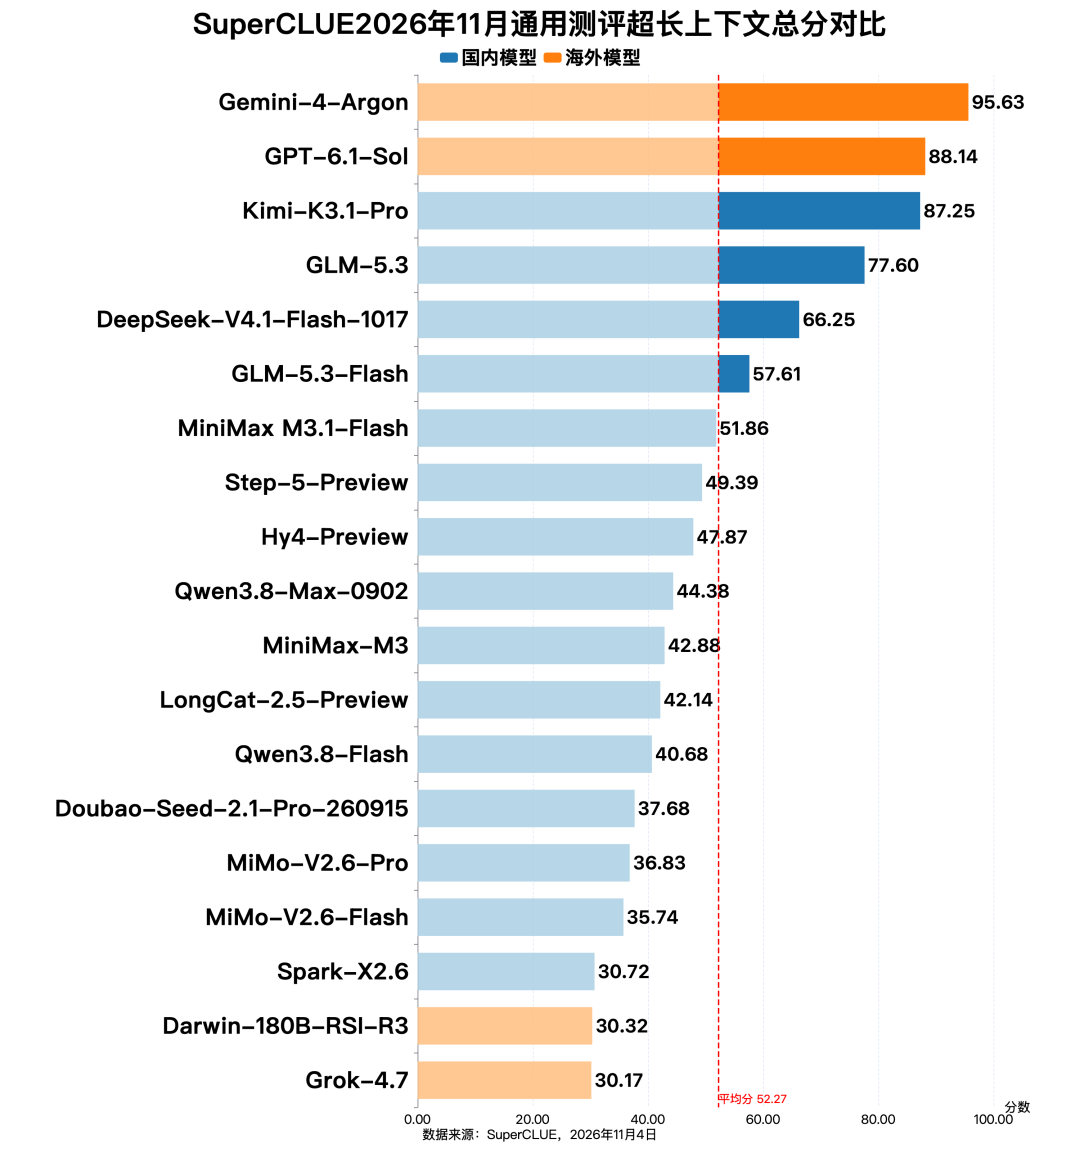
Gemini-4-Argon以95.63分领跑超长上下文榜单,GPT-6.1-Sol以88.14分位居第二,Kimi-K3.1-Pro以87.25分位列第三、国内第一。GLM-5.3(77.60分)与DeepSeek-V4.1-Flash-1017(66.25分)分列国内第二、第三,前三款模型均超过85分,与尾部模型差距明显,长上下文能力呈现明显分化。
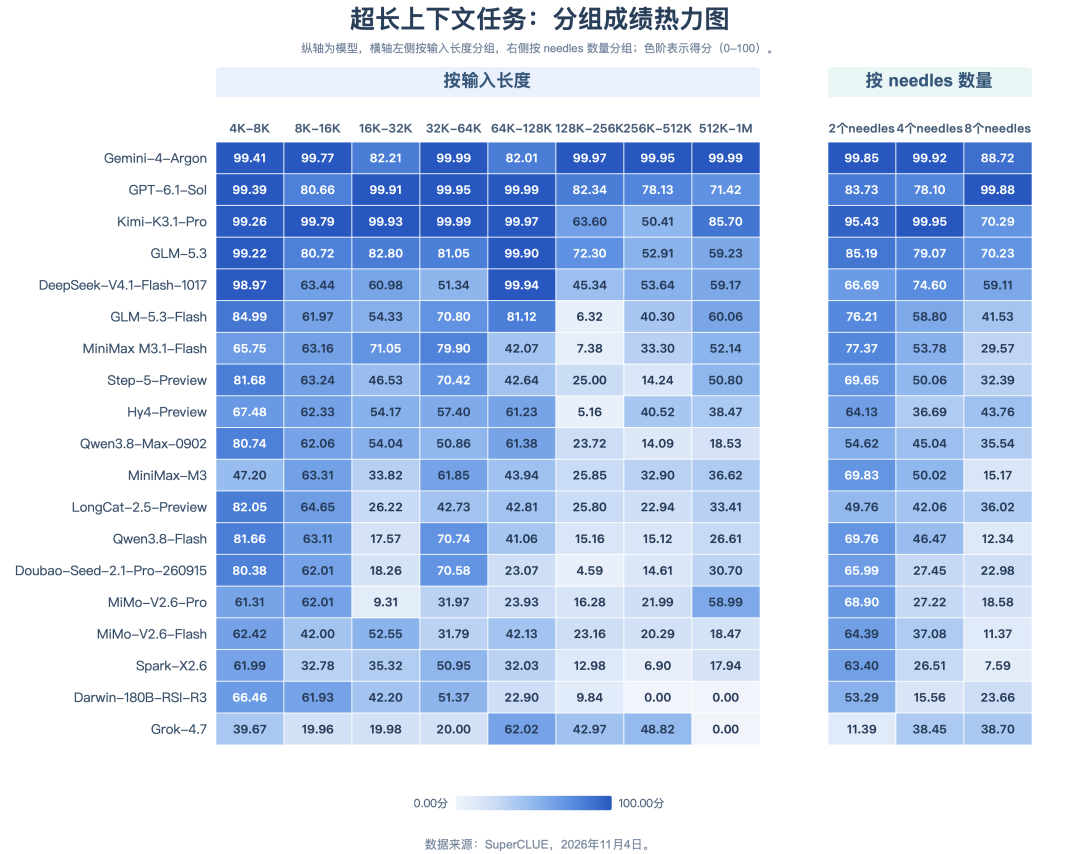
在超长上下文任务上,模型间差异显著:
在不同输入长度与检索目标(needles)个数上,不同模型能力表现差异明显。在极长文本处理与多目标检索上,Gemini-4-Argon在512K–1M输入长度组中领先,Kimi-K3.1-Pro与GPT-6.1-Sol位居第二、第三,多数模型得分不足60分;而在8个needles的任务组中,GPT-6.1-Sol位居第一,Gemini-4-Argon排名第二,体现出不同模型的优势差异。
(4)精确指令遵循
GPT-6.1-Sol与Gemini-4-Argon均获68.97分,并列精确指令遵循榜单第一。Kimi-K3.1-Pro以44.83分位列第三、国内第一,DeepSeek-V4.1-Flash-1017以43.10分位居国内第二,Hy4-Preview以31.03分位列国内第三,榜首两款模型与其余模型拉开明显差距,国内模型仍有较大进步空间。

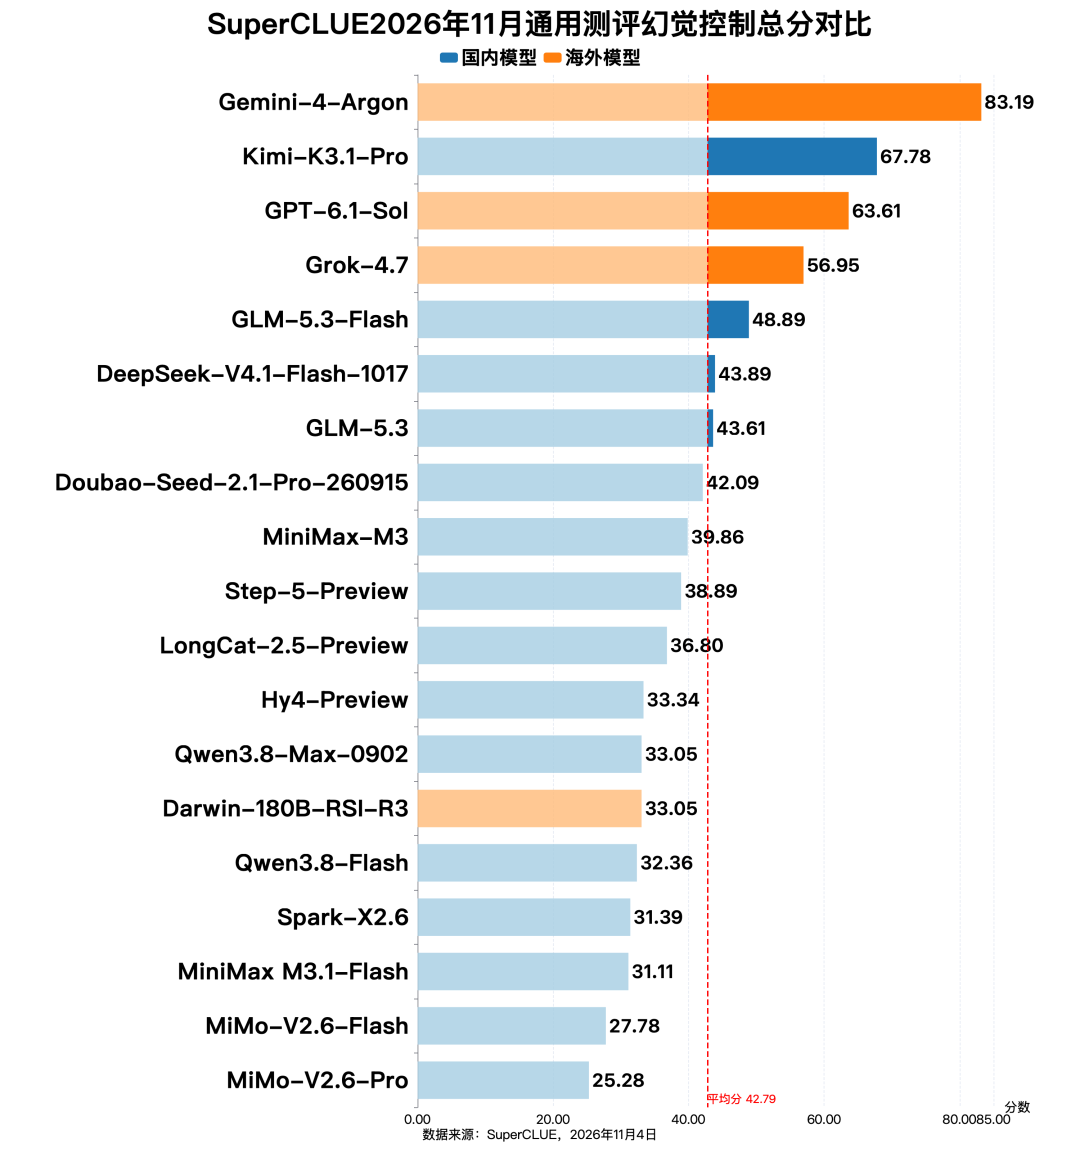
(5)幻觉控制
三、性价比区间分布(2026年11月)
国产模型主导中高性价比区,DeepSeek与GLM-5.3-Flash表现突出。
DeepSeek-V4.1-Flash-1017与GLM-5.3-Flash以较低的API价格实现了较高的推理质量,位于高性价比区;中性价比区包括GLM-5.3、Hy4-Preview、Doubao-Seed-2.1-Pro-260915、MiniMax M3.1-Flash、Step-5-Preview和MiniMax-M3六款模型;Kimi-K3.1-Pro、Gemini-4-Argon、GPT-6.1-Sol、Grok-4.7和Qwen3.8-Max-0902虽能力表现尚可,但API价格较高,落入低性价比区。

*Darwin-180B-RSI-R3为开源部署模型,暂不统计API价格与成本。
具体开源地址可见:https://huggingface.co/FINAL-Bench/Darwin-180B-RSI-R3。
测评的更多详细内容,请点击文章下方 阅读原文 或 复制以下链接到浏览器 查看:
https://www.superclueai.com


扩展阅读
[1] CLUE官网:www.CLUEBenchmarks.com
[2] SuperCLUE排行榜网站:www.superclueai.com
[3] Github地址:https://github.com/CLUEbenchmark/SuperCLUE


