
 五度妙笔
 企业透视镜
 API商城

 数据库
人类视频教机器人总学不像?视频大模型自带通用"动作语言"
单击上方“图灵人工智能”,选择“星标”公众号
您想知道的人工智能干货,第一时间送达
一、论文信息与一句话结论
- 英文标题
:DreamX: Video Diffusion Model is a Universal Latent Action Learner - 论文链接
:https://arxiv.org/abs/2611.05377 - 完成单位
:KAIST(韩国科学技术院,第一单位)与 NVIDIA - 发布时间与状态
:2026 年 11 月 3 日首次提交 arXiv(cs.CV),所依据版本为 v1,目前是预印本(Preprint),尚未见正式发表记录 - 项目页
:https://cvlab-kaist.github.io/DreamX (页面标注"Code soon",代码尚未发布)
一句话结论:作者把预训练的因果视频扩散模型(Cosmos-Predict2.5 2B)直接当"动作提取器",用可学习查询从模型内部的时空表示里读出每帧仅 4 个 token 的潜在动作,在人类视频与机器人视频混合训练后,这套"动作语言"能跨身体、跨场景迁移,甚至不需要任何人类—机器人配对数据。
这项工作值得读的地方在于:它不是又造一个"潜在动作编码器",而是把视频生成模型本来就要学的"场景怎么随时间变化"这件事,直接当成动作监督信号——生成模型越会想象未来,它的内部表示就越接近"动作"。这是把两个原本分开的领域(视频生成、机器人策略)用一个信息瓶颈拧到一起的做法。
二、面向的问题

先讲清任务
具身智能里最贵的东西是数据。训练一个通用机器人策略(VLA 模型)或世界动作模型,需要大量机器人示教轨迹;而网上和数据集里最不缺的,是人自己戴着头显或拿手机拍的第一视角操作视频。所以过去几年一直有条思路:用人类视频教机器人。
麻烦在于"动作"这一层对不上。人类视频没有机器人关节角、没有夹爪开合量这类标签;就算都是机器人,不同型号的控制空间也不一样——同一个"把杯子推过去"的动作,在一台机器上是 7 维关节指令,在另一台上可能是末端位姿增量。低层动作标签无法直接共享。
于是出现了一类折中方案,叫潜在动作模型(Latent Action Model,LAM):不要求动作标签,而是从视频里学一个"压缩的中间表示",代表"这一帧到下一帧发生了什么变化",这个表示就叫潜在动作(latent action)。典型做法是"逆动力学—前向动力学"瓶颈:一个编码器把相邻帧的差异压成一个向量,一个解码器只用"当前帧 + 这个向量"去重建下一帧。因为编码器被强制压得很小,它只能保留"变化本身"。
现有方法的真正瓶颈
问题在于:重建准确,并不等于动作被隔离出来。
只要对重建有利,编码器完全可以把"这是哪个视角""场景是什么样""哪个身体在做"也编进潜在动作里——这种做法在训练分布内反而更容易拿低重建误差。结果是潜在动作被绑死在训练时的身体和场景上,换个身体就失效。
这个判断有直接的数字支撑。作者在 LARYBench(专门评测潜在动作表征质量的基准)上报告:做得最好的基线 DiLA,动作回归 MSE 是 0.38,动作分类准确率只有 62.25%;用相邻帧对训练的经典方法 LAPA 更差(MSE 0.97、分类 20.17%)。分类准确率刚过六成,说明这个"动作表示"里混了大量与动作无关的视觉信息。
论文要解决的正是这个问题:能否从视频里学到一个跨身体共享、与外观解耦的动作表示? 范围限定在操纵类任务(人类第一视角视频 + 机器人示教),评测覆盖表征质量、跨场景/跨身体的视频迁移、人类到机器人的动作迁移,以及把它当策略预测目标的下游应用。
三、方法直白讲解
先给一个贯穿全文的直觉(这是解释性类比,不是论文原话):把预训练视频模型想象成一位看惯了各种视频的"老导演",它内部已经知道"画面接下来应该怎么动"。DreamX 做的事情,是往这位老导演的工作流程里插进几个"提问员"(可学习查询),让它们看着画面提出"这一段到底在做什么动作",老导演则用自己的想象能力去验证——如果只告诉它首帧和这几个提问员的答案,它能不能把后面几帧还原出来。
具体流程如下。
输入:一段视频(人类第一视角或机器人示教,2–8 个 VAE 潜帧,对应 5–29 帧画面),加一句语言指令(如"close the drawer")。
第一步:把画面变成 token。 视频先经因果 VAE 压成潜帧序列,每帧再切成空间 patch,一帧大约 1200 个 token。
第二步:插入查询 token,读出"动作"。 在一帧的 token 序列末尾插入 4 个可学习查询 token,让它们和视频 token 一起过骨干的时空注意力。查询在注意力里"看"画面,输出特征就汇总了"到目前为止画面在怎么变"。每个潜帧对应一组 4 个查询,整段最多 32 个。这一步把一帧 1200 个 token 压成 4 个——300 倍压缩。关键约束是:查询看视频的注意力是"帧因果"的,第 g 帧的查询只能看到第 0 到第 g 帧,看不到未来;但查询之间可以自由互看,便于整段协调。
第三步:用生成来监督。 同一个骨干再当解码器:把首帧和所有查询输出一起喂进去,让它重建后面几帧。注意这里不给文本条件。首帧已经提供了"场景长什么样",生成先验负责补"细节应该长什么样",于是唯一还需要解释的就是"动作怎么发生"——监督信号就会把查询输出往"纯运动信息"上推。
第四步(可选):动作标签辅助。 如果这段视频有机器人动作标签,解码器额外解出一段低层动作 chunk,作为辅助任务。没有标签就只算视频损失。
第五步(推理):两种用法。
- 视频迁移
:冻结编码器,从源视频提取潜在动作,配上目标域的首帧,让解码器生成"目标场景 + 源动作"的视频。 - 动作迁移
:同一份潜在动作,配上目标机器人的初始本体感受状态,直接解码成可执行的关节指令——过程中不需要看任何人类—机器人配对数据。
第六步(下游):当策略的预测目标。 潜在动作每个 token 仍是骨干的完整宽度(2048 维),直接做扩散预测维度太高,所以先学一个变分瓶颈把每个 token 压到 32 维(保持 token 布局不变,32×2048 → 32×32)。之后训练策略:给定当前画面和指令,预测这串 32 维紧凑码,再由一个独立的动作头输出低层动作。执行时策略不再生成未来视频,只吐码和动作——这是它比"视频生成式策略"快一个数量级的原因。
训练阶段与推理阶段的区别要记住:训练时编码器和解码器一起学(骨干冻结,只训 LoRA 与查询);推理做迁移时两者都冻结,只做前向;策略阶段则换成"预测紧凑码"的生成器加动作头。
四、方法深度解析
整体框架

图 2(a) 是两条腿共用一副骨架:上半支是编码,视频 token 与查询 token 拼在一起过时空注意力,查询输出形成潜在动作组;下半支是解码,潜在动作与首帧共同条件化解码器输出未来帧(以及可选的机器人动作)。图 2(b) 给出注意力掩码,这是整套设计成立的关键:
编码侧:查询→视频的注意力是帧因果的,第 g 组查询只能看 ;查询→查询不受限。 解码侧:潜在动作查询只作为条件,自己不参与注意力;视频流与动作流互不可见,但都各自看对应前缀——第 t 帧视频看 ,第 m 个动作 chunk 看 。
这个掩码安排解决了一个很实际的矛盾:潜在动作必须"因果"(不能偷看未来,否则推理时用不了),但又必须"整段协调"(相邻帧的动作要连贯)。把两种情况分开放在两条注意力通路上,恰好做到。
核心公式与逐项解释
以下符号与原文一致: 是潜帧序列( 形式的空间 token 集,); 是可学习查询; 为每组查询数; 为干净视频潜变量, 为噪声, 为噪声等级; 为条件(首帧与文本的合并记法); 为机器人本体感受状态; 为动作损失权重。
(1)视频扩散的预训练目标(原文式 1)
先做插值:,即把干净潜变量与噪声按 线性混合。模型 被训练去预测"从噪声指向数据"的速度场:
为什么目标写成 而不是 ?因为 flow matching 的直线路径上,从 走到 的方向正是 ,网络学的是这条路的方向与速率。这一项是整个方法的"地基":它让骨干在大量视频上学会"给定首帧和条件,未来应该怎么演化"的先验。
(2)编码:查询读出潜在动作(原文式 2)
就是冻结骨干加上 LoRA 适配器与查询嵌入; 是语言指令,仍走骨干原有的交叉注意力。输出 , 最多 32。这一式没有新的"编码器网络"——动作表示是从骨干已有的时空表示里读出来的,不是另起炉灶训的。这正是与 AdaWorld、VideoWorld 2 一类方法的分界线:那些方法把视频模型当生成器(供像素、供 rollout),动作表示由外部模块从帧对上学;DreamX 让动作表示直接住在骨干内部。
(3)解码:以动作为条件重建未来(原文式 3)
三个条件各管一件事: 管"怎么动", 管"长什么样", 管"从哪个初始状态出发"(仅在有动作标签时参与)。 是重建的未来潜帧, 是解出的低层动作 chunk。
这里有一个容易被忽略但决定成败的设计:解码时不给文本 。如果给文本,"把抽屉关上"这句话已经把动作说完了,潜在动作就成了冗余条件,梯度不会奖励它编码运动。去掉文本之后,解码器只知道"首帧 + 潜在动作",而首帧本身不含未来信息,于是潜在动作不得不承担"解释未来变化"的全部责任。
(4)总目标(原文式 4)
与 同构(式 1 的形式),只是作用在动作 chunk 上。 用于没有动作标签的视频(人类视频全是这种情况)。训练时编码器与解码器端到端优化,骨干权重冻结,只更新编码/解码两侧各自的 rank-16 LoRA 和查询嵌入——这也是为什么 78,000 步就能适配完一个 2B 模型。
(5)迁移:一份动作,两个出口(原文式 5)
左边是视频迁移,右边是动作迁移。两式共用同一个 ,区别只在第二个条件换成"目标首帧"还是"目标机器人状态"。可以这样理解: 描述"运动本身",第二个条件描述"在哪个身体、哪个场景里落地"。作者明确说明,跨身体迁移不是训练目标,而是预训练自然带来的能力,迁移阶段不做任何额外训练。
(6)策略接口(原文式 6、7)
策略不是直接回归 2048 维的潜在动作,而是先经变分瓶颈压成 32 维码 再预测(瓶颈细节见式 8、9)。式 7 的两项分别监督"紧凑码预测"和"低层动作预测",人类视频只有前一项有监督(),机器人示教则两项都有。动作头与潜在码特征之间的注意力是单向的(动作看码,码不看动作),避免动作标签反过来污染潜在码。
(7)变分瓶颈(原文式 8、9,附录 A.3)
式 8 是重参数化采样, 为逐元素乘;式 9 中重构项保证码里留住信息,KL 项把后验拉向标准高斯,。瓶颈是单层自注意力加六层 Transformer 解码器,把每个 2048 维 token 压到 32 维、布局不变(32×2048 → 32×32),训练 50,000 步;推理时取后验均值 ,得到确定性码。
(8)扰动分析(原文式 10,附录 C.3)
是按训练特征统计出的逐通道标准差, 控制扰动强度。这一式不是模型的一部分,而是用来做"因果探针":固定首帧与噪声,只扰动潜在动作,看解码输出的运动变了多少、外观变了多少。结果见下一部分。
为什么这套设计能把"动作"和"外观"分开
这一节区分三类信息:作者明确陈述的设计意图、原文数据支撑的现象、以及我基于机制的分析推断。
作者的设计意图很直接(原文 3.2 节):首帧提供场景外观,预训练生成先验提供合理演化,因此潜在动作"被鼓励去编码解释未来所需的运动,而不是解码器已经能拿到的视觉线索"。这是动机陈述,不是形式化证明。
数据支撑的现象有两类。其一是扰动实验(表 8):把潜在动作清零后,平均运动幅度降到原来的 0.456,光流偏差升到 0.866 像素/帧,整图 RGB 变化 0.0758——但静态区域的 RGB 变化只有 0.0227,明显更小。也就是说,抹掉动作,画面"不动了",场景外观大体还在。其二是注意力可视化(图 8):查询对人还是对机器人,注意力都落在正在动作的手和夹爪上。
我的分析推断是:这套机制的有效性依赖两个条件同时成立——(a) 骨干在训练分布内确实有强生成先验(这里是在 2.19k 小时人类与机器人视频上继续适配了 78,000 步,不是拿通用视频模型直接零样本用);(b) 首帧确实携带了足够的外观信息。若换到先验很弱的新域(例如从未见过的传感器、极端光照),"解码器自己补外观"的假设会退化,潜在动作就可能重新被迫携带外观信息——这一点论文没有做跨域压力测试,是后文局限部分的讨论点。
下游应用的数据流

图 3(a) 与式 5 一一对应:上面一列是"源视频 → 潜在动作",分叉后一路配目标首帧生成视频、一路配目标机器人状态解出动作。图 3(b) 展示策略路径:潜在动作先过瓶颈成 32 维码,策略网络(仍是那个视频骨干,换成预测码)从当前帧与指令生成码,动作头再据此输出低层动作。两条路都不需要生成未来视频——这是延迟从 28 秒级降到 1.5 秒级的结构性原因。
五、核心结果与证据
实验条件(理解数字的前提)
- 骨干
:Cosmos-Predict2.5 2B,输入 480×640,训练片段 5–29 帧(步进 4),对应 2–8 个潜帧;每潜帧 4 个查询,最多 32 个。 - 训练
:编码器与解码器各一套 rank-16 LoRA,骨干冻结,共 78,000 步;学习率 (LoRA 与查询)、(其余可训练参数),500 步 warmup。 - 数据
:2.19k 小时、6 个数据集。人类视频 469 小时(EgoDex、EgoVerse);机器人示教来自 Bridge、DROID、AgiBot、MolmoAct2-BimanualYAM。 - 表征评测
:LARYBench,冻结所有表征模型,训练统一的 attentive probe 做动作回归(归一化 MSE,越低越好)与动作分类(准确率,越高越好)。 - 零样本迁移评测
:HumanAndRobot(H&R)数据集,21 个任务、每任务 48 段共 1,008 段;只给人类源视频与配对机器人录制的首帧,其余机器人帧仅作参考,训练未使用任何配对数据;统一取前 20 帧(去掉条件帧后 19 帧)比较 FVD(Kinetics-400 预训练 I3D)、LPIPS(VGG)、PSNR、SSIM。 - 真机
:双臂 YAM 机器人,14 维绝对指令(每臂 6 关节 + 1 夹爪),单目俯视相机;抽屉任务 45 条轨迹训练、每配置 10 次试验。
表征质量(原文 Table 1、§4.1)
| DreamX | 0.15 | 0.05 | 0.17 | 69.67 |
相对最强基线 DiLA:回归 MSE 从 0.38 降到 0.17(下降约 55%,绝对减少 0.21),分类准确率从 62.25% 升到 69.67%(提升 7.42 个百分点,不是百分比)。注意这是"表征探针"分数,不是任务成功率;而且即使压到 32 维的紧凑码(FAE-32)仍优于所有基线,说明大部分动作信息保留在低维码里。
零样本人类→机器人视频迁移(原文 Table 2、§4.2)
| DreamX | 57.44 | 0.179 | 26.52 | 0.917 |
FVD 从 170.19 降到 57.44(相对下降约 66%),LPIPS 从 0.299 降到 0.179。四点全胜,是这一部分最强的证据:训练时完全没见过配对数据,输出却在"运动对得上、外观是机器人"两个维度同时更好。作者给的解释是基线在分布外会出现视觉退化(AdaWorld)或"漏出人手"(VideoWorld 2),而 DreamX 的潜在动作更干净地把运动与外观分开——这是作者解释,数字本身只证明生成结果更接近参考。
动作迁移的真机定性证据(原文 Figure 6、§4.3)
从人类示教视频提取潜在动作,直接解码成机器人关节指令并开环执行(执行时无视觉反馈,只有潜在动作与初始本体状态,见附录 B.2)。展示的三类运动能读出潜在动作保留了多少结构:写字任务里,右夹爪夹住马克笔复现出字母"N"的笔画结构,而不只是"画了个东西";单臂推动任务里,机器人按"先前推、再左推"的顺序执行,说明方向的先后关系被保留;双臂推动里,两只手臂各自做出对应动作,说明按臂区分的运动没有在共享表示里被抹平。
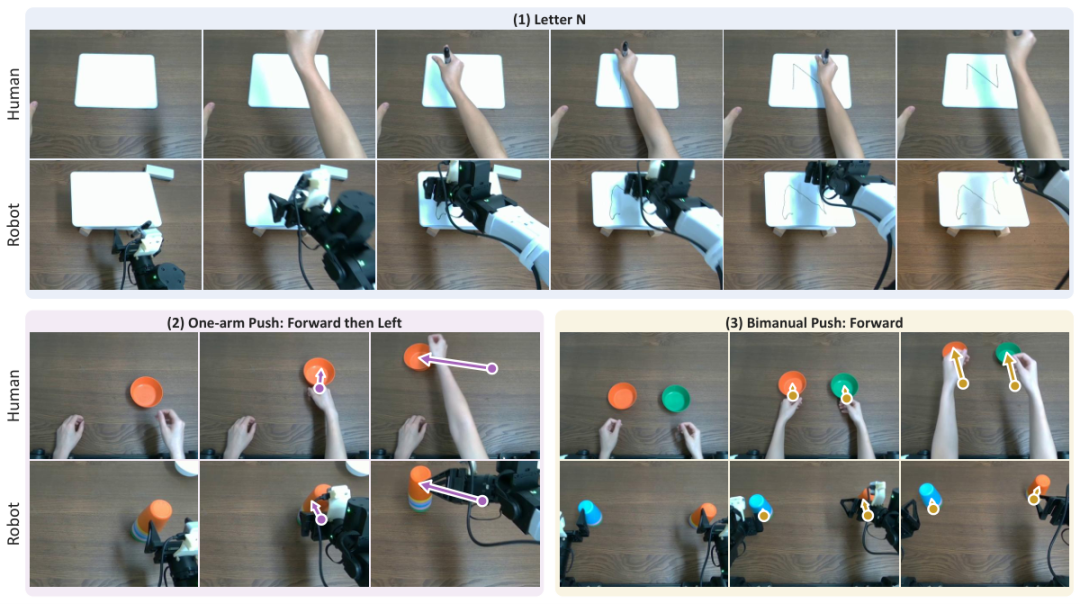
需要说明的是,这三类任务只给了定性结果,论文没有报告这些开环轨迹的执行成功率,也没有量化误差;它证明的是"结构能保留",不是"可靠可复现"。
真机策略与延迟(原文 Table 3、Table 5、§4.4)
| DreamX(预测紧凑码) | 90.0 / 100.0 / 100.0 | 96.7 | 1,474 |
平均子目标成功率 96.7% 对 50.0%(高 46.7 个百分点),延迟降低到约 1/19(19.1 倍加速,作者标注)。子目标拆开看(Table 5):Mimic-Video 的"推到"完成率是 20%/0%/0%,DreamX 是 80%/100%/100%——差距主要在"真的把抽屉关上"这一步,而不只是"靠近抽屉"。另外作者在附录 C.1 补充了一个纯人类数据训练的实验(Table 6):上层抽屉配置只用人类视频监督潜在码预测,子目标成功率 100%,说明人类视频确实能独立承担一部分监督。
同时必须如实报告一处不显著的结果(原文 Table 4、§4.5):加入动作标签辅助监督后,LARYBench 回归 MSE 从 0.24 微降到 0.23,分类准确率反而从 65.3% 微降到 64.8%。作者的解读是"性能相当,说明 DreamX 仅从视频就能抓住运动与动作语义"。这个解读方向合理,但严格讲,该消融只在一个数据子集上做,且分类上确实是退步——它证明的是"动作标签不是必需",而不是"动作标签有害"。
消融与机制证据(原文 Table 7、Table 8、图 7、图 8)
- 潜在码条件是否有效
(Table 7,CALVIN):策略若不能看潜在动作特征,完成至少 5 连任务的比率 20.4%,能看则 25.7%;平均完成长度 2.378 → 2.643。增益真实但幅度不大。 - 扰动敏感性
(Table 8): 从 0 加到 1.0,运动比例 1.000 → 0.946(几乎不变),光流偏差 0 → 0.481 像素/帧,整图 RGB 变化 0 → 0.0215;清零后运动比例 0.456、光流偏差 0.866、整图 RGB 0.0758、静态区仅 0.0227。这组数字支撑"潜在动作控运动、外观由解码器与首帧控"的分工假设。 - 注意力落点
(图 8):查询在人类与机器人示教上都集中在手/夹爪区域,是"查询确实在读动作"的可视化旁证。 - 跨身体方向结构
(附录 C.3、图 12):2,362 段 RoboCOIN 视频、10 种机器人、6 个末端平移方向,按方向聚类的潜在动作质心在 t-SNE 里呈现跨机器人类型相似的组织——这是聚合层面的旁证,不是逐样本的一致性证明。
六、不足、局限与未来方向
作者明确承认的
原文没有独立的 Limitations 章节,但 Conclusion 与伦理声明给了边界:
跨身体迁移与机器人策略在评测设置之外可能失败,部署前需要安全验证(伦理声明原文意思)。 迁移能力是预训练的"涌现",作者未给出形式化保证,也未做跨身体的显式训练目标。 Reproducibility statement 只承诺补充视频与附录文档,未提代码与权重;项目页当前标注 "Code soon",代码与权重尚未公开。
基于证据的分析推断(我的判断,非作者陈述)
- 真机证据规模小。
只有一个机器人(双臂 YAM)、一个任务族(抽屉)、45 条训练轨迹、每配置 10 次试验。96.7% 由 30 次子目标评估平均而来,统计上置信区间较宽,不能外推为"通用操纵能力"。 - 零样本迁移用的是视频生成指标。
FVD/LPIPS/PSNR/SSIM 衡量"生成得像不像参考视频",不衡量"策略能不能用这段动作完成任务"。这两件事之间的跳跃,论文没有补桥。 - 动作迁移是开环执行的。
附录 B.2 明确说明执行时无视觉反馈,只有潜在动作与初始本体状态。定性展示了写字"N"、单臂推、双臂推,但没有报告执行成功率——这属于"能跑通"级证据,不是"可靠"级证据。 - 对强生成先验的依赖是隐含前提。
迁移与解耦都建立在"解码器能自己补外观"之上。训练在 2.19k 小时人类+机器人视频上继续适配 78,000 步;如果目标域的先验更弱(少见传感器、极端视角、非操纵场景),这套分工可能退化。论文的 DAVIS 例子只是少量定性扩展,不构成跨域压力测试。 - "Universal" 的覆盖范围有限。
两个具身(人、双臂 YAM)加若干机器人数据集,控制空间是关节绝对指令;对移动底盘、灵巧手、多指操作的泛化未被检验。 - 计算与部署成本不低。
2B 骨干 + 78,000 步适配 + 瓶颈 50,000 步 + 策略 100,000 步(2×H200、batch 60);推理 1.47 秒/次对高频闭环控制仍偏重,论文也没给显存占用。 - 基线公平性基本可信但需注意。
真机对比中 Mimic-Video 从 MolmoAct 预训练骨干出发、DreamX 从自己的潜在动作生成器出发,两者各训练 30,000 步,规模对齐;但两者的初始化先验不同源,"同预算"不等于"同等先验",这个差异无法从论文中完全排除。 - LARYBench 探针协议的一处口径风险。
附录 B.4 说明回归基准原本每样本只给两帧,作者用元数据回捞中间帧来喂视频类方法;这提升了可比性,但各方法"原生时间窗"不同(帧对方法 vs 视频方法),探针看到的时间跨度不完全一致。
值得验证的具体问题(回应上述局限,不写空话)
- 把视频指标换成任务指标
:同一批 H&R 潜在动作,直接解码成目标机器人动作并闭环执行,报告任务成功率与失败模式,才能回答"迁移到底能不能用"。 - 跨域压力测试
:固定预训练骨干,只在目标域给极少量视频(如 10 小时新传感器数据)或不给,测解耦是否保持——这能直接检验"生成先验强度"这一隐含前提。 - 动作空间异构性
:把目标机器人换成末端位姿控制或移动底盘,检验潜在动作空间是否真的与"控制参数化"无关(论文声称跨参数化,但只测了关节绝对指令)。 - 紧凑码的信息损失边界
:32 维码在 LARYBench 上仅掉 2.5 个百分点准确率,但在细粒度任务(写字笔顺)上是否仍够,需要逐任务诊断而不是平均分。 - 多任务、多具身规模化
:当前策略只在抽屉一族任务上验证;把任务数从 1 扩到 10+、具身从 2 扩到 5+,观察潜在码是否仍可共享,以及失败是否集中在特定具身。 - 闭环与延迟权衡
:1.47 秒/次意味着约 0.7 Hz 控制频率,对动态任务不够;需要测"码预测频率提高、动作头插值"这类工程方案的上限。
一句话收束:DreamX 给出了一条清晰且证据扎实的路径——动作可以从视频生成模型的内部表示里读出来,而且读出来的东西比专门训练的编码器更干净;它把"动作表示"从"另起炉灶学"变成"借用生成先验读"。目前它证明的是"能迁移、能当预测目标",还没证明"能可靠闭环执行"。下一步值得追的,正是这条从"看起来对"到"跑起来稳"的桥。

文章精选:
1.刚刚,图灵奖得主Hinton发了首篇RSI论文


