五度妙笔
 企业透视镜
 API商城

 数据库
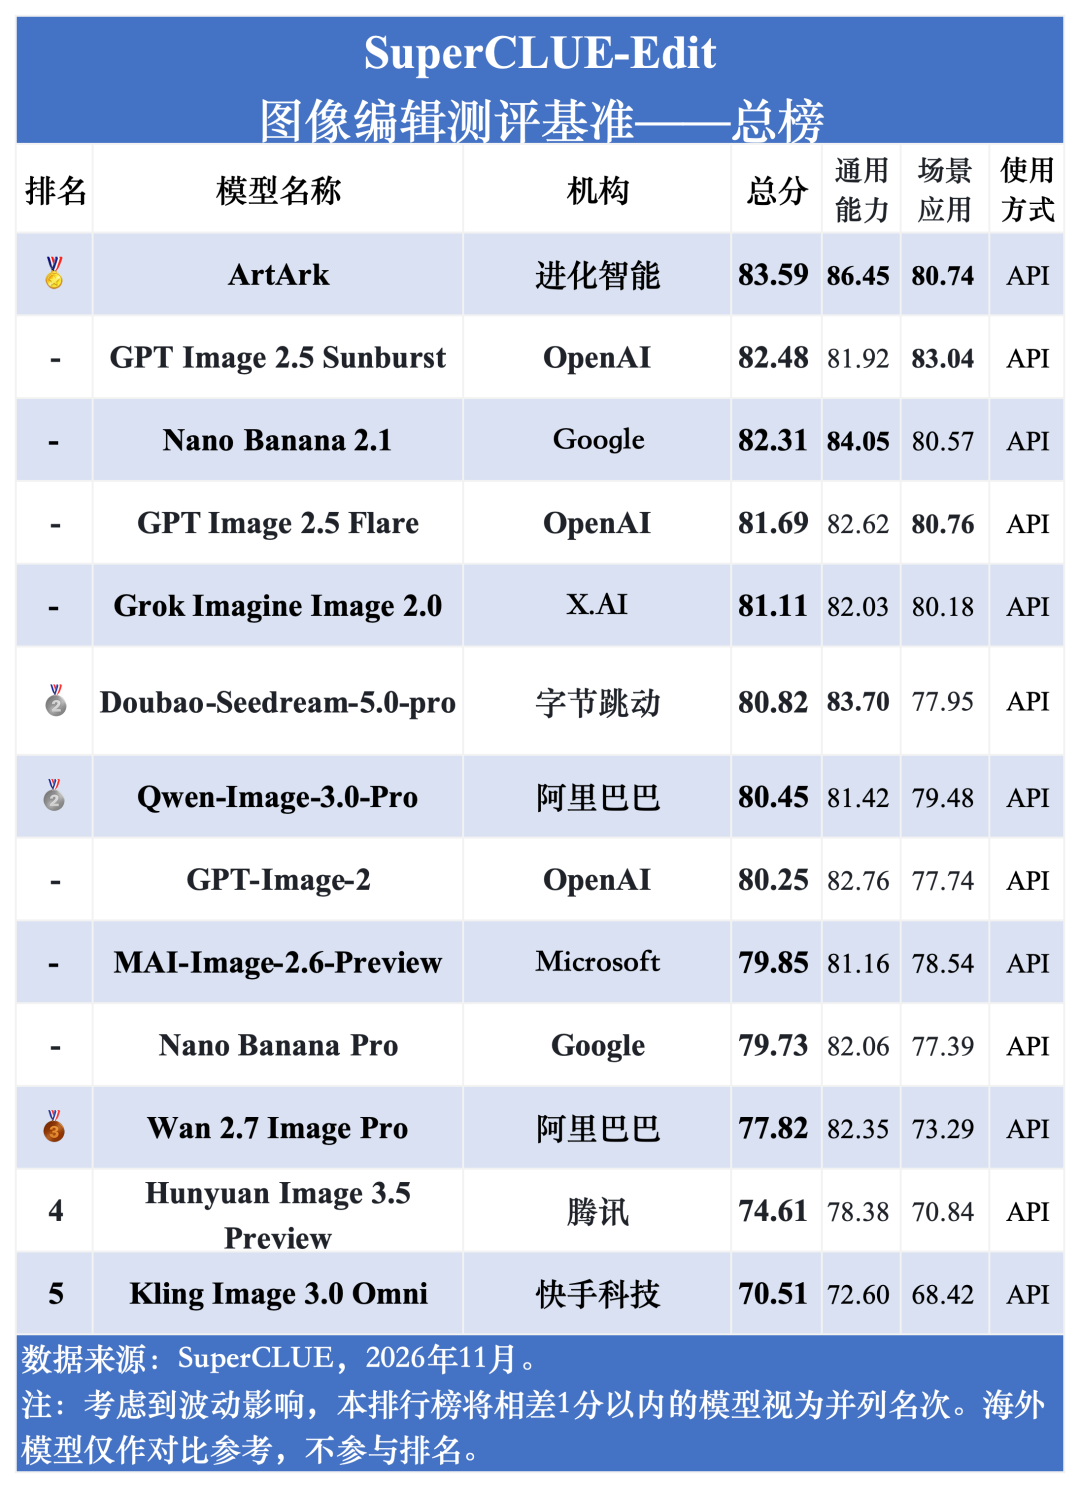
图像编辑11月榜单发布:ArtArk总榜第一,复杂视觉推理拉开模型差距
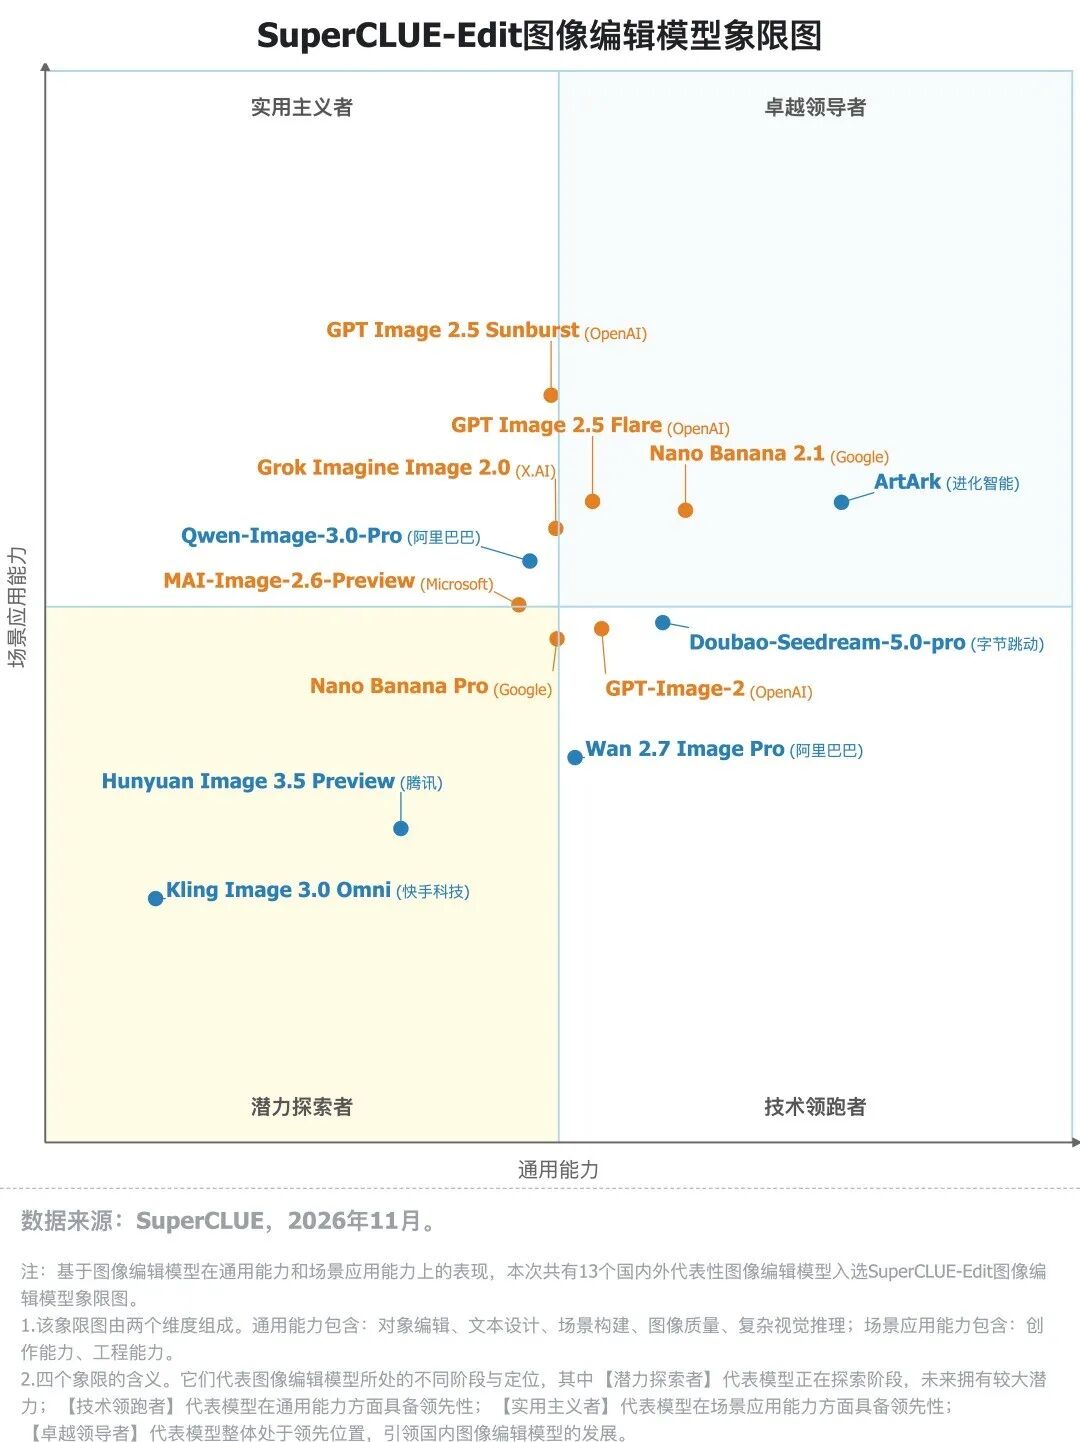
本次评测涵盖了国内外13个具有代表性的图像编辑模型,并对其综合能力进行了深入测评。以下为详细测评报告:
官网地址:www.superclue.ai
「过往文章介绍」
1.【2026年3月 图像编辑测评榜单参考文章】3月图像编辑榜单发布!GPT-Image-1.5领跑,腾讯混元国内第一!
2.【2025年10月 图像编辑测评榜单参考文章】「图像编辑」测评基准榜单发布:Nano Banana中文能力欠佳,无缘第一,国产模型表现不俗!
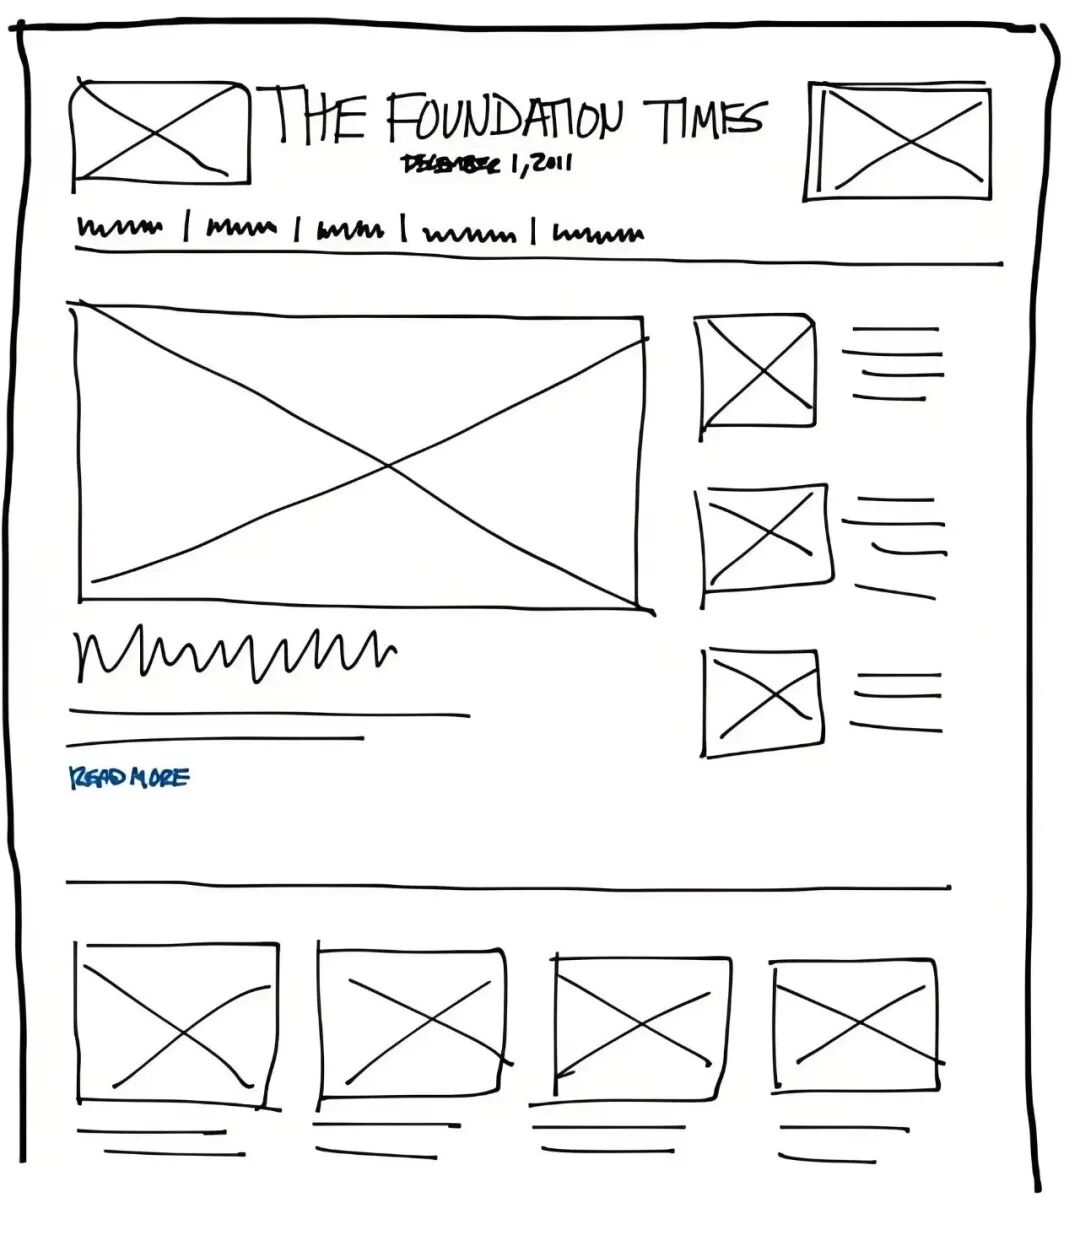
提示词:这是一个Web端用户详情的简图,请根据图中原型布局,将其渲染成一个花店的用户详情页面。
原始图片:
优秀模型回答:




测评核心内容摘要
摘要1:ArtArk位居总榜第一,海外头部模型竞争力突出!
摘要2:复杂视觉推理成为模型能力分水岭。
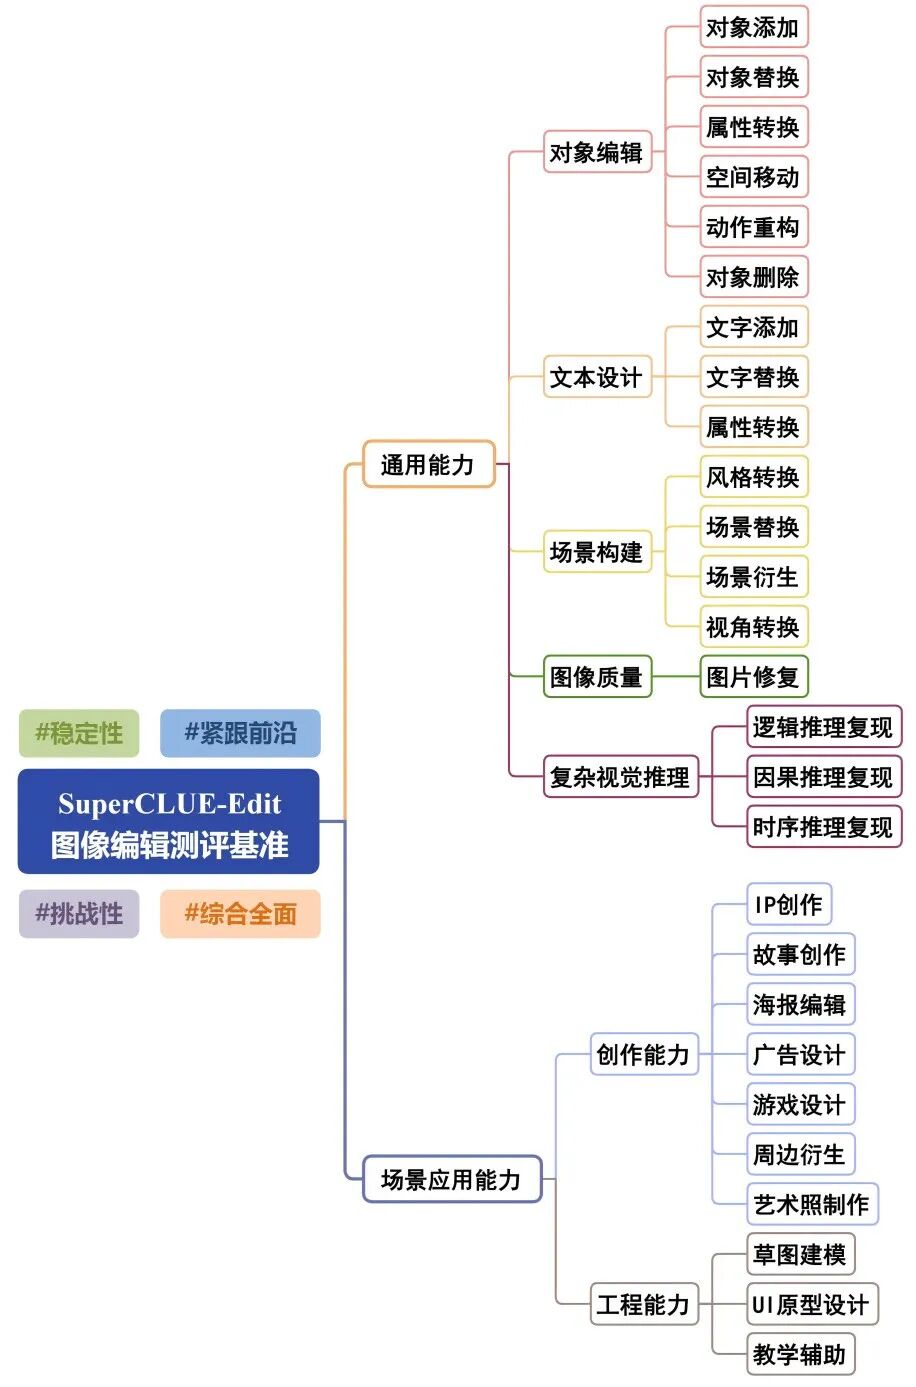
SuperCLUE-Edit 是一个聚焦图像编辑模型的基准,旨在为图像编辑领域的评估提供全面且多维的参考,覆盖通用能力和场景应用能力,涵盖28个子任务。本次测评沿用2026年3月的任务评估体系,详细的任务介绍和评价标准可回顾:3月图像编辑榜单发布!GPT-Image-1.5领跑,腾讯混元国内第一!
# 测评方法和评估示例
参考SuperCLUE细粒度评估方式,采用裁判模型进行评价,每个维度进行细粒度的评估并可以提供详细的反馈信息。该评估流程分为以下几个步骤:
1. 测评集构建
我们结合具体场景与考察方向针对评估维度撰写图像编辑的提示词(prompt),为了更好地检验图像编辑模型的中文理解能力,本次的提示词全部使用中文。
中文原生图像编辑测评基准中文题库的构建流程如下:
1.收集图片,并根据图片撰写编辑提示词prompt--->
2.测试--->
3.基于测试结果优化完善prompt--->
4.系统化构建各维度专属评测集,形成完整测评题库。
2. 评分标准
裁判模型根据预先定义的评测流程进行评估。评测流程涵盖了评价流程的说明、评价标准、打分细则、以及数据格式要求,确保评分的一致性、稳定性与公正性。
3. 自动化评分
裁判模型将根据具体的任务类型结合相关的评价标准进行自动化评分。此外,SuperCLUE-Edit将采用多轮测评方案,即针对同一个模型生成的全部图片均将采取相同的评价流程进行前后三次测评,并将三次结果的平均值作为每个图片的最终分数参与后续计算与排名。
4. 综合评分与反馈
最终,我们将各一级维度的平均分计算出来,结合各模型在不同场景中的得分,最终分数将反映出该模型在每个场景的综合性能。结果将以统一的输出格式提供,包括每个单独任务的详细评分与总体评价。
评估示例

-----评价开始----- **初步质量定性 (0.0-1.0分档):** 优秀(0.8-1.0档) **基础要求检查:** 基础要求完全满足,无逻辑违背或明显不符现象。 1. **标准1 <主体匹配> 的评价:** - 灰白小鸟正确添加,与提示词中的物种描述一致。 - 添加的位置明显在黄胸小鸟的右侧,与描述吻合。 - 整体符合提示要求,无任何明显的错位或不符。 基于标准1的得分:【1】 2. **标准2 <属性一致性> 的评价:** - 小鸟外观上的灰白特征与指令一致,羽毛的整体颜色符合提示词要求。 - 添加的小鸟与原图主体小鸟的大小比例和放置位置符合逻辑,没有出现明显的不协调。 - 风格保持一致,光影处理自然,总体质量令人满意,但姿态设计稍显单调,羽毛纹理细节有提升空间。 基于标准2的得分:【0.9】 **综合得分计算:** 计算过程:(1 + 0.9) / 2 = 平均分 = 0.95 综合得分:【0.95】 -----评价结束----- 第二轮评价: -----评价开始----- **初步质量定性 (0.0-1.0分档):** 优秀 (0.8-1.0档) **基础要求检查:** 满足基础要求,无逻辑错误,符合提示需求。 1. **标准1 <主体匹配> 的评价:** <图像显然满足了主体匹配要求,增加的小鸟形象及灰白颜色与原始提示描述准确一致,同时位置也正确。无明显偏差。> 基于标准1的得分:【1】 2. **标准2 <属性一致性> 的评价:** <图像的属性一致性表现总体良好:灰白色的小鸟大小比例与场景协调一致;位置安排精确;风格与原场景融合较自然。但光影处理稍显不足,增加的小鸟的表现略显僵硬,与原鸟相比细节动态逼真度略逊。此缺点虽不明显,但影响艺术表现。> 基于标准2的得分:【0.8】 **综合得分计算:* 计算过程:(标准1得分 + 标准2得分) / 2 = 平均分 综合得分:【0.90】 -----评价结束----- 第三轮评价: -----评价开始----- **初步质量定性 (0.0-1.0分档):** 优秀(0.8-1.0档) **基础要求检查:** 满足基本要求,无明显违背提示词逻辑或常识。 1. **标准1 <主体匹配> 的评价:** 添加的对象为灰白色小鸟,符合提示描述的类别、种类及位置。即使存在轻微位置和比例偏差,仍与提示的指令要求大体一致。 基于标准1的得分:【1】 2. **标准2 <属性一致性> 的评价:** 添加小鸟的外观颜色、纹理、形态设计与指令要求相符,尺寸比例虽稍偏,但风格和呈现形式都较好地融入原图。背景未产生明显变动,整体协调性高。然而,由于比例以及位置细微调整可能进一步改善,此分数不完全提升至满分。 基于标准2的得分:【0.9】 **综合得分计算:** 计算过程:(标准1得分 + 标准2得分) / 2 = (1 + 0.9) / 2 = 0.95 综合得分:【0.95】 -----评价结束-----