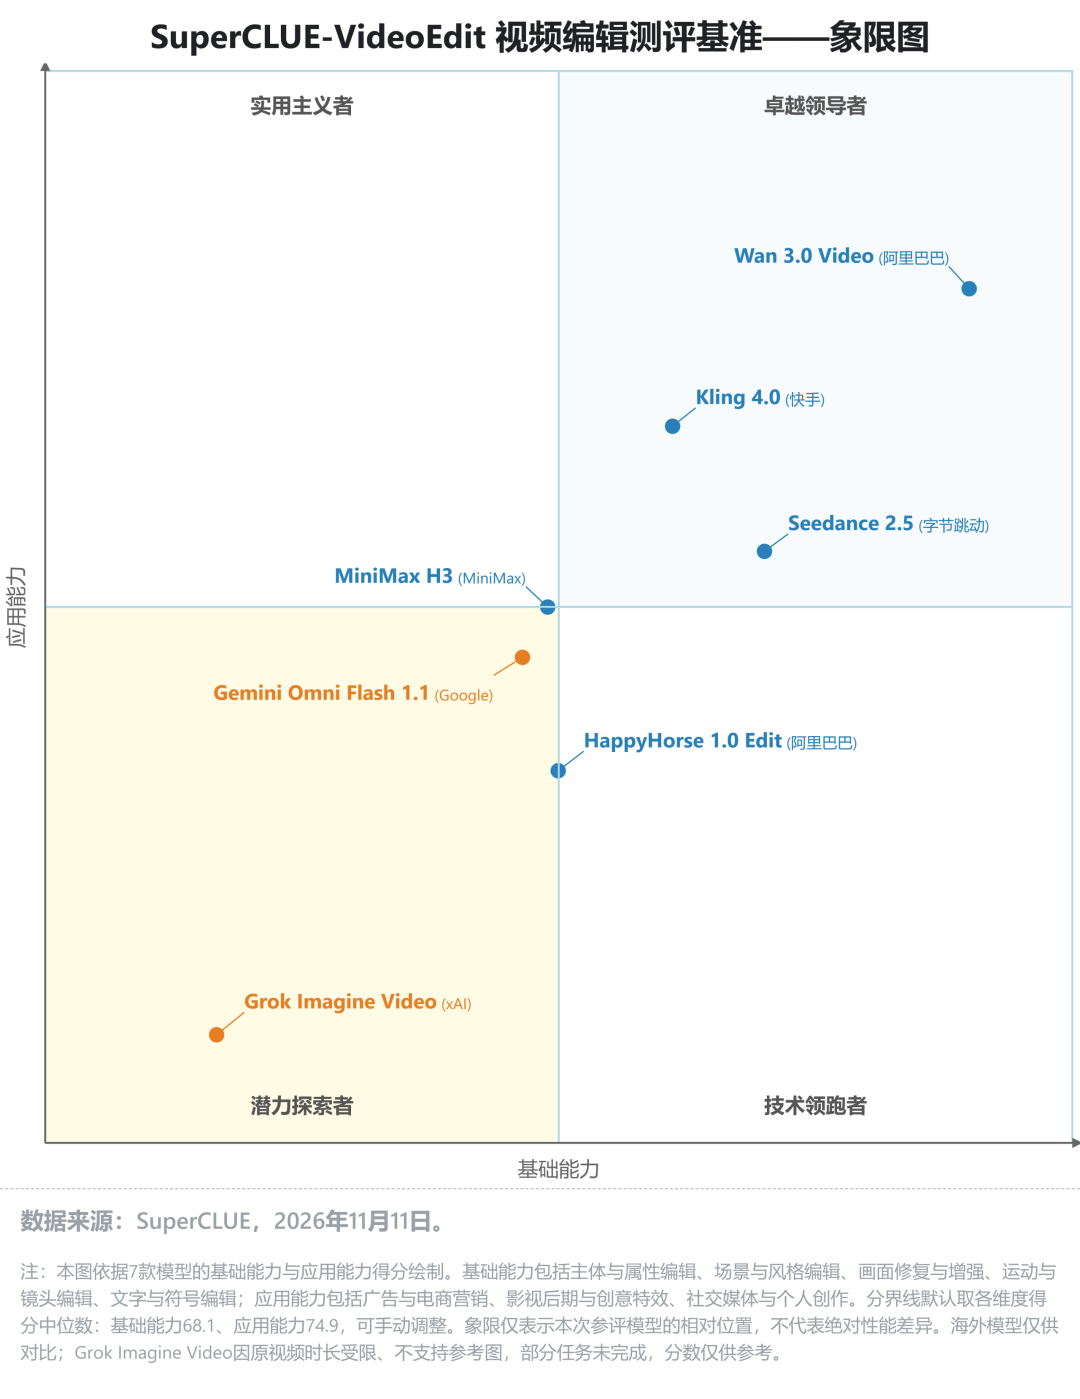
当前,AI视频技术正从内容生成向精准、可控的视频编辑加速发展。从主体替换、场景调整,到运动控制、画面修复及创意特效,如何准确执行编辑指令、保留原视频内容并保持画面动态一致性,已成为衡量视频编辑模型实际能力的重要标准。为全面评估国内外主流模型的中文视频编辑能力,SuperCLUE团队正式发布 SuperCLUE-VideoEdit 中文视频编辑首期测评榜单。 本次测评覆盖7款国内外代表性模型,围绕基础能力与应用能力两大维度、8项核心任务展开测试,设置5秒、10秒两档视频时长,及有、无参考图两类编辑条件,采用裁判模型对生成视频进行三轮独立评分并取平均值,综合考察编辑准确性、原视频保留度、动态与跨帧一致性及画面质量。以下为详细测评结果及分析。
「过往文章介绍」
1.【2026年10月视频编辑测评体系介绍】SuperCLUE-VideoEdit 中文视频编辑测评基准方案发布!覆盖2大维度、8项核心任务!
提示词:将白模画面整体转换成写实的雨夜钟表店。画面中有一位成年男性钟表匠,戴深灰色圆帽、穿深棕色长袖工作服,坐在木质工作台前低头修理一只圆形怀表,怀表如@图1所示。桌上台灯发出暖黄色光,照亮双手、怀表和附近桌面;窗户可见时,窗外为冷蓝色雨夜,玻璃上有向下流动的雨滴。保持白模中人物、工作台、台灯和怀表的相对位置;镜头从人物斜后方缓慢推近,沿桌边移到侧面,最后以怀表为视觉焦点,全程一镜到底。
参考图:
# 榜单概览
榜单地址:www.superclue.ai
视频编辑测评摘要
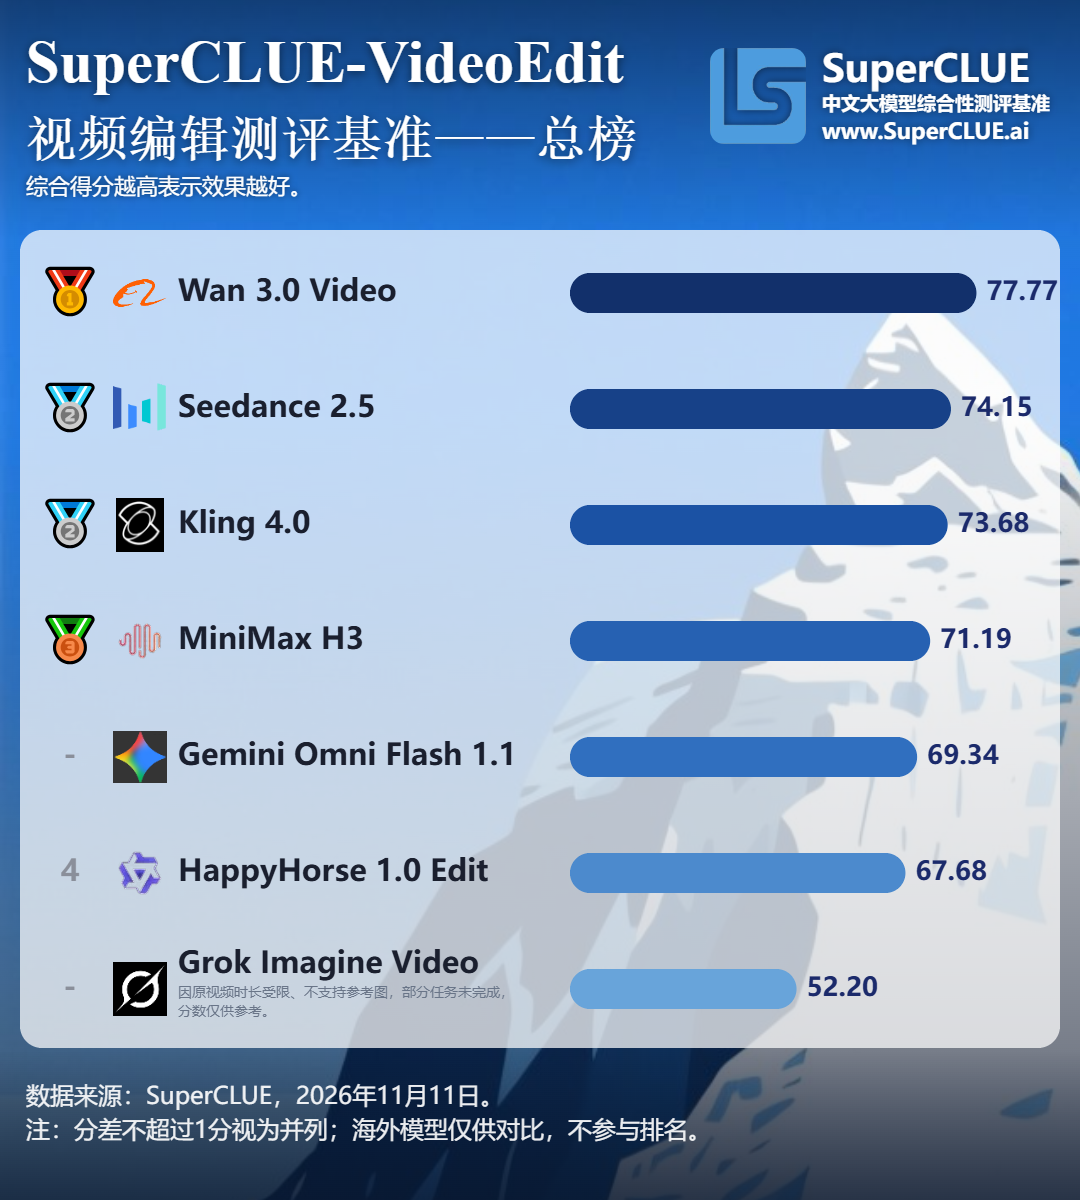
测评要点1:Wan 3.0领跑视频编辑总榜,Seedance与Kling并列第二!
Wan 3.0 Video以77.77分登顶综合总榜,基础能力与应用能力均列第一;Seedance 2.5 与 Kling 4.0并列第二,MiniMax H3紧随其后,国内模型包揽前四。测评要点2:基础编辑能力分化明显,运动控制与中文文字编辑仍具挑战。
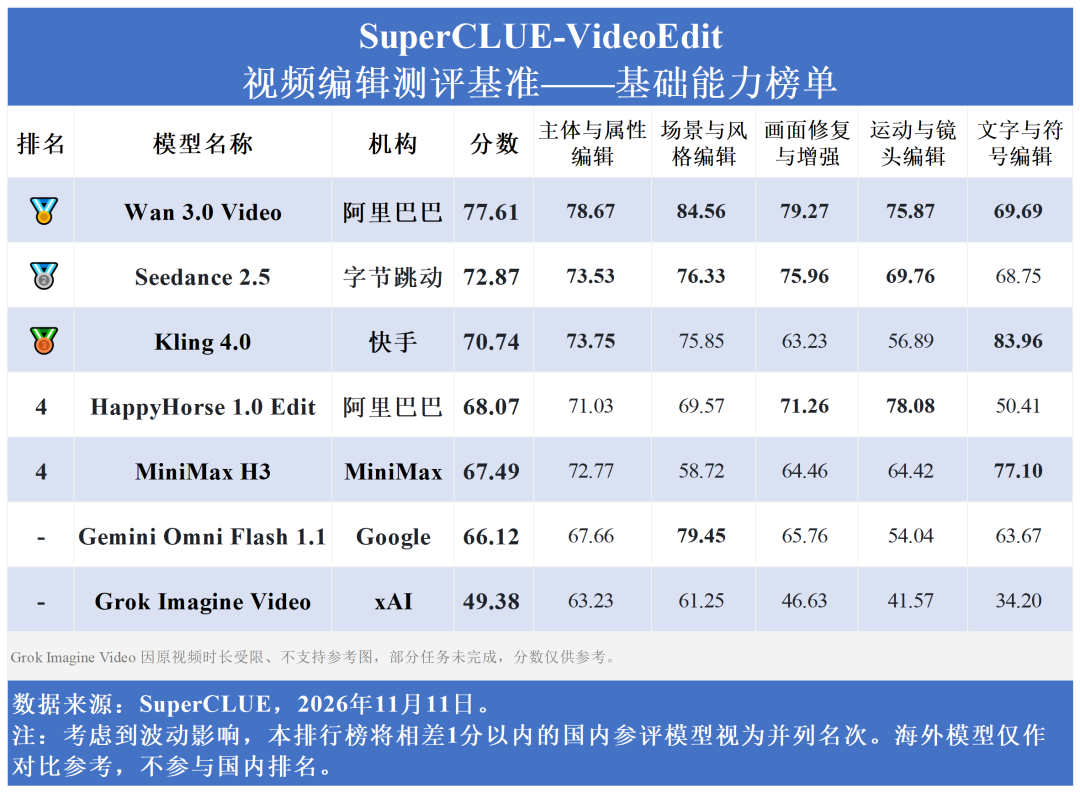
Wan 3.0领跑基础能力;Kling 4.0居文字与符号编辑之首,HappyHorse 1.0 Edit领跑运动与镜头编辑。运动与镜头编辑平均仅66.51分,为八项任务最低;文字与符号编辑极差33.56分,模型间分化最大。
测评要点3:应用能力竞争激烈,商业营销、影视特效与个人创作各有所长。
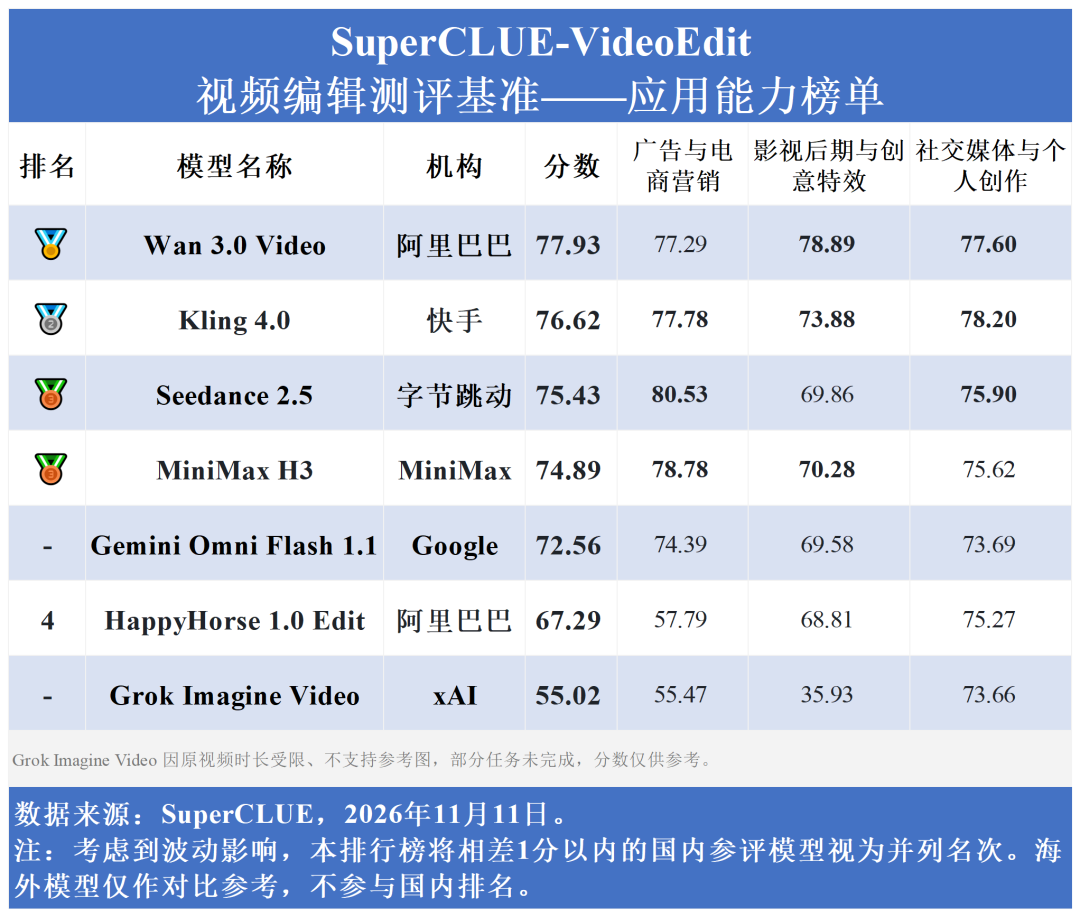
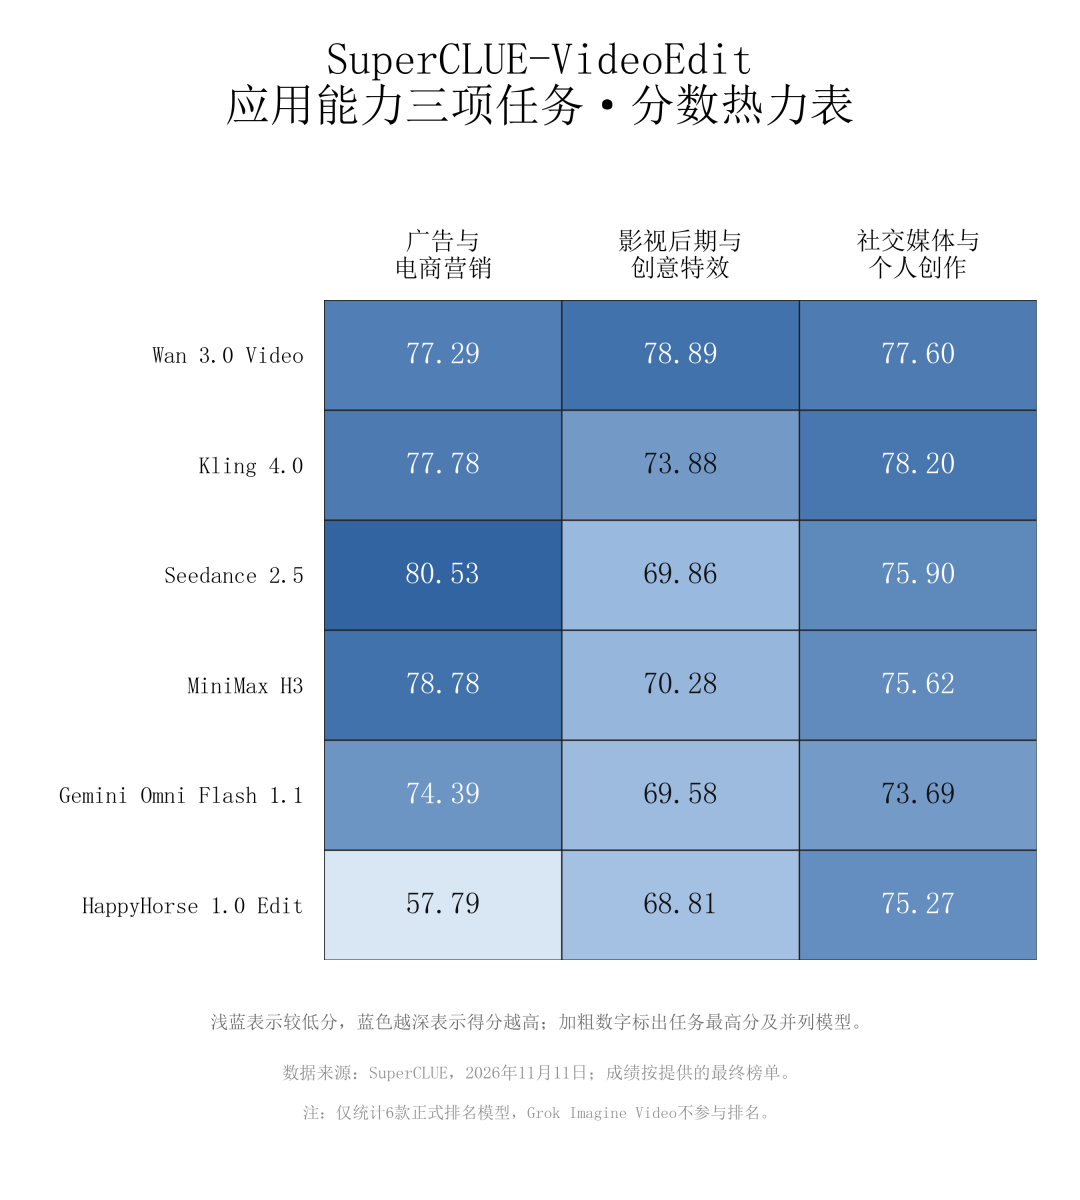
Seedance 2.5以80.53分领跑广告与电商营销,Wan 3.0以78.89分领跑影视后期与创意特效,Kling 4.0与Wan 3.0并列社交媒体与个人创作第一。注:由于 Grok Imagine Video 在原视频超过输入时长上限或任务需要参考图时无法完成视频编辑,现不参与排名,分数仅供参考。
#SuperCLUE-VideoEdit评测体系
SuperCLUE-VideoEdit是面向中文自然语言指令的视频编辑能力测评基准,旨在从基础编辑能力与实际场景应用两个方面,系统评价主流模型对已有视频的精准修改与内容控制能力。本次测评体系包含 2大一级维度、8项二级任务。
本次 SuperCLUE-VideoEdit 测评采用细粒度评估方式,结合视频编辑任务特点,从编辑指令完成情况、原视频内容保留及画面动态表现等方面,对模型的视频编辑能力进行综合评价。
围绕基础能力与应用能力两个方向,结合不同编辑操作及实际应用场景设计测评任务。每道题由原视频、中文编辑指令及可选参考图片组成,重点考察模型对中文编辑需求的理解与执行能力。裁判模型依据预先制定的评价流程和评分细则,结合具体任务的考察重点进行结构化评分,确保不同模型和任务之间评价标准的一致性与可比性。
裁判模型将根据具体的视频编辑任务,结合相应评分标准进行自动化评价。本次测评采用多轮评分机制,即针对同一模型生成的全部视频,按照统一评价流程独立评分三次,并以三次结果的平均值作为每段视频的最终得分,参与后续综合计算与排名。
根据各任务的评分结果,逐级汇总形成模型综合得分及分维度表现,并按照综合得分进行排名。最终结果将展示各模型的整体表现、不同任务下的能力差异及典型编辑问题,为模型能力对比提供参考。此外,将对部分自动评分结果进行人工抽样复核,检查评价结果的合理性与一致性,并根据复核情况对评分机制进行必要调整。【测评维度】:基础能力—文字与符号编辑
【提示词】:将视频画面里最大的红色书法 “囍” 字修改为 “金榜题名”,保持原有书法字体风格、红色效果、显示位置、绸缎背景质感和光影褶皱不变。“金榜题名”两边的图形参考@图1,对称位于“金”字的左侧和“名”字的右侧,原图案与颜色不变。同时把下方文字 “WELCOME TO OUR WEDDING Mr Man & Ms Mei” 修改为 “WELCOME TO MY GUESTS 升学宴”,“升学宴”三个字需做换行居中处理,与原图“Mr Man & Ms Mei”位置对应。文字排版、红色色调、位置大小和原图对齐,整段视频里所有修改文字清晰、稳定显示,不出现闪烁、变形。
【参考图】:
【裁判模型——第一轮打分】
本题传入参考图1张。生成视频将参考图中的蓝金色装饰图形分别置于“金”字左侧和“名”字右侧,主要轮廓与配色得到保留,且未破坏原有绸缎背景。- 优点1:成功将红色书法“囍”修改为“金榜题名”,文字准确、清晰,没有缺字或错字。- 优点2:下方英文正确替换为“WELCOME TO MY GUESTS”,“升学宴”换行居中显示,符合指令要求。- 优点3:两侧装饰基本符合参考图要求,图文跨帧显示稳定,绸缎背景及动态光影得到保留。- 缺点1:新标题的笔画粗细与书法笔势未能充分还原原“囍”字风格,是主要的外观偏差。- 缺点2:四字标题横向占比增大,局部图文间距偏紧,原有排版比例有所变化。总体判定:编辑指令基本完成,文字准确且动态稳定,但字体风格与排版还原仍存在不足。标准1〈指定文字数字或标识准确性〉,权重85%:文字内容、顺序及换行均正确,参考图形的主要特征得到保留,局部细节存在轻微偏差。得分:【95.0分】标准2〈外观匹配与动态显示稳定性〉,权重15%:图文跨帧显示稳定,背景动态效果基本保留,但书法风格及标题排版与原片存在差异。得分:【82.0分】计算过程:95.0×85%+82.0×15%=93.05分评分复核:文字内容准确,字体风格还原不足仅计入外观项,避免重复扣分。
【裁判模型——第二轮打分】
本题传入参考图1张。生成视频在标题两侧呈现了参考图的蓝金色主体图形。标准1〈指定文字数字或标识准确性〉,权重85%:评价过程与第一轮类似,此处略。得分:【96.0分】标准2〈外观匹配与动态显示稳定性〉,权重15%:评价过程与第一轮类似,此处略。原“囍”字的笔势未被充分还原,四字标题的排版也比原片更宽。得分:【80.0分】计算过程:96.0×85%+80.0×15%=93.6分【裁判模型——第三轮打分】
本题传入参考图1张。参考图的蓝金色主体图形分别位于“金”字左侧和“名”字右侧。标准1〈指定文字数字或标识准确性〉,权重85%:评价过程与第一轮类似,此处略。得分:【95.0分】标准2〈外观匹配与动态显示稳定性〉,权重15%:评价过程与第一轮类似,此处略。字形风格与原片有差距,但图文在抽查的时间点保持稳定。得分:【83.0分】计算过程:95.0×85%+83.0×15%=93.2分【综合得分】:(93.05+93.6+93.2)/3=93.28
# 参评模型
本次测评共纳入7款代表性视频编辑模型,其中包括5款国内模型和2款海外模型,均通过API方式参与测评。

基础能力榜单
模型回复率统计
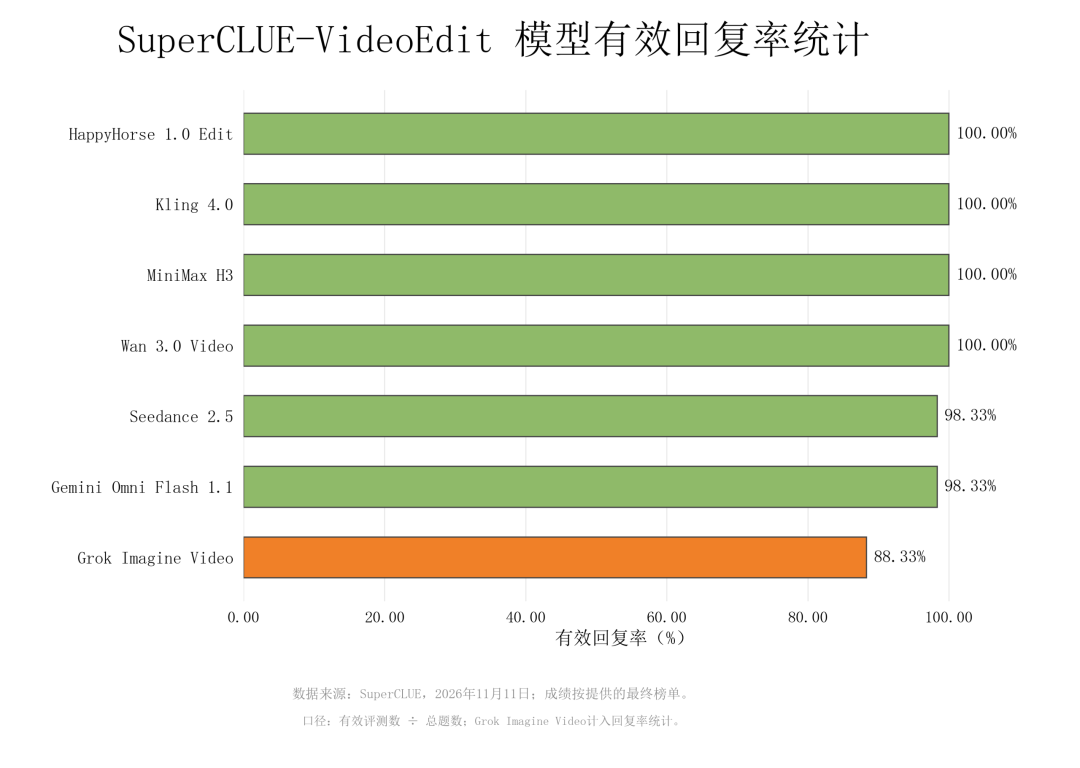
本次测评中,受各模型输入能力、内容安全限制及生成过程等因素影响,部分任务未能成功生成,有效回复率存在一定差异:1. Wan 3.0 Video、Kling 4.0、MiniMax H3和HappyHorse 1.0 Edit表现最佳,有效回复率均达到100%,所有测评任务均成功完成。2. Seedance 2.5与Gemini Omni Flash 1.1的有效回复率均为98.33%,仅有少量任务未能完成,整体表现较为稳定。3. Grok Imagine Video的有效回复率为88.33%,为本次参测模型中最低。其视频编辑输入时长及参考图片支持范围存在一定限制,可能影响部分任务的完成情况。整体来看,本次测评的平均有效回复率为97.86%,多数模型能够完成绝大部分视频编辑任务,但不同模型在输入支持范围与生成稳定性方面仍存在一定差异。# 模型对比分析
示例1 基础能力——运动与镜头编辑
【提示词】:将原本直线向前平飞的航拍镜头修改为复合多轴运镜:镜头先朝峡谷内的瀑布低空俯冲推进,随后缓缓上升,从高处俯瞰瀑布。严格保持瀑布水流动态、弥漫的水雾、两岸针叶林地貌及斜射的丁达尔光束方向不变。
【Gemini Omni Flash 1.1生成视频】:74.00分
【简要分析】:MiniMax H3较好地完成了先向瀑布俯冲推进、再上升俯瞰的复合运镜,镜头高度与视角变化较为明显,整体运动较连贯;Gemini Omni Flash 1.1主要表现为向瀑布持续推进,后半段缺少明确的上升俯瞰动作,未能完整执行两阶段运镜要求。
示例2 应用能力——广告与电商营销
【提示词】:把香水瓶的黑色喷盖变成粉色;保持原来的瓶子整体、镜子反射、手部运动和背景灯光不变。
【Grok Imagine Video生成视频】:61.10分
【Wan 3.0 Video生成视频】:90.50分
【简要分析】:Wan 3.0 Video较好地完成了喷盖颜色替换,镜内与镜外的香水瓶喷盖均变为粉色,手部运动及背景基本保持不变;Grok Imagine Video虽然将镜中香水瓶的喷盖改为粉色,但镜外前景中的喷盖仍保留原有黑色,存在编辑不完整、镜内外颜色不一致的问题。
# 总体测评分析及结论
1. Wan 3.0综合领跑,Seedance 2.5与Kling 4.0各有优势。
Wan 3.0 Video以77.77分登顶综合总榜,基础能力(77.61分)与应用能力(77.93分)均排名第一,在八项二级任务中的四项取得最高分。其中,场景与风格编辑达到84.56分,影视后期与创意特效取得78.89分。Seedance 2.5(74.15分)与Kling 4.0(73.68分)并列综合第二,但两者的专项优势有所不同:Seedance 2.5以80.53分领跑广告与电商营销,Kling 4.0则以83.96分在文字与符号编辑中排名第一。2. 运动与镜头编辑最具挑战,文字与符号编辑分化明显。 八项二级任务中,运动与镜头编辑平均得分为66.51分,为所有任务最低,文字与符号编辑平均得分为68.93分,整体表现同样相对较弱。从模型间成绩差异来看,文字与符号编辑的标准差为10.52分、极差33.56分,均为八项任务中最高;场景与风格编辑的极差达到25.83分,模型间表现也存在明显差异。相比之下,社交媒体与个人创作的平均分为76.05分,标准差仅1.50分、极差4.51分,模型成绩较为集中。复杂动作控制与中文文字精准修改仍是本次测评中值得重点关注的能力方向。
3. Seedance领跑商业营销,Wan 3.0与Kling在影视及个人创作中表现突出。 广告与电商营销方面,Seedance 2.5以80.53分取得最高分,MiniMax H3(78.78分)与Kling 4.0(77.78分)紧随其后。影视后期与创意特效方面,Wan 3.0 Video以78.89分位居第一,Kling 4.0以73.88分排名第二。社交媒体与个人创作方面,Kling 4.0(78.20分)与Wan 3.0 Video(77.60分)并列第一。不同模型在商品还原、视觉特效及个性化创作中的表现存在差异,说明模型的实际应用优势具有明显的场景针对性,选型时应优先参考对应任务的专项成绩。[1] CLUE官网:www.CLUEBenchmarks.com
[2] SuperCLUE排行榜网站:www.superclueai.com
[3] Github地址:https://github.com/CLUEbenchmark

 五度妙笔
 企业透视镜
 API商城

 数据库