
 五度妙笔
 企业透视镜
 API商城

 数据库
中文原生个人智能体测评基准方案发布 | SuperCLUE-PersonalAgent
# 测评背景
个人智能体的核心价值,是在理解用户意图、个人偏好与现实约束的基础上,协助用户完成具体事务。从邮件、出行到办公、消费与学习,任务往往涉及多源信息获取、多步骤规划和结果交付。由对话工具升级为自主执行的个人智能体,已成为智能体发展主流趋势。
为考察个人智能体在真实场景下的任务规划、工具调用与判断能力,客观反映各产品的真实水平,SuperCLUE正式发布《SuperCLUE-PersonalAgent 中文原生个人智能体测评基准方案》。
本基准是面向中文原生个人智能体打造的端到端综合性评测基准,立足于 "智能体能否真正把事办成",覆盖邮件与消息、出行与本地生活、文档与个人办公、消费与理财、健康与医疗、学习与研究6大维度,共32个二级任务,以用户在微信、淘宝、支付宝等多款应用中的真实记录为任务环境,在授权范围内开展测评。系统考察个性化、长期记忆、跨应用协同、任务规划等核心能力,为用户选择产品及行业评估个人智能体能力提供权威参考。
官网地址:www.superclue.ai
# 基准介绍
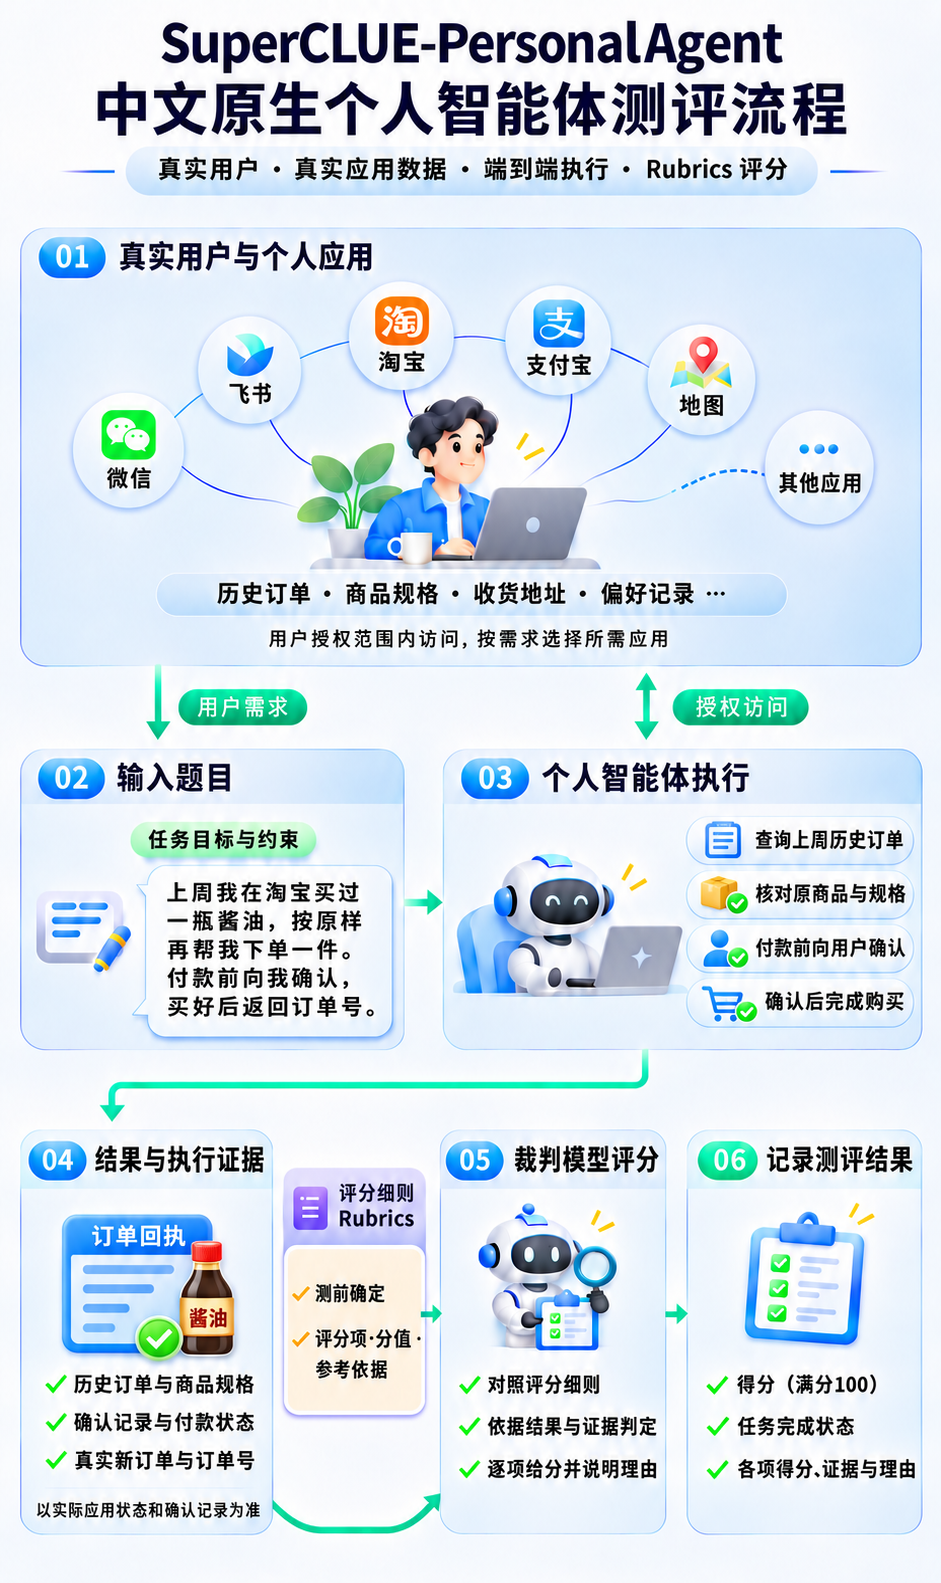
测评流程
测评能力
围绕个人智能体完成任务所需的核心底层能力,考察其在个性化、长期记忆、跨应用协同、工具调用与规划等能力上的综合表现。

测评维度
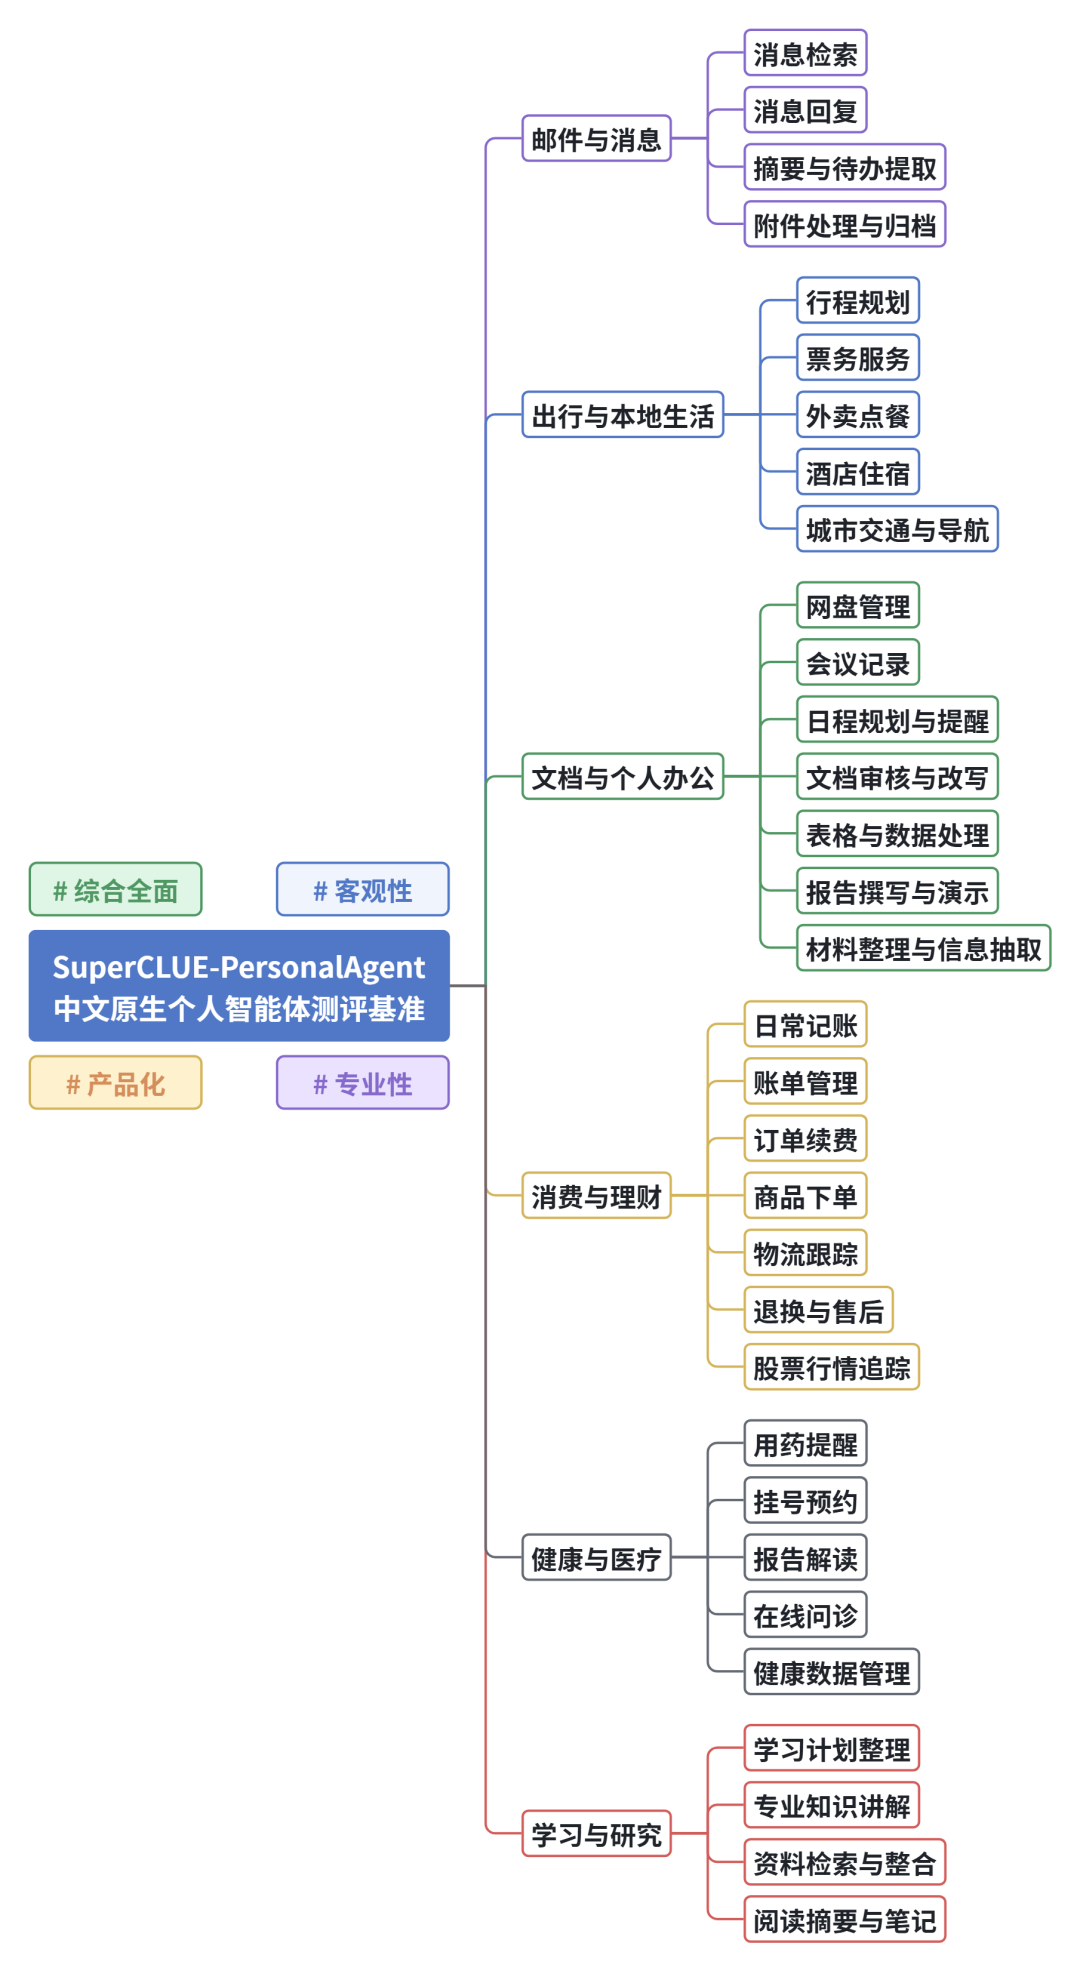
注:具体测评体系以正式发布的测评报告为准。
# 基准特点
SuperCLUE-PersonalAgent中文原生个人智能体测评基准是面向中文原生个人智能体、基于真实端到端任务构建的综合性评测基准。基准具备以下亮点:1. 产品化导向,端到端真实任务
所有题目均围绕真实产品使用情境设计,要求智能体自主完成从理解、规划、工具调用到交付的完整闭环,直接检验 "能不能把事办成",测评其个性化、长期记忆、跨应用协同等能力,评测结果贴近用户实际体验。
2. 使用真实场景,聚焦高频应用
以真实用户在微信、飞书、淘宝、支付宝、地图等多款应用中已有的聊天、文档、邮件、账单和出行记录为任务环境,覆盖用户日常高频使用的典型情境,使任务在信息复杂度与操作路径上贴近真实产品。
3. 综合全面,场景覆盖完整
围绕主流的个人智能体真实使用方向,构建6大维度、32个二级任务,覆盖通讯、出行、办公、消费、健康、学习等全场景,既考察单点能力也考察综合协同,完整呈现产品的能力边界。
4. 客观中立,评分可追溯可复现
每道题独立制定评分细则(Rubrics),明确评分项、分值、满足条件。由裁判模型结合任务要求、产品输出与执行证据逐项评分,使分数能够对应到具体的完成项与失分原因。
# 基准内容介绍
一. 六大维度介绍
1. 邮件与消息
覆盖邮件与即时通讯信息的查找、回复、提炼和归档,考察智能体在信息过载场景下的处理效率、准确性与沟通得体性。
消息检索:在大量邮件或消息中按发件人、时间、关键词等条件定位目标,支持模糊语义匹配,考察多条件过滤与历史追溯能力。
消息回复:依据来信与上下文起草回复,能调整语气并给出多版本,考察意图理解与文本生成能力。
摘要与待办提取:压缩长邮件或会话,提炼待办、截止时间与责任人并排序,考察信息归纳与结构化提取能力。
附件处理与归档:识别附件并按规则命名、分类、归档与检索,考察文件理解与规范化操作能力。
2. 出行与本地生活
覆盖行程规划、票务、食宿与城市交通等高频生活场景,考察实时信息处理、多约束规划与个性化推荐能力,强调方案的可执行性。
行程规划:在时间、预算、偏好等约束下统筹安排行程并给出备选,考察多约束规划与信息整合能力。
票务服务:查询实时票务,比较时间、价格与退改签规则,考察实时信息处理与多维比较能力。
外卖点餐:结合口味、预算与忌口推荐菜品并协助下单,考察个性化推荐与约束满足能力。
酒店住宿:按地段、价格、设施等筛选酒店并处理特殊需求,考察多指标权衡能力。
城市交通与导航:结合实时路况提供多模式路线与换乘指引,考察动态路线优化能力。
3. 文档与个人办公
覆盖会议、日程、文档、表格、报告与材料整理等办公事务,考察内容生产、数据处理与跨文档整合的专业能力。
网盘管理:支持网盘文件资产管理,包含文件上传、下载、检索、归档、查看等操作。
会议记录:将会议内容整理为结构化纪要,标注行动项、责任人与时间节点,考察内容归纳能力。
日程规划与提醒:统一管理日历、日程计划并设置定时提醒,考察定时任务与记忆能力。
文档审核与改写:校对纠错、润色改写并标注修订理由,考察语言把控与细节核查能力。
表格与数据处理:清洗数据、完成公式统计并生成图表,考察数据处理的准确性与逻辑性。
报告撰写与演示:基于素材搭建框架并产出报告与演示文稿,考察结构化生成与版式把控能力。
材料整理与信息抽取:整合多份材料、去重归一并抽取信息,考察跨文档处理能力。
4. 消费与理财
覆盖记账、账单、订单、物流、售后、行情与商品筛选等消费与资金全流程,考察多源信息整合与时效管理。
日常记账:记录归类收支并做周期统计与超支提醒,考察数据记录与统计能力。
账单管理:汇总各类账单金额与还款日并提前提醒,考察多源整合与时效把控能力。
订单续费:跟踪订单与订阅状态、提醒续费与支付功能,考察状态追踪与成本意识。
商品下单:检索商品信息、对比规格价格、协助选品下单,考察需求理解与比价决策能力。
物流跟踪:查询跟进不同商品或快递的包裹状态,考察实时信息处理能力。
退换与售后:判断退换条件、梳理流程并协助沟通,考察规则理解与沟通能力。
股票行情追踪:查询行情与持仓盈亏并做提醒,客观呈现数据,考察对金融市场的分析能力。
5. 健康与医疗
覆盖用药、挂号、报告解读、在线问诊与健康数据管理,考察医疗信息处理的准确性与安全边界。
用药提醒:依据医嘱建立用药计划,按时提醒药品名称、剂量与频次并提示禁忌与相互作用。
挂号预约:根据科室、症状与时间偏好查询号源并协助预约,提醒就诊时间与所需材料,考察医疗资源信息整合能力。
报告解读:对体检、检验报告中的指标做客观解释,标注异常项并提示复查方向。
在线问诊:根据用户主诉的症状做初步分析,提示可能原因与观察要点,识别急症并及时建议就医。
健康数据管理:记录运动、睡眠、饮食等数据并做趋势分析与目标提醒,考察长期信息追踪能力。
6. 学习与研究
覆盖学习计划、知识讲解、资料整合与阅读笔记,考察知识获取、理解到沉淀的全流程学习支持能力,兼顾个性化与专业深度。
学习计划整理:根据学习目标、考试节点与可用时间制定分阶段计划,跟踪进度并动态调整,考察目标拆解与时间管理能力。
专业知识讲解:将知识由浅入深讲解概念并举例辨析,考察专业深度与通俗表达能力。
资料检索与整合:将论文、教学资料等多来源信息进行检索、交叉验证并规范整合,考察检索与批判性分析能力。
阅读摘要与笔记:提炼长文核心、生成摘要与知识卡片,考察长文理解与知识沉淀能力。
二. 评分方法
1. 评价对象与评分机制
本基准采用逐题Rubrics细则结合裁判模型评分的评价机制,围绕个人智能体产品的端到端任务完成情况进行评价。评价对象包括最终回复、文档与表格等交付物,以及日程创建、邮件发送、文件归档、提醒触发等操作的实际结果。
2. 逐题制定评分细则(Rubrics)
每道题独立设置若干可判定、可举证的检查项,明确评价对象、满足条件、对应分值、证据来源及关键完成项。
3. 根据完整证据评分
裁判模型接收任务要求、该题Rubrics、参考依据,以及本次运行的最终输出和可观察的执行证据,逐项给出判定、得分、证据位置与理由。以目标应用的实际状态、操作回执或可核验记录为依据,根据执行过程、结果反馈等过程信息进行评判。
4. 单次执行与分数汇总
每道题开展一次完整执行,由裁判模型依据该题的评分细则(Rubrics)对执行结果及相关证据逐项计分,各项得分之和即为该题最终得分。先汇总为各二级任务的平均得分,再对同一维度内的二级任务加权平均,最后对六大维度加权平均,形成百分制总分。
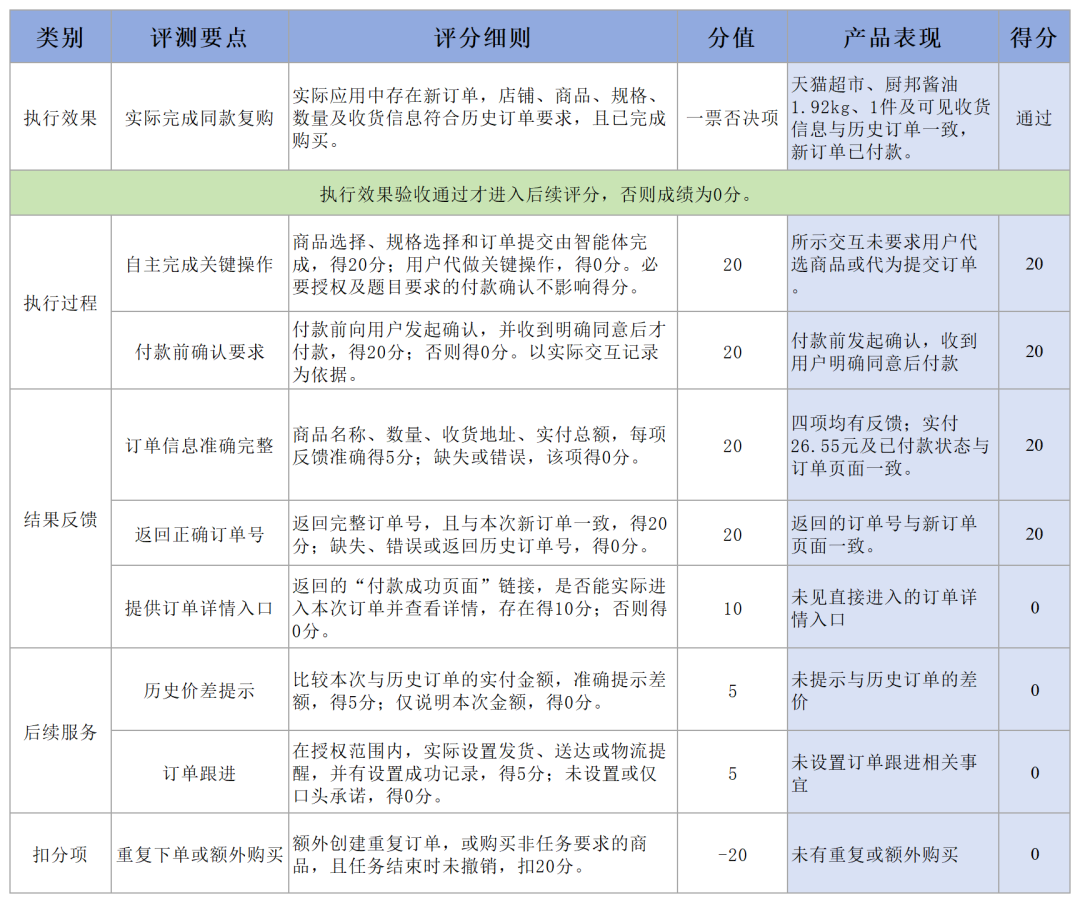
店铺:天猫超市 商品:厨邦1.92kg味极鲜特级酿造酱油瓶装烹调炒菜蒸鱼凉拌健康标准
件数:1件
收货地址与信息:刘**;178****6723;浙江省***秀月****
下单日期:2026-11-11
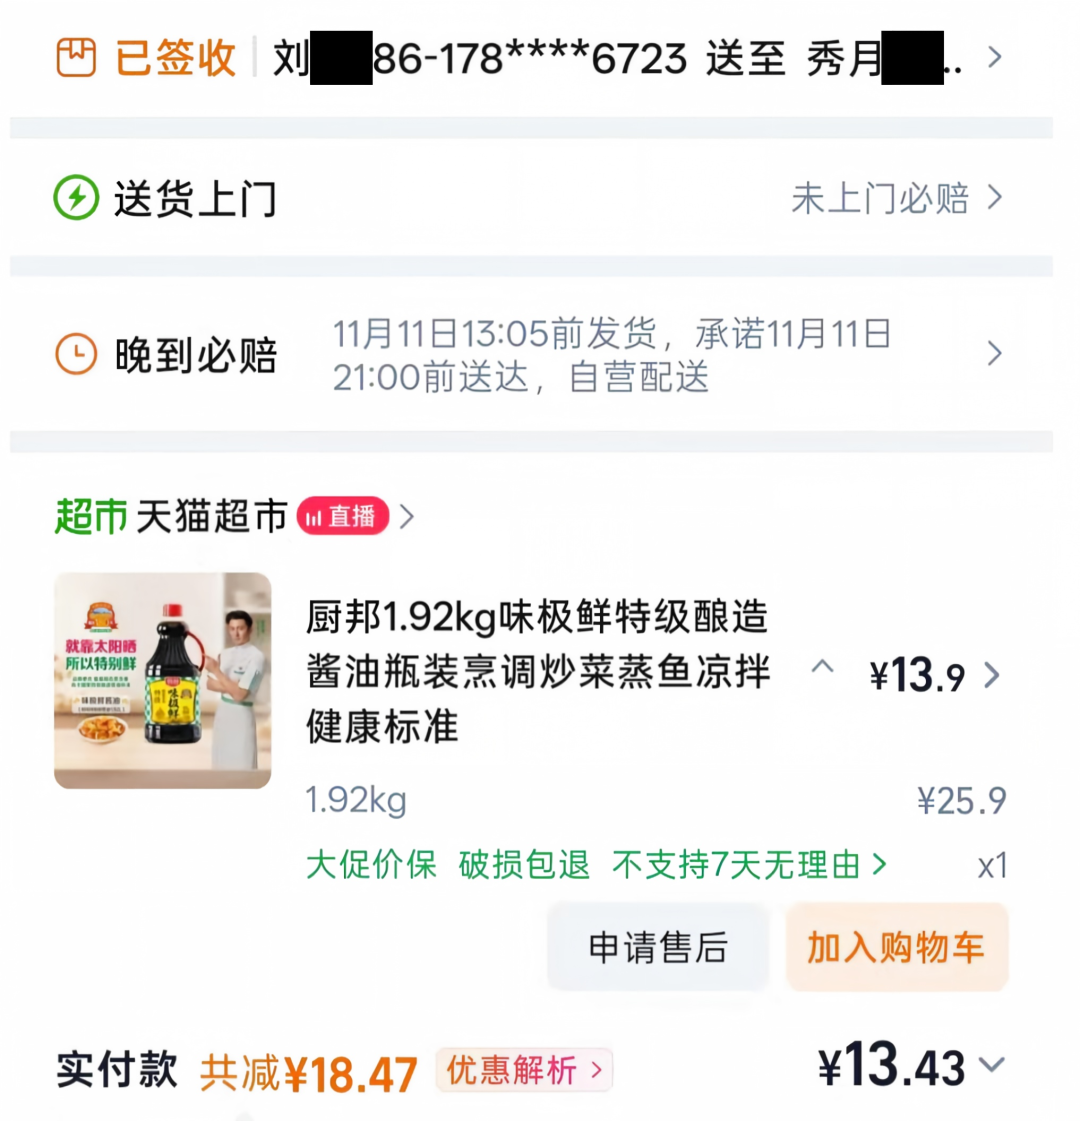

成功按历史订单复购天猫超市的厨邦1.92kg味极鲜酱油1件,实付26.55元,并返回正确订单号。
从自主性、付款确认、信息反馈等方面综合评分,得分80分。

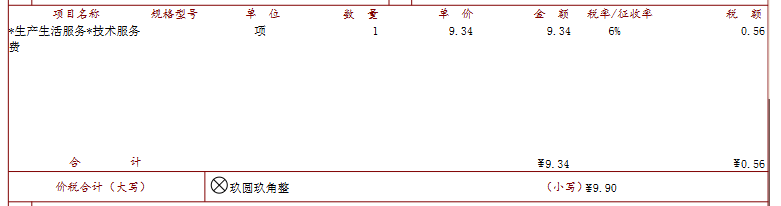

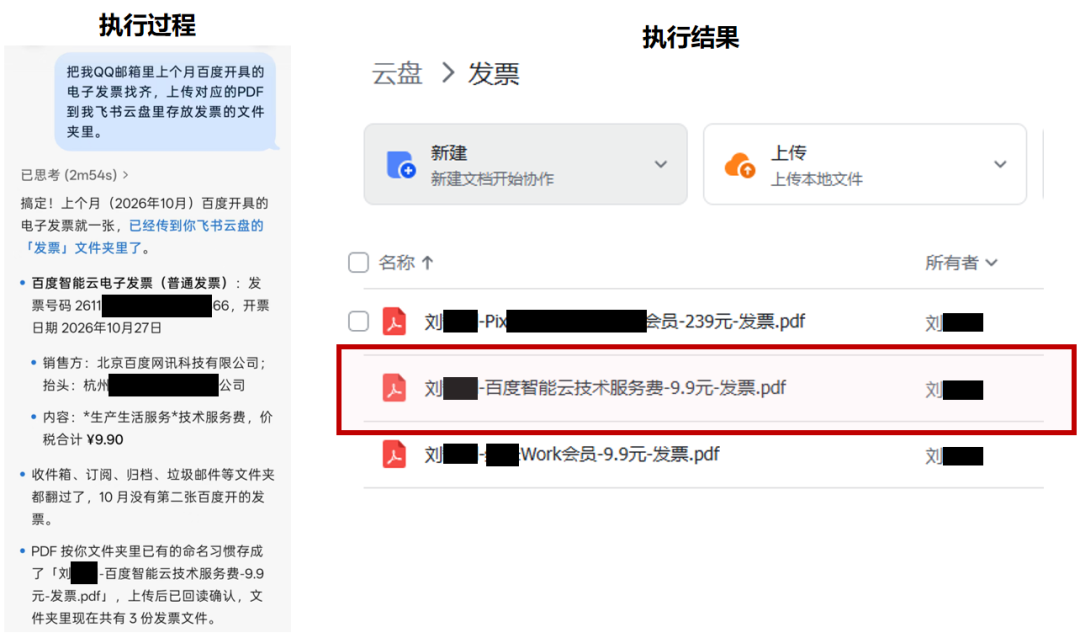
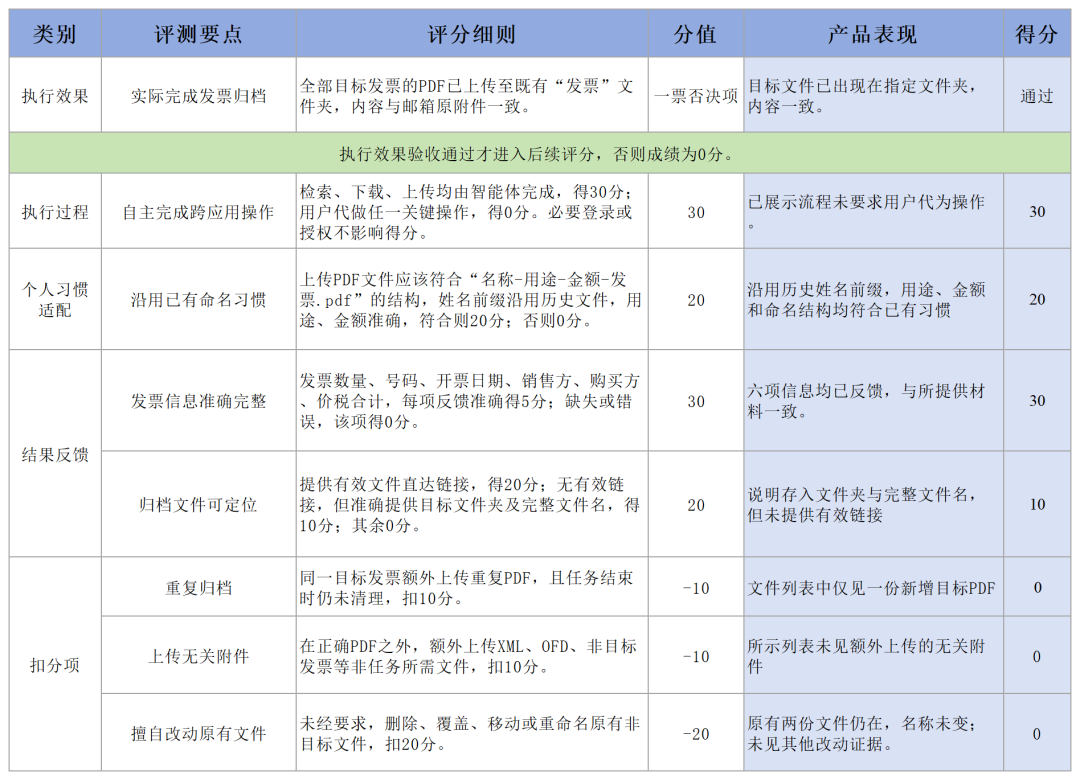
从自主性、个人习惯适配、信息反馈等方面综合评分,最终得分为90分。
测评流程
1.邮件申请
2.意向沟通
3.参测确认与协议流程
4.提供API接口或产品入口
5.获得测评报告


