2026年11月17日,SuperCLUE发布EmbodiedCLUE-VLA(RoboTwin 2.0扩展测评)更新榜单,测评任务详细介绍可回顾:EmbodiedCLUE-VLA(RoboTwin 2.0扩展测评)任务体系。本次测评补测 9 款模型,共呈现 17 款模型在相同任务集合和随机化场景下的表现,以下为详细测评结果。
本次测评具备三大特点:① 覆盖视觉语言动作模型(VLA)、世界动作模型(WAM)等不同技术路线的具身智能模型;② 按 RoboTwin 专项训练数据类型划分 Full 榜(使用干净场景与随机化场景示范数据训练)和 Clean 榜(仅使用干净场景示范数据训练),该分类不代表模型全部预训练数据,所有参评模型均在 Randomized 随机化场景下测试;③ 统一测评条件,基于 RoboTwin 2.0 Hard 随机化环境,采用相同机器人本体、任务集与配置,共测试 10 项双臂操作任务,每个模型每项任务执行 20 个评估回合,保证结果可比。
# 榜单概览
测评摘要
摘要1:总榜前三保持领先,ME-Dex-1.0 位列国内第四
Hy-Embodied-0.5-VLA、Motus 和 InternVLA-A1.5 分别取得 73.00、68.50 和 61.00 分;新增模型 ME-Dex-1.0 VAE 以 57.00 分位列国内总榜第四、Clean 榜首位。Full 榜 10 款模型平均得分为 45.65,Clean 榜 7 款模型为 33.00,相差 12.65 分。说明加入随机场景数据训练有助于模型适应背景、光照和物体位置变化,训练数据的场景多样性值得重视。摘要3:定位按压表现较好,精细操作与连续执行仍具挑战
按铃和按闹钟的平均成功率分别为 81.18% 和 73.82%,积木排序和挂杯分别为 14.71% 和 9.12%,反映出不同任务之间的表现差异。
一、评测基准
1.基准介绍
RoboTwin 2.0 是面向通用双臂机器人操作研究的大规模仿真数据生成与评测平台,基于 SAPIEN 物理仿真环境构建。
RoboTwin 2.0 官方当前提供 50 项双臂操作任务,并支持多个机器人本体进行数据采集与模型评估。任务覆盖物体抓取、放置、排序、堆叠、工具使用、双臂协作、关节物体操作以及连续动作等不同类型。与相对固定的桌面操作场景相比,RoboTwin 2.0 的一个重要特点在于其较强的环境随机化能力。这些随机因素使模型不能简单依赖固定的场景纹理、物体位置或视觉模式完成任务,而需要具备更稳定的视觉理解、空间定位和操作能力。
因此,相比上一阶段的 RoboCasa-GR1-Tabletop,本阶段更关注:VLA 模型在随机环境、有限执行预算以及复杂双臂操作条件下的任务完成能力。
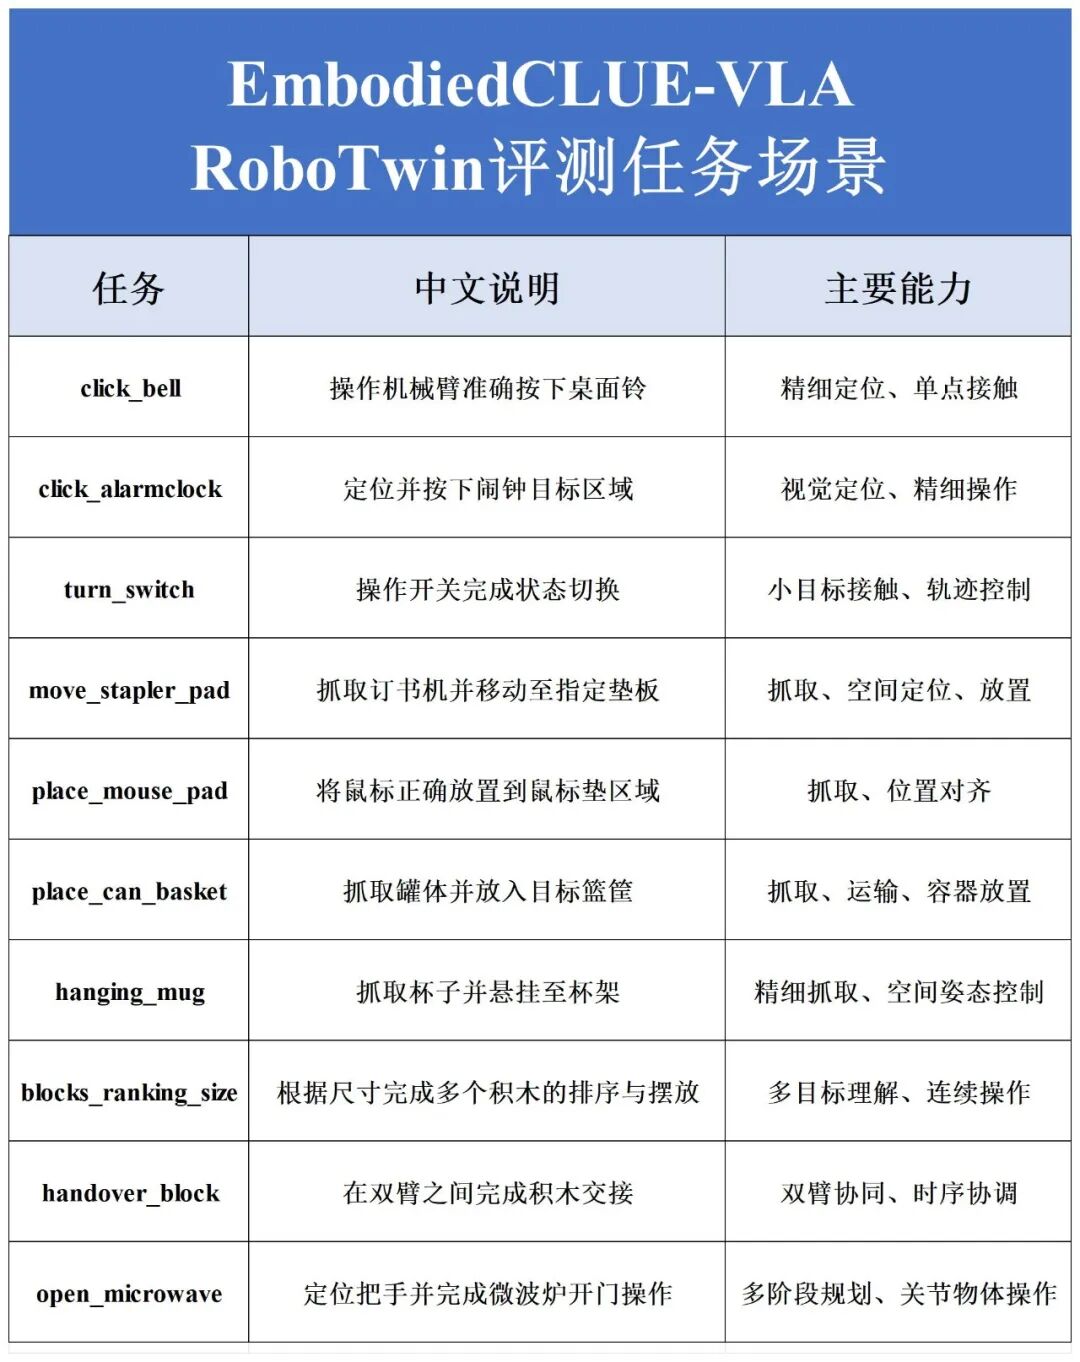
RoboTwin 2.0 官方包含 50 项双臂任务。为了突出模型能力区分度,本阶段 EmbodiedCLUE-VLA 从中选取 10 个具有代表性的任务,覆盖单点接触、抓取放置、双臂协作、多目标排序以及关节物体操作等多种操作能力。
具体的测评任务配置可以回顾:具身智能 Robotwin2.0 统一测评结果发布,腾讯混元 VLA 领先,生数 Motus 第二 | EmbodiedCLUE-VLA
参评模型
本次共计17款模型参与榜单对比,包括15款国内模型和2款海外模型。本次参与测评的模型均为开源模型,覆盖视觉语言动作模型(VLA)和世界动作模型(WAM)等技术路线。VLA 模型包括 Hy-Embodied-0.5-VLA、InternVLA-A1.5等;WAM 模型包括 Motus、ME-Dex-1.0等。
本次展示三张榜单:总榜汇总全部 17 款模型;Full 榜与 Clean 榜按 RoboTwin 训练数据类型分别列出。Full榜单
Clean榜单
1. 总榜前三保持领先,ME-Dex 位列第四
总榜前三名依次为 Hy-Embodied-0.5-VLA(73.00 分)、Motus(68.50 分)、InternVLA-A1.5(61.00 分),ME-Dex-1.0 VAE 位列总榜第四(57.00 分),海外参考模型 OpenWAM 得分 48.50 分;Full 榜中,Hy-Embodied-0.5-VLA、Motus、InternVLA-A1.5 为国内前三,Fast-VLA 以 45.00 分位列国内第四;Clean 榜前三名则是 ME-Dex-1.0 VAE(57.00 分)、UniWAM(47.50 分)、PICA-WAM(35.00 分)。
Full榜单(测评模型使用 Clean 和 Randomized 数据训练)的 10 款模型平均得分为 45.65,而Clean榜单(仅使用 Clean 数据训练)的 7 款模型平均得分为 33.00,相差 12.65 分。加入Randomized数据训练可以让模型在训练时接触更多背景、光照和物体位置变化,减少对固定场景的依赖,因此有助于适应本次随机化测试环境。由此可见,要提升模型在具身任务的表现,多样化的场景训练数据的加入必不可少。3. 简单接触任务表现较好,精细操作与多步骤规划仍需加强在 10 项任务中,按铃和按闹钟的模型平均成功率最高,分别为 81.18% 和 73.82%;积木排序和挂杯最低,分别为 14.71% 和 9.12%。前两项主要考察目标定位与按压,而积木排序需要识别物体属性并连续完成放置,挂杯需要抓取并对齐杯柄与杯架。结果提示,模型在单次定位按压任务上表现相对较好,在精细空间对齐和连续动作执行方面仍有提升空间。示例可视化展示
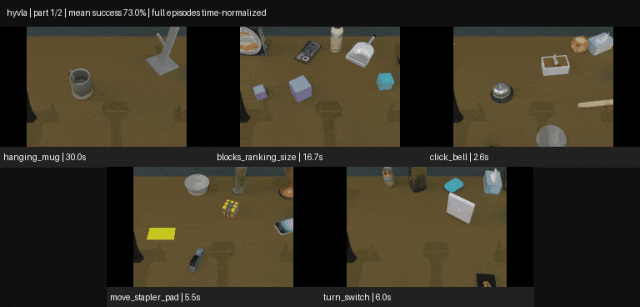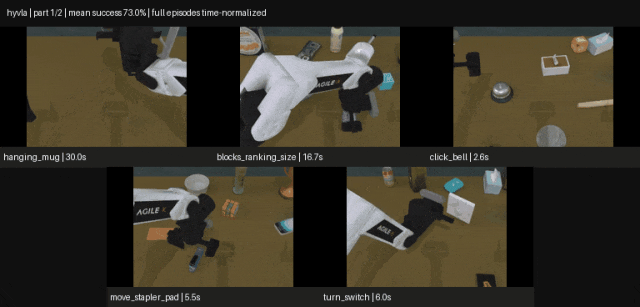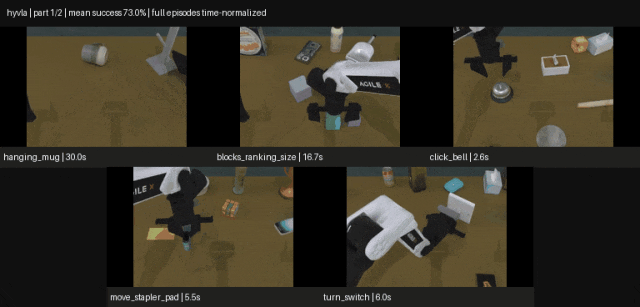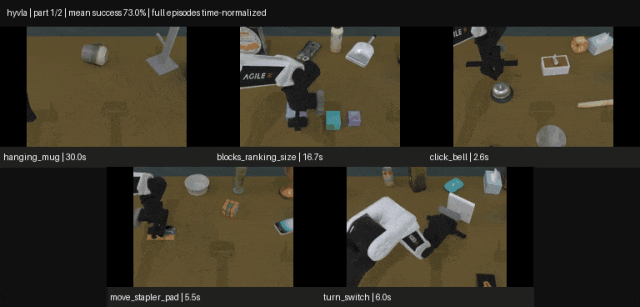
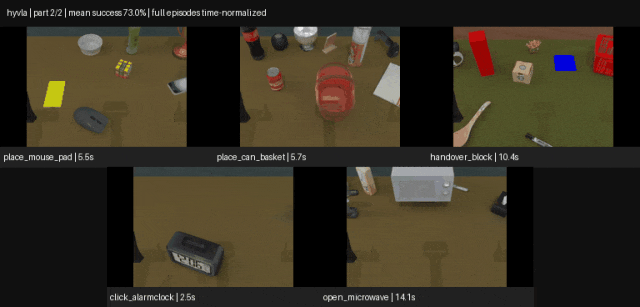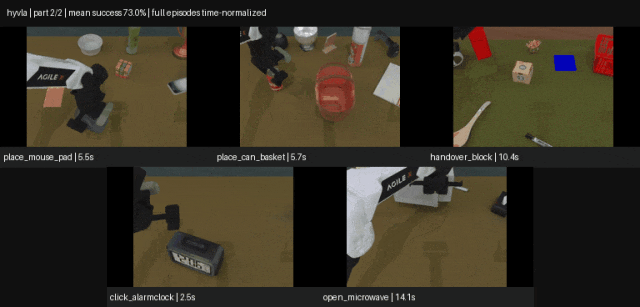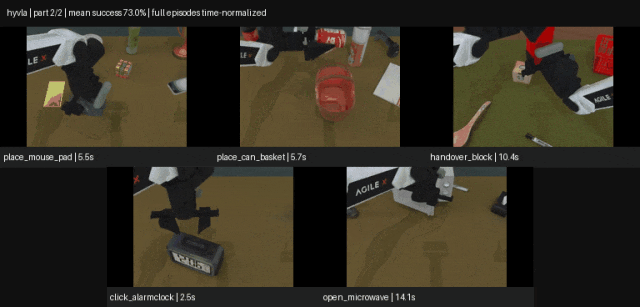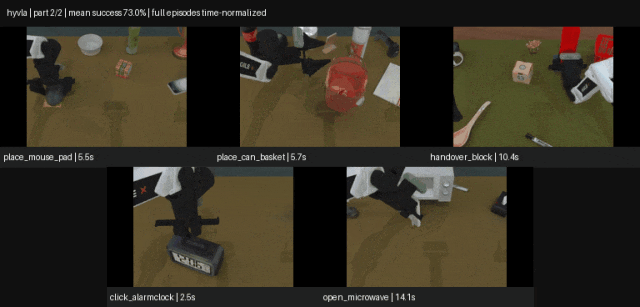
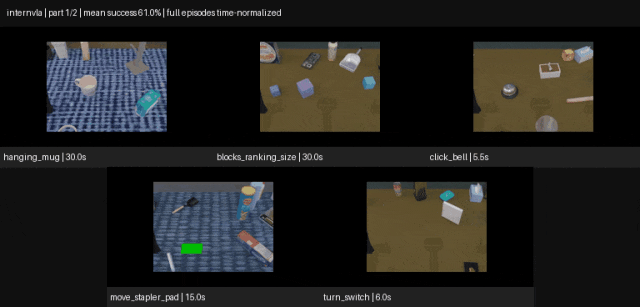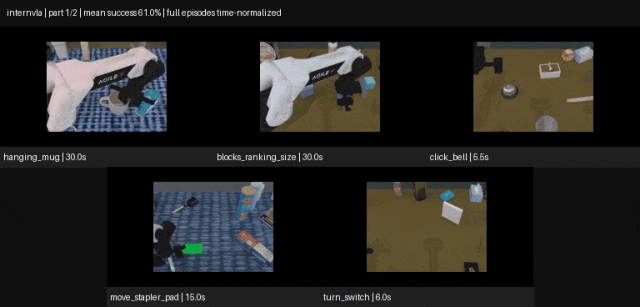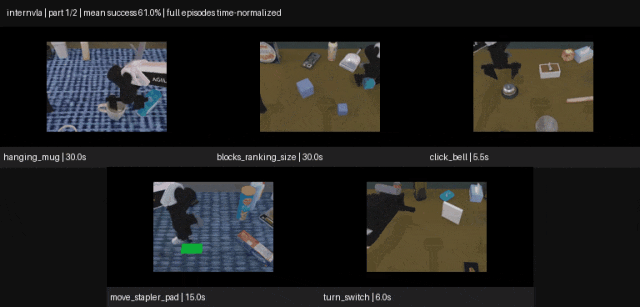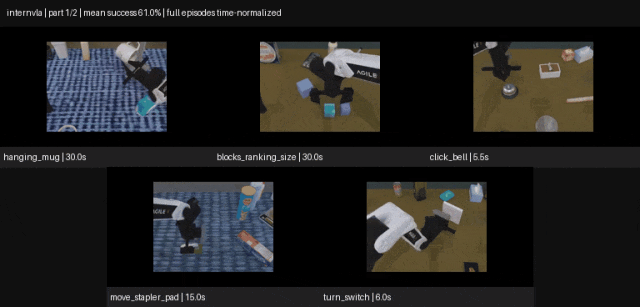
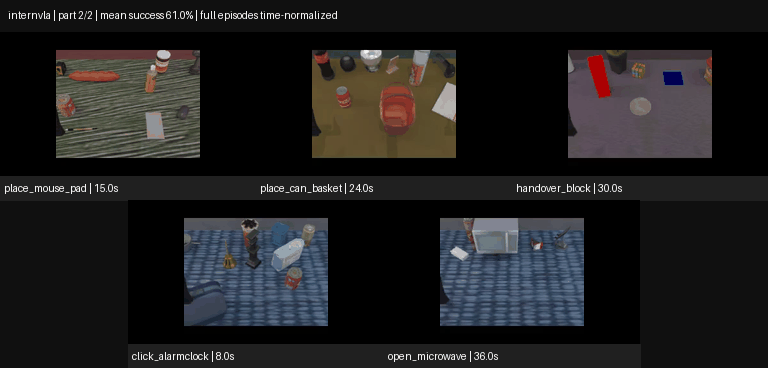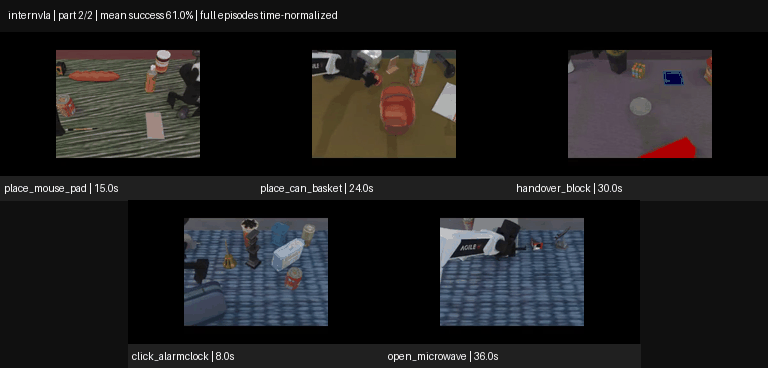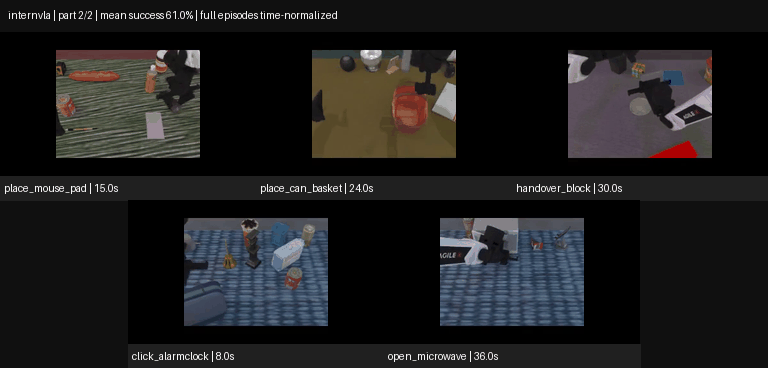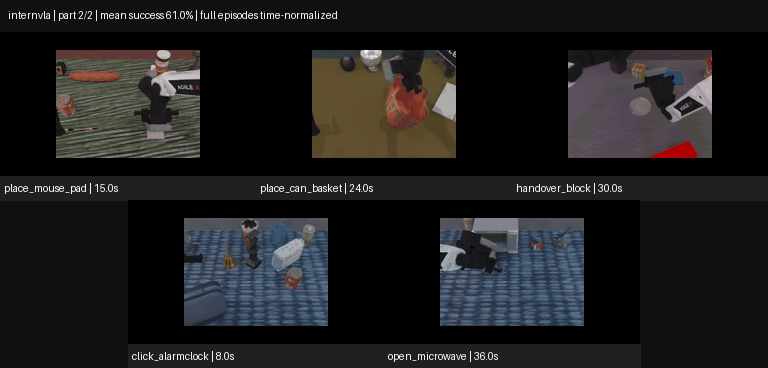
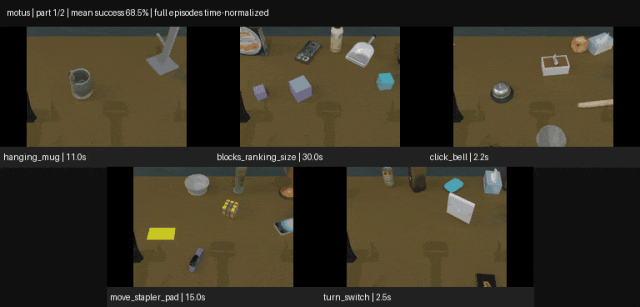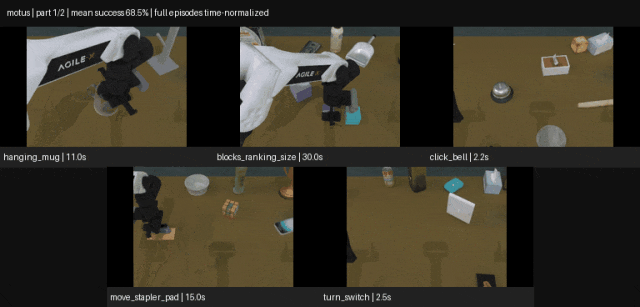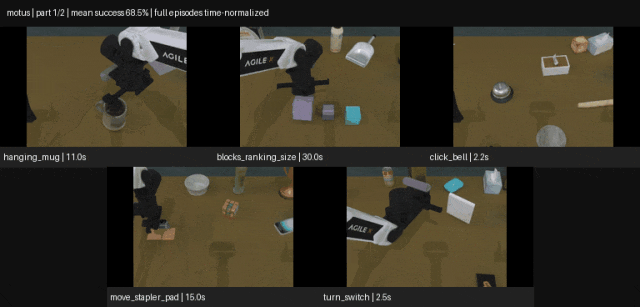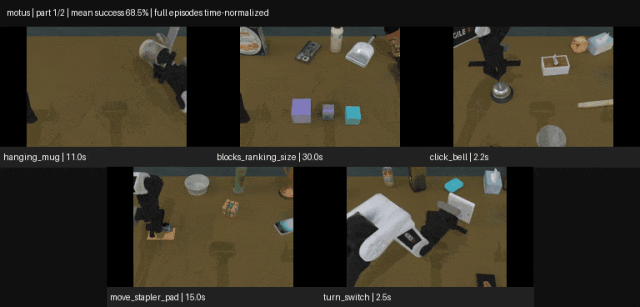
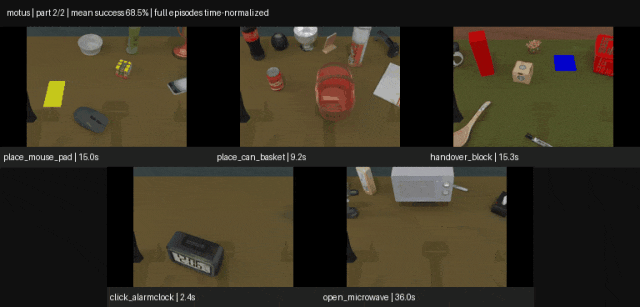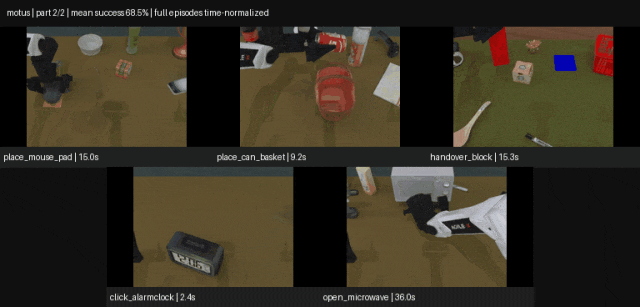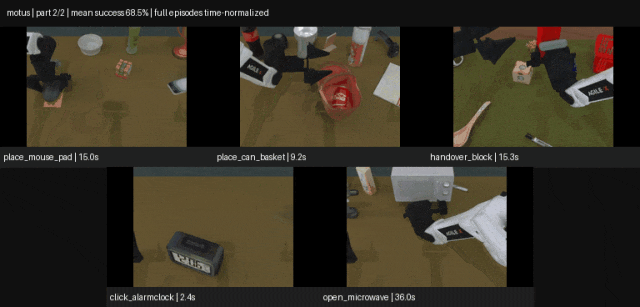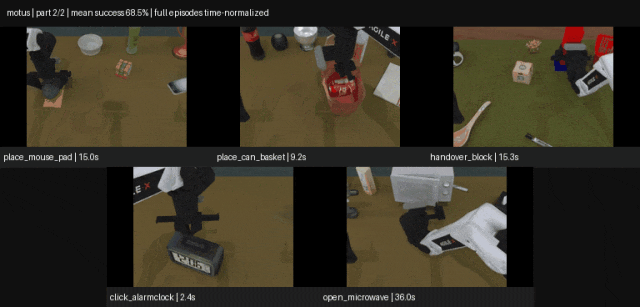
当前评测过程中生成了完整的渲染视频,本次抽取代表性模型回复的渲染结果用于可视化展示。
Hy-Embodied-0.5-VLA-RoboTwin