
 五度妙笔
 企业透视镜
 API商城

 数据库
宋舒然 CoRL 演讲全文:2 万小时训练数据,我们学到了什么?
单击上方“图灵人工智能”,选择“星标”公众号
您想知道的人工智能干货,第一时间送达

转自AI科技评论,仅用于学术分享,如有侵权留言删除
作者丨马晓宁
编辑丨张 驰
机器人学习领域常有一种焦虑:数据还不够,模型还需要更多真实交互。但如果把视线从单个实验室移到整个社区,会发现另一面——大量机器人数据已经被采集并公开,只是分散在不同设备、格式和动作体系中,难以直接复用。
在 CoRL 2026 的 UMI Arena Workshop 上,斯坦福大学副教授宋舒然(Shuran Song)分享了团队对约 2 万小时开源机器人数据的探索:用相机运动统一不同机器人的动作表示,训练能够跨本体迁移的策略模型;再通过 MuSe 引入力觉、触觉等新传感器,同时尽量保留模型原有能力。这场报告讨论的,不只是如何把数据做大,更是如何让数据真正积累为机器人的能力。
以下为根据演讲录音转写和现场PPT核校整理的中文演讲全文。

01
机器人真的缺少数据吗?
大家好!非常高兴来到这里。看到这么活跃、富有创造力的UMI社区,我特别开心,也很期待去看看大家带来的新设备和设计。今天,我想和大家分享一些最近的研究经验:我们尝试利用大规模开源机器人数据训练不同的机器人策略,也从中发现了一些有意思的事情。
这次演讲的题目是:从2万小时开源机器人数据中,我们学到了什么?
2万小时听起来可能并不是一个特别庞大的数字,但我想先强调一点:这2万小时全部来自开源数据。 这意味着,如果我们能够利用这些数据训练出一个模型,其他研究者也可以使用同样的数据进行训练。它们不是某家公司内部积累的数据,而是已经可以从互联网上获取、整个社区都能使用的公共资源。
机器人领域一直有一个普遍的担忧:机器人训练数据不够。大家应该已经听过很多次这种说法了。尤其是对于高校研究人员来说,这个问题更加突出。大学实验室不像创业公司或大型企业,没有那么多资金去购买各种机器人和设备,也很难承担大规模数据采集的成本。
但我想说的是,如果仔细看看目前已经积累的数据,就会发现情况可能没有我们想象得那么悲观。
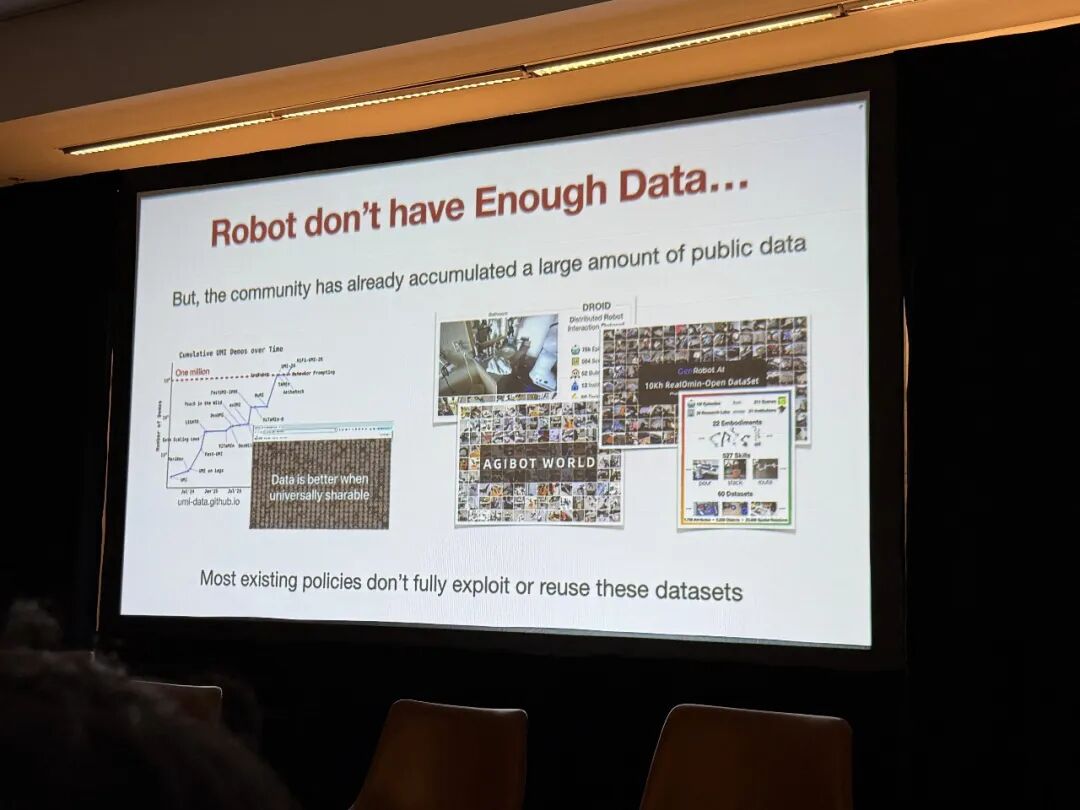
自从UMI推出以来,我们一直在收集社区利用UMI设备采集的各种数据集。越来越多的研究团队对UMI进行了改造,针对不同任务设计自己的设备,然后把采集的数据上传到网站。
今年,我们达成了一个相当重要的里程碑:UMI网站上已经积累了超过100万条开源数据。 而且这还不是全部,今年新产生的一些数据,包括CoRL会议期间出现的数据集,还没有全部整合进网站。
如果把视野从UMI扩展到整个机器人领域,能找到的公开数据就更多了。很多公司和研究实验室都已经开放了自己的机器人数据集,所以整个社区实际上已经积累了相当丰富的公开资源。
那么问题来了:数据明明已经存在,为什么大家还是不愿意重复使用?为什么研究人员往往更愿意在自己的机器人上重新采集一遍数据,再针对自己的任务训练模型?
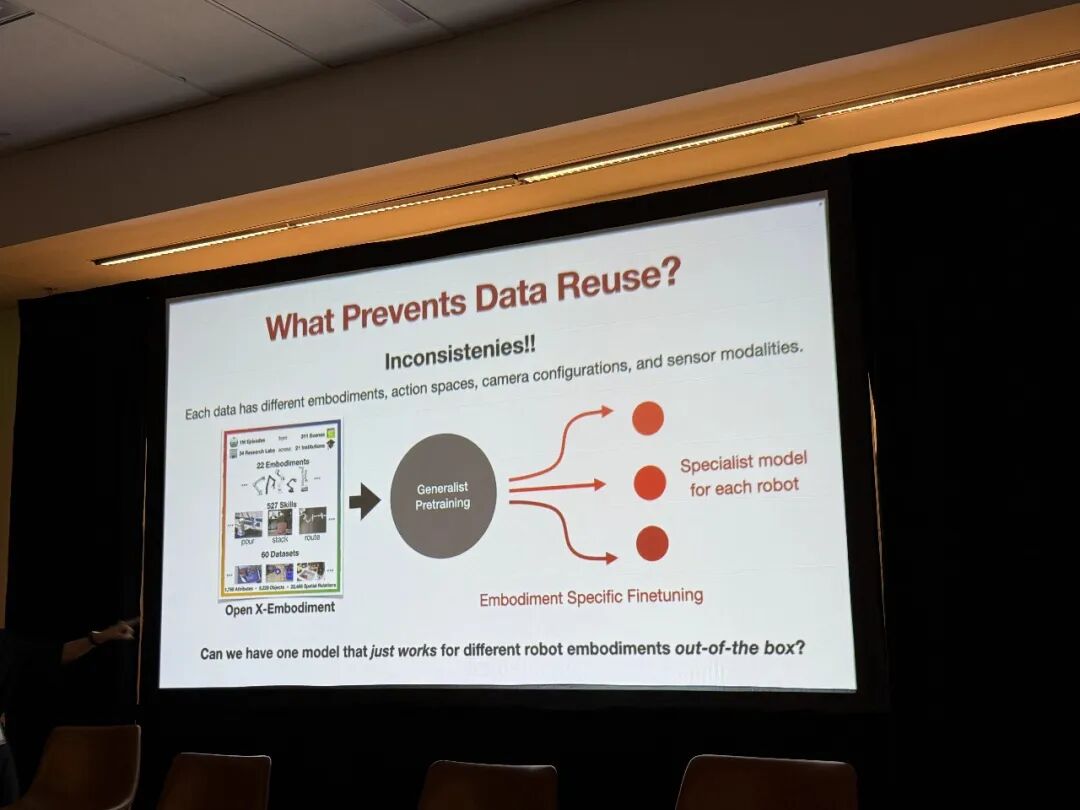
我认为,一个非常直接的原因就是数据之间存在大量不一致。
首先是数据格式不同。不同团队采集的数据,使用的存储格式、动作定义和数据组织方式可能完全不一样。除此之外,由于数据来自不同的设备和机器人系统,它们在机器人本体、动作空间等方面也存在差异。
即使都是UMI,夹爪也可能不同。有的更长,有的更短,有的更柔软,还有一些是为了特定任务重新设计的。各种细微甚至明显的差异叠加起来,就让研究人员很难直接使用其他人采集的数据。
Open X-Embodiment等工作已经证明,将不同来源的数据放在一起训练一个大模型,能够带来跨环境训练的收益。但实际使用时,我们往往还是需要针对自己的机器人进行微调,才能让模型真正运行起来。
这就出现了一个有些遗憾的结果:我们花了很大力气训练一个在多种机器人数据上预训练的通用策略,最后却又把它微调成一个只适用于特定机器人的专用模型。
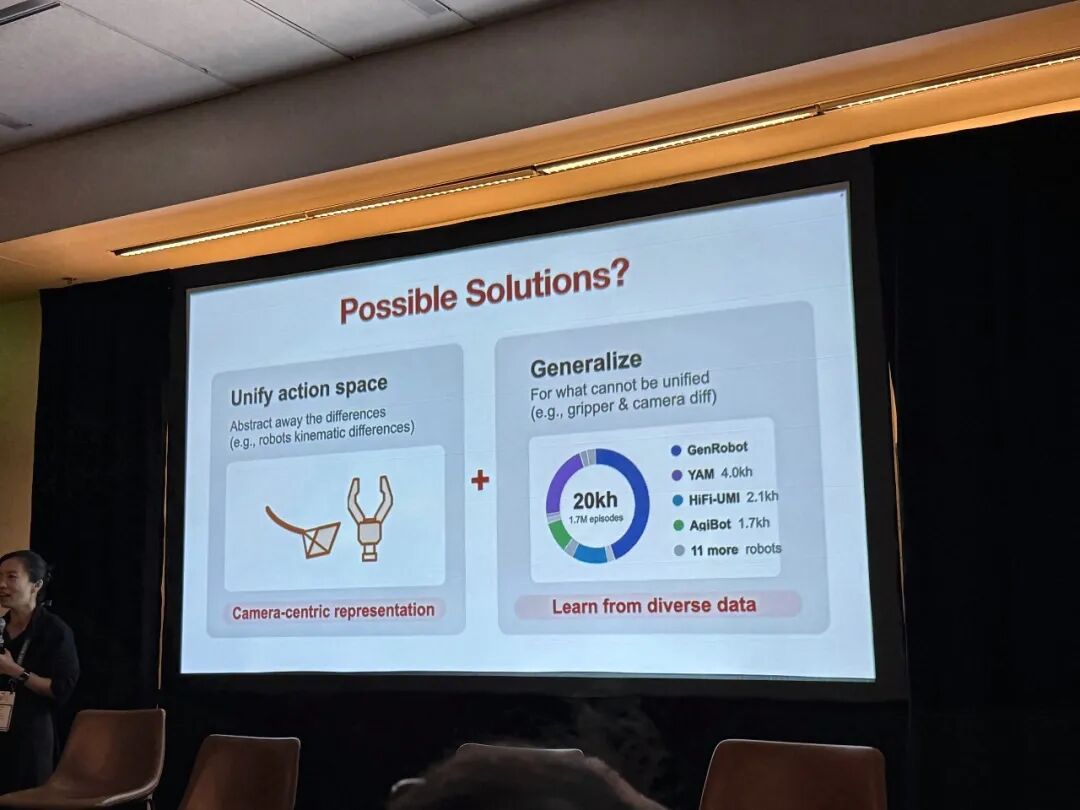
所以,我们真正想解决的问题是:能不能只训练一个模型,让它直接适用于不同形态的机器人?
理想情况下,用户下载模型之后,不需要针对自己的机器人重新采集数据、重新训练,就能够直接部署使用。无论你手里是什么样的机器人,都可以尝试调用同一个模型。
这是一个相当有挑战性的目标,但也是我们这项工作的出发点。
02
用相机运动统一不同机器人的动作表示
那么,怎样才能实现这个目标?
我们的思路主要分成两步。第一步,尽可能统一机器人的动作空间,把不同机器人之间可以抽象掉的差异先处理掉,尤其是运动学结构上的差异。第二步,对于那些无法直接统一的部分,例如夹爪结构和相机配置,则通过多样化的数据训练,让模型学会适应这些差异。
先来看第一步:统一机器人的动作表示。
我们的想法其实很简单,就是用相机运动来表示机器人的动作。
对于熟悉UMI的研究者来说,这个思路应该比较直观。UMI的设计本身就让机器人的动作与相机运动建立了直接联系,两者之间只相差一个刚体变换。因此,只要能够预测相机的运动轨迹,就能够得到对应的机器人动作,模型可能只需要额外预测夹爪的打开和闭合状态。
如果仔细想一想,就会发现这个方法并不只适用于UMI。比如,使用头戴式相机的人类,或者安装了前置相机的移动机器人,都可以采用类似的表示方式。我们只需要让模型预测相机的运动轨迹,就可以把它作为机器人的动作表示。
为什么我认为这是一个好方法?
因为它迫使模型把注意力放在机器人动作中最关键的信息上,也就是末端执行器的运动轨迹,以及与之对应的相机运动,而不必同时理解机器人身体的所有细节。
这样一来,无论你使用的是人形机器人还是移动机器人,模型都只需要预测三维空间中的相机运动轨迹,就能够绕开不同机器人之间复杂的运动学差异。如果还需要关节级控制,只需要把预测结果交给全身控制器,就能进一步转换成关节动作。策略模型本身不必操心这些底层控制细节。
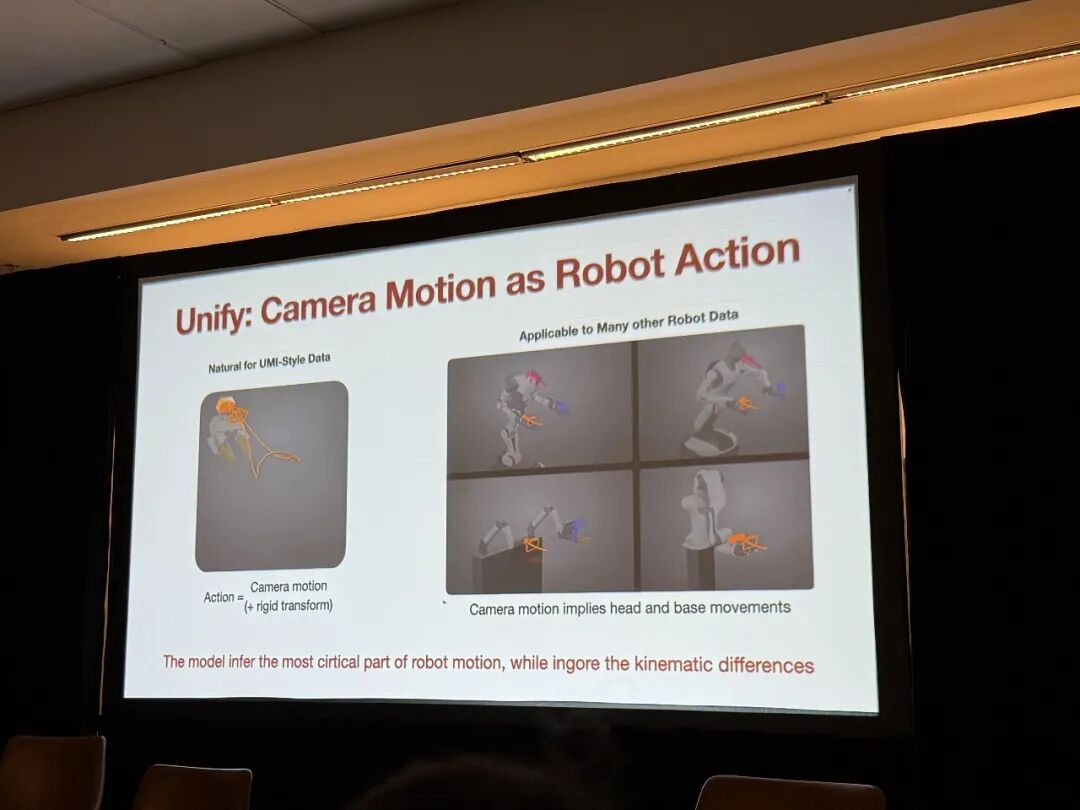
这就是我们统一动作表示的基本思路。
有了这个方法之后,之前那些看起来差异很大的机器人数据,就可以放到同一个框架里了。
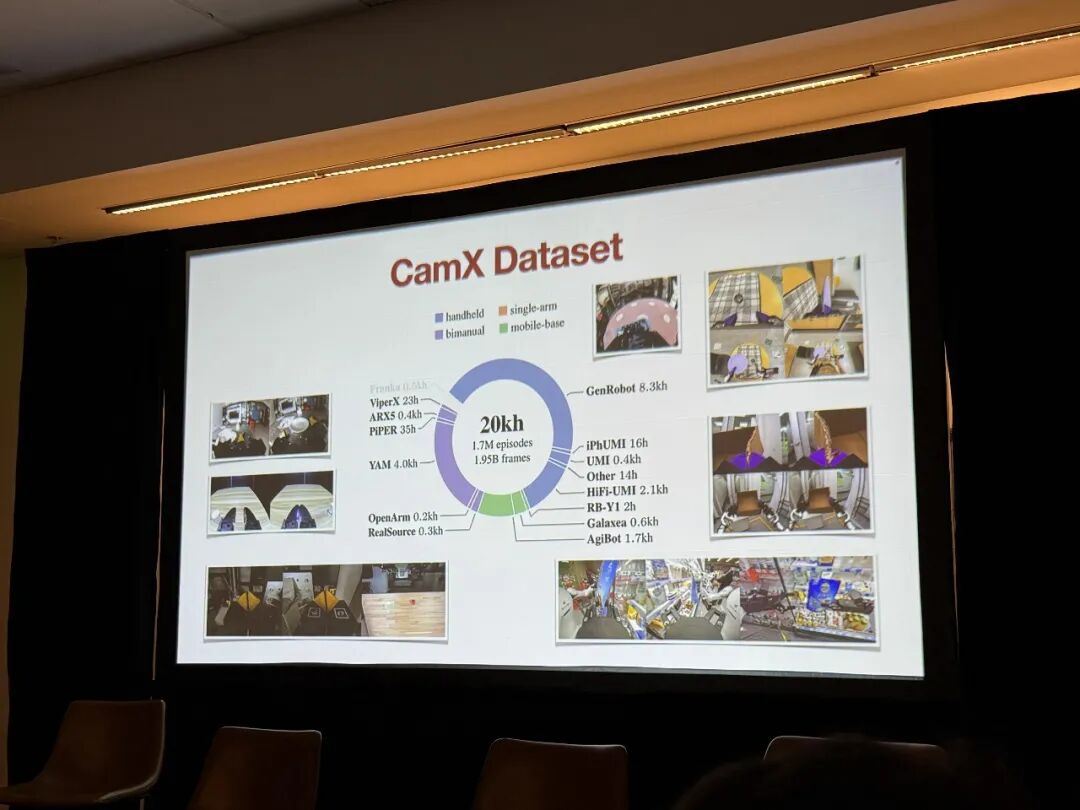
我们收集的2万小时开源数据中,很大一部分来自UMI社区,很多在座的研究者都为这些数据集作出了贡献。除此之外,我们还转换了大量移动操作机器人数据,这些机器人通常配备头部相机和底座相机,同样可以使用相机运动轨迹来表示动作。
双臂操作数据也可以采用类似的方法。例如,一些双臂操作数据集包含两条运动轨迹,分别对应左右两侧的相机。这样,我们就可以用同一种方式表示单臂和双臂操作数据。
为此,我们花了相当多的时间,从不同来源下载数据、清理数据,并把它们转换成统一格式。最终,所有数据都被整理成两类信息:图像和动作表示,不同机器人的动作也被转换到统一的表示空间中。
PPT展示的CamX数据集统计进一步显示,这些整理后的数据已经达到约170万条Episodes和19.5亿帧。原本分散在不同机器人和研究团队手中的数据,现在终于能够放在一起使用了。
03
CamUVA:一个模型
同时预测未来视频和机器人动作
完成数据统一之后,下一步就是训练一个能够利用这些数据的大规模策略模型。
我们的模型在概念上其实很简单:输入包括两部分,一部分是过去的视觉观察,以视频形式表示;另一部分是过去执行的动作,以相机位姿的形式表示。模型需要根据这些信息,预测未来的视频和未来的动作。
我们把这个模型称为 Camera-centric Unified Video Action Model,简称CamUVA,也就是以相机为中心的统一视频动作模型。
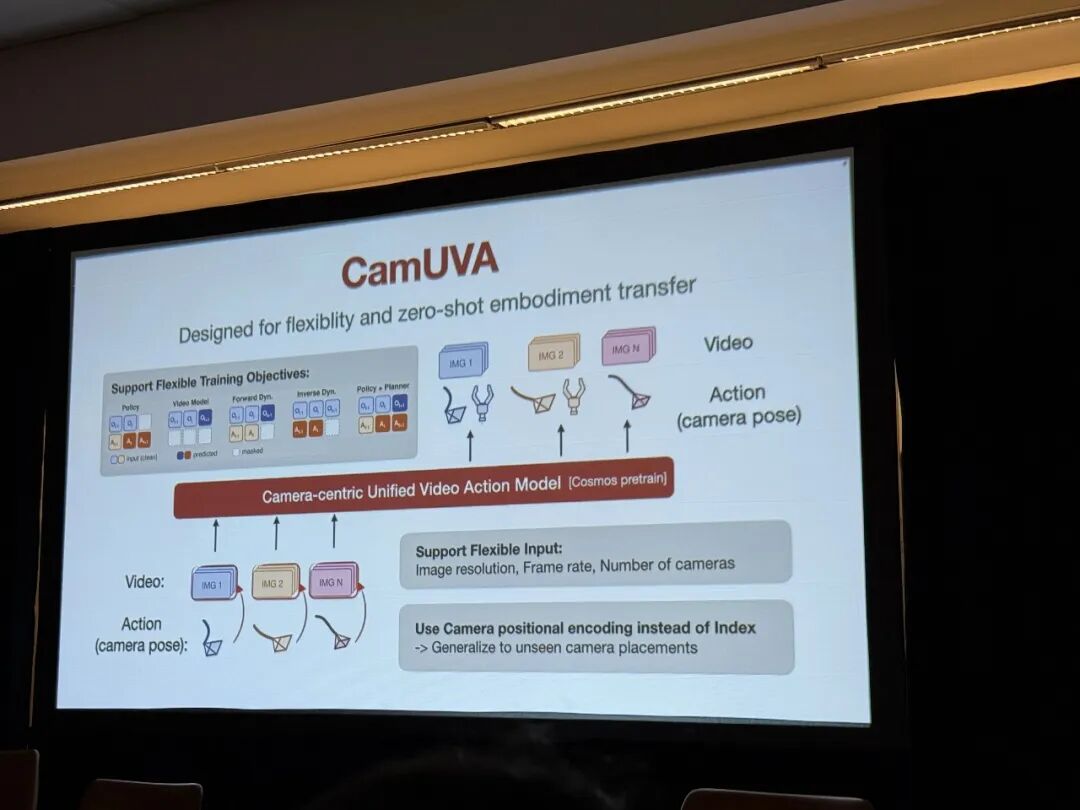
CamUVA建立在开源的Cosmos预训练模型之上。Cosmos本身是一个视频模型,也支持视频动作建模。在设计CamUVA时,我们最重要的考虑是尽可能提高模型的灵活性,让它最终能够适应不同的机器人本体。
具体来说,我们做了几项设计。
首先,模型需要支持灵活的输入形式。不同机器人使用的相机可能具有不同的图像分辨率、帧率和相机数量,因此CamUVA需要能够处理这些差异,而不能要求所有机器人都采用完全相同的视觉输入配置。
其次,我们采用了相机位置编码(Camera Positional Encoding),而不是简单地使用相机编号来表示不同视角。这一点对于模型适应不同的相机配置非常重要,后面我会进一步解释。
另外,模型还采用了比较灵活的训练目标。从功能上看,CamUVA既是一个策略模型,也是一个视频模型。它可以根据过去的视频和动作预测未来的视频,因此也具备视频生成能力。
同时,模型还使用了正向动力学和逆向动力学训练目标。正向动力学是根据当前观察和动作预测未来状态;逆向动力学则是根据视频观察推断机器人执行的动作。
例如,如果只给模型输入一段视频,让它预测对应的机器人动作,那么它实际上是在根据视觉观察重建相机位姿。因此,CamUVA不仅可以用于机器人策略,还可以作为视频生成模型、规划器,甚至用于动作重建。
我们希望通过这种灵活的设计,让同一个模型能够充分利用尽可能多的开源机器人数据。
接下来,我想重点分享训练这个大模型之后,我们究竟发现了什么。我会分成两个部分:第一,模型设计中哪些因素真正重要,哪些设计能够帮助我们有效扩大训练规模;第二,如果能够统一不同机器人的动作表示,并利用大量多样化数据训练模型,究竟可以获得哪些新的能力?
▎动作表示方式:相机空间为什么更好?
我们首先研究了不同动作表示方式的效果。具体来说,我们想验证:相机空间表示是否真的比传统的关节空间表示更适合跨机器人训练?
关节空间是机器人领域最常见的动作表示方式,很多跨本体模型默认使用的也是关节空间动作。因此,我们专门设计了对照实验,比较Camera-Space和Joint-Space两种表示方式。
实验中,我们使用三种不同的机器人本体进行训练,包括Joint、AGI机器人和ABC双臂操作系统,然后在其中一个训练环境的数据集上进行测试。
结果相当明确:当训练数据来自不同机器人时,相机空间表示的模型表现明显更好。 PPT中的实验结果显示,相机空间表示在单一本体训练测试和多本体混合训练设置下,分别带来了约9%和13.3%的性能提升。
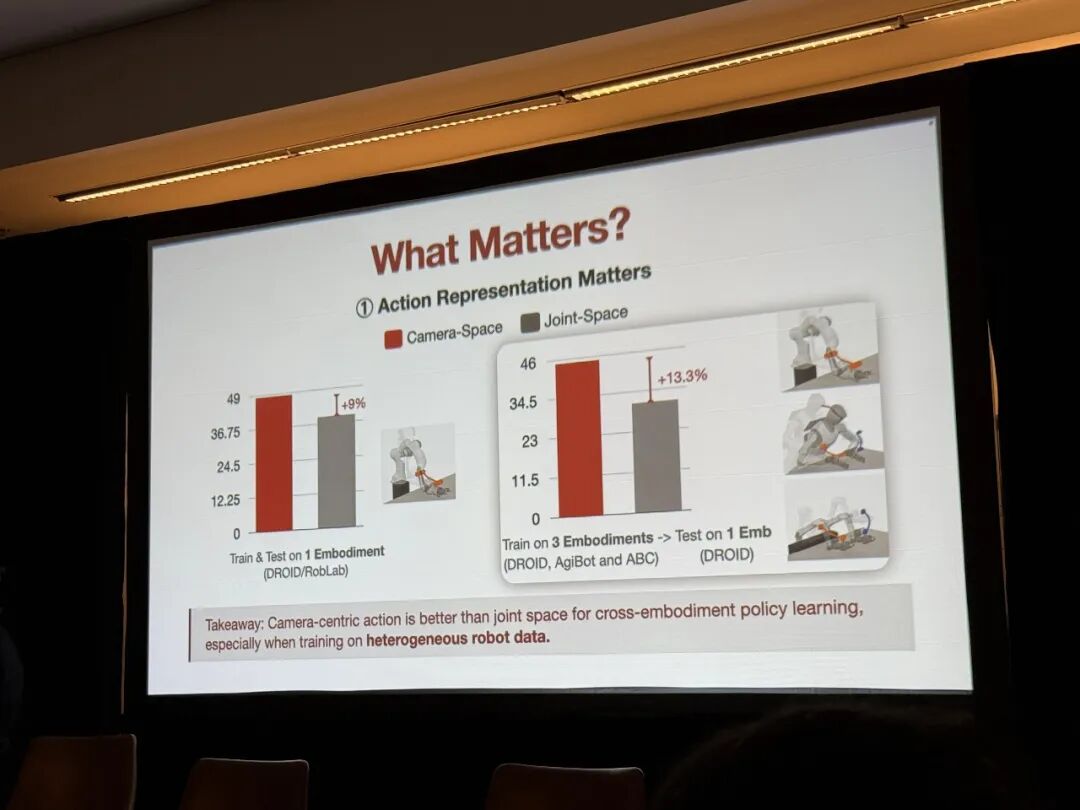
我认为,这是一个相当有说服力的结果,说明相机空间表示确实更适合多种机器人数据共同训练。
从直觉上也很容易理解。相机空间表示只需要模型关注末端执行器的运动,不需要它完整理解不同机器人的动作空间。模型只需要学习一种运动表示,而不是同时学习三种完全不同的动作空间。
即使在相同机器人本体上训练和测试,相机空间表示也能带来一定收益,我认为这可能与它具有更低维度的表示有关。但最大的提升,还是出现在使用多种机器人数据进行训练的情况下。
▎相机位置编码:让模型理解不同相机之间的空间关系
第二个重要的设计选择是相机位置编码。
前面提到,在处理视频和图像数据时,我们使用相机位姿作为图像Token的位置编码。在传统的视频模型中,位置编码通常用来表示不同图像Token在时间或空间上的位置,多相机系统也需要一种方式,让模型区分来自不同相机的图像。
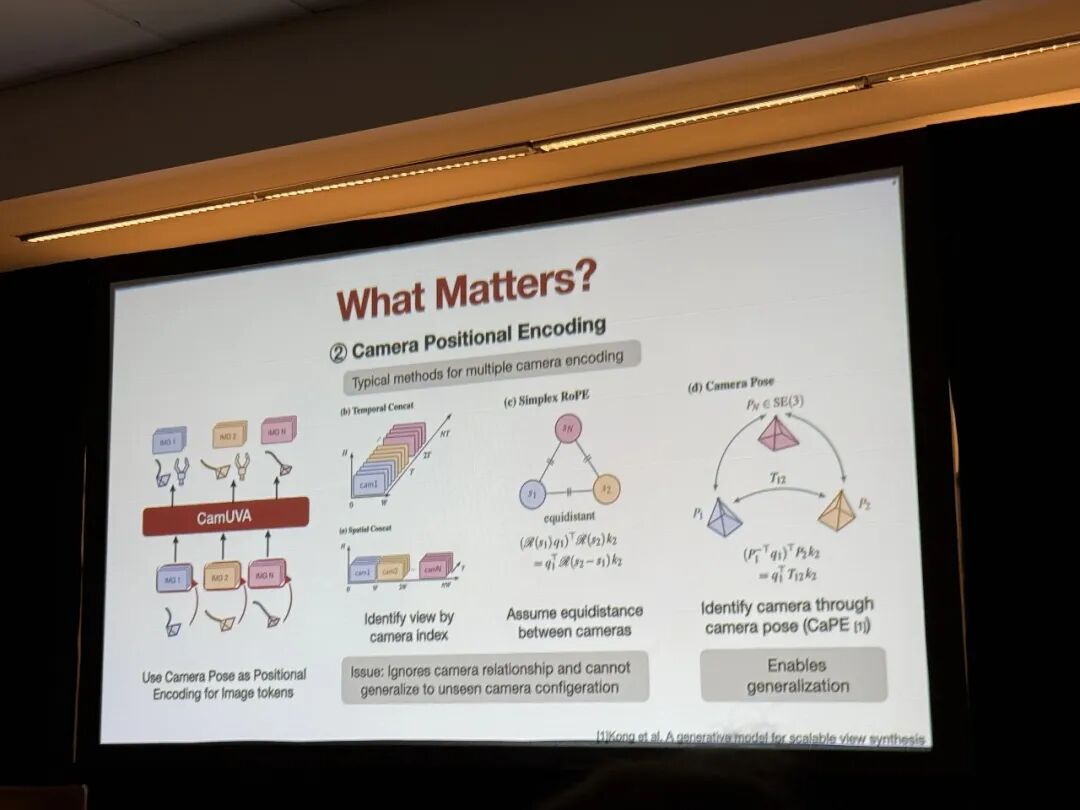
一种比较简单的做法,是把不同视角的图像在时间维度或者空间维度上进行拼接。这种方法看起来没有什么问题,但实际上会带来一个限制:模型需要记住每个视角对应的相机编号。
如果把相机移动到另一个位置,模型就需要重新学习视角与相机之间的对应关系。而且,这种方法也不容易适应不同数量的相机输入。
还有其他一些相机编码方法,例如Simplex RoPE,也会对不同相机之间的空间关系作出一定假设。它们共同存在的问题是:没有充分考虑不同相机之间真实的相对空间关系。
因此,当机器人系统增加新的相机,或者改变相机位置和配置时,模型可能无法直接适应,甚至需要重新训练或微调。
我们的做法是直接使用相机位姿来编码图像。这样,模型不仅知道图像来自哪个视角,还能够理解不同相机在空间中的相对位置。即使相机位置发生变化,或者系统增加新的相机,模型也更容易适应新的配置。
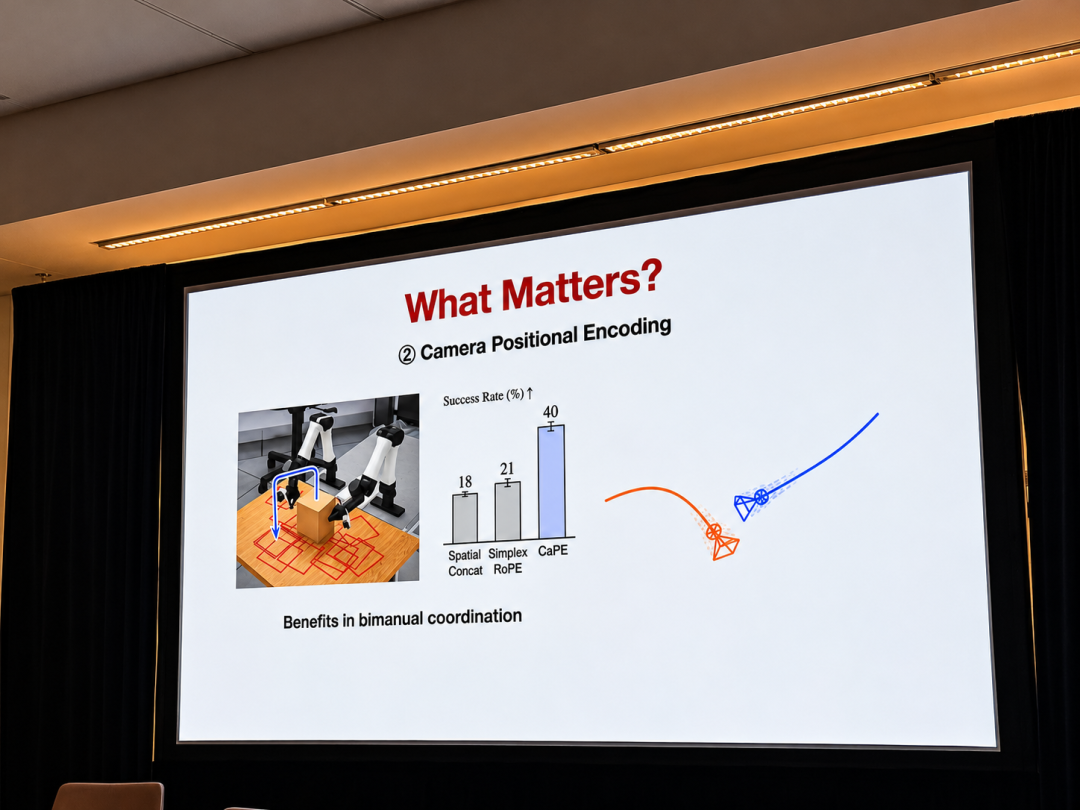
这种方法并不是我们首次提出的。它被称为CaPE(Camera Positional Encoding),在计算机视觉领域,多相机系统已经使用类似的方法来编码相机的位置关系。我们将它引入机器人视频动作模型,发现了一个很有意思的现象:这种编码方式对于双臂操作尤其有帮助。
为什么会这样?
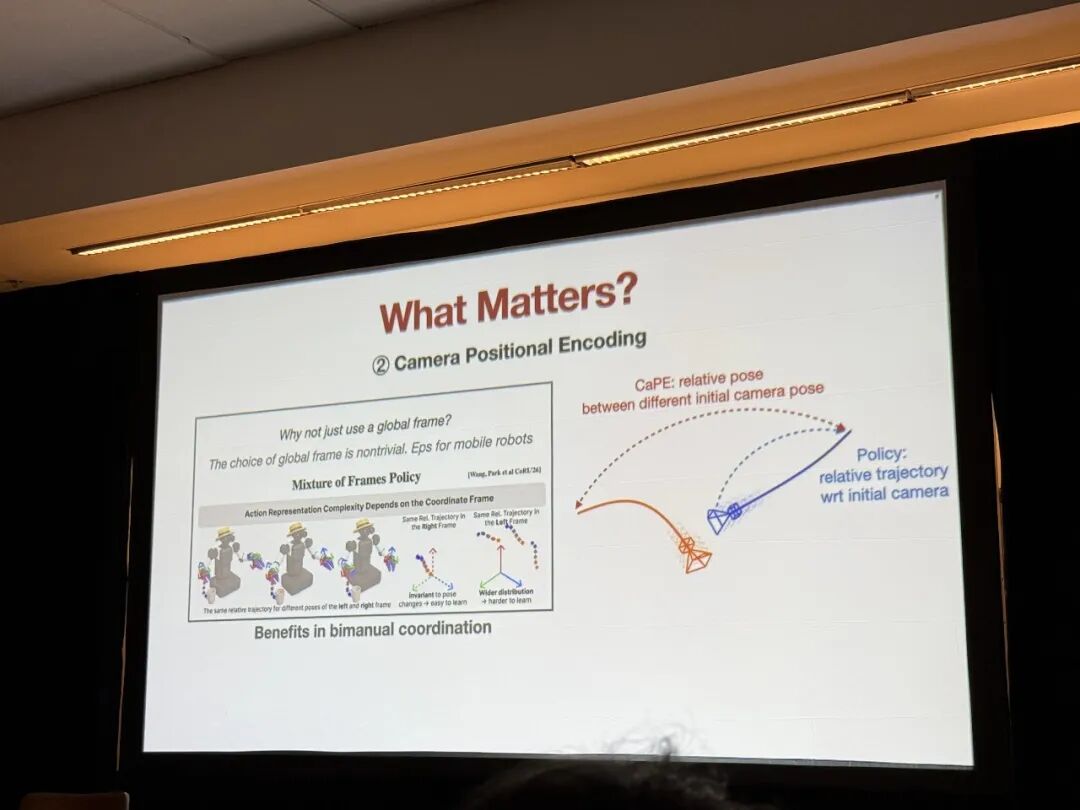
在训练Diffusion Policy时,动作通常会表示为相对轨迹。也就是说,所有相机位姿都是相对于轨迹中的第一个相机位姿来表示的。这种表示方式有很多好处,但有一个不足:模型并不知道不同相机之间的相对位置。
引入相机位置编码之后,这部分空间信息就被补充进来了。对于双臂操作来说,这一点尤其重要。比如,两只机械臂需要同时到达某个指定位置,模型不仅要知道每只机械臂应该怎么运动,还需要理解两者之间的空间关系,才能更好地协调动作。
实验中,我们确实观察到了明显的提升。PPT展示的双臂协调任务结果中,CaPE取得了40%的成功率,而另外两种对比方案分别为18%和21%。
所以,如果你也在训练多相机系统,尤其是涉及双臂协同的操作任务,我认为这种方法非常值得考虑。
这里还有一个有意思的问题:既然我们希望模型理解不同相机之间的相对位置,为什么不直接使用全局坐标系来表示相机位姿?
实际上,对于移动操作机器人来说,全局坐标系的选择并不简单。应该把它放在机器人头部、底座,还是桌面上?不同的选择可能让模型表现出现很大差异。我们甚至专门有一项研究,讨论移动操作任务中应该如何选择最合适的坐标系。
如果暂时不想处理这些复杂问题,那么使用相对于各自相机的运动轨迹,再结合相机位置编码,就是一个很好的起点。这也是这组实验最重要的结论:相机位姿编码不仅支持更加灵活的相机配置,还能改善双臂操作中的空间协调能力。
▎模型规模与计算预算:大模型不一定总是更划算
接下来,我们研究了模型规模带来的影响。这部分结果可能不会让大家特别意外,但我还是觉得有必要展示,因为这些实验的计算成本其实并不低。
我们比较了两个不同规模的模型:较大的Cosmos Nano 16B和较小的Cosmos Edge 4B,并在不同计算预算和Batch Size设置下进行训练。
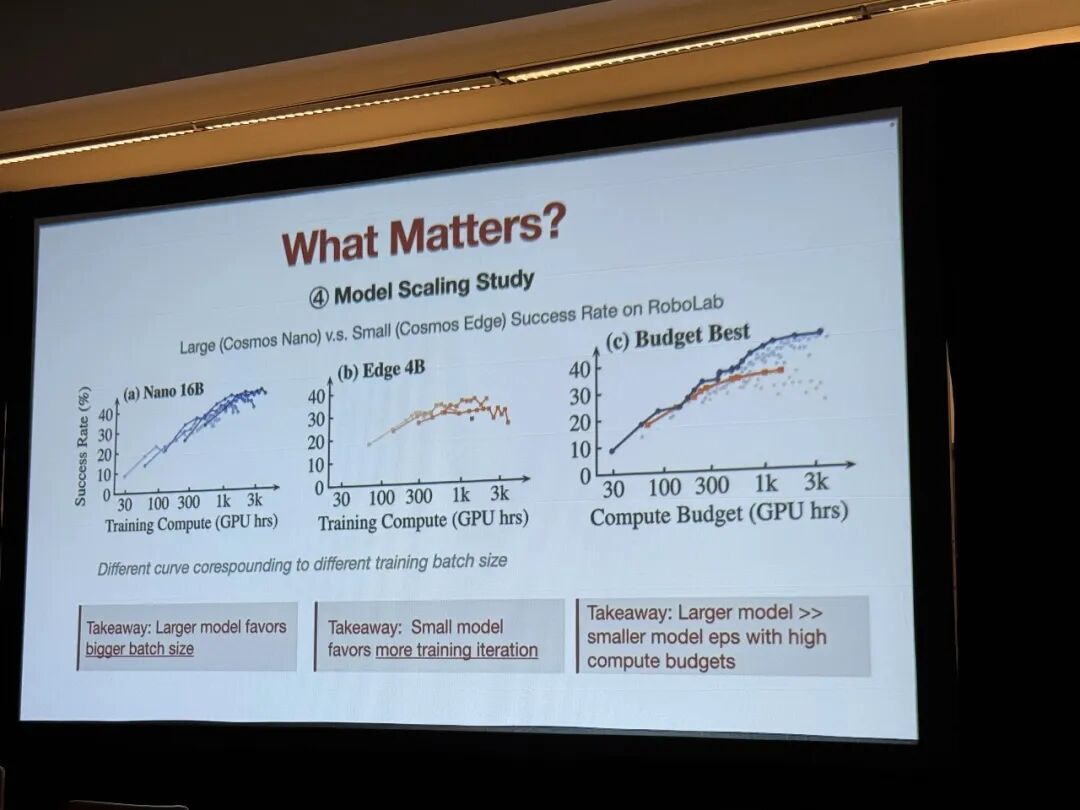
实验得到几个有意思的结果。首先,大模型更倾向于从较大的Batch Size中获益。如果想充分发挥大模型的能力,可能需要使用更大的Batch Size;而对于小模型来说,延长训练时间可能带来更多收益。
其次,大模型整体表现更好,这并不令人意外。但真正值得注意的是,大模型只有在获得足够计算资源时,优势才会体现出来。
如果计算预算非常有限,直接训练一个大模型未必是最好的选择。在这种情况下,训练一个较小的模型可能反而更加划算;但如果计算预算足够,大模型确实能够取得更好的表现。
所以,模型规模不能脱离计算预算单独讨论。选择多大的模型、采用多大的Batch Size,以及训练多长时间,都需要结合实际资源来决定。
04
训练2万小时数据后,
机器人获得了哪些新能力?
前面介绍的是模型设计。接下来,我想展示的是:当我们真正把不同来源的机器人数据统一起来,并使用这些数据训练一个大模型之后,究竟能够获得什么样的能力。
从这里开始,接下来展示的所有实验结果,都来自同一个CamUVA模型检查点。这里有一个非常重要的前提:我们没有针对不同机器人或不同任务额外采集微调数据,所有实验都使用同一个模型检查点进行零样本评估。

▎同一个模型适用于不同机器人
首先,我们测试模型在训练数据中已经出现过的机器人本体上的表现。训练数据包含多种不同的机器人形态,我们想知道,同一个模型能不能直接在这些机器人上运行。
答案是肯定的。
同一个CamUVA模型可以直接适用于这些不同的机器人本体,不需要针对每一种机器人单独进行微调。
我们还将它与此前一些专门针对不同基准进行优化和后训练的方法进行了比较。结果显示,单个CamUVA模型取得了具有竞争力的表现,有时甚至超过了专门针对特定基准训练的模型。
其中一个比较有说服力的结果,是与π0.5进行比较。π0.5首先使用自己的数据进行预训练,然后再针对相应数据集进行微调,而CamUVA只使用公开的开源数据进行训练,却能够取得更好的表现。
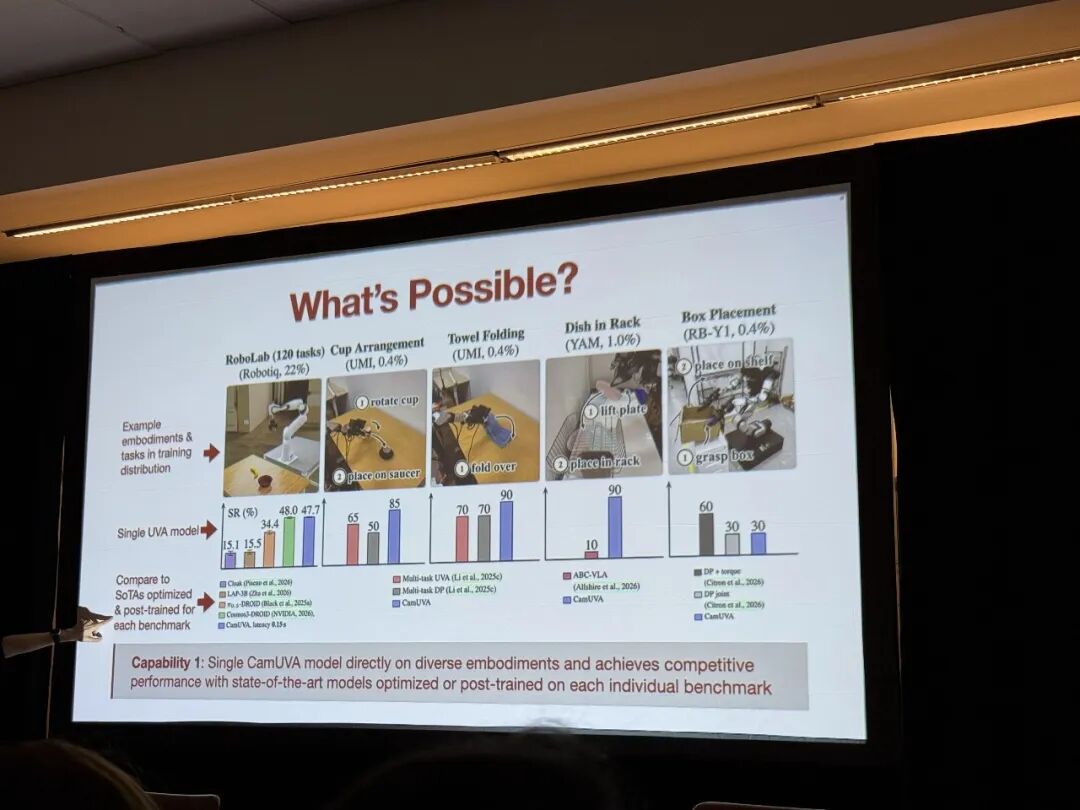
这说明,利用多样化的开源机器人数据训练统一模型,确实能够获得相当强的跨机器人泛化能力。
▎从训练过的机器人,迁移到从未见过的机器人
接下来,我们进一步测试模型在训练数据之外的机器人本体上的表现。这一次,实验设置更加严格:对于每一项任务,我们都有对应的训练机器人,然后在不同于训练机器人的其他设备上进行测试。
这些机器人可能使用完全不同的夹爪,也可能具有不同的相机配置。我们重点关注这两类差异,因为相机中心表示已经帮助我们抽象掉了机器人运动学结构上的差异,但夹爪和相机本身的差异,仍然需要模型在部署时处理。
实验中,每项任务都有一个训练环境,也就是模型已经见过的机器人和任务组合;除此之外,还有迁移环境,以及完全没有在训练数据中出现过的新环境。例如,我们专门设计了一些新的手指几何结构,让模型面对从未见过的夹爪。
测试任务包括抓取瓶子并将其倾斜倒出、将物体翻转至直立状态、抓取杯子并放入盒子,以及抓取香蕉并将其放入容器等。
实验结果表明,经过多种机器人环境的数据训练后,模型学到的任务知识能够迁移到其他机器人上,甚至可以迁移到训练期间从未见过的环境。
这就是跨本体训练带来的重要能力:一个机器人上学到的任务知识,可以迁移到其他机器人,甚至适用于新的机器人结构。
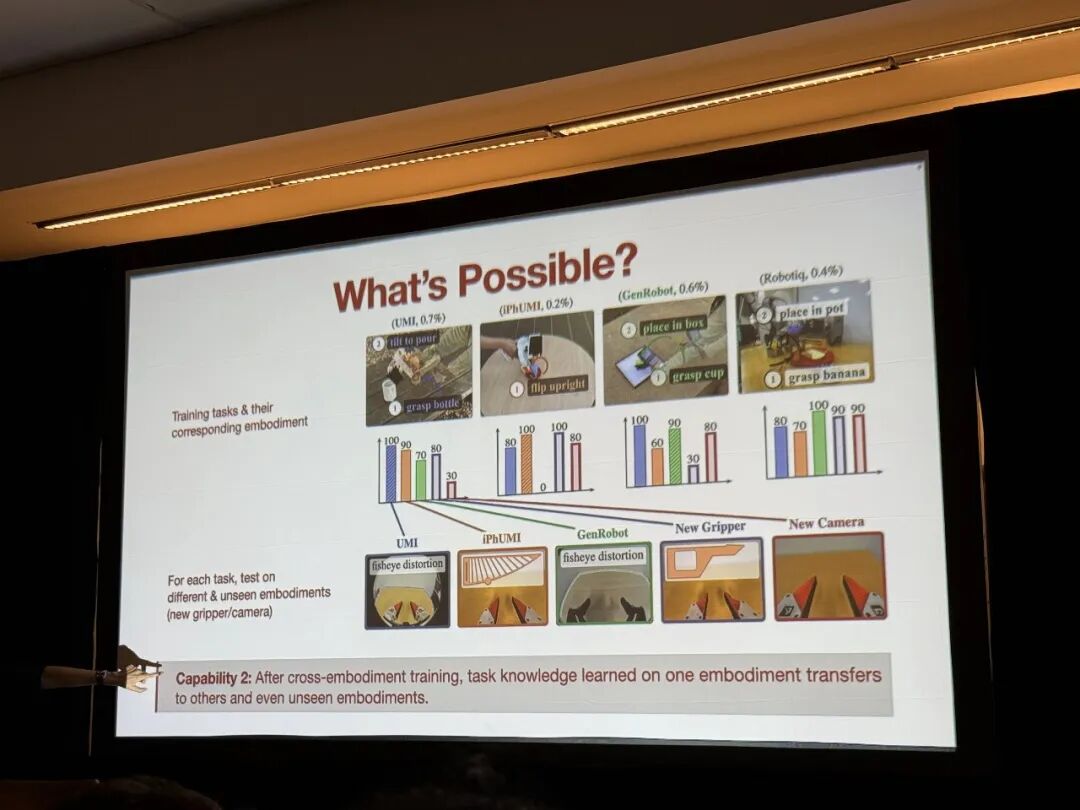
为了进一步验证这一点,我们还使用了多种不同的相机和夹爪进行测试。相机包括鱼眼相机、iPhone相机,以及具有不同视场角的普通针孔相机;夹爪则包括原始UMI夹爪、通用机器人夹爪,以及专门随机设计出来、用于测试泛化能力的新夹爪。
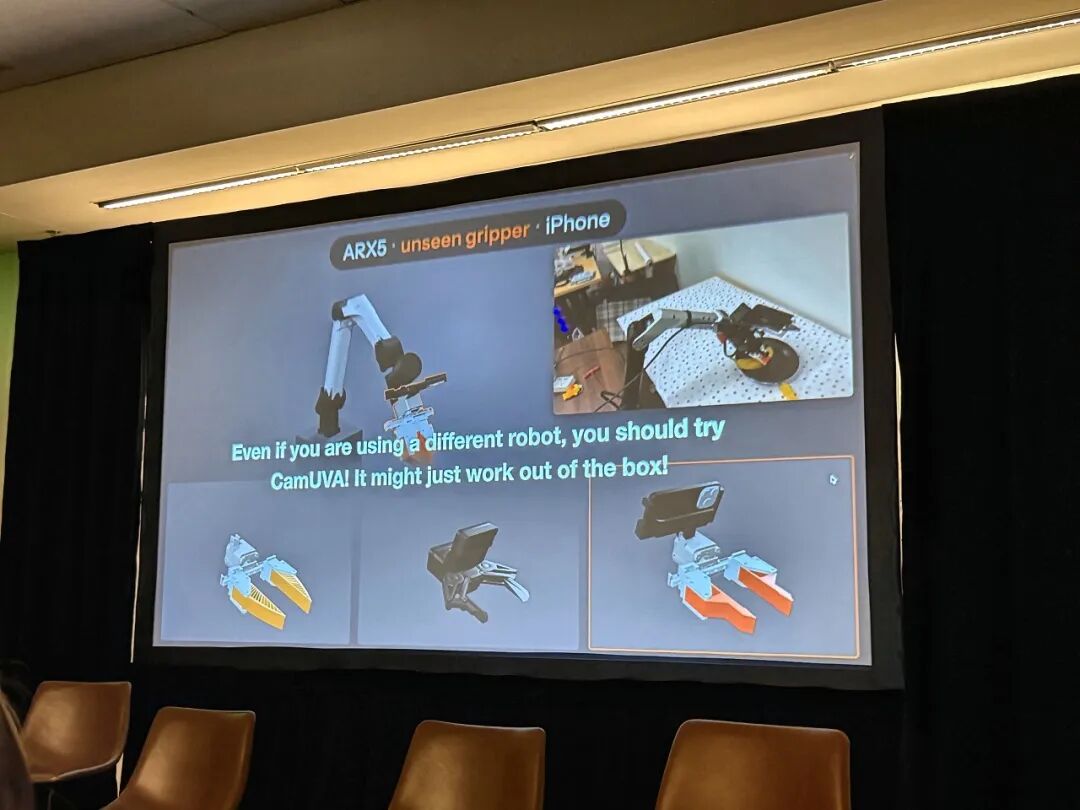
现场展示的实验还包括ARX5机器人使用未见过的夹爪和iPhone相机的情况。
这里我想给大家一个非常实际的建议:即使你使用的是一台与训练机器人差异很大的设备,也可以尝试使用CamUVA。
我们计划公开发布模型检查点,大家可以下载下来,在自己的机器人上试一试。它可能不需要额外适配,就能直接运行。毕竟我们已经在很多不同的机器人系统上进行了测试,在大多数测试案例中,模型都能够正常工作。
这就是利用相机中心表示统一不同机器人数据之后,我们获得的一项重要能力。
05
机器人不只有摄像头:
如何让模型学习新的传感器?
不过,讲到这里,大家可能会想到另一个问题:除了图像数据,机器人能不能利用其他传感器的信息?
我觉得UMI社区一个非常令人兴奋的地方,就是大家一直在尝试为设备增加不同的传感器。在我们自己的团队里,我们研究过力传感器、触觉传感器和声音传感器。如果大家去UMI网站看看,还会发现更多不同的设备改造方案,包括各种触觉、力觉和3D传感器。
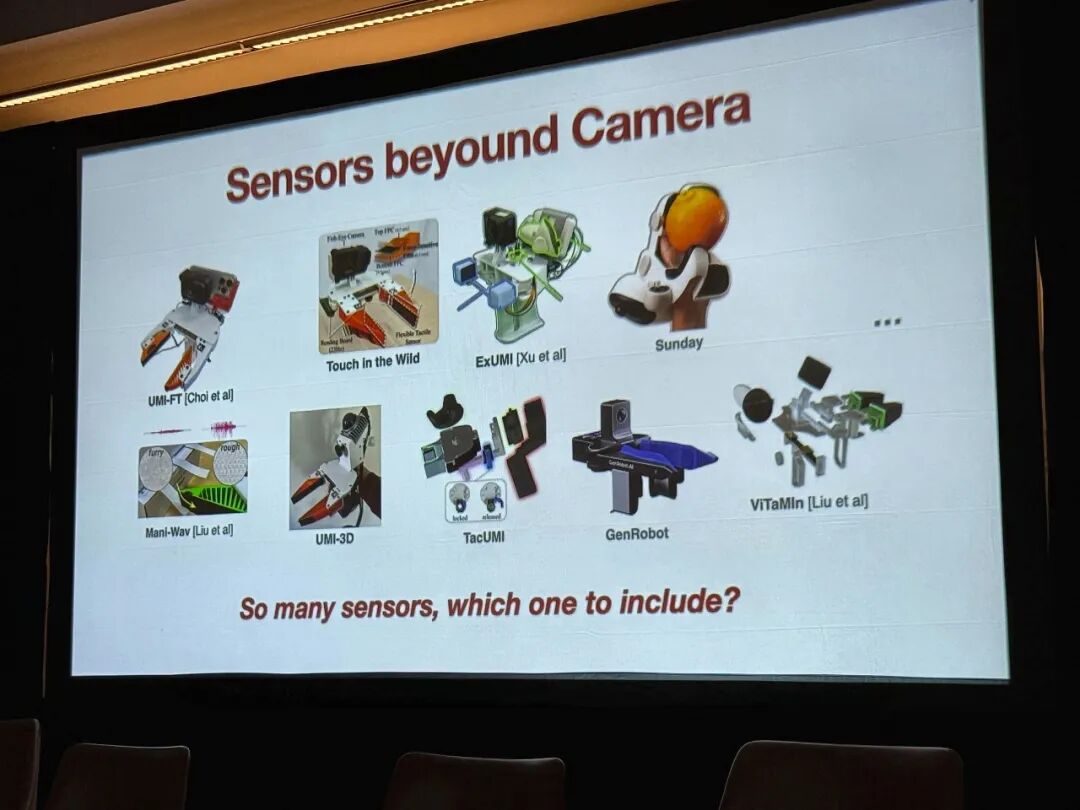
而且,几乎每隔一两周,就会有新的项目尝试给UMI增加传感器。
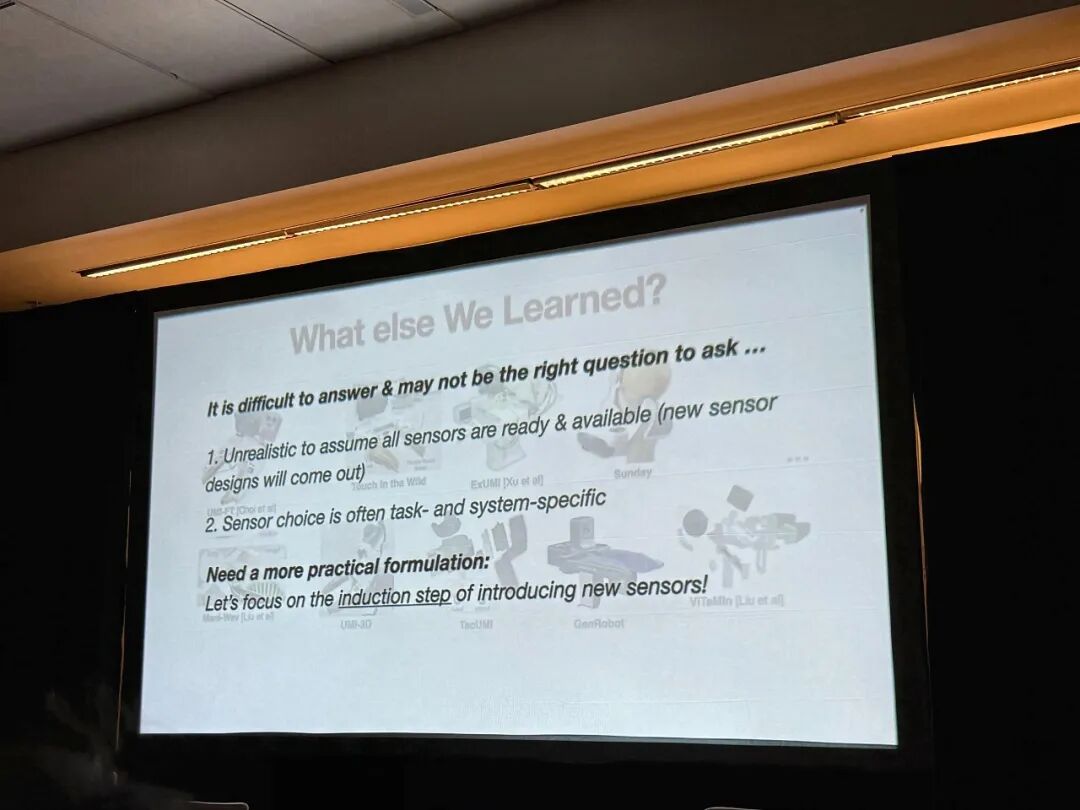
那么,一个很自然的问题就是:面对这么多不同的传感器,我们究竟应该选择哪些,把它们加入统一的机器人模型?
我认为,这个问题其实很难回答,而且可能本身就不是一个正确的问题。
首先,我们不能假设在进行大规模数据采集时,所有需要的传感器都已经准备好了。现实情况恰恰相反,新的、更好的传感器一直在出现,尤其是力觉和触觉传感器,技术还在不断发展。
其次,传感器的选择往往与具体任务和机器人系统有关。不同应用需要不同的传感器,很难要求整个研究社区都采用一套固定的传感器配置。很多时候,研究人员需要根据自己的任务和应用场景选择合适的设备。
所以,与其一开始就试图训练一个包含所有传感器模态的模型,我认为我们需要一种更实际的思路:先使用最常见的传感器完成预训练,之后再研究如何把新的传感器引入模型。
例如,我们可以先使用视觉数据完成预训练,等新的力传感器或触觉传感器出现之后,再把它们加入模型。
这里真正需要解决的问题是:引入新传感器之后,模型能不能保留原来已经学到的知识?原来的任务还能不能做好,甚至能不能变得更好?
这就是我们最近一个项目MuSe想要解决的问题。
▎MuSe:让模型逐步学习新的感知能力
MuSe的全称是MultiSensory World Model,即多感官世界模型。
我们的基本思路是,首先使用纯视觉数据进行预训练。可以把它理解为使用原始UMI设备,也就是只有普通彩色相机的数据。等模型完成预训练之后,再尝试引入力传感器等新的模态。
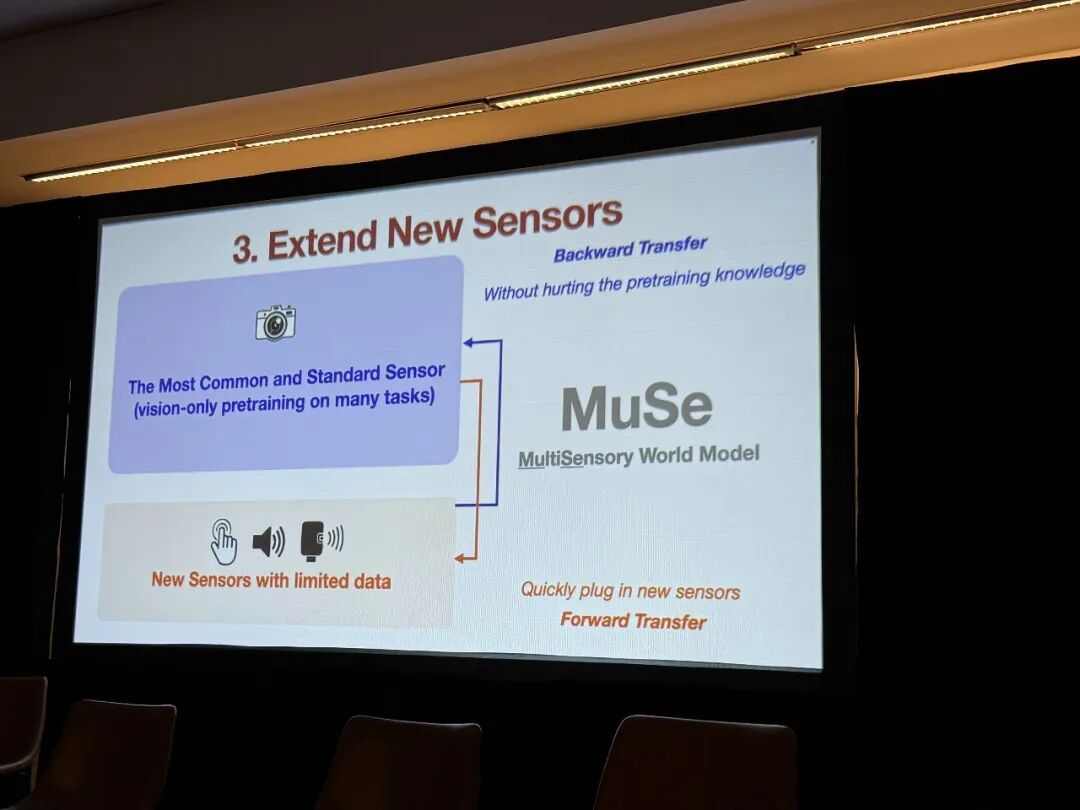
不过,这里有一个很重要的要求:引入新传感器,不能让模型忘记以前学到的东西。
我们把这种能力称为Backward Transfer,也就是反向迁移。它意味着模型在学习新传感器和新任务时,仍然能够保留此前视觉预训练阶段学到的知识,原来能够完成的任务仍然应该表现良好,甚至可以进一步提升。
与此同时,我们还希望模型能够利用新传感器的信息,提升新任务的表现。这对应Forward Transfer,即正向迁移。
所以,MuSe关注的是两个方向:一方面,引入新传感器之后,原有任务不能退步;另一方面,已有的预训练知识还应该帮助模型更快、更好地学习新传感器上的任务。
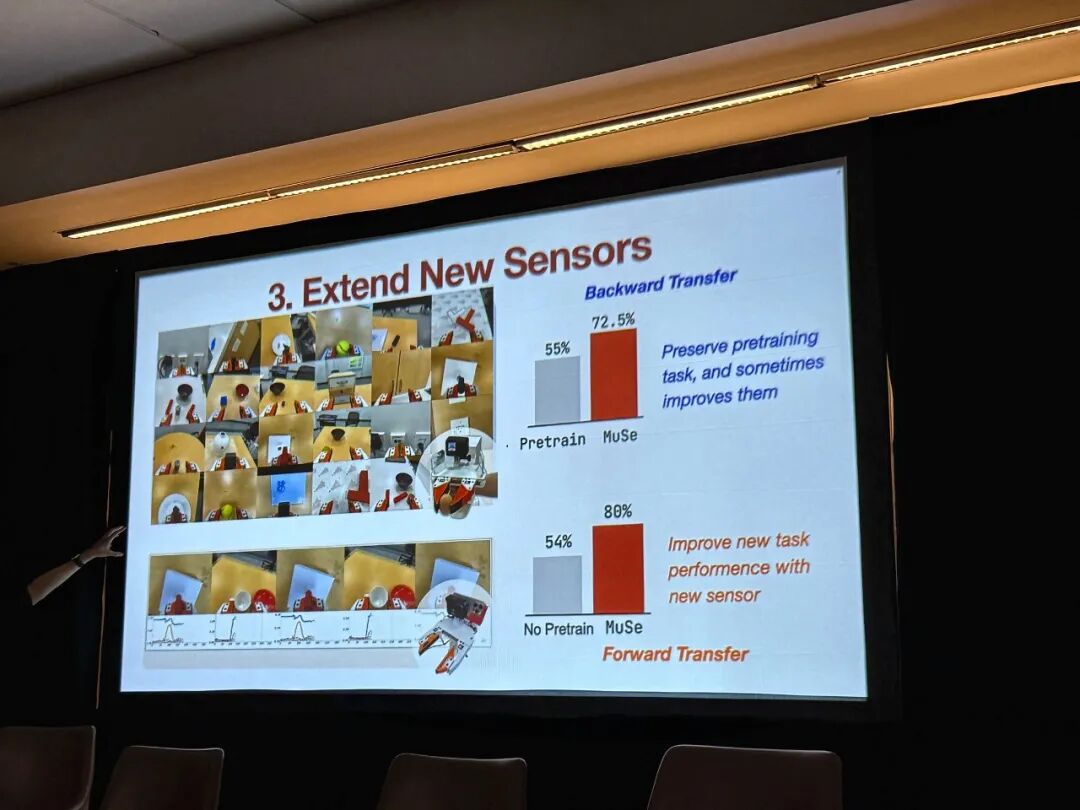
在具体实验中,我们首先使用只有彩色相机的原始UMI数据进行视觉预训练,然后尝试在这个模型中加入额外的力传感器。
我们发现,如果能够正确处理引入新传感器的过程,会出现一个相当有意思的结果:模型不仅能够利用新传感器提高新任务的表现,还能够保留原有视觉预训练任务的性能,有时甚至可以进一步改善原有任务。
这个结果让我感到非常惊喜,也大为振奋。
▎新传感器不仅没有破坏旧能力,还可能改善原有任务
在PPT展示的实验结果中,MuSe在反向迁移和正向迁移两个方向上都取得了提升。
在反向迁移实验中,原有预训练任务的表现从55%提升到72.5%;在正向迁移实验中,新传感器任务的表现从54%提升到80%。
这意味着,模型不仅能够学习如何利用新传感器,还能够在引入新传感器之后保留原有的预训练能力,甚至进一步提升原有任务的表现。
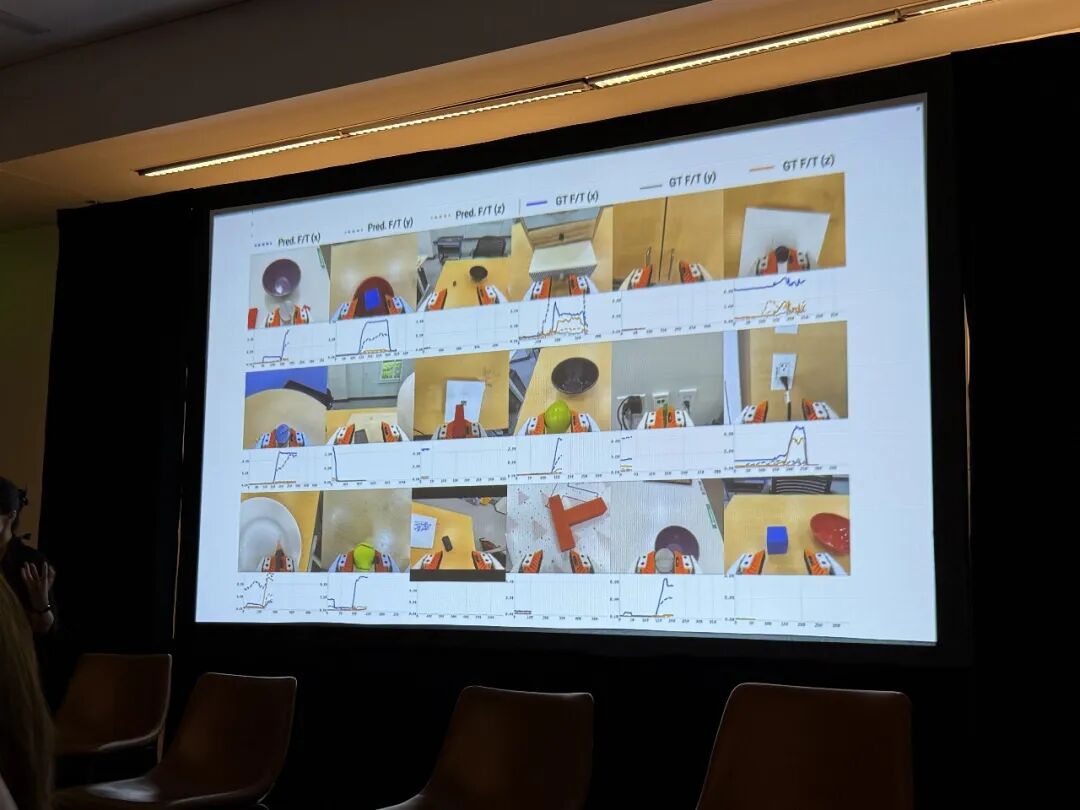
此外,MuSe还有一个很有意思的特点:它本身是一个世界模型,能够预测未来的力传感器信息。
我们进一步让模型在原本没有使用力传感器进行训练的预训练任务上,尝试预测力的信息。结果发现,模型预测出的力信号相当合理,尤其是在接触事件发生的时间和上下文方面,即使具体的力值大小可能还存在一定偏差。
这让我觉得非常有意思:模型原本只通过视觉数据学习任务,却已经能够根据学到的知识,对这些任务中的力觉信息作出一定程度的预测。
这说明,模型能够从原有的视觉信息中学习到一部分与物理交互有关的知识,并将这些知识用于预测力觉信息。
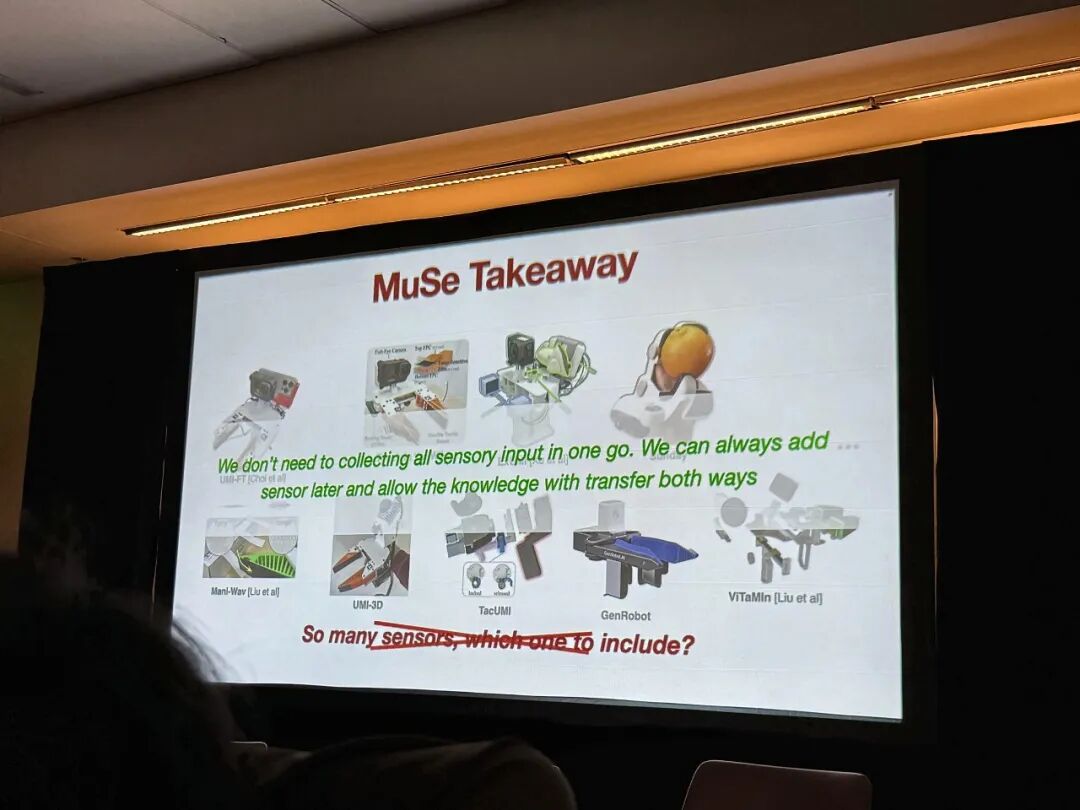
所以,MuSe给我们展示了一条比较有希望的技术路线:不必在最初的数据采集阶段就把所有传感器全部准备好,也可以在模型完成预训练之后,逐步引入新的传感器。
关键是让知识能够在不同传感器之间双向迁移,而不是每增加一种传感器,就重新训练一套完全独立的模型。
06
总结:只有能够重复利用的数据,
才能不断积累
最后,我想总结一下今天最希望大家记住的内容。
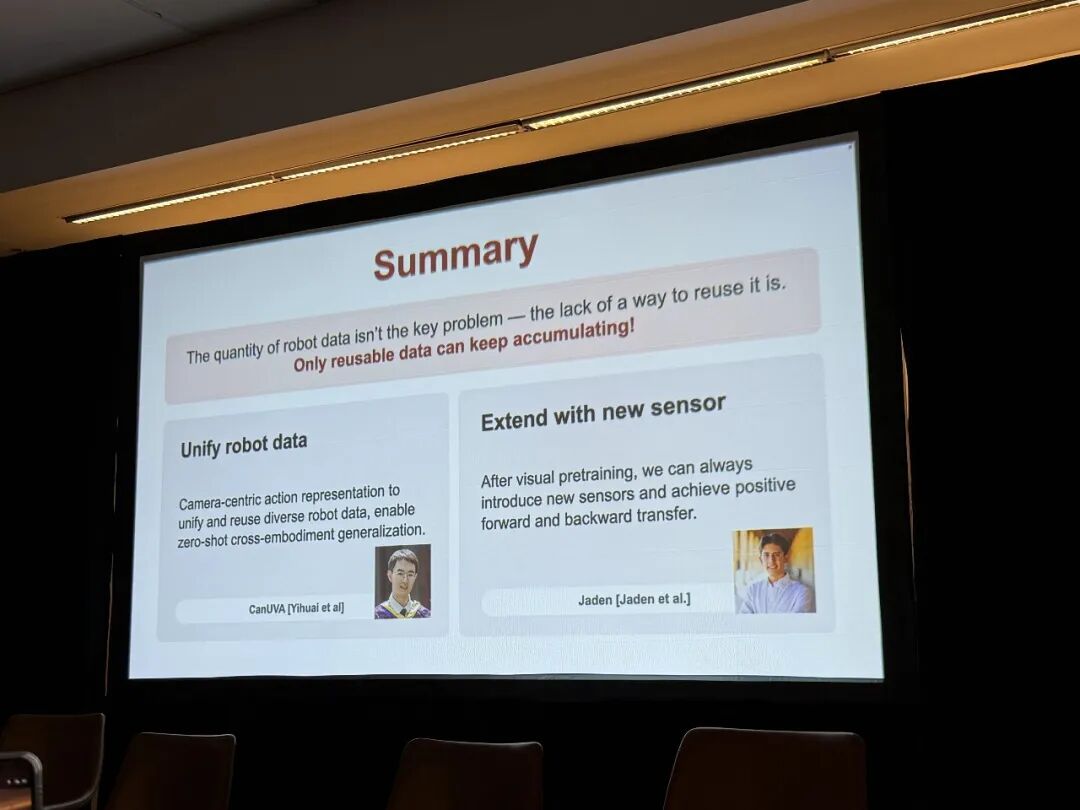
我认为,机器人领域的问题可能并不只是数据数量不足。一个更重要的问题是,我们还没有找到足够好的方法,去重复利用已经积累的训练数据。
只有能够重复利用的数据,才有可能真正积累起来,并持续增长。
如果我们每次开展新任务都需要重新采集数据,无论已经拥有多么庞大的数据集,最终都可能发现数据还是不够用。所以,我们必须找到一种方法,让已有数据能够被更多任务、更多机器人和更多模型重复利用。
围绕这个目标,今天我介绍了两个方向的工作。
第一个方向是统一不同机器人的数据。我们通过相机中心动作表示,将不同机器人原本差异很大的动作空间统一起来,再利用大规模、多样化的开源机器人数据训练一个模型。最终,我们获得了CamUVA,它能够在不同机器人本体之间实现Zero-shot迁移,让同一个模型直接适用于不同的机器人,而不需要针对每台机器人单独进行微调。
第二个方向是扩展新的传感器。通过MuSe,我们证明了模型可以在完成视觉预训练之后,再逐步引入力觉等新的传感器信息。这个过程不仅能够提升新任务的表现,还能够保留原有的预训练知识,实现正向和反向的双向迁移。
这意味着,我们不必在最初采集数据时就确定所有传感器,也不必因为硬件设备不断更新,就一次又一次地重新采集全部数据。
今天介绍的这两项工作,都是围绕同一个问题展开的:如何让已经积累的数据发挥更大的价值。
这两项工作分别由我们团队的两位学生完成。如果大家对具体实现细节,或者项目中发现的其他有意思的现象感兴趣,也欢迎和他们交流。我的分享就到这里,谢谢大家!

文章精选:
1.刚刚,图灵奖得主Hinton发了首篇RSI论文


