 五度妙笔
 企业透视镜
 API商城

 数据库
600B模型,只激活27B,阶跃在赌大模型的未来吗?
9月20日,
阶跃星辰发布了
Step 5 Preview。
官方称,这
是
一款
稀疏
MoE模型
,
总
参数量
600B,激活27B,100万上下文,原生视觉输入。
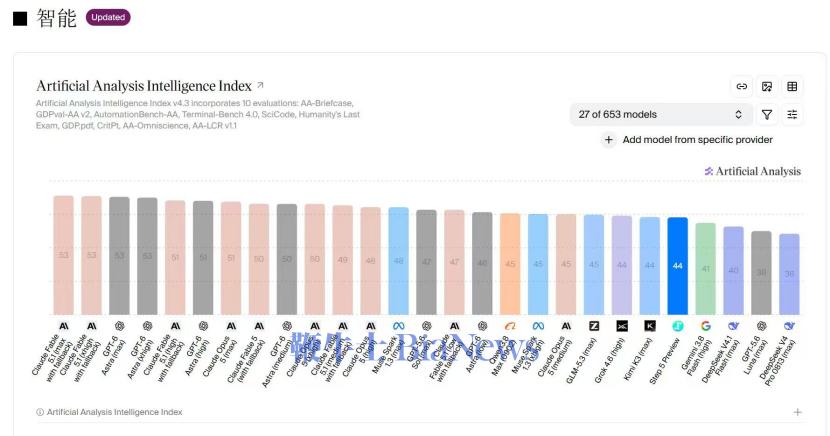
ArtificialAnalysis榜单
称,
Step 5 Preview
综合智能指数
44分,与KimiK3打平。K3总参数量2.8T,激活1040
亿
。
相比之下,
Step 5 Preview
的激活规模低得多
。
但
整体来看,这倒
不是一个
“小模型逆袭”的故事。因为
Step 5 Preview
真正的卖点只有一句话:便宜。
01
领先,但有点偏科
7月发布会上,阶跃星辰端出了StepAOS,一个从零搭建的智能体原生操作系统,同时还有STEPXNeo手机和个人智能体Amoo。
公司董事长
印奇表示,传统操作系统是为
“人操作机器”设计的,智能体在里面只能是访客。StepAOS要把系统功能拆成原子能力,把用户数据统一成语义文件,把记忆召回压到15毫秒以内。
这
就
需要一个能在后台稳定调用工具、维持长上下文、出错重试成本极低的执行引擎。
比起在
GPQA上刷最高分,也不需要生成视觉精美的网页
,
它更需要
的是可靠完成
“打开表格、提取数据、撰写邮件、发送”这类任务。
阶跃星辰对
Step 5 Preview
的定位也印证了这一点:
“
过去,大模型
Scaling的核心逻辑是用更多计算换取更强智能。但随着模型规模和任务复杂度持续增长,计算成本也被同步放大。
Scaling的核心关注开始变成:如何更高效地把计算转化成模型能力。
”
当然,阶跃星辰并没有明确把
Step 5 Preview
的低激活路线和
StepAOS的需求绑在一起。但从战略方向看,两者吻合度很高。
看性能。
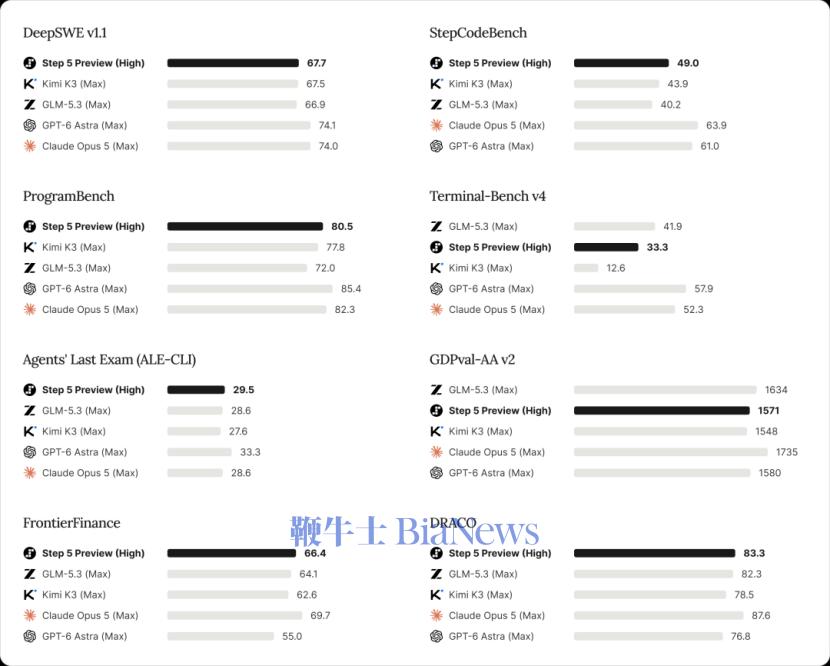
与
KimiK3相比,
Step 5 Preview
在公布的
8项核心评测里全部领先。但领先幅度差很多。Terminal-Benchv4,
Step 5 Preview
是
33.3%,K3只有12.6%,差了20个百分点。这是真正的碾压。DeepSWEv1.1,
Step 5 Preview
是
67.7%,K3是67.5%,基本打平。StepCodeBench,
Step 5 Preview
是
49.0%,K3是43.9%。GDPval-AAv2,
Step 5 Preview
是
1571,K3是1548。
也就是说,
Step 5 Preview
用四分之一的激活参数,在综合指数上追平了
K3
。
它
也
不是在所有维度上都更强,而是在特定维度上拉开差距,在其余维度上打平。
跟
Claude Opus 5
比,
StepCodeBench上,
Step 5 Preview
落后近
15分。Terminal-
Bench v4
上,落后近
19分。GDPval-
AA v2
上,落后
164分。只在ALE-CLI
一项
上以
29.5比28.6微弱反超。
更关键的指标是任务成本。阶跃星辰
称,
Step 5 Preview
输出价格
约
3
美元
/MToken
,
Step 5 Preview
单任务成本是
ClaudeOpus5的八分之一,K3
的五分之一
。
所以阶跃这次更像是
在
K3和ClaudeOpus5之间,切出一个“够用且便宜”的生态位。
为了验证
Step 5 Preview
的真实能力,
我们
给它安排了一个
3D网页游戏开发任务。
经过一个多小时的持续交互,它生成了一个能跑、能操作的
HTML文件。但结果跟官方showcase差距巨大。官方演示里的3D游戏赛道清晰、透视干净、UI信息层级分明;复现出来的版本,
存在严重
的视觉模糊、光晕过载、卡顿
问题,
基本没法正常游玩。
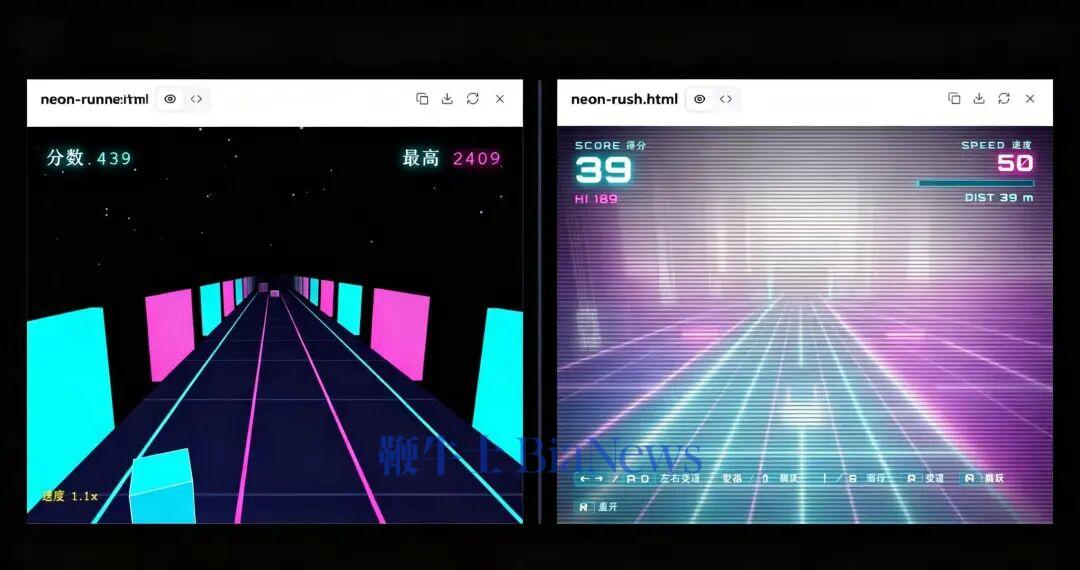
图注:左图为官方showcase截图,右图为按照官方prompt 复现截图
这个结果大概划出了
Step 5 Preview
的
一项能力短板
:逻辑生成和长程迭代可以完成,前端视觉渲染和性能调优
有所不足
。
它确实能连续工作一个多小时不放弃。这一点跟官方宣传的连续运行
22小时优化GPUKernel、3000轮宝可梦的案例一致。
但至少根据它在前端视觉和性能调优上的短板,说明这个模型的能力光谱是明显偏科的。
当然,前端渲染质量跟
“低激活路线”没有必然因果关系。低激活影响的是推理成本和知识容量,前端渲染更多跟训练数据分布和任务优先级有关。
StepAOS需要的不是漂亮的网页,是可靠的Agent执行。
Step 5 Preview
的训练预算大概率被集中在了工具调用、终端操作、错误恢复这些
“干活才需要的能力”上。这
也
解释了为什么它在
Terminal-Bench上能领先K3二十个百分点,却在StepCodeBench上落后Opus5近十五分。
偏科并非坏事,但得承认它偏科。
02
低激活模型真的是未来方向吗?
从产业趋势看,低激活、高效率模型的崛起几乎是必然的。端侧
AI正在从“能跑起来”走向“更好用”。苹果在WWDC2026上发力端侧模型,谷歌
Gemma 412B
也
已经能在笔记本上运行。边缘计算场景要求低延迟、高可靠、本地部署,云端调用的网络延迟满足不了需求,低激活模型是更现实的选择。
Omdia
在
4月
的数据
中称,
自
2021年以来,前沿模型的参数规模年增长率只有约5%。而2019到2021年,这个数字超过100倍。
可见,
堆参数的阶段,基本结束了
,行业重心正在转向小模型和效率优化
。
智谱联合创始人唐杰
8月在X上
也说
:行业曾经集中追逐万亿参数模型,事后看,是整个行业共同经历、又共同折返的一段弯路。模型能力依然在提升,但提升速度正在放缓,单纯扩大规模带来的收益正在下降。
对
于
模型能力的
“提
升
”,行业里大概分成两条路:
一条是
把模型做小
,
总
参数量
压到几十
B以内,目标是端侧和边缘场景。阿里千问、智谱、Meta都走过这条路线,追求“让模型跑在离用户更近的地方”。
第二是
把激活做小。总
参数量
还是很大,但每次推理只调用一小部分参数。
MiniMax M2
.5激活10B,阶跃
Step 5 Preview
激活
27B,都是这条路线,追求“让每次调用都更便宜”。
两条路都在提效,但完全不是一回事。前者解决
“能不能在本地跑”,后者解决“在云端跑长任务划不划算”。
Step 5 Preview
就
属于后者。它的总
参数量
虽远小于
K3,但依旧跟“小模型”没有半点关系。智谱GLM-4.7-Flash总
参数量
30B;阿里千问0.8B、2B、4B,那是端侧。
Step 5 Preview
的总
参数量
是它们的几十倍甚至上百倍。
阶跃
星辰
在这个分工里选了一个位置
:
它不做最大的模型,也不做最聪明的模型。它做的是在可接受成本内能跑完长任务的模型。
但这个生态位的边界,取决于两个变量
,
首先是
Agent任务对推理深度的真实需求
,
如果任务越来越复杂,低激活模型可能不够用。
其次是
端侧算力的增长速度。如果端侧算力快速提升,云端低激活模型的成本优势可能被削弱。
风险同样清晰。如果
StepAOS跑不起来,如果开发者不愿意适配,如果设备厂商不预装,
Step 5 Preview
的
“便宜耐用”就失去了应用场景。
一个操作系统需要的不是
“够用的模型”,是“好用的模型”。
而目前
Step 5 Preview
在实测中暴露的工具调用失败、上下文漂移、前端渲染短板,距离
“好用”还有距离。
Step 5 Preview
并不算完美。但在一个所有人都想做大模型的年份里,阶跃选择用一个低激活、低成本的模型来支撑一个大系统。这个选择本身,就是它找到的生态位。至于这个位置能不能坐稳,
就
看
StepAOS到底能不能
真正
跑起来。
(转载自第四波)


