

百度文心还放出了 Benchmark 评测结果,称新模型在知识、推理、数学、代码、多语言和长上下文等多个基准测试中 取得同尺寸模型SOTA表现 。
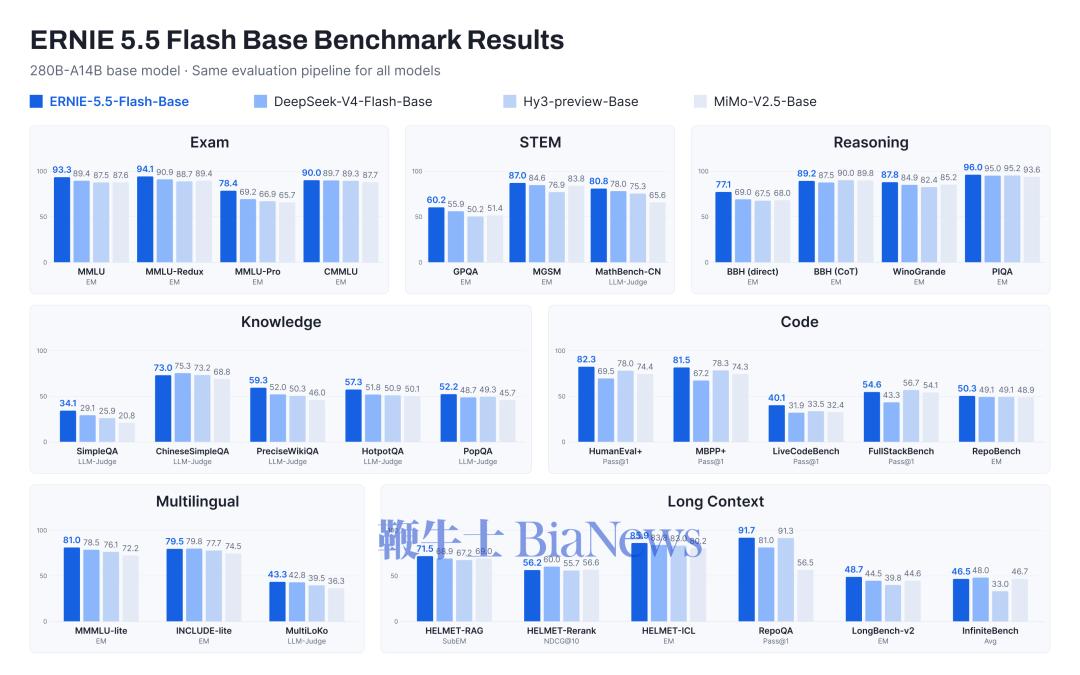
对比模型有DeepSeek V4 flash、Hy3 preview、mimo V2.5, 基本都是其他家上一代模型 ,官方解释称“对比模型选取截至发布时我们能找到的、规模相近的最新开源 Base 模型”。
四个模型均基于各自公开发布的 checkpoint 评测,使用同一套评测框架、相同的 prompt 与 few-shot 样例,自由问答题则使用同一个裁判模型。
如果没记错,这也应该是 百度文心的第一个Flash模型 。
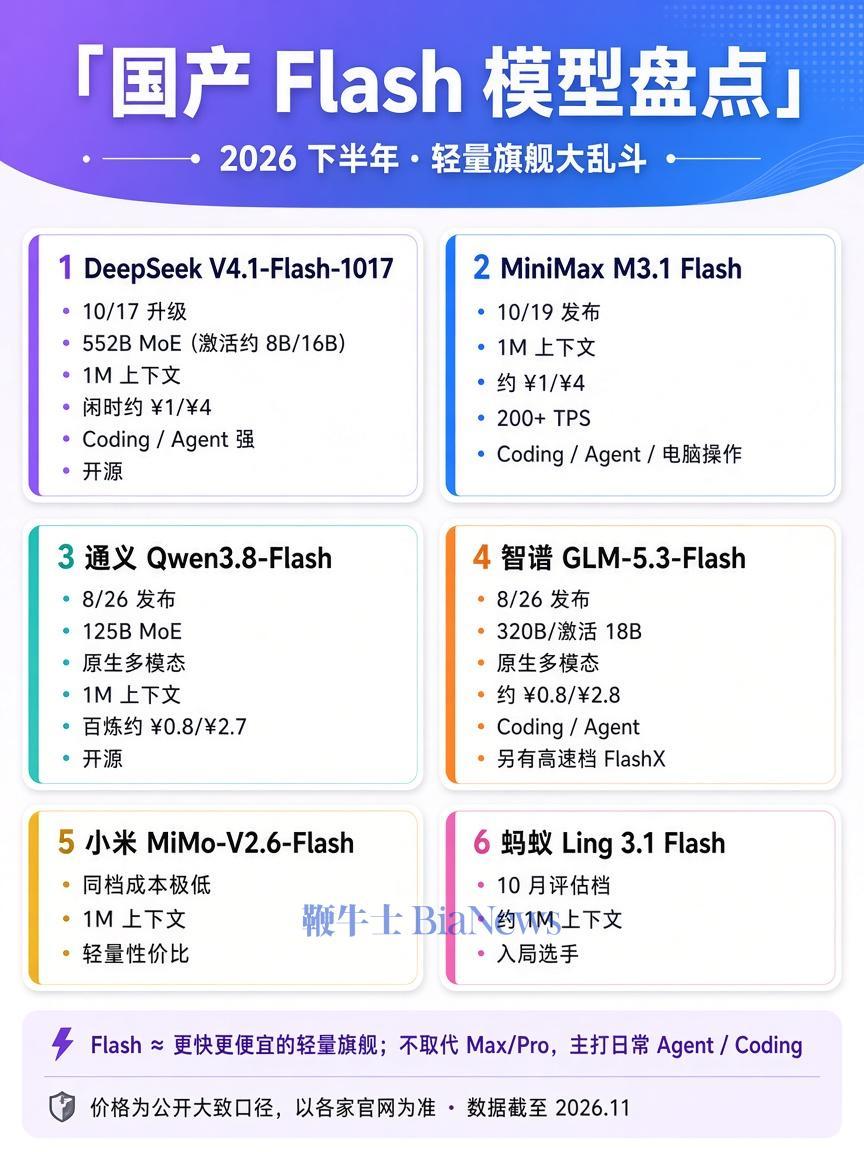
百度文心表示,Base 模型只是起点。经过后训练的 ERNIE 5.5 Flash 将随后推出。
目前,ERNIE-5.5-Flash-Base 已在 Hugging Face 发布,提供 FP8 与 BF16 两种 safetensors 权重。(转载自AI普瑞斯)