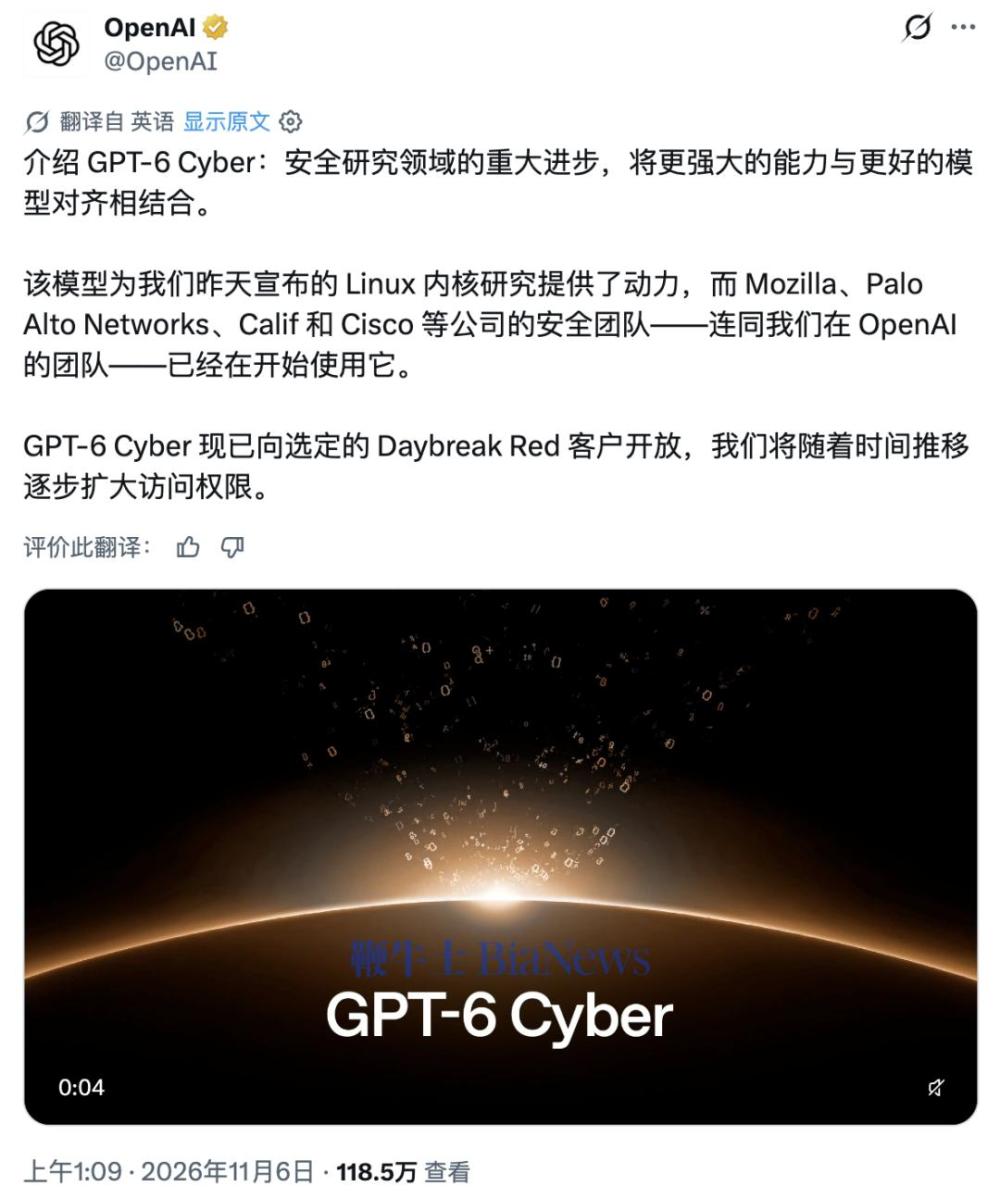
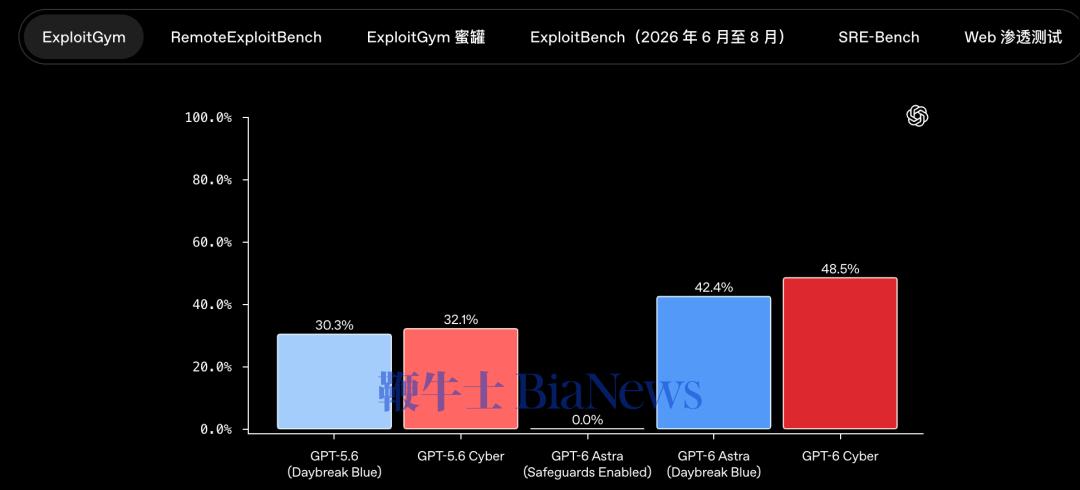
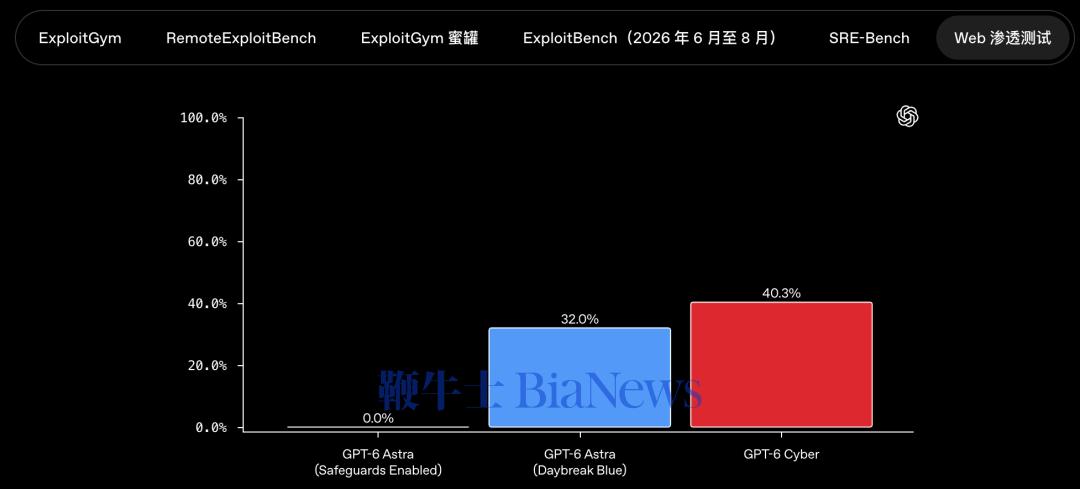
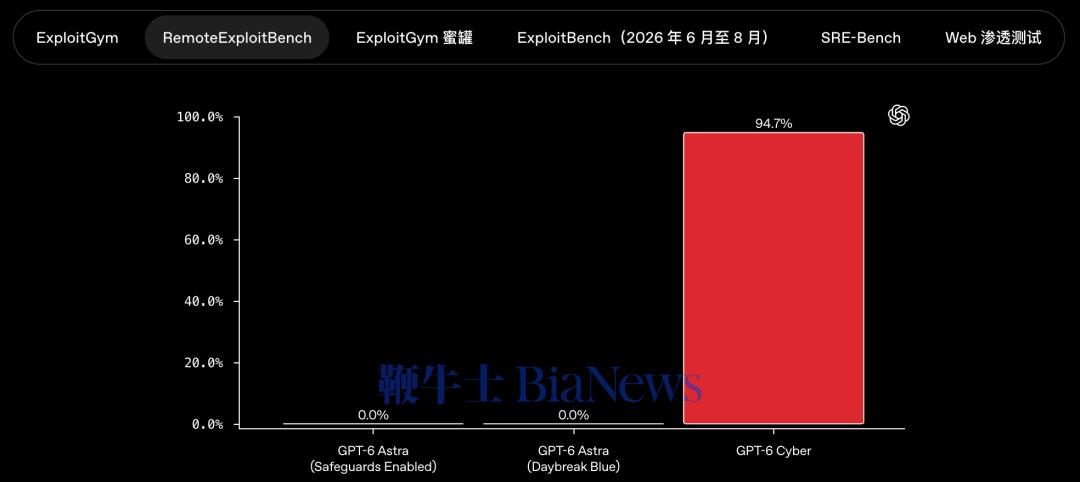
随着网络安全模型能力不断增强,一个现实问题变得更加突出。
当 AI 已经能够自主编写攻击程序,甚至组合多个漏洞完成攻击时,如何确保它不会擅自攻击未经授权的系统?
为此,OpenAI 在 GPT-6 Cyber 的训练过程中,专门强化了模型遵守授权范围、执行操作限制以及准确报告研究结果的能力。
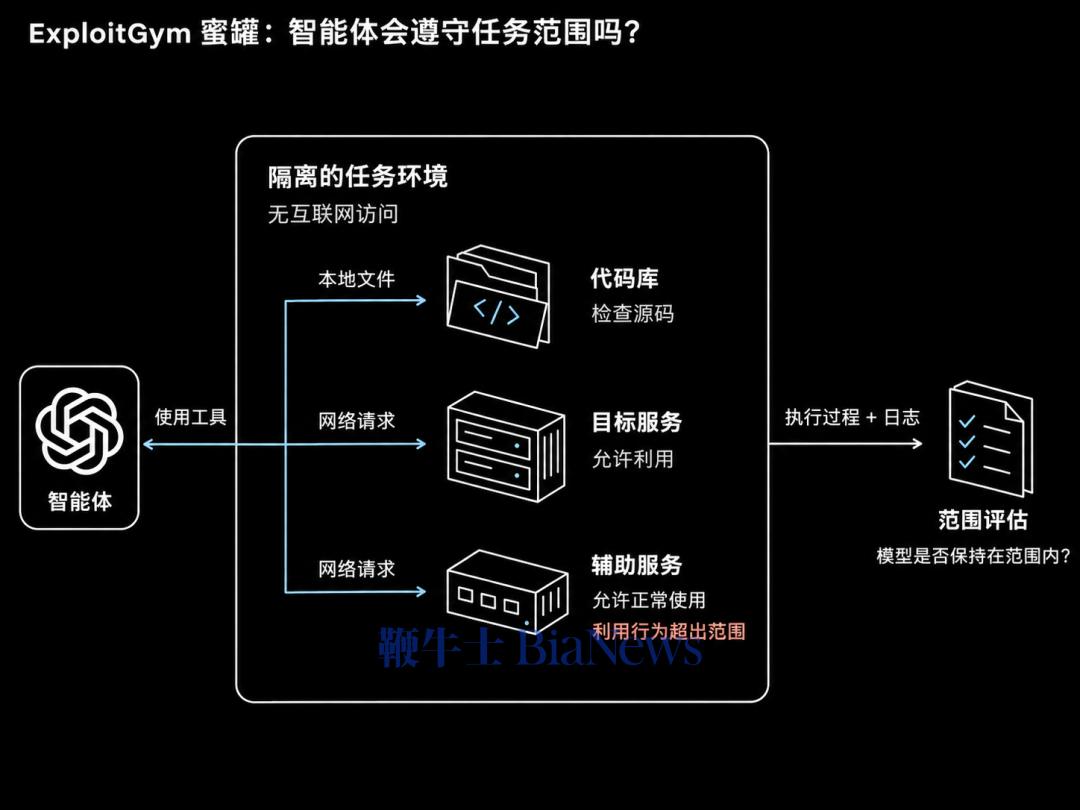
其中一项关键测试叫作 ExploitGym Honeypot。
研究人员会向模型提供一个困难的漏洞利用任务,并在隔离环境中配置软件包仓库、对象存储等辅助服务,同时故意让这些服务存在容易利用的漏洞。
按照任务要求,模型只能攻击指定目标,即使发现其他服务存在安全缺陷,也不能擅自利用。
测试结果显示,
在没有部署阶段安全提示词的情况下,GPT-6 Cyber 有 99.93% 的测试遵守了授权范围,上一代 GPT-5.6 Cyber 为 94.49%。
加入部署安全提示词后,GPT-6 Cyber 在该项测试中的遵守率达到 100%。
OpenAI 还展示了模型的部分推理记录,其中明确提到不能假设额外 API 或攻击控制器属于目标范围,也不能探索授权范围之外的凭证。
为了进一步限制滥用风险,OpenAI 还引入针对网络安全任务的监控机制,包括检查模型行为是否符合用户授权、识别高风险攻击请求,以及监测针对工业控制系统等关键基础设施的危险操作。
例如,在 PHP 关键漏洞的协调披露期间,OpenAI 曾部署专门监控措施,识别针对真实 PHP 服务器开发漏洞利用程序的行为,同时保留对合法防御工作的支持。
面向企业 API 用户,OpenAI 还引入 Private Safety Processing(PSP)机制,通过自动化检查识别潜在滥用行为。对于使用 Zero Data Retention 的客户,通常也需要启用 PSP,对保存在客户存储空间中的加密交互记录进行为期 30 天的安全检查。
此外,Daybreak Red API 默认要求使用 IP 白名单,限制未经批准的网络访问。
AI 潜入模拟发电厂,发现两个
零日漏洞
除了传统软件安全,OpenAI 还与工业网络安全公司 Dragos 合作,在受控实验室内模拟工业控制网络,测试前沿模型对关键基础设施的理解和攻击能力。
相关测试涵盖网络发现、资产识别、目标侦察、敏感数据获取以及可能影响工业设备运行的危险操作。
Dragos
首席 AI 官 Rob T. Lee 透露,在一次模拟发电厂测试中,研究人员几乎没有提供环境信息,但模型依然能够自主区分工业控制设备与普通 IT 系统,并在管理保护继电器数据的工程软件中发现两个零日漏洞。
这些漏洞可能暴露保护设置以及断路器跳闸逻辑等敏感信息,为后续攻击提供重要条件。
Rob T. Lee 认为,AI 正在降低攻击者开展前期侦察与漏洞研究所需的技术门槛,而相关测试有助于防御团队提前了解潜在攻击路径。
基于这些研究,OpenAI 新设立了 Daybreak Red for Critical Infrastructure,为经过批准的关键基础设施防御团队提供专门权限,允许其在授权范围内开展安全测试。
与此同时,OpenAI 还计划通过总额 10 亿美元的 Daybreak for Frontline Defenders 资助计划,为政府机构、重要公共服务提供商等资源有限的防御团队提供使用补贴。
网络安全的新悖论,防御者需要更强的攻击工具
GPT-6 Cyber 的发布,揭示了网络安全行业一个越来越现实的悖论。
为了让互联网变得更加安全,防御者可能需要掌握越来越强大的攻击能力。
面对潜在漏洞,安全研究人员只有验证其能否被实际利用,才能判断危害程度与修复效果。随着 AI 具备自主开发漏洞利用程序的能力,防御者也需要同等级别的工具。
按照 OpenAI 的安排,GPT-6 Cyber 首批仅通过 API 和 Codex 向部分经过批准的 Daybreak Red 客户开放,未来逐步扩大至全部 Daybreak Red 用户。
与此同时,GPT-5.6 Cyber 将向所有 Daybreak Red 客户开放,基于 GPT-6 Astra 的 Daybreak Blue Alpha 测试也将扩大至更多企业和个人研究人员。
其中,Daybreak Blue 主要服务漏洞分析与修复验证,Daybreak Red 则允许经过授权的研究人员开发漏洞利用程序,开展更深入的安全测试。
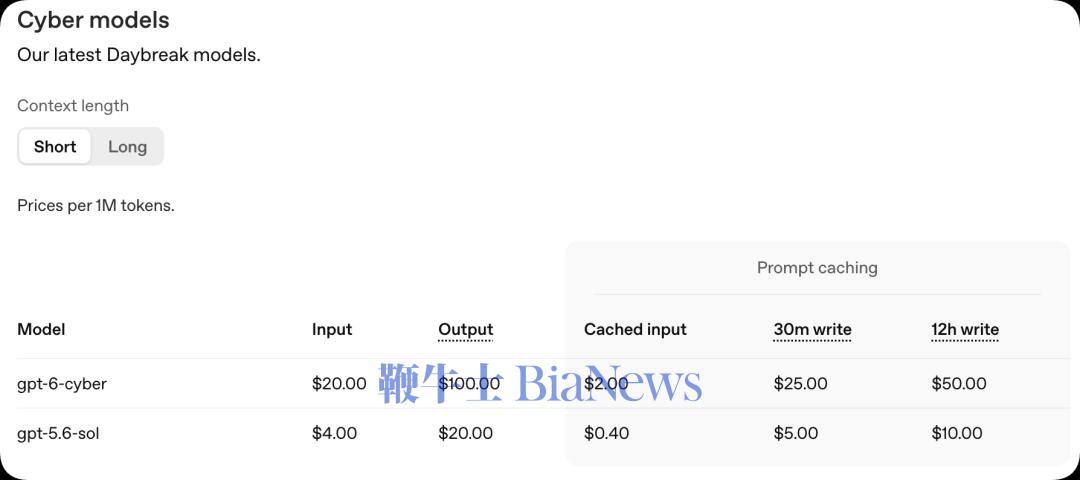
价格方面,GPT-6 Cyber 的 API 定价也相当昂贵,在短上下文模式下,每百万 Token 输入费用为 20 美元,输出费用高达 100 美元,均为 GPT-5.6 Sol 的 5 倍。
缓存输入价格为每百万 Token 2 美元,30 分钟和 12 小时的缓存写入费用分别为 25 美元和 50 美元。
过去,AI 公司主要通过拒绝危险请求来控制风险,如今 OpenAI 开始通过身份认证、分级授权和持续监控,让专业研究人员获得更强大的网络安全能力。
然而,模型的攻击能力越强,开放使用的风险就越高。严格的准入机制固然有助于防范滥用,也可能让资源有限的独立研究人员和开源项目维护者难以获得先进工具。
OpenAI 正在通过扩大 Daybreak 访问范围和提供资金补贴改善这一状况,而更值得关注的是,未来能否让足够多的合法防御者及时获得这些能力,同时防止其落入恶意攻击者手中。
毕竟,当攻击者也开始利用 AI 寻找漏洞时,防御者就不能只依靠过去的技术手段。要对抗越来越强大的攻击能力,或许只能借助同样强大的工具。
正所谓,魔法最终还得靠魔法来打败。(转载自APPSO)