
 五度妙笔
 企业透视镜
 API商城

 数据库
从OCP 2026,看AI光网络有哪些新进展和关注点?
2026年10月12日至15日,2026年Open Compute Project(OCP)Global Summit在美国圣何塞举行。今年大会主题是“Scaling Innovation for the AI Era”,议程覆盖AI集群、网络、光子技术、开放计算平台、存储、供电和冷却等22个技术方向。与光通信直接相关的报告集中在Networking、Photonics、AI Clusters及配套工作。[1][2]
从公开议程与会后资料看,大型AI集群对网络提出的要求正在进入更具体的工程层面。GPU之间怎样交换数据,光路怎样建立和调整,高速光模块发生故障后怎样定位,以及多个数据中心怎样参与同一项计算任务,都已经出现针对性的开放规范或工程讨论。
本文章沿着AI Scale-Up网络、OCS光电路交换、高速光互联、Scale-Across和开放管理平台,梳理本届大会与光网络行业关系较大的进展。
一、OCP 2026:为什么值得光通信行业关注?
Open Compute Project由大型互联网企业与产业伙伴推动,长期围绕开放硬件、接口与数据中心基础设施开展协作。随着AI计算逐步向高密度机架和多站点集群发展,OCP的关注范围已经延伸到交换网络、互联协议、机架供电、冷却、固件和跨系统管理。
今年大会的一个特点,是同一个技术问题往往会出现在几个不同专题中。例如高速光互联在Photonics轨道讨论器件位置、外置激光源和系统可靠性,在Networking轨道讨论交换平台和遥测,在AI Clusters轨道则讨论Scale-Up和Scale-Out网络如何配合计算任务。[1][2]
Meta、Google、Microsoft、NVIDIA、Oracle、Broadcom、Arista和多家光器件公司都带来了相关报告。大型云厂商关注如何将设备部署到生产网络,芯片与模块企业关注接口实现,开放社区则试图把共同需求写成可实现和可验证的规范。
这种会议组织方式对光通信行业具有参考价值。高速光模块的性能仍然重要,但模块所在的交换系统、端点协议、故障恢复和机架运行环境,开始共同影响AI任务的实际效率。
二、AI Scale-Up网络开始有了更具体的开放规范
Scale-Up通常指同一计算系统或紧密耦合计算域内的加速器互联。数据交换往往具有短消息密集、低时延和同步要求高等特征。以太网生态希望进入这一领域,需要对报文效率、流量控制和可靠交付作出更明确的定义。
2026年2月生效的OCP ESUN 1.0《Network Operator Requirements》由Meta和Microsoft牵头。规范面向Scale-Up交换网络,讨论紧凑报文头、无损多跳拓扑及链路级可靠性。其中ESUN Header将相关场景常用的IP/UDP头部组织成更紧凑的4字节格式,并结合PFC、基于Credit的流控和链路层重传机制控制拥塞与丢包。[3]
另一份规范SUE-T 1.0.0在10月8日生效,作者来自Broadcom和Arista。SUE-T关注加速器端点的数据交付,定义在以太网承载上运输内存访问事务的框架,包括命令和响应的映射、队列调度、ACK语义、可靠传输及与XPU接口的关系。规范提供Delivery ACK与Operational ACK两种方式,以适应不同的端点实现。[4]
把两份规范放在一起看,ESUN主要给出网络侧的能力与约束,SUE-T则进一步明确端点如何发出和接收事务。它们共同涉及网络流量控制和传输可靠性,但作用位置与规范范围各有侧重。两份文件已经发布;多厂商芯片、交换机和加速器的完整互通程度仍要结合后续实现与测试。
Meta在本届大会介绍了Tahan——面向其MTIA 300加速器的以太网Scale-Up交换平台。Tahan采用51.2Tbps交换芯片,四台交换设备连接16个加速器,现阶段重用基于IPv6、PFC和RoCE的无损传输体系。Meta还展示了面向更高密度机架的下一代方案,并表示未来版本计划采用ESUN数据平面。[5]
因此,目前可以区分两类进展:Tahan体现了Meta已有的工程实现,ESUN和SUE-T提供了开放规范的发展基础。未来Scale-Up以太网能覆盖多大计算域,还取决于交换时延、端点能力、拥塞处理和跨厂商验证。
尤其需要注意端点事务与普通以太网数据报文之间的区别。一次加速器内存访问可能包含请求、确认和返回数据,吞吐量之外还要控制每次事务的排队与完成时间。SUE-T把相关命令映射、缓存和可靠性交给明确的传输功能处理,为芯片、交换机和网络软件围绕同一种事务语义展开互操作验证提供依据。[4]
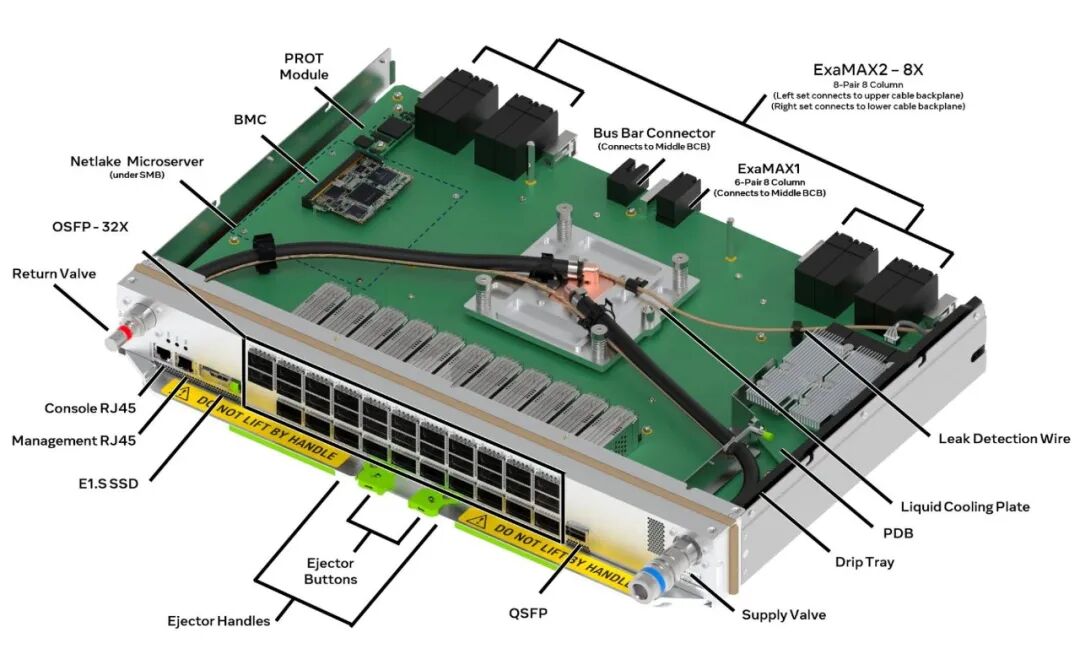
【图1】Meta Tahan以太网Scale-Up交换设备照片。Meta Engineering,2026-10-12官方照片
三、OCS从技术方案走向接口与多厂商互通
光电路交换(Optical Circuit Switching,OCS)在光域建立端口之间的连接,能够为指定端点提供透明光路。OCP在2026年4月发布的OCS白皮书,系统比较了机械式、MEMS、液晶、硅光及混合实现路线,讨论了端口规模、重配置时间、插入损耗、成本与可靠性等取舍。[6]
OCS的工程价值与它的工作机制直接相关。已经建立的光路可以绕开中间的分组缓存和逐包转发处理,有利于减少部分电交换环节的功耗。与此同时,OCS自身不执行逐包排队、QoS分类和拥塞管理。它更适合与分组交换系统、控制器和业务调度配合使用。[6]
OCP白皮书回顾了Google Jupiter使用OCS进行网络扩展,以及TPU集群利用可重配置光连接适配计算任务的经验。对AI网络而言,光路的重新组合可以服务于故障绕行、计算域划分或相对稳定的大流量连接;切换速度、端口数和链路损耗会影响不同实现的适用范围。
本届大会进一步把讨论推进到控制接口。Google报告《Standardizing OCS Interfaces for Seamless Integration》,iPronics与KDDI报告多厂商OCS的AI集群应用场景,Lumentum与Oracle则以《Zero-Touch OCS Fabrics》讨论大规模部署的自动化方向。这些演讲说明多厂商接入、控制和可观测性已成为重要议题;具体互通结果仍以相应演讲中的实际测试证据为准。[1]
OCP OCS子项目已明确将软硬件接口、SDN集成、遥测监控及互通验证纳入工作范围。其重点是数据中心与AI集群,和运营商面向长途WDM业务的ROADM/OXC在网络位置、交换粒度及控制要求上存在差别。[7]
对于光通信行业,值得持续观察的是OCS如何与电交换结合、控制器如何描述端口和光路状态,以及不同器件路线能否建立共同的管理与测试接口。
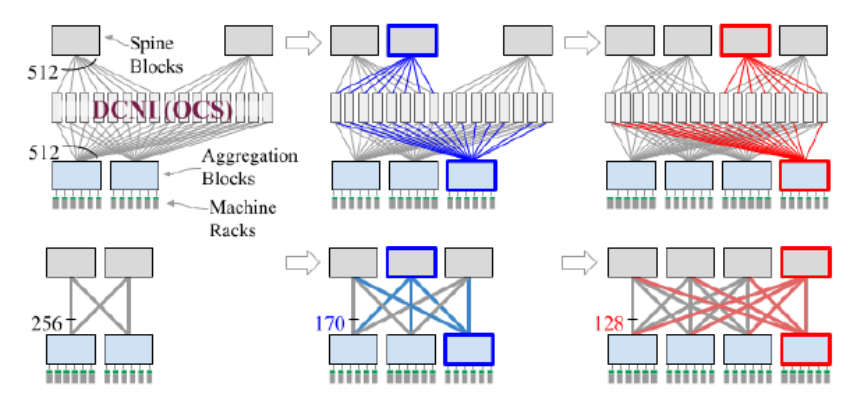
【图2】Google Jupiter网络中的OCS光交换层。OCP OCS White Paper(2026年4月),PDF第15页,Figure 2;原图引自Google Jupiter Evolving研究
四、CPO、NPO与高速光模块进入系统级设计
随着交换容量和端口密度提高,高速电连接的长度、功耗、信号完整性及维护方式成为系统设计的重要约束。可插拔光模块、近封装光学(NPO)和共封装光学(CPO)把光学器件放在不同的位置,相应的供光、散热、测试和维修条件也会改变。
OCP 2026 Photonics专题中,Meta安排了从51.2T CPO验证走向102.4T集成光学交换系统的报告;Microsoft讨论光学Scale-Up架构、标准与韧性,以及与Arista联合进行XPO系统级评估;华为介绍开放NPO标准生态。大会配套的IPEC工作坊还讨论了NPO插座、外置激光源和光互联标准化。[1]
这些议题让系统可靠性成为与光电指标同样重要的研究内容。光引擎越靠近高功耗芯片,热环境和可维护性就越需要提前考虑。外置激光源可以改变供光与维护的功能边界,同时引入新的光纤连接、冗余和故障定位要求。不同方案仍在按照具体端口密度和系统成本进行验证。
10月8日发布的OCP《Enhanced Telemetry Optics Product Software Specification V1.0.0》提供了更具体的标准进展。该规范面向400G、800G及1.6T光模块,基于OIF CMIS体系扩展统一的遥测与管理方法。它规定链路健康度指标、事件日志、时间信息、远端模块访问和相关故障处理接口。[8]
这份规范把模块本地统计与系统诊断联系起来:运维软件能够分别查看主机电接口与线路光接口的质量信息,结合Pre-FEC BER、FEC错误统计、SNR、温度和链路状态,定位性能下降发生在哪个环节。非易失性事件记录还可以保留链路异常发生前后的信息。[8]
对于大规模AI网络,链路处于Up状态只是最基本的检查。网络还需要识别性能持续变差的端口、远端设备状态和短时间故障。OCP这份规范为不同光模块建立共同的数据接口,后续效果仍需通过设备实现、测试和实际运维数据验证。
规范还涉及远端CMIS访问、链路健康评分和按时间记录的事件日志。其直接用途是在故障发生后还原信号质量的变化过程,并把服务器侧光模块的信息带回交换设备管理系统。对大量使用可插拔模块的AI集群,统一数据格式可以减少不同模块需要分别适配采集软件的工作量。[8]

【图3】端到端光模块遥测及链路分段监测。OCP Enhanced Telemetry Optics Specification V1.0.0,PDF第11页,Figure 1
五、Scale-Across让数据中心间网络变得更加重要
当AI训练任务分布在多栋机房、多个园区时,集群之间的连接开始直接影响计算效率。跨站点网络除了容量,还要处理距离增加造成的往返时延、缓存需求、拥塞反馈,以及不同网络平面发生故障后的任务恢复。
Meta在大会期间介绍了Backend Aggregation(BAG)网络,将不同楼宇和园区的AI后端网络连接起来。其工程文章指出,链路延伸到数十公里之后,缓冲区预留与实际线缆距离密切相关。Meta利用测量的往返信息估算链路长度,结合eBGP链路带宽信息实施流量分配,并通过训练任务调度减少不必要的跨站点集合通信。[5]
这组实践说明,Scale-Across会同时改变传输网络和计算系统的运行方式。网络侧需要知道链路的容量和距离,训练侧需要理解哪些通信应留在本地完成。随着距离增大,集合通信对同步等待的敏感度也更突出。Meta提到的跨数百乃至数千公里训练仍属于后续演进方向,应与已公开部署的BAG架构分开理解。

【图4】Meta Backend Aggregation(BAG)结构图。Meta Engineering官方架构图,2026-10-12
Google则在OCP报告中介绍Virgo Network与“Campus-as-a-Computer”。根据Google于2026年4月公布的工程文章,Virgo主要是面向加速器的Scale-Out网络,采用扁平的两层、多平面架构;Jupiter前端网络承担计算、存储访问,并可用于跨站点扩展。[9]
Google还将故障隔离、亚毫秒级遥测和慢节点检测纳入网络设计。它反映出一个重要变化:AI网络的性能指标正在从端口吞吐量进一步延伸到训练过程中能够有效完成的通信工作量,以及故障发生时整体任务受到的影响。
大会有关Scale-Across的讨论还覆盖路由器与传送设备的功能分工。Meta、Microsoft、Broadcom、Google参与了网络设备影响的专题讨论,Ciena介绍从单数据中心到多区域AI集群的互联议题。[1] 对光传输行业来说,相干接口、DWDM线路系统及IP层流量工程将面对更紧密的协同要求。
六、开放网络正在延伸到设备管理与基础设施
开放网络的软件栈过去更多集中在交换芯片适配、转发表管理与网络操作系统。今年OCP还把平台硬件接口、光传送设备和机架环境纳入讨论。
阿里巴巴在Networking专题安排了《SONiC for OTN: Expanding SONiC and OCP SAI into Optical Transport Network》。这是一个值得跟踪的技术议题:如果希望用开放软件管理光传送设备,相关接口就需要描述线路端口、传送交叉、告警与性能监测等对象。当前公开资料能够确认大会开展了这一研究报告,后续是否形成可复用规范仍需结合项目代码和接口文件核验。[1]
另一项新工作是Open Switch Platform Architecture(OSPA)。OCP在10月公布,Meta、Microsoft和阿里巴巴推动制定交换设备平台层的共同参考架构,涉及电源、硬件清单、环境与温控、固件维护、调试及安全。其Revision 1.0.0 Candidate目前仍在基金会审查程序中。[10]
OSPA关注的是交换设备内部的公共平台管理接口。SAI让网络软件能够面向不同交换芯片使用共同抽象,OSPA尝试进一步减少不同硬件平台在上电、传感器、固件升级和维护接口上的重复适配。

【图5】Meta IcePack液冷网络机架照片。Meta Engineering官方照片,2026-10-12
硬件侧,Meta介绍了IcePack液冷网络机架和IceCube 102.4Tbps交换刀片,单刀片提供128×800G交换能力,运行FBOSS并使用OCP SAI适配硬件。机架供电、液冷、交换芯片和网络软件在同一个平台中协同设计,表明AI网络已经进入机架级系统工程阶段。[5]
结语
OCP 2026展现了几条相互衔接的技术路线。Scale-Up以太网开始有可引用的网络侧与端点规范,OCS继续推进控制接口和多厂商互通,高速光模块的标准工作进入遥测与可靠性,Scale-Across把链路距离和任务调度纳入同一工程问题,开放网络软件则向设备管理与机架系统扩展。
参考资料与原始文献
[1] OCP Foundation|2026 OCP Global Summit — Recorded Content
[2] OCP Foundation|Explore 22 Tracks at the 2026 OCP Global Summit
[3] OCP Networking / Meta / Microsoft|OCP ESUN — Network Operator Requirements — Base Specification 1.0(2026-02)
[4] OCP / Broadcom / Arista|SUE-T: Base Specification v1.0.0(2026-10-08)
[5] Meta Engineering|OCP Summit 2026: Powering AI with Open Innovations in Scale-Up, Scale-Out, and Scale-Across Networks
[6] OCP Networking / OCS Subproject|Optical Circuit Switching for AI and Hyperscale Data Centers: Benefits, Technologies, Current and Future Deployments(2026-04)
[7] OCP Networking|Optical Circuit Switching(OCS)子项目官方页面及工作范围
[8] OCP Optics Reliability Workstream|Enhanced Telemetry Optics Product Software Specification V1.0.0(2026-10-08)
[9] Google Cloud|Introducing Virgo Network, Google’s Scale-Out AI Data Center Fabric(2026-04-22)
[10] OCP Foundation|Introducing OSPA: Unifying the Switch Platform Layer for Open Networking(2026-10)


