从首次登顶到连续领跑,中国超级计算机正在展现新的技术实力。
当地时间11月16日,在美国芝加哥举行的SC26国际超级计算大会期间,新一期全球超级计算机TOP500榜单正式公布。
中国国家超级计算深圳中心的“灵晟”(LineShine)E级超级计算机,以2.1984 EFlop/s的实测性能继续位居全球第一,成功蝉联TOP500榜首。同时,该系统还以22.00 PFlop/s的成绩位列HPCG榜单第一,成为本期全球超算领域备受关注的焦点。
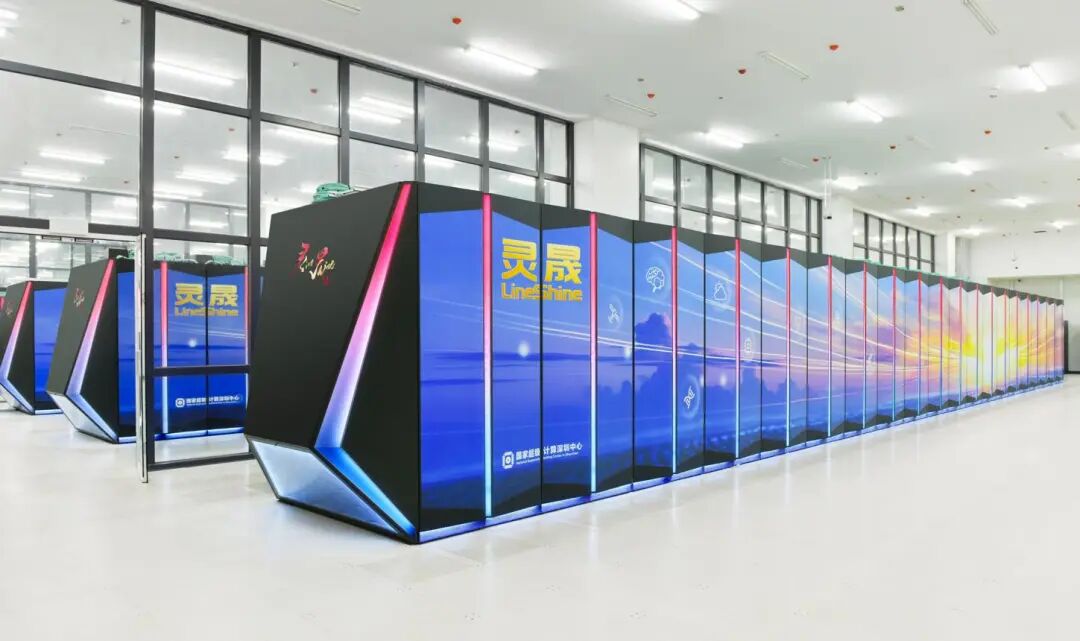
这意味着,继今年6月首次登顶之后,中国超算再次在全球最具影响力的超级计算机排名中保持领先。
值得关注的是,“灵晟”的意义不仅在于计算速度,更在于其背后所采用的自主计算架构、超大规模并行处理能力,以及面向科学研究和产业应用的系统支撑能力。
01 2.1984 EFlop/s!中国超算继续领跑全球
TOP500是全球超级计算机领域最具影响力的权威排名之一,每年通常在6月和11月更新,主要依据高性能Linpack(HPL)基准测试结果,对全球超级计算机的实测性能进行排名。
在2026年11月公布的最新榜单中,“灵晟”以2.1984 EFlop/s的HPL实测性能继续位居第一。
EFlop/s即每秒百亿亿次浮点运算(10¹⁸次/秒)。2.1984 EFlop/s意味着,“灵晟”在规定的双精度Linpack测试中,能够达到每秒约219.84亿亿次浮点运算的性能水平。
从排名来看,全球前五名分别为:
从数据可以看出,“灵晟”的实测性能领先第二名美国El Capitan约21.5%,也是本期TOP500榜单中性能最高的超级计算机。
除了TOP500排名,“灵晟”在另一项重要测试中同样表现突出。
在HPCG(High Performance Conjugate Gradients,高性能共轭梯度)测试中,“灵晟”以22.00 PFlop/s位居全球第一。
与主要考察密集型矩阵计算能力的HPL不同,HPCG更加关注内存访问、通信和复杂稀疏计算等能力,能够从另一个角度反映超级计算机在实际科学计算中的综合表现。
因此,同时在TOP500和HPCG两项榜单中位列第一,也让“灵晟”的技术实力有了更加全面的体现。
02 千万核级规模:自主CPU架构构建超强计算能力
“灵晟”能够取得这样的成绩,背后是一套大规模并行计算系统的支撑。
根据TOP500公布的技术资料,该系统采用自主设计的“灵鲲”(LingKun)计算平台,搭载LX2处理器,通过自主高速互连网络“灵脉”(LingQi)实现大规模计算节点之间的数据交换,并运行麒麟操作系统。
其主要技术参数包括:
处理器架构: LX2处理器,单颗304核;
处理器主频: 1.55 GHz;
总核心数量: 13,789,440个;
HPL实测性能: 2.1984 EFlop/s;
理论峰值性能: 2.73582 EFlop/s;
系统功耗: 42.22 MW;
高速互连: 自主灵脉(LingQi)互连网络;
操作系统: 麒麟操作系统。
从技术架构来看,“灵晟”最值得关注的特点之一,是采用了全CPU计算架构。
与当前许多依赖GPU等专用加速器构建超大规模计算系统的超级计算机不同,“灵晟”通过大规模CPU核心并行计算实现了超过2 EFlop/s的双精度实测性能。
这也是它在2026年6月首次登顶时引起国际计算领域广泛关注的重要原因之一。
更重要的是,超级计算机并不是简单地把大量处理器连接起来就能获得理想性能。
当计算规模达到千万核心级别时,系统需要同时解决计算任务分配、节点间高速通信、内存访问、数据存储以及软硬件协同调度等复杂问题。
其中,互连网络尤其关键。
在大规模并行计算过程中,不同计算节点需要频繁交换数据。如果节点之间的数据传输速度跟不上计算速度,就可能出现大量处理器等待数据的情况,进而影响整个系统的运行效率。
因此,自主处理器、自主互连网络、系统软件和计算调度能力的协同优化,是“灵晟”实现高性能计算的重要技术基础。
据央视新闻报道,“灵晟”采用在线加速(Online Acceleration)全CPU超智融合架构,实现从芯片、网络、存储到系统软件的全栈自主可控。
这意味着,其技术突破并不局限于某一款处理器,而是涉及整个超级计算系统的协同设计与优化。
03 从超级计算到科学研究:国产E级算力开始支撑重大科研应用
超级计算机的价值,最终需要通过实际应用体现。
此次“灵晟”蝉联全球第一,另一个值得关注的信息是其应用能力。
据央视新闻报道,截至目前,“灵晟”已经支撑22项千万核级全机规模应用,并适配220余款领域应用。
这表明,系统不仅能够在基准测试中取得优异成绩,也已经具备支撑大规模科学计算任务的能力。
例如,在材料科学、能源研究、生命科学、气候模拟和基础物理等领域,科研人员往往需要处理规模庞大的数据,并通过复杂的数学模型模拟真实世界中的物理过程。
这些任务通常需要大量计算资源。
以材料科学为例,研究人员可以利用超级计算机模拟原子、分子之间的相互作用,分析材料的电子结构、能量状态和物理性质,从而帮助探索新型材料。
值得一提的是,基于“灵晟”开展的XLSDFT科研应用成果,已经入围2026年ACM戈登贝尔奖。
戈登贝尔奖被誉为高性能计算领域的最高荣誉之一,重点关注利用超级计算技术解决重大科学和工程问题的创新成果。
这一进展说明,国产E级超级计算机正在从计算性能突破,进一步走向重大科学研究应用。
04 超级计算与人工智能:下一代算力基础设施正在融合
近年来,人工智能快速发展,使全球计算基础设施的竞争进入新的阶段。
大模型训练、科学智能、复杂物理仿真和多模态数据处理,都需要强大的计算能力作为支撑。
但超级计算与人工智能计算并不完全相同。
传统高性能计算更加重视双精度浮点运算、科学模拟和复杂数值计算;而大模型训练通常大量采用低精度计算,并依赖GPU等专用加速器提供高吞吐量。
因此,不能简单地将TOP500排名第一等同于AI训练性能全球第一。
“灵晟”的价值在于,它展示了全CPU架构在超大规模双精度科学计算领域仍然具有强大的竞争力,也为国产计算系统的自主设计、软硬件协同和大规模应用积累了重要经验。
随着科学计算与人工智能进一步融合,超级计算机未来有望在AI辅助科研、复杂系统模拟、数字孪生和工业智能优化等领域发挥更加重要的作用。
结语:
从今年6月首次登顶,到11月继续蝉联全球TOP500第一,中国超级计算机“灵晟”再次展示了国产高性能计算系统的综合实力。
2.1984 EFlop/s的实测性能、超过1378万个计算核心、全CPU计算架构,以及自主处理器、互连网络和系统软件的协同设计,共同构成了这一成绩背后的技术基础。
更值得关注的是,超级计算机的竞争已经不再只是单纯比拼峰值算力。
从芯片、网络、存储到系统软件,从计算性能到实际科研应用,从传统高性能计算到人工智能与科学计算融合,真正决定超级计算机产业竞争力的,是整个计算生态的综合能力。
对于中国科技产业而言,“灵晟”蝉联全球第一,不仅是一项值得关注的计算性能纪录,也展现了国产高端计算系统在自主研发和重大科研应用方面持续向前发展的能力。
免责声明:本文版权归原作者所有。本文所用视频、图片、文字如涉及作品版权问题,请第一时间告知,我们将根据您提供的证明材料确认版权并按国家标准支付稿酬或立即删除内容!本文内容为原作者观点,并不代表本公众号赞同其观点和对其真实性负责。

为您发布产品,请点击“阅读原文”