五度妙笔
 企业透视镜
 API商城

 数据库
AI 的万亿账本:钱往哪里流、机会在哪一行?
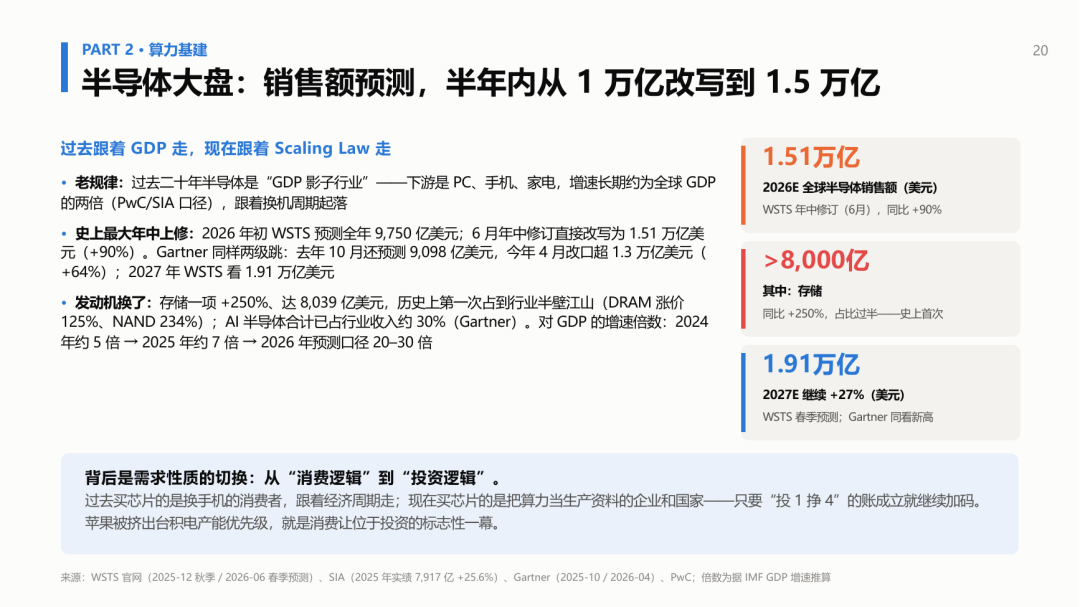
2026 年 6 月,行业权威机构 WSTS 把当年全球半导体销售额预测从年初的 9,750 亿美元,直接改写为 1.51 万亿美元——一次上修 5,300 多亿美元,同比增速 90%,是这个行业有统计以来最大的一次年中修订。要知道,就在 AI 浪潮起来之前,全行业还普遍认为"2030 年做到 1 万亿"是天方夜谭。
预测机构集体"失准",不是因为不专业,而是因为行业底层的定价逻辑换了轨。本文试图把这本账完整算一遍,回答五个问题:①AI 这轮革命到底特殊在哪?②Agent 为什么是需求爆发的引擎?③一年 3 万亿美元的资本开支,账能不能算平?④钱沿着产业链怎么传导,最终落进谁的口袋?⑤对创业者和普通人,位置在哪一行?
全文约 1.4 万字,建议收藏。数据截至 2026 年 7 月,来自公开财报、WSTS/Gartner/SEMI 等机构预测及业内研讨口径,部分为第三方估算,均在文中标注;不构成任何投资建议。
01
换轨:AI 把硬件产业从"消费逻辑"带入"投资逻辑"
第四次革命,和它的三个前辈
人类历史上有过三次"改变一切"的革命,每一次都把全球 GDP 增速抬上一个台阶:1760 年代开始的蒸汽革命用机器替代肌肉,把人类几千年接近于零的增速抬到约 1%;1870 年代起的电力革命把能源送进千行百业,增速抬到约 3%,整个 20 世纪全球 GDP 增长了约 19 倍;1990 年代的互联网革命把信息流通成本打到零,30 年里全球 GDP 从 23 万亿美元涨到 105 万亿美元。
现在是第四次。红杉资本把 2022 年开启的这一轮直接定名为 Cognitive Revolution(认知革命)——AI 替代脑力,把认知劳动的成本打到趋近于零,一场 10 万亿美元级、比工业革命更宏大的革命。乐观的测算认为,它能把全球增速再抬一个台阶,到 10% 一年。
更值得玩味的是速度:蒸汽机到第一座工厂用了 67 年,工厂到流水线用了 144 年;而这一次,算力、数据、分发基础设施已经全部就位——变革以"年"为单位发生。它还有一个特殊属性:这大概率是人类主导的最后一次革命,因为认知革命完成之后,下一次的大创新,很可能就由 AI 来做了。

能力已经越级:AI 在用"非人类"的方式做设计
认知革命不是口号,有两件已经"上天"和"点火"的实物可以作证。
NASA 的"进化结构"项目里,同一个望远镜支架经过三代 AI 演化算法迭代:一代比一代更不规则、更不重复,镂空的曲面像外星生物的骨骼,人类工程师根本不会这样画——但它整体最轻、刚度最高,比人工设计减重最多三分之二、强度提升三倍,设计周期从几个月缩到以小时计,已经用在多个天文和深空任务上。另一件是 AI 用拓扑优化生成的 Aerospike 火箭发动机:内部流道长得像器官、像肺泡,反直觉,却是最优的流体与冷却路径,3D 打印一体成形、热试车一次点火成功。
AI 理解世界的方式和人类不同——它不需要"看得懂",只需要"最优"。顺着这个趋势看芯片行业本身:今天生产的芯片已有六到八成供给硅基 AI 使用,但设计、制造、设备还都由碳基的人类完成;未来 10 到 20 年,AI 很可能自主设计芯片、自主建晶圆厂、自主设计新一代设备——到那一天,芯片行业本身,就是 AI 重做千行百业的最后一站。
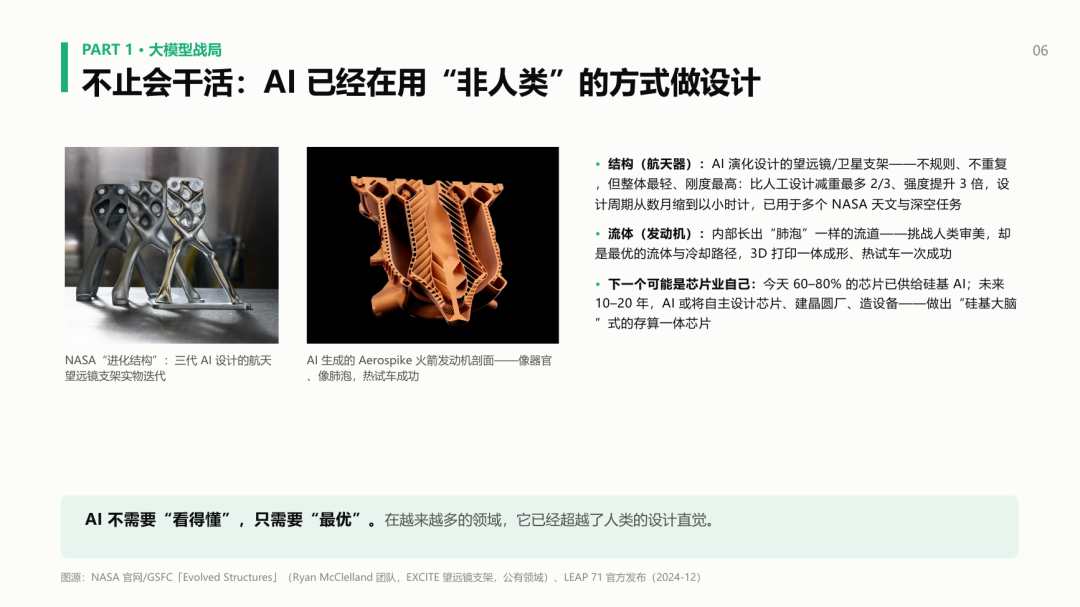
▲ 三代 AI 演化设计的望远镜支架实物(左),与 AI 生成的火箭发动机剖面(右)
1,287 天:速度与不确定性,同时到顶
这场革命跑得有多快,一条时间线看清。2022 年 11 月 30 日,ChatGPT 发布,两个月用户破亿——认知革命的"iPhone 时刻"。2025 年 2 月 24 日,编程 Agent Claude Code 发布,AI 第一次从"回答问题"走向"完成工作",六个月做到 10 亿美元年化收入。2025 年 12 月 27 日,开源个人 Agent OpenClaw(吉祥物是一只龙虾)发布,约 60 天后超过 React 成为 GitHub 历史上 star 最多的项目——React 用了十年,它用了两个月。
2026 年 1 月 15 日,红杉官宣"AGI 到来",硅谷最谨慎的钱包改口了。2 月,Anthropic 接连发布 11 个"硅基员工"插件与安全产品,美股 SaaS 板块应声大跌,市场管这叫"剃头"行情——AI 开始直接改写上市公司的估值逻辑。2026 年 5 月,Anthropic 官方口径年化收入 470 亿美元:距 ChatGPT 发布 1,278 天,三年半,一个行业从 0 做到年化 470 亿美元。
时间线的最后一拍性质完全不同:6 月 9 日,Anthropic 发布迄今最强的公开模型 Fable 5,带着史上最严的限制上线,3 天后被白宫下令召回(公司公开表示异议);它更强的同门 Mythos,因网络安全能力"过于危险"干脆不做公开发布。三年半,行业确认了 AI 的价值;但"AI 是否安全",行业第一次承认没人敢打包票。
还要注意这条时间线最重要的特征:每个里程碑之间的间隔都在缩短——从 ChatGPT 到 Claude Code 隔了 27 个月,从"龙虾"到 AGI 宣言只隔了 19 天。这就是指数世界的体感。

▲ 1,287 天:从 ChatGPT 到"危险"模型
本节结论:定价逻辑换轨
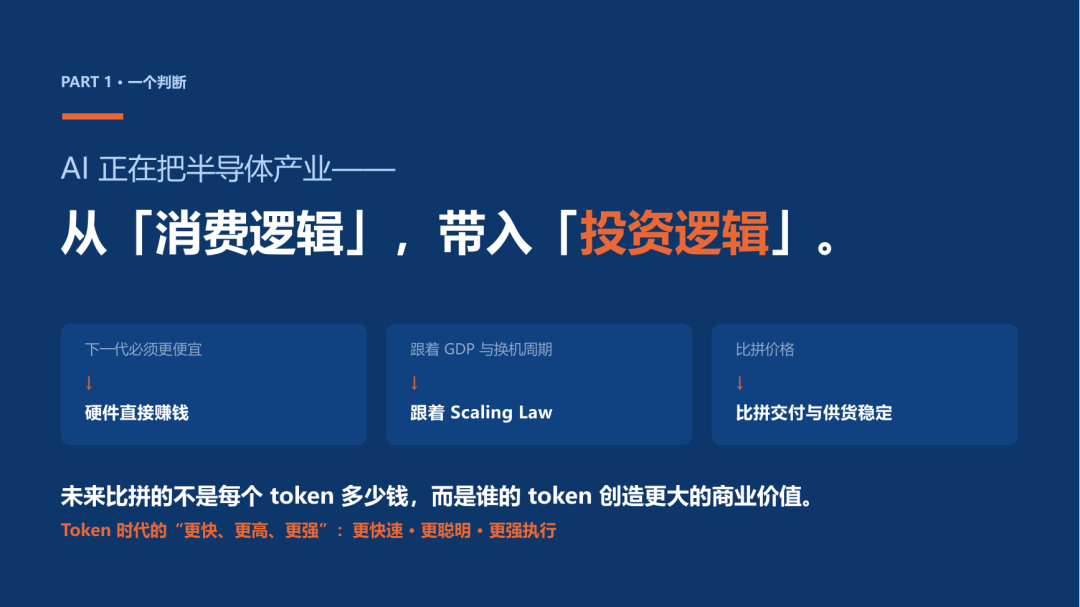
把能力、速度放在一起,可以得出本文最重要的一个判断:AI 正在把半导体乃至整个硬件产业,从"消费逻辑"带入"投资逻辑"。
过去几十年的消费逻辑里,下游是手机、PC、家电——不管性能怎样,下一代必须更便宜,行业跟着 GDP 和换机周期走,供应链拼价格。而在投资逻辑里,硬件直接赚钱:买算力不是消费,是购置生产资料;行业跟着 Scaling Law(规模定律)走,供应链的第一竞争力从价格变成了交付能力与供货稳定。两个现场证据:英伟达曾愿意"翻倍价格换翻倍供应"而不可得——当有钱也买不到货,价格就不再是第一竞争力;某量化基金花 3 亿元只做 100 颗定制芯片,理由是"快人一步,一个星期就把钱赚回来"。
未来比拼的,不是每个 token 多少钱,而是谁的 token 能创造更大的商业价值——更快速、更聪明、更强执行。这句话是全文的纲,后面所有的账都从这里长出来。
02
需求引擎:Agent 把 AI 从"顾问"变成"员工"
大脑,和长了手脚的大脑
先厘清两个常被混用的词。大模型是"大脑":靠上下文学知识、靠推理给路径,交互方式是对话,输出的是"答案"。Agent 是"长了手脚的大脑":理解意图、遵循目标、长程规划、调用工具,常驻在互联网、代码、文件系统这些环境里,带记忆、能自我纠错,交付的不是答案,是"结果"。
关系一句话:模型是发动机,Agent 是整车——发动机每升一级,整车能力翻几倍。而人的分工只剩两件事:表达意图,验收结果。业内已有真实案例:有人一行代码没写,用编程 Agent 一周半做出了一个完整产品。
Agent 元年:软件史上最快的收入曲线
2026 年被称为 Agent 元年,最硬的证据是钱。编程 Agent Claude Code 上线 6 个月年化收入 10 亿美元、9 个月 25 亿美元,最新第三方估算已到约 80 亿美元——软件历史上没有任何产品跑出过这样的曲线。两个细节更能说明问题:GitHub 全部公开代码提交里约 4% 出自它手;平均每位开发者每周让它干 20 个小时的活,相当于雇了半个全职员工。就是这一个产品,把 Anthropic 整个公司的年化收入从一年前的 90 亿美元带到了 470 亿美元以上。大家更熟悉的 Cursor,18 个月 ARR 从 1 亿美元涨到 40 亿美元、被 SpaceX 以 600 亿美元收购——已经足够疯狂,但在这条曲线面前只能算注脚。微软和谷歌自己也承认:公司里 20%–30% 以上的新代码已经由 AI 写出。
企业端的信号同样清晰:Jack Dorsey 的 Block 宣布裁员约 4,000 人、接近 40%——注意,这家公司毛利超 100 亿美元、还在增长 17%,不是活不下去,而是主动重构组织。Dorsey 的原话是:更小的团队,借助更强的 AI,可以做更多更好的工作。一边在放大 Agent,一边在压缩人力——企业的"组织算法"变了:原来花在工资和管理上的钱,开始流向模型调用和算力。
当然要泼一盆冷水:31% 的企业已有 Agent 进入生产环境,但 Gartner 同时预测 40% 的 Agent 项目会在 2027 年前被砍——场景选择决定生死。而从总量看,故事才刚开始:编程只是第一条变现曲线,全球 IT 支出加工程师工资约 5 万亿美元,按 40% 可替代估算就是 2 万亿美元的市场,今天全行业收入只挖了不到 1%。行业里流行的说法是:今年是 0 到 1,明后年是 1 到 10。
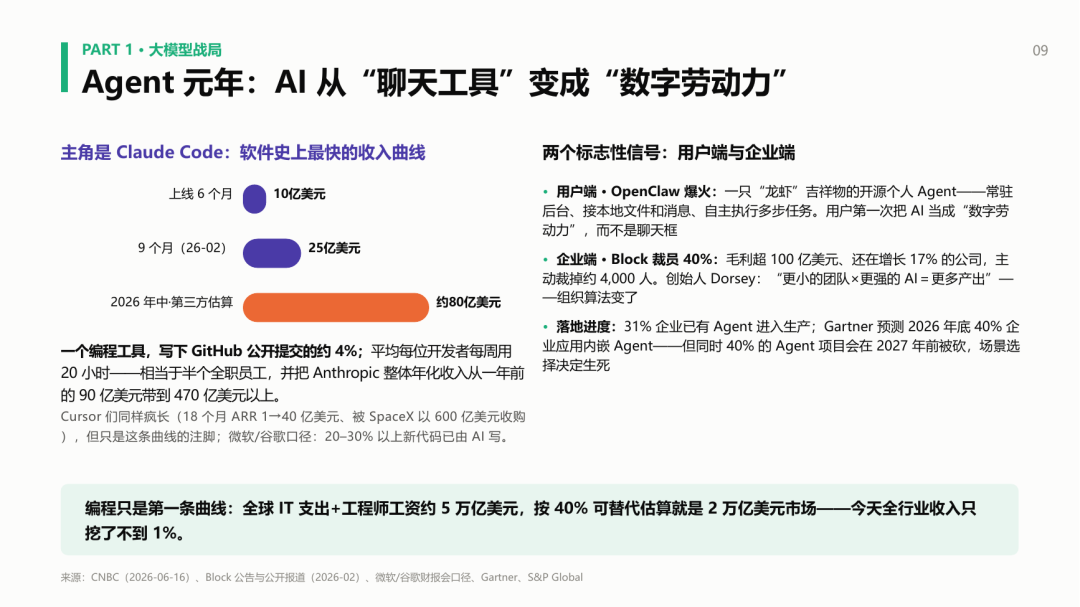
▲ Agent 元年:AI 从"聊天工具"变成"数字劳动力"
Token 经济学:成本骤降、用量爆炸、角色跃迁
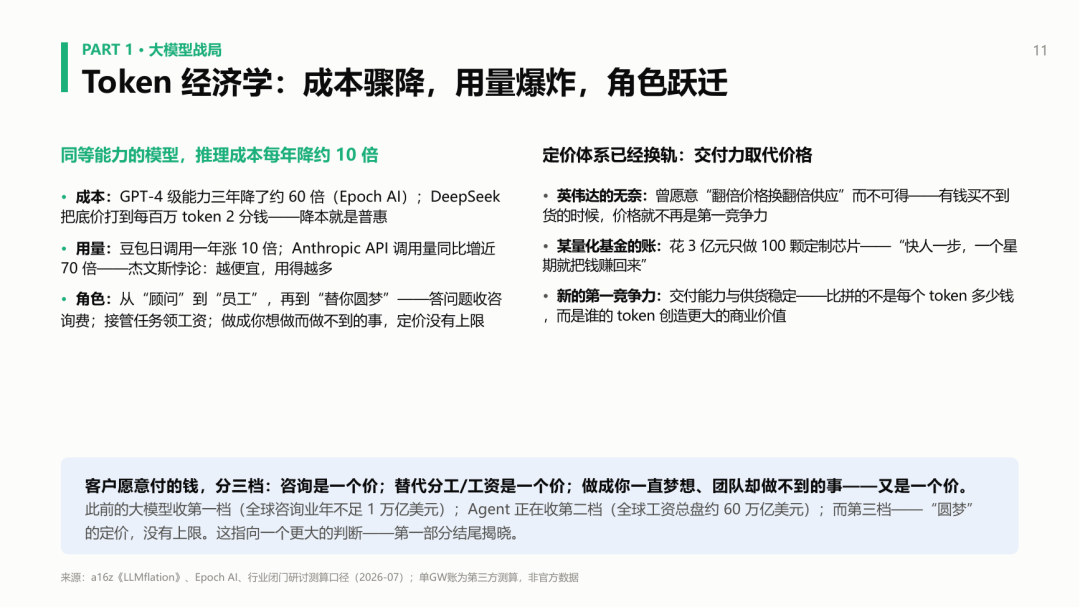
Agent 的经济学可以浓缩成三个关键词。
成本骤降:同等能力的模型,推理成本每年降约 10 倍,GPT-4 级能力三年降了约 60 倍。用量爆炸:豆包的日调用量一年涨 10 倍,Anthropic 的 API 调用量同比涨了近 70 倍——经济学里的杰文斯悖论:越便宜,用得越多,总盘子越大。
第三个关键词最重要:角色跃迁。不妨做个对比:为一次咨询,客户愿意付几千到几万块,还要反复比价;为替代一份工资,客户会按"预算"付十几万到上百万。此前的大模型是"顾问"——答问题、收咨询费,全球咨询业一年不足 1 万亿美元;Agent 是"员工"——接管任务、领工资,全球工资总盘子约 60 万亿美元,两个市场差着两个数量级。其实还有第三档:帮客户做成一直梦想、团队却始终做不到的事——为这种事,付费意愿没有上限。咨询一个价,替代工资一个价,"圆梦"又是一个价。
当 Agent 真的开始承担工作,企业会像管理者一样给模型"分层用工":复杂决策给旗舰模型,日常分析给中档模型,高频标准任务给白菜价模型——token 花的是工资预算,不是软件预算。AI 时代的劳动力同样分层:有 AI 蓝领、AI 白领,也有 AI 硕士、AI 博士,背后是不同能力、不同成本的 token。
一个前瞻判断:未来的沟通是 A2A
沿着能力曲线往前推演:各行各业都会有一个"行业 Agent",实时收集整理这个行业的全部信息;每个人都会有一个私有化的"个人 Agent"——最了解你的那个存在,你所有对外的沟通和信息交互都由它完成。到那时,业务的发生与协同就是 A2A——Agent 对 Agent 的对话,不经过 Agent 的人与人直接沟通会变得越来越少。
这不是科幻,学校和科研体系里已经发生了:在 AI 擅长的领域,教授和学生之间已经很少直接讨论——各自先跟 AI 对话几十轮,把结果发给对方,对方再交给自己的 AI 去分析。这个模式会复制到每一个行业。对创业者,这个判断里藏着三个卡位:行业 Agent(拼行业 know-how 与数据)、个人 Agent(拼隐私与信任)、以及 A2A 世界的协议与基础设施——MCP、A2A 这些标准已捐入 Linux 基金会,生态刚刚起步。
03
牌桌:三强的胜负手,与中国队的 token 红利
三个超级玩家,各有底牌
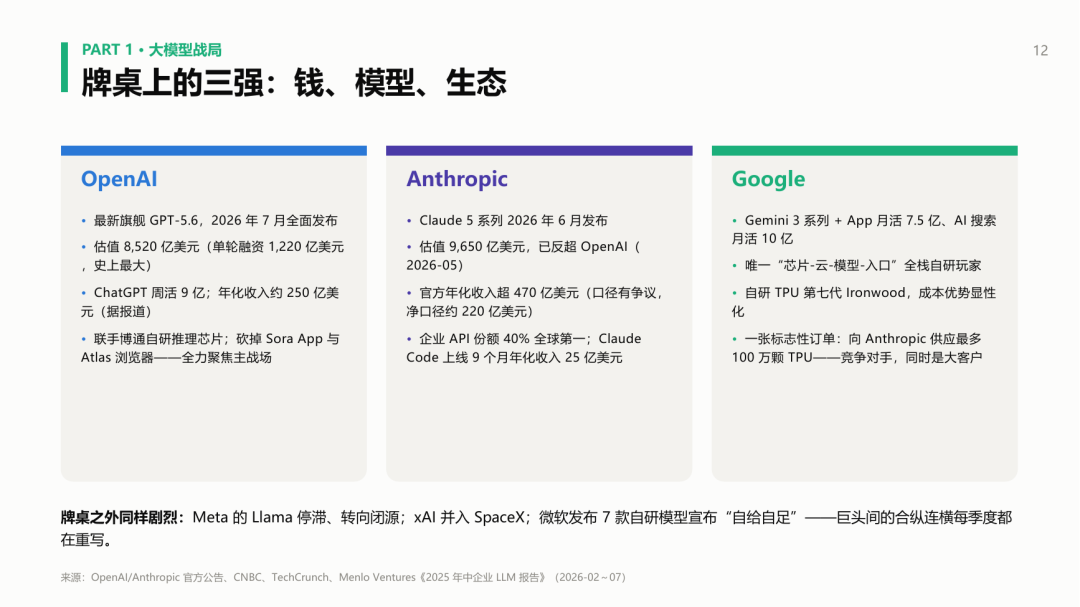
OpenAI:最新旗舰 GPT-5.6 刚全面发布,估值 8,520 亿美元,单轮融资 1,220 亿美元创人类纪录,ChatGPT 周活 9 亿。值得注意的是它开始做减法:砍掉 Sora 独立 App 和浏览器项目,联手博通自研推理芯片——巨头开始聚焦,说明竞争进入深水区。
Anthropic:2026 年 5 月估值达 9,650 亿美元、反超 OpenAI。打法很清晰——押注"干活"而不是"聊天":企业 API 市场份额 40% 全球第一,官方口径年化收入超 470 亿美元(口径有争议,净口径约 220 亿美元,但无论按哪个口径增速都惊人)。
谷歌:唯一"芯片—云—模型—入口"全栈自研的玩家,自研 TPU 已到第七代,成本优势开始显性化。它牌桌上最有意思的一张牌:向 Anthropic 供应最多 100 万颗 TPU——竞争对手,同时是大客户;算力在这个时代已经是硬通货。
牌桌之外同样剧烈:Meta 的开源路线停滞、转向闭源;xAI 并入 SpaceX;微软发布七款自研模型宣布"自给自足"。这个层面的竞争单位是千亿美元——创业者不要上桌,但要看懂他们出牌。
胜负手只有两个字:聚焦
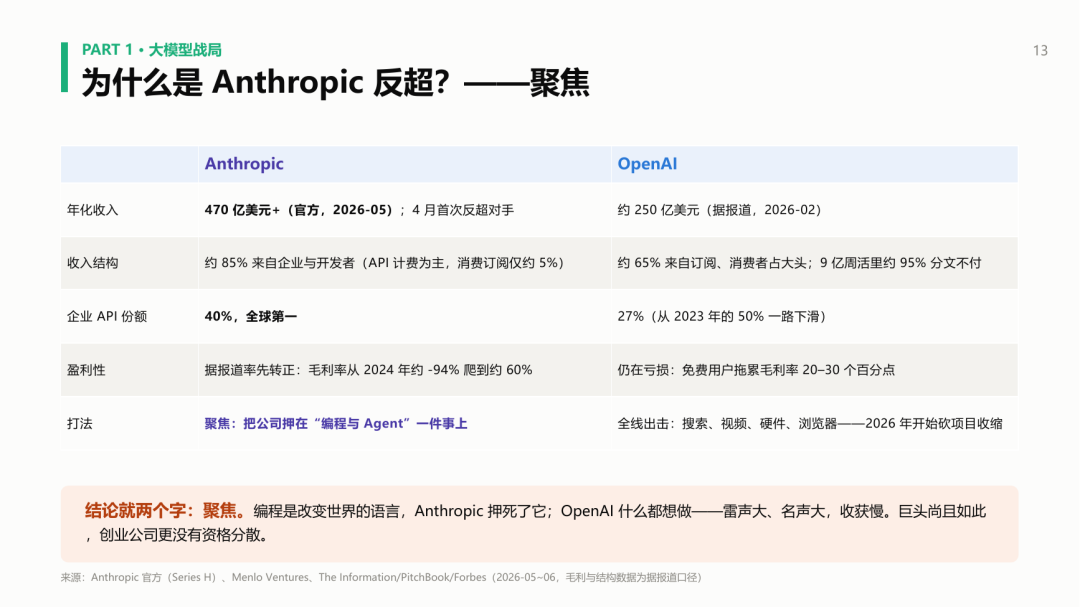
过去一年大模型双雄的位置对调——Anthropic 的年化收入在 4 月首次反超 OpenAI,估值随后也反超。原因藏在三组数字里。
收入结构:Anthropic 约 85% 的收入来自企业与开发者、以 API 计费为主,消费订阅只占 5%;OpenAI 反过来,六成五收入来自订阅,9 亿周活里约 95% 分文不付。企业市场:Anthropic 企业 API 份额 40% 全球第一;OpenAI 27%,还在从 2023 年的 50% 一路下滑。盈利性:据报道 Anthropic 已率先转正,毛利率从 2024 年的负 94% 爬到约 60%;OpenAI 仍在亏损,庞大的免费用户把毛利率拖低二三十个百分点——企业客户每个 token 的收入是消费者的三到五倍,还更稳定。
归结起来就两个字:聚焦。Anthropic 把整个公司押在"编程与 Agent"一件事上——因为编程是改变世界的语言,是 AI 第一个能闭环验证、闭环收费的场景;而 OpenAI 搜索、视频、硬件、浏览器、社交什么都做,雷声大、收获慢,直到今年才开始砍项目收缩。巨头之间的胜负尚且由聚焦决定,创业公司更没有资格分散。
中国队:开源跑量,token 红利
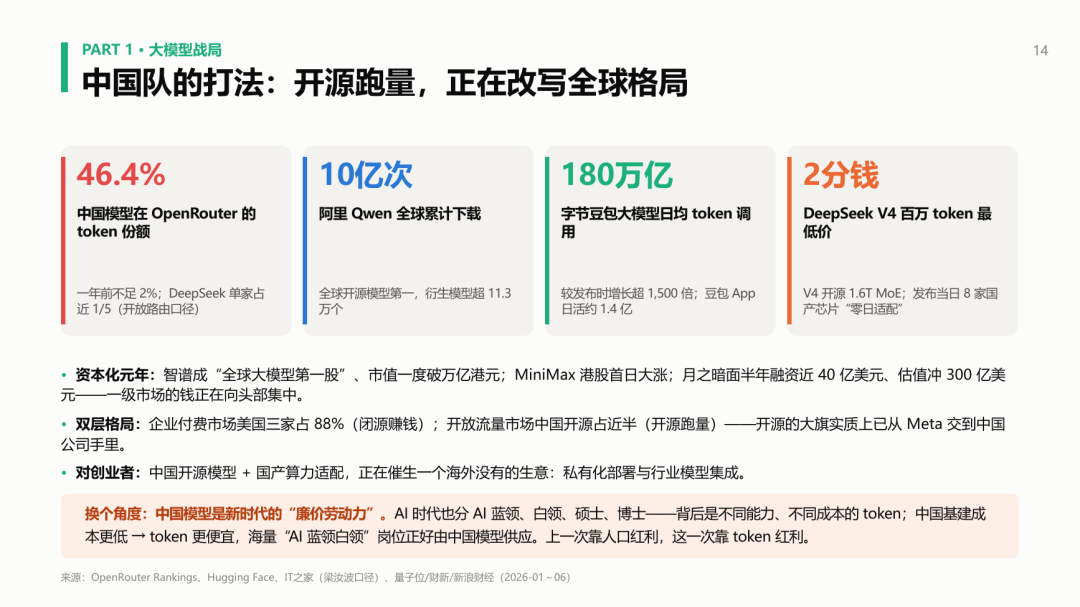
中国队的打法完全不同,四个数字看懂:46.4%——全球最大模型开放路由平台 OpenRouter 上,中国模型的 token 份额从一年前不足 2% 涨到 46.4%,DeepSeek 一家占近五分之一;10 亿次——阿里 Qwen 全球累计下载量,开源模型全球第一,衍生模型超 11 万个;180 万亿——字节豆包大模型的日均 token 调用量,较发布时涨了 1,500 倍;2 分钱——DeepSeek 把每百万 token 的底价打到 2 分钱人民币,发布当日八家国产芯片"零日适配"。资本市场也在投票:智谱、MiniMax 相继完成标志性上市,月之暗面半年融资近 40 亿美元、估值冲向 300 亿美元。
看懂这个双层格局:企业付费市场,美国三家占 88%——闭源赚钱;开放流量市场,中国开源占近半——开源跑量。开源的大旗,实质上已经从 Meta 交到了中国公司手里。
更深一层的解读:中国模型是新时代的"廉价劳动力"。接电话、审单据,便宜的 token 就够用;做科研、写系统,才需要最贵的 token。正因为中国 AI 基建的成本更低、token 更便宜,全球海量"AI 蓝领、AI 白领"岗位正好由中国模型供应。上一次,中国靠人口红利成为世界工厂;这一次,靠的是 token 红利。开源模型还有一个天然优势:最敏感的数据一定存在本地——由此催生出一门海外没有的生意:私有化部署与行业模型集成(第六章展开)。
04
万亿账本:一年 3 万亿美元的资本开支,账能算平吗?
先建立规模感:这是重资产革命
四个数字。第一,7,250 亿美元——微软、谷歌、Meta、亚马逊四家 2026 年的资本开支合计,同比增长 77%,比全球绝大多数国家一年的财政收入都大。第二,英伟达 Blackwell 加 Rubin 两代平台,到 2027 年的订单可见性超过 1 万亿美元。第三,英伟达最新单季营收 816 亿美元,其中数据中心 752 亿、同比增长 92%,市值约 5 万亿美元、全球第一。第四,2025 年全球风险投资的 61% 流向 AI,OpenAI 和 Anthropic 两家就拿走了全球 VC 的 14%。
这四个数字合起来说明一件事:这不是一场软件革命,是一场重资产革命。IEA 测算,全球数据中心用电量到 2030 年将翻倍到 950 太瓦时、占全球用电近 3%。上一次人类用这种强度砸基础设施,是电网,是高速公路。

一本五步账:黄仁勋的 3 万亿,怎么对上账
7,250 亿只是起步——黄仁勋的说法是,到 2030 年一年要烧 3 万亿美元。这个数字听着离谱,但行业里有一本摊开算的五步账,值得整套记下来。
第一步,单 GW 经济账。以 Meta、微软、谷歌为样本:每 GW 数据中心投资约 250–450 亿美元,按五年折旧年成本 50–90 亿美元;而每 GW 每年能带来约 100–150 亿美元收入——收入第一次系统性盖过折旧成本。所以说,2026 年,AI 开始赚钱了:据报道头部模型公司已率先盈利,最贵的 token 毛利率约 75%。
第二步,GDP 锚定。全球 GDP 约 126 万亿美元,如果 AI 拉动其中 10%(正是第一章认知革命的增速台阶),就是每年 12.6 万亿美元的增量产出;按约 75% 的推理毛利率——投 1 块钱、挣 4 块钱——反推,正好支撑约 3 万亿美元的年资本开支。黄仁勋的数,就这样对上了账。
第三步,供给上限。硬约束在 ASML 光刻机:存量 200 多台、每年新增六七十台,推算到 2030 年每年可支撑新增约 200 吉瓦数据中心——全行业资本开支的物理天花板大约在 4–5 万亿美元。
第四步,谁来出钱。现在的钱几乎全部来自北美几大云厂,一年约 1 万亿美元,而且已经开始举债。从 1 万亿到 4、5 万亿,缺口巨大——AI 终将像修桥铺路一样普惠化,美国、中国、中东的国家级资本,可能是下一阶段最重要的投资方。
第五步,远期需求。今天模型公司的收入本质上还是"单一 coding 曲线"——约 2 万亿美元的年市场空间,头部公司年化才刚过百亿美元,差着两个数量级;而且一年前没人预料到编程 Agent 的爆发,新的变现曲线还会不断出现——时间站在多头这一方。再往后是物理 AI:机器人时代的存储用量,按美光的口径可达当前的 1,000 倍。
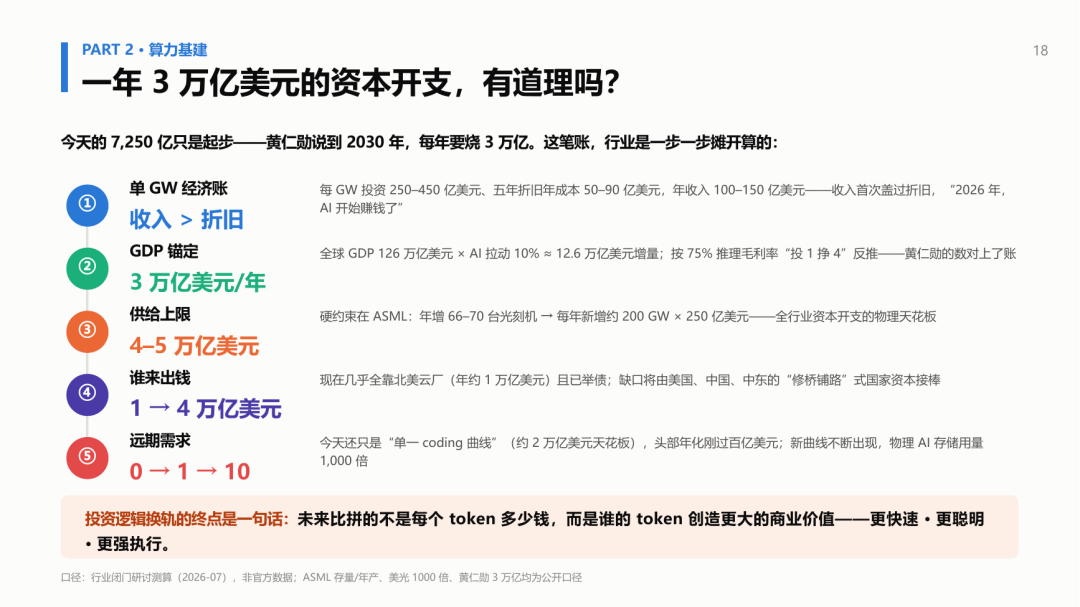
▲ 一年 3 万亿美元资本开支的五步账
这本账还有一个顺理成章的推论:私有化算力一定会出现。token 毛利率高企,而大量任务并不赶时间——比如把积攒多年的照片、文件结构化成 AI 可读的数据库,这是 7×24 小时慢慢跑的活,用高毛利的 token 跑并不划算,本地部署开源模型只费一点电。隐私加经济性,决定了个人和企业的私有化算力是下一个确定性需求。
反面教训:省下的资本开支,买不回第一名
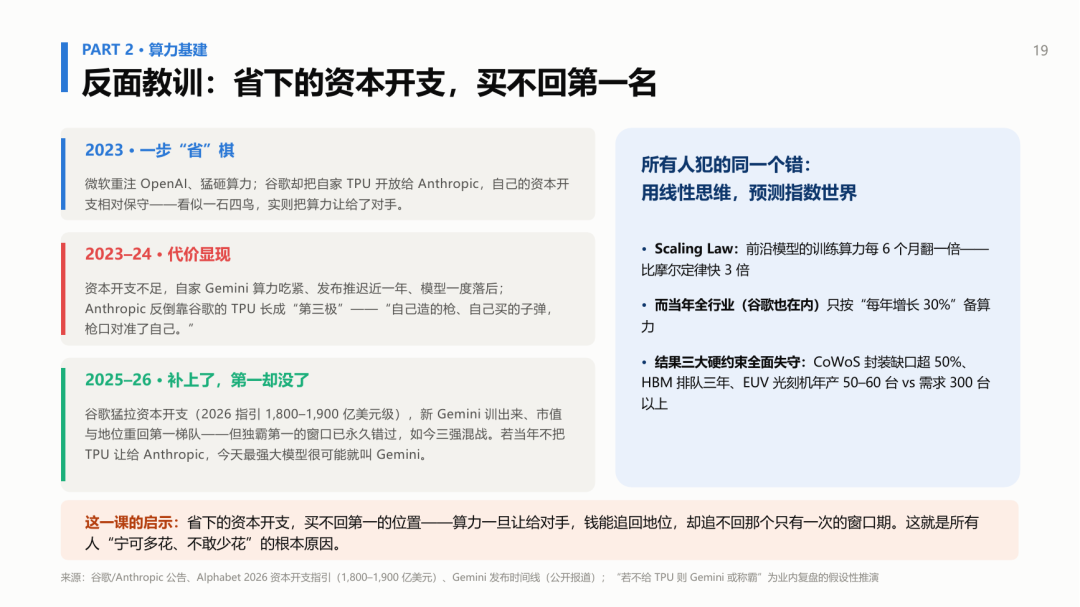
正面的账算完,看反面:如果在算力上省钱,代价是什么?一个真实的教训,分三幕。
第一幕,2023 年:微软重注 OpenAI、猛砸算力;谷歌却把自家最宝贵的 TPU 算力开放给了 Anthropic,自己的资本开支相对保守。当时的算盘是"一石四鸟":投资入股、赚云收入、验证技术、留战略后手——看着聪明,本质上是把本该留给自己的算力让给了对手。
第二幕,代价显现:谷歌自家旗舰模型启动大规模训练时才发现算力不够,发布推迟近一年、能力一度落后;Anthropic 拿着谷歌的 TPU 一路狂奔,长成 AI 竞赛的"第三极"。业内复盘时有句扎心的话:自己造的枪、自己买的子弹,枪口最后对准了自己。
第三幕,2025–2026 年:谷歌醒过来猛砸资本开支——2026 年指引拉到 1,800–1,900 亿美元级别,新一代模型训出来,市值与地位重回第一梯队。但独霸第一的窗口永久错过了:今天是三强混战。业内很多人的共识是一个反事实推演:如果当年谷歌不把 TPU 让给对手,今天全球最强的大模型,很可能就是 Gemini。
这个故事的底层逻辑,是所有人都在犯的同一个错:用线性思维,预测指数世界。Scaling Law 告诉我们,前沿模型的训练算力每 6 个月翻一倍、比摩尔定律快 3 倍;而当年整个行业按"每年增长 30%"备产能,结果 CoWoS 封装、HBM 内存、EUV 光刻机三大硬约束全面失守。这一课的启示:算力这种核心资源一旦让给对手,钱可以追回地位,却追不回那个只有一次的窗口期——这就是今天所有巨头"宁可多花、绝不敢少花"的根本原因,也是预测机构半年内被迫上修 5,300 亿美元的深层答案。
05
拆开账本:钱沿着产业链,最终落进谁的口袋
半导体大盘:从"GDP 影子行业"到跟着 Scaling Law 走
过去二十年,半导体是个"GDP 影子行业":下游是 PC、手机、家电,增速长期约为全球 GDP 的两倍,跟着换机周期起落。2025 年它实际卖了 7,917 亿美元、增长 25.6%,对 GDP 的增速倍数跳到约 7 倍;到 2026 年的预测口径,这个倍数会干到 20–30 倍——历史常态只有 2 倍。
于是出现了开头那一幕:WSTS 半年内把预测从 9,750 亿美元改写为 1.51 万亿美元(+90%),Gartner 从 9,098 亿美元改口超 1.3 万亿美元,2027 年 WSTS 看到 1.91 万亿美元。拆开看发动机:存储一项达 8,039 亿美元、增长 250%——DRAM 年度涨价 125%、NAND 涨 234%——历史上第一次占到全行业半壁江山;AI 半导体合计已占行业收入约三成。
需求性质的切换是根本原因:过去买芯片的是换手机的消费者,预算跟着经济周期走;现在买芯片的是把算力当生产资料的企业和国家——只要"投 1 挣 4"的账成立就继续加码,与宏观景气无关。苹果被挤出台积电的产能优先级,是"消费让位于投资"最标志性的一幕。判断这个行业,别再看宏观 PMI,去看 token 用量和资本开支指引。
英伟达:Token King,与 SysMoore 的 3,500%
钱的第一站,流向了同一家公司。2026 年 3 月 GTC 的名场面:第三方机构 SemiAnalysis 发布跨平台推理性价比横评 InferenceMAX,结论是英伟达生成 token 的成本全球最低,黄仁勋当场举起一条拳王"金腰带"——Token King。这不是段子:今天全球在跑的 token 绝大多数从英伟达平台流出,其数据中心业务年化约 3,000 亿美元。
它凭什么最便宜?一组对比:摩尔定律(Moore's Law),晶体管密度一年提升 30% 左右,这是单颗芯片的进步天花板;而英伟达每年推出一个新平台——Hopper、Blackwell、Rubin——每一代把 token 效率提升 35 倍,换算过来是 3,500%。3,500% 对 30%,这就是 SysMoore(系统摩尔)对 Moore:单芯片的摩尔定律走不动了,性能的接力棒交给了芯片、互联、软件、电源、散热一起动的系统级创新。
为什么只有它做得到系统级?因为今天的英伟达某种意义上是"人类协作的巅峰":一方面组织极度扁平;另一方面,更罕见的是,全球科技公司都愿意把自己现在的能力、未来两三年的规划,提前向它毫无保留地交底——工艺、HBM、电源、散热方案都摊在它面前,让它据此做整机设计。在全球产业链的"托举"之下,它做到了任何单一公司都做不到的事。结果就是:英伟达定义的生态,会成为行业的标准;英伟达定义的方向,就是行业的方向。
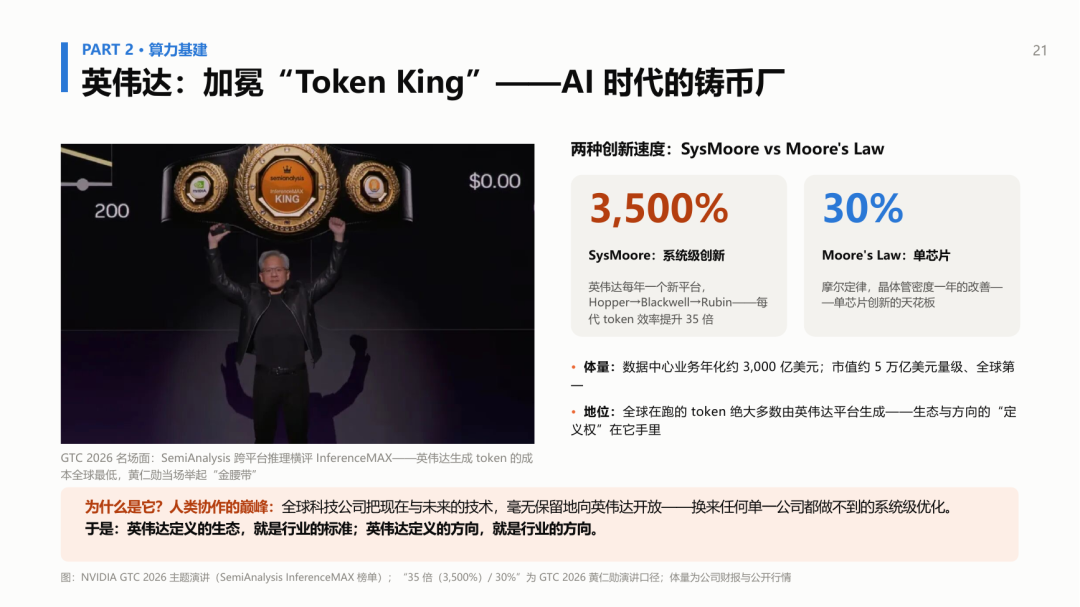
▲ GTC 2026:"Token King"金腰带,与 SysMoore 对 Moore 的 3,500% vs 30%
拆开一台机柜:每一行 BOM,都是一条产业链
钱具体买了什么?拆一台今天 AI 数据中心的主力机型——英伟达 GB200 NVL72:72 颗 GPU、36 颗 CPU、18 颗交换芯片,机柜内 130 TB/s 全互联,72 颗 GPU 被当成一颗来编程;整机功耗 130 千瓦、是传统机柜的 10 倍,液冷从可选项变成必选项——而且下一代 200 千瓦、再下一代 600 千瓦,还在涨。
看 BOM(物料清单)要先看口径:GPU 一项约 250 万美元,是英伟达的"售价"、大头是它 70% 以上的毛利——按纯制造成本算 72 颗 GPU 只有约 46 万美元,其中近一半是 HBM 内存。其余是从生态采购的:HBM 加内存约 37 万美元给了存储三巨头,铜缆背板给安费诺,电源、液冷、高层数 PCB 各有各的赢家。机柜内部 72 颗 GPU 之间全是铜缆,光是用在机柜与机柜之间的——把集群网络的光模块摊回每一柜约数百只、15–25 万美元;英伟达一年要采购约 500 万只光模块。
最值得盯的是存储那一行:HBM 缺货涨价,到 2027 年的 Rubin 世代,单柜存储要从 37 万美元冲到约 200 万美元、占整柜 BOM 约四分之一,跃居第二大成本项。结果是 SK 海力士 2026 年一季度毛利率约 80%、营业利润率 72%,双双创历史纪录——一家重资产制造业公司,挣出了比软件公司还高的利润率。巨头吃肉的地方,汤也是滚烫的,而内存这碗汤现在最烫。
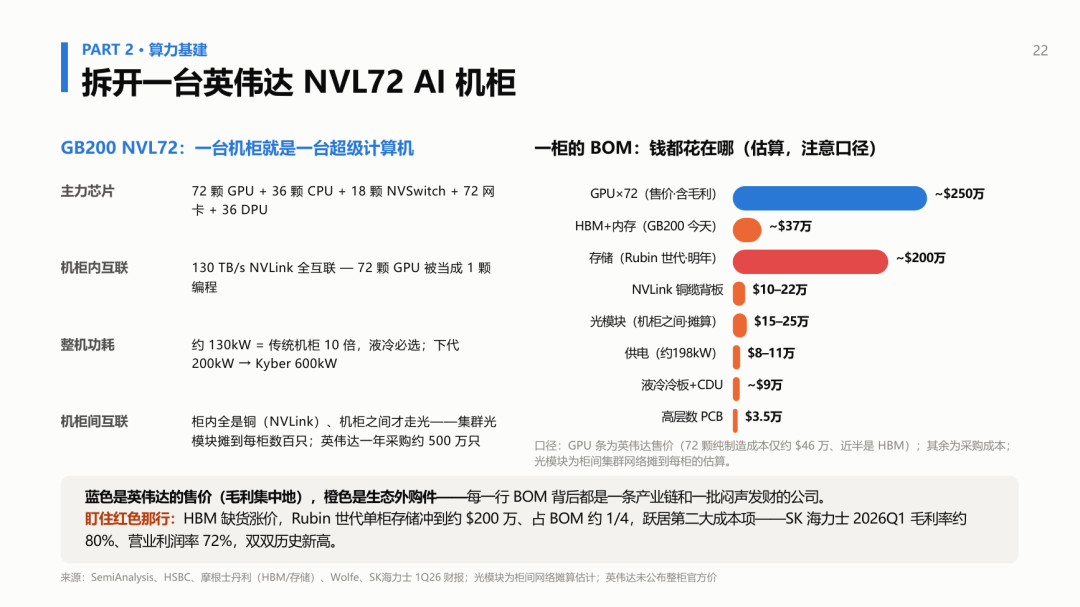
▲ 拆开一台 NVL72:蓝色是英伟达的售价(毛利集中地),其余是生态外购件
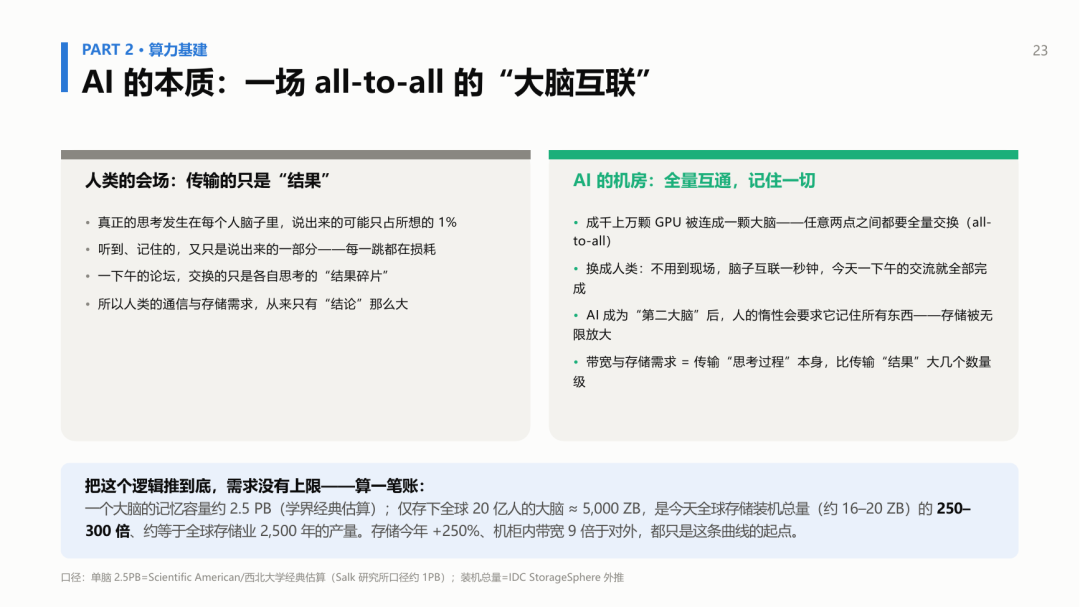
第一性原理:AI 是一场 all-to-all 的"大脑互联"
为什么 AI 对互联和存储的需求会爆炸?因为 AI 的通信方式与人类有本质区别。
人类的信息系统从来只传"结果":一场几小时的会议,台上说出来的可能只是所想的百分之一,听众记住的又只是说出来的一部分——每一跳都在损耗,真正的思考过程锁在各自脑子里。而 AI 把这个前提彻底改了:成千上万颗 GPU 要连成一颗大脑,任意两点之间都要全量交换信息(all-to-all)——这就是机柜内带宽是对外九倍、还要从铜换到光的根本原因;同时,当 AI 成为人的第二大脑,人的惰性会要求它记住所有东西——存储需求被无限放大。
放大到什么程度?算一笔账:神经科学界对单个大脑记忆容量的经典估算是 2.5 PB;仅存下全球 20 亿人的大脑就是约 5,000 ZB——而今天全球存储装机总量只有 16–20 ZB。只这一项需求,就是现有总量的 250–300 倍,相当于让全球存储产业不吃不喝干 2,500 年。存储今年涨 250%,只是这条曲线的起点。
瓶颈不在"算",在"连":光的生意与它的变局
工程现实是:今天算力的瓶颈不在"算",在"连"。一万颗 GPU 做一次梯度同步只要 40 微秒,但只要一颗慢了 20 微秒,其余 9,999 颗全体陪等——互联决定整机效率,木桶效应在这里是物理定律。速率军备赛更残酷:SerDes 从 112G 到 224G 到 448G 每代翻倍,电信号在铜线里越来越跑不动,损耗高达 22 dB。记住一句话:电的瓶颈,把光一步一步往芯片方向推。
把"连"这门生意做成印钞机的,是两家中国公司:全球光模块第一的中际旭创(英伟达第一大供应商,2025 年营收 382 亿元、增长 60%,净利 108 亿元、增长 109%;2026 年一季度营收再增 192%、净利增 262%)和全球第二的新易盛(2025 年营收 248 亿元、增长 187%,净利 95 亿元、增长 236%)。行业大盘同样火热:2026 年一季度全球光模块单季销售额 100 亿美元、增长 90%,创历史新高;两家合计拿走英伟达可插拔订单约六成。
但商业世界最戏剧性的一幕正在上演:2026 年,英伟达要买下全球八成以上的 1.6T 光模块(超 500 万只);同一年,它把自家交换机上的光模块整个"焊"进了芯片封装(CPO)——买家与拆解者,是同一个人。拆的理由是物理账:光引擎搬进封装,一个 800G 端口的功耗从 30 瓦降到 9 瓦,放到十万卡集群等于省出一座电站。于是"光模块"被拆成六个环节重新分配:芯片设计权归英伟达,制造归台积电,DSP 芯片直接消失,激光器归 Coherent 和 Lumentum(英伟达各注资 20 亿美元绑定),光纤阵列 FAU 归中国的天孚通信——传统光模块整机厂,在这份新 BOM 里没有位置。
也要注意节奏:CPO 渗透率到 2030 年约 35%,传统可插拔光模块出货还要翻三倍——变局是渐进的,中间有巨大的过渡窗口,两家龙头也已在自救:一家向上游自研硅光芯片、押注新形态,另一家率先量产新一代方案。这一页的结论适用于每一个行业:问题从来不是"变局会不会来",而是——它来的时候,你在新 BOM 的哪一行?
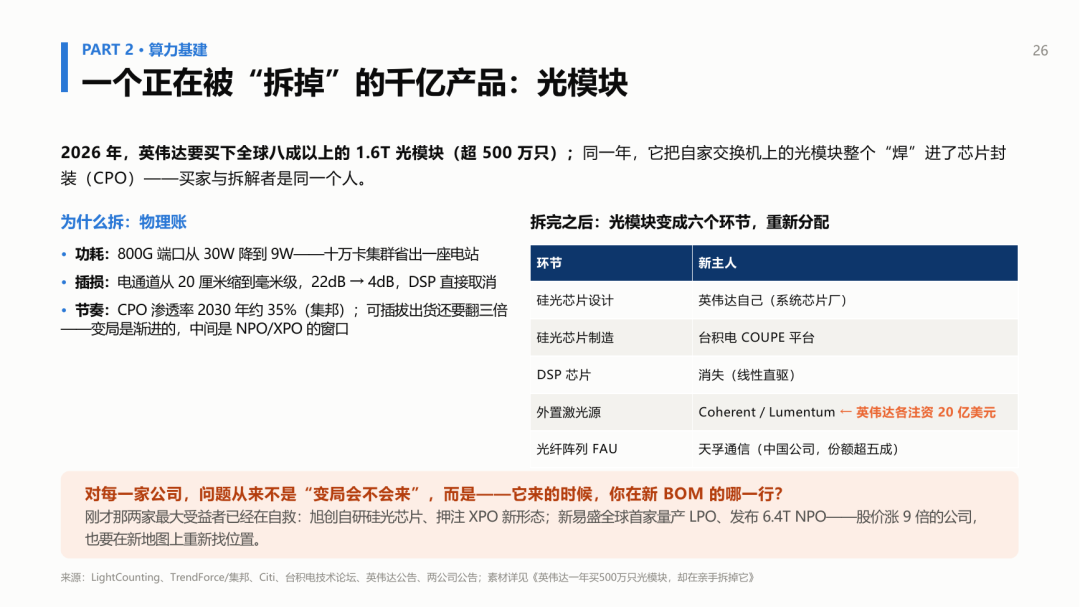
▲ CPO 把"光模块"拆成六个环节重新分配
晶圆:一场没有退路的产能战争
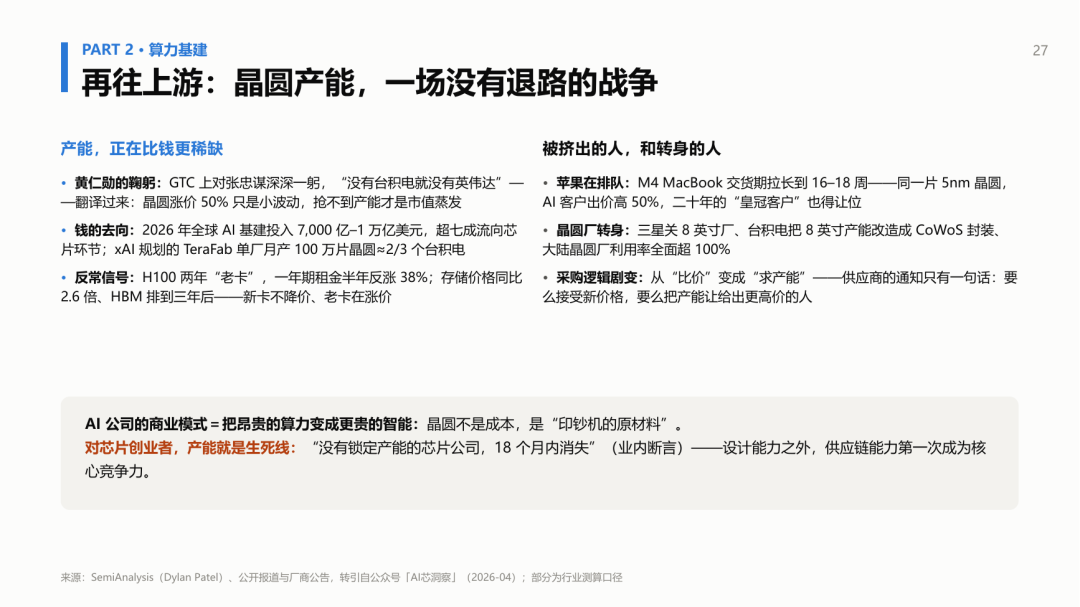
再往上游走一层。2026 年 GTC 上有个画面:黄仁勋当着几万人对张忠谋深深鞠躬,说"没有台积电就没有英伟达"。这句感谢翻译成商业语言是:晶圆涨价 50% 对英伟达只是净利润的小波动,但抢不到产能,蒸发的是几千亿市值。
几个信号。钱的去向:2026 年全球 AI 基建投入 7,000 亿到 1 万亿美元,超七成流向芯片环节;马斯克规划中的 TeraFab 单厂月产 100 万片晶圆,相当于三分之二个台积电。反常信号:H100 是两年前的"老卡",按摩尔定律早该打折,一年期租金却在半年内反涨 38%;存储价格同比 2.6 倍,HBM 排到三年后——新卡不降价、老卡在涨价,这不是供需紧张,是供需灾难。最扎心的一幕:苹果这个二十年的"皇冠客户",M4 MacBook 交货期被拉到 16–18 周——同一片 5nm 晶圆,AI 客户出价高 50%,连苹果都要排队。三星在关 8 英寸厂,台积电把 8 英寸产能改成 CoWoS 封装,采购逻辑从"比价"变成了"求产能"。
这对创业者有两层含义。第一层,看懂 AI 公司的商业模式:花大价钱买算力、变成 token、再以更高价格卖出去——晶圆不是成本,是"印钞机的原材料"。第二层更直接:对芯片创业者,产能就是生死线,业内甚至有个断言——没有锁定产能的芯片公司,18 个月内消失。设计能力之外,供应链能力第一次成为核心竞争力。
设备:所有人都在排队,排队本身就是生意
资本开支的钱最终会传导成设备订单:五大云厂约 7,750 亿美元资本开支,约三分之一流向加速器芯片;芯片订单逼着晶圆厂扩产——台积电今年资本开支 520–560 亿美元,三星砸出约 730 亿美元的史上最大投入,美光上调到 270 亿美元、九个月内调了四次;而晶圆厂资本开支的七到八成,最终变成一台一台的设备。结果:全球晶圆厂设备市场今年预计 1,400–1,500 亿美元、增长超过 20%,明年可能冲向 2,000 亿美元。
有个细节值得琢磨:2025 年 12 月,行业对 2026 年设备市场的共识预测还只有 +9%;到 2026 年 5–7 月,各大机构集中上修到 +21%~28%——半年上修 18 个百分点。连最专业的机构都在用线性思维预测指数世界,和谷歌 TPU 那一课是同一个错误。
排队已经排成什么样?测试机:SK 海力士为 HBM4 一次抢购约 200 台,爱德万交期超 6 个月、直接宣布"2026 年产能售罄"。EUV 光刻机:SK 海力士下了一笔 80 亿美元的大单——ASML 史上最大单笔订单,而 ASML 今年全年只能造 60 台。键合设备:混合键合客户一年从 0 涨到 20 家,BESI 订单翻倍,产能一年只能从 180 台爬到 250 台。CoWoS:台积电产能两年翻两番,到年底缺口仍约 10%——设备交付周期 12–18 个月,这是钱解决不了的时间。更上游的电力设备:变压器交期约 128 周,大型燃气轮机最长要等 7 年。
而且缺口不是脉冲,是趋势:工艺每复杂一步,单位晶圆的"设备含量"就抬一级——GAA 晶体管让检测层增加 50%,HBM 十六层堆叠坏一颗整包报废、测试次数与时长齐涨,CPO 的晶圆级光电测试单颗超 100 秒被称为量产真瓶颈。供给侧则有三道墙:时间墙(主流设备交付 12–18 个月,加钱不加速)、良率墙(混合键合一颗 1 微米的尘粒就能毁掉一片键合区)、预期墙(五大设备商对 2027 年罕见集体看多,两年合计约 3,500 亿美元、史上最大扩张窗口)。需求以"周"为单位变化,供给以"年"为单位响应——中间的每一条队伍,都是一门生意。
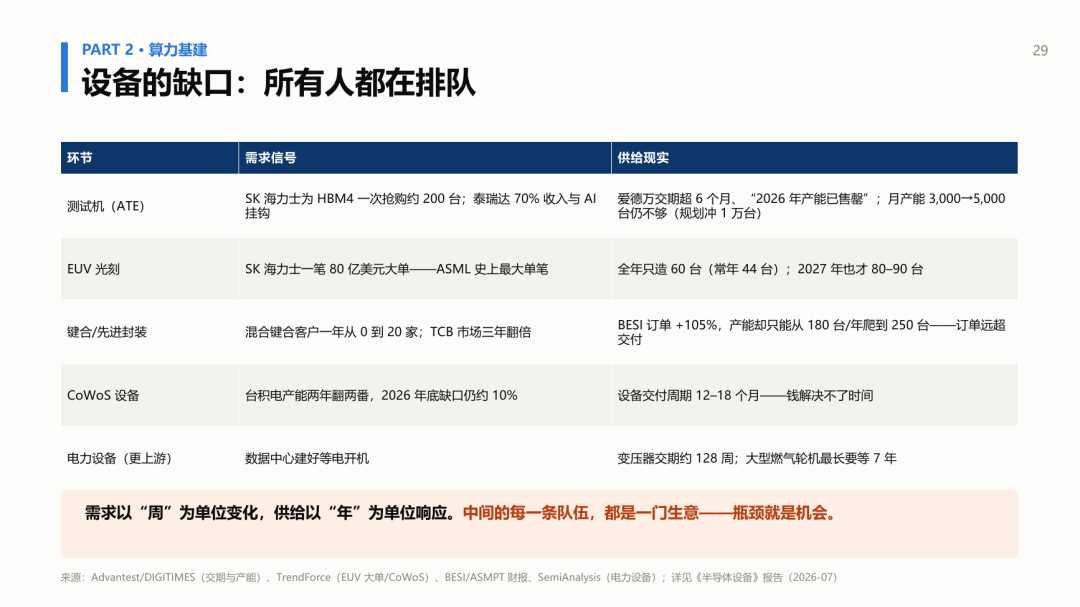
▲ 设备的缺口:每一行都在排队
中国在这本账上的位置:强、追、缺
强在光模块:全球七成产能在中国厂商手里,前两名都是中国公司——这是中国公司在全球 AI 蛋糕上切得最深的一刀。追在算力芯片:国产 AI 加速卡份额已到约 41%;华为 CloudMatrix 384 超节点用 384 颗昇腾芯片全对等互联;DeepSeek 新模型发布当天八家国产芯片"零日适配"——软硬件生态第一次咬合上了;寒武纪、摩尔线程、沐曦、壁仞相继完成资本化里程碑。缺在上游:先进制程、HBM,以及核心设备——光刻的国产化率约等于零、量检测约 10%、收入口径整体约 21%,再加上 EDA 和硅光代工。
但换个角度:每一个"缺",都是一张十年期的创业和投资地图。
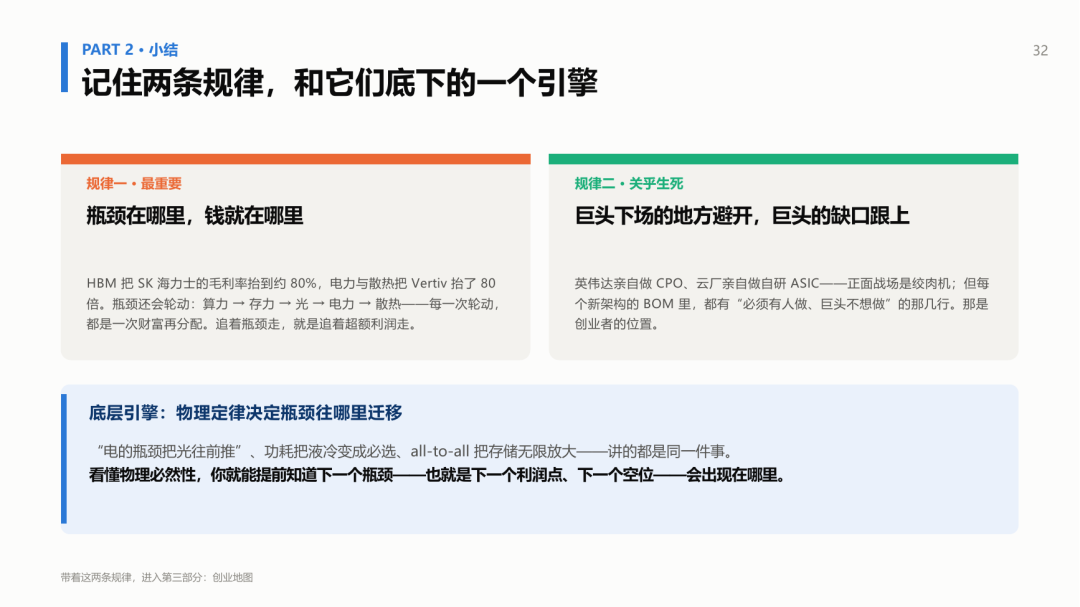
本章小结:两条规律,一个引擎
第一条规律,最重要:瓶颈在哪里,钱就在哪里。HBM 把 SK 海力士的毛利率抬到约 80%,电力和散热把 Vertiv 抬了 80 倍;而且瓶颈会轮动——算力、存力、光、电力、散热,每一次轮动都是一次财富再分配。追着瓶颈走,就是追着超额利润走。
第二条规律,关乎生死:巨头下场的地方避开,巨头的缺口跟上。英伟达亲自做 CPO、云厂亲自做自研芯片——正面战场是绞肉机;但每个新架构的 BOM 里,都有"必须有人做、但巨头不想做"的那几行,那是创业者的位置。
两条规律底下共用一个引擎:物理定律决定瓶颈往哪里迁移。电的瓶颈把光往前推、功耗把液冷变成必选、all-to-all 把存储无限放大——讲的都是同一件事。看懂物理必然性,就能提前知道下一个瓶颈——也就是下一个利润点、下一个空位——会出现在哪里。
06
创业地图:三层结构,与"军需官"法则
先看全局:三层结构,钱和机会的分布
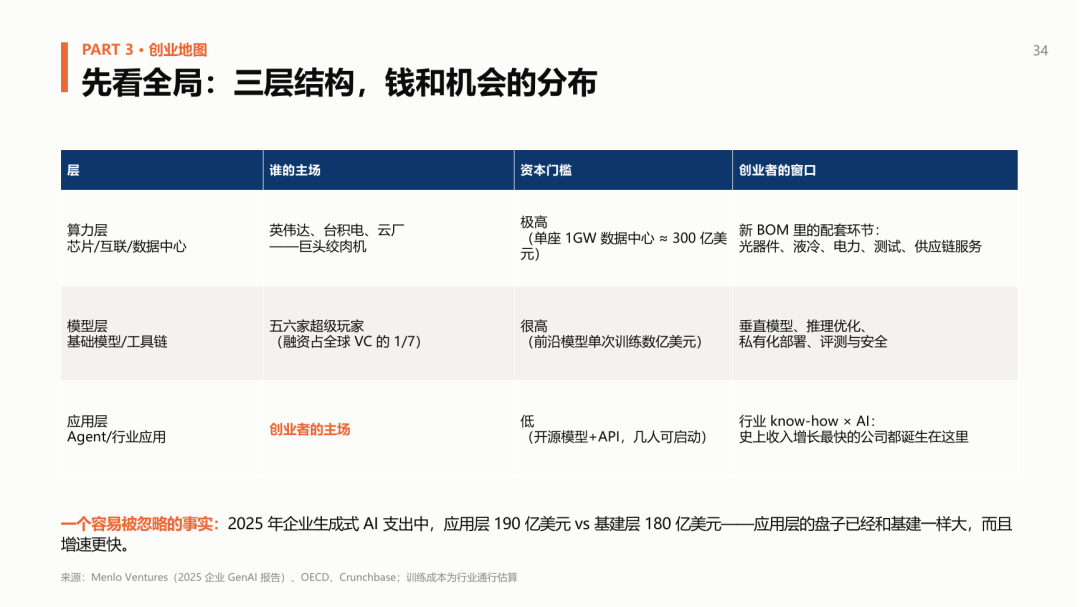
把整个 AI 产业竖着切三层。算力层:英伟达、台积电和云厂的主场,一座 1GW 数据中心约 300 亿美元,可以叫它"巨头绞肉机"——但它的配套环节是开放的。模型层:五六家超级玩家的资本军备赛,前沿模型单次训练数亿美元,但周边全是缝隙。应用层:创业者的主场——开源模型加 API,几个人就能启动,史上收入增长最快的公司都诞生在这里。
这里要纠正一个普遍的认知偏差:很多人觉得 AI 的钱都在基建,离自己很远。但 2025 年企业生成式 AI 支出里,应用层 190 亿美元、基建层 180 亿美元——应用层的盘子已经和基建一样大,而且增速更快。不要被基建叙事吓住,最大的机会在贴近客户的地方。
算力层:别打正面,做"军需官"
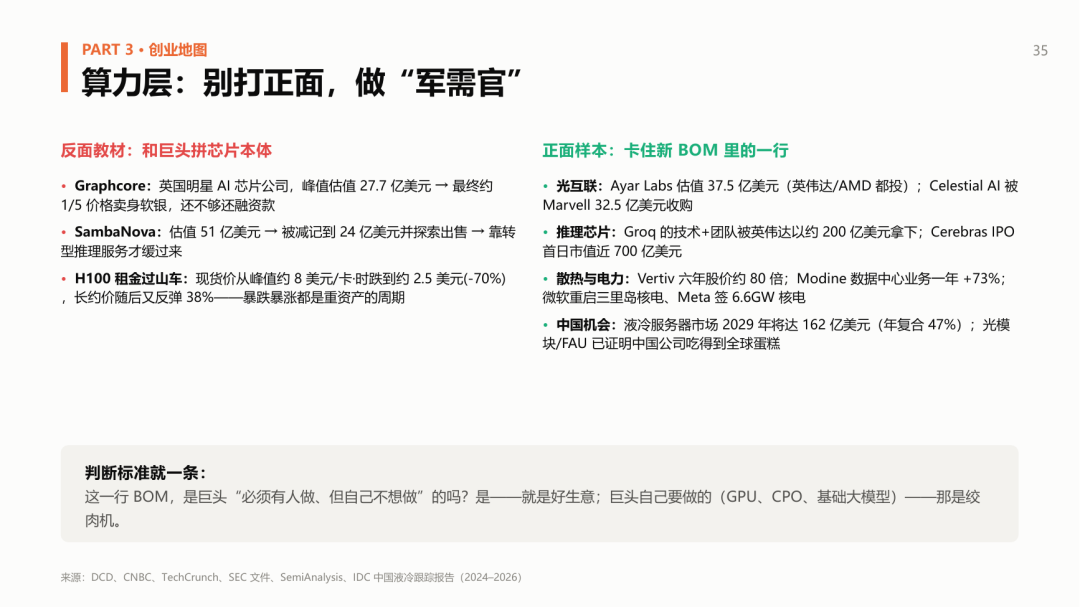
先看反面教材。Graphcore,号称"英伟达挑战者"的英国明星芯片公司,峰值估值 27.7 亿美元,最终以约五分之一的价格卖身,卖价还不够还历年融资款;SambaNova 估值从 51 亿美元被减记到 24 亿美元、探索出售,靠转型推理服务才缓过来;算力租赁同样是过山车——H100 现货租金从 8 美元一卡时跌到 2.5 美元、跌了七成,长约价随后又反弹 38%,暴跌暴涨都是重资产模式的周期,踩错半拍就出局。
再看正面样本,全是"卡住新 BOM 里一行"的公司:光互联的 Ayar Labs 估值 37.5 亿美元,英伟达和 AMD 都投了它;Celestial AI 被 Marvell 以 32.5 亿美元收购;Groq 的推理技术和团队被英伟达以约 200 亿美元拿下——被巨头高价买走,本身就是"军需官"路线的完美退出。散热与电力:Vertiv 六年涨了约 80 倍,微软为数据中心重启三里岛核电站,Meta 签下 6.6 吉瓦核电。中国侧的机会也很具体:液冷服务器市场到 2029 年 162 亿美元、年复合增长 47%。
判断标准就一条:这一行 BOM,是巨头"必须有人做、但自己不想做"的吗?是,就是好生意;巨头自己要做的——GPU、CPO、基础大模型——那是绞肉机,绕开走。
先进封装:一堵物理墙,和中国的"第二摩尔定律"
军需官路线里最硬核、也最属于中国的一条赛道,值得单独讲透。
先说一个所有人都逃不掉的物理天花板:一次光刻最多只能造出 858 平方毫米的芯片——这堵"光罩墙",中国、美国、台积电、英伟达谁都撞得头破血流,不是砸钱能解决的。一个锚点:英伟达 H100 就是一颗几乎占满光罩的芯片,814 平方毫米、800 亿晶体管——一颗顶到物理极限的先进芯片,差不多就是 800 亿晶体管。
英伟达的解法是"拼":单颗做不大了,就用两颗满光罩裸片加 8 颗 HBM 拼在 CoWoS 封装上,Blackwell 单封装 2,080 亿晶体管;下半年的 Rubin 更进一步,2 颗计算加 2 颗 I/O 裸片、3,360 亿晶体管;连光都要"焊"进来——COUPE 光引擎用小于 9 微米的无凸点混合键合,把电芯片直接叠在硅光芯片头顶。单芯片摩尔定律放缓之后,性能的接力棒已经交给了封装。
中国的难处是"又小又稀":拿不到 EUV 光刻机,最先进量产制程停在 7nm 级,晶体管密度只有台积电 5nm 的六到七成——这是"做不密";用 DUV 做接近光罩极限的大芯片良率崩塌,实际能量产的面积往往只有一半——这是"做不大"。密度打七折、面积再对折,两头一叠,中国单颗芯片的晶体管数量大约只有英伟达的三分之一到二分之一(综合推算口径)。所以结论很硬:英伟达能靠一颗大芯片打天下,中国不行——必须把多颗"做得出来的、合规的小芯片"用先进封装拼成一颗大的。同样是先进封装,对英伟达是锦上添花的效率问题,对中国是能不能上牌桌的生死问题——这就是"中国算力的第二摩尔定律"。
而这块地基还在指数级扩张:台积电 CoWoS 封装面积从 2016 年的 1.5 倍光罩,到 2025 年 5.5 倍(良率 98%)、2027 年 9.5 倍、2029 年要干到 14 倍以上、一个封装塞 24 颗 HBM。封装每上一个台阶,键合、减薄、电镀、TSV 刻蚀、检测就多一轮设备订单——先进封装设备 2026 年约 200 亿美元、以 30%–50% 的速度增长,是整个设备行业里最快的一条。价值正在从"制程"流向"封装":过去比的是几纳米,现在比的是谁能把多颗裸片、多层内存拼得又快又稳。
中国的起点并不落后:封装不像光刻那样被死死卡住,大陆 2.5D 先进封测份额八成五集中在头部一家,长电、通富、华天稳居全球封测第一梯队;国产设备已在关键工序卡位——拓荆科技的晶圆对晶圆混合键合已量产(这是门槛最高的一环,在手订单约 110 亿元),华海清科的减薄抛光一体机正对 HBM 刚需,天孚、上詮在光纤耦合环节卡住关键位置。差距也要诚实说:混合键合的量产规模和客户覆盖仍在爬坡,HBM 仍高度依赖海外三家,键合材料、玻璃基板、电镀液等上游材料还是短板。但方向很硬:先进封装是中国"以封装补制程"的战略支点,是设备行业增速最快、国产离第一梯队最近的一条赛道。
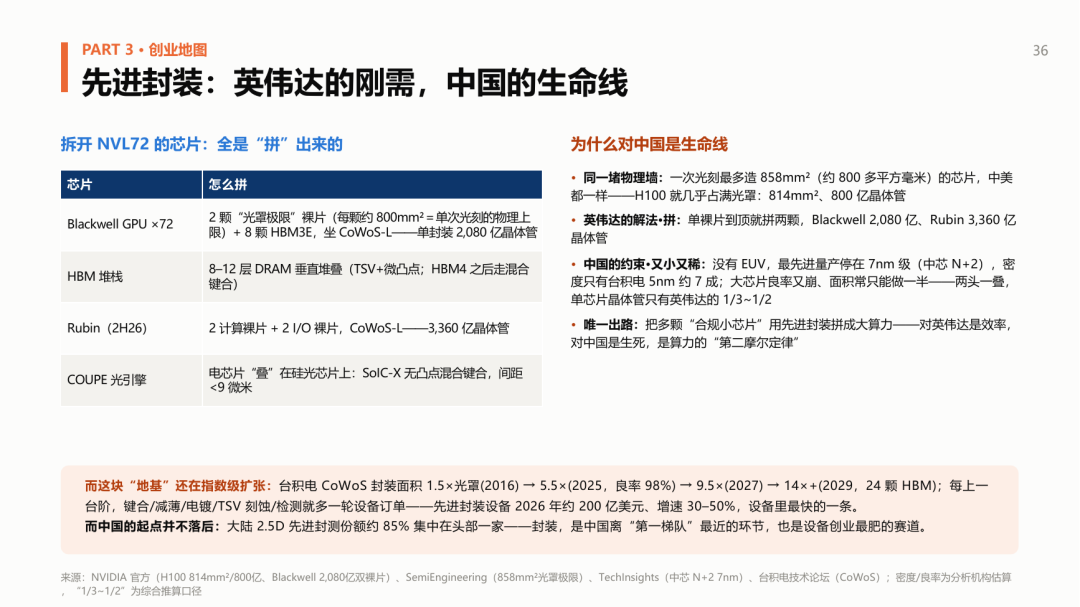
▲ 858 平方毫米的光罩墙:英伟达靠"拼",中国必须靠"拼"
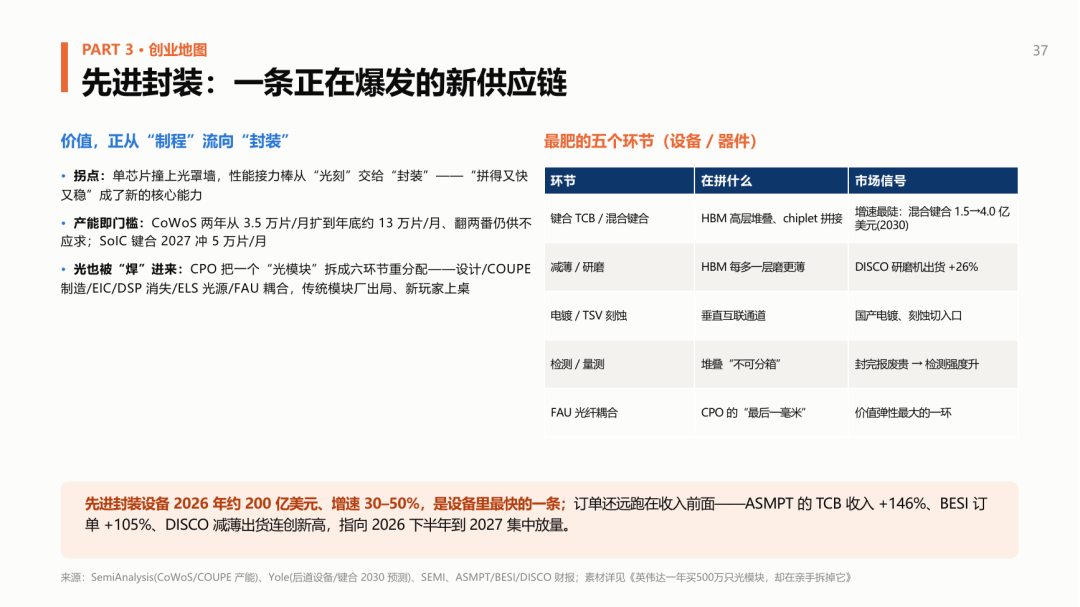
▲ 先进封装:一条正在爆发的新供应链,最肥的五个环节
放大到整个供应链:一级市场的五条赛道
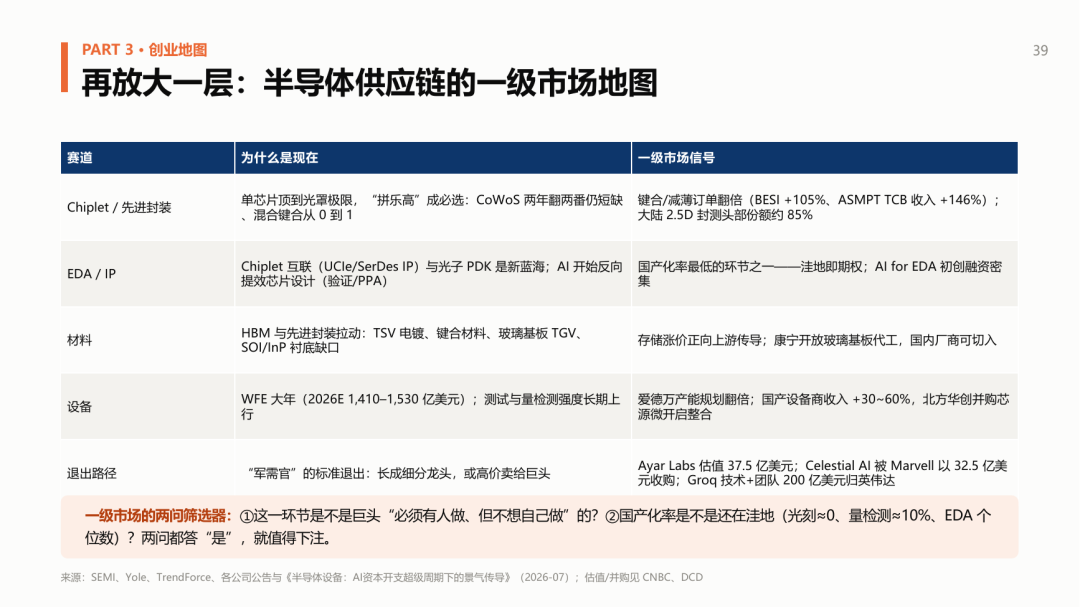
把视野放大到半导体供应链的一级市场,五条赛道值得盯。①Chiplet 与先进封装:CoWoS 两年翻两番仍短缺、混合键合从 0 到 1,排在第一位不是偶然。②EDA 与 IP:Chiplet 互联 IP、光子 PDK 是新蓝海,AI 还在反向提效芯片设计——这是国产化率最低的环节之一,洼地就是期权。③材料:TSV 电镀、键合材料、玻璃基板、衬底的缺口,存储涨价正向上游传导。④设备:测试与量检测强度长期上行,国产设备商收入普遍增长三到六成。⑤退出路径:军需官的标准退出就两条——长成细分龙头,或高价卖给巨头(Ayar Labs、Celestial AI、Groq 都是现成案例)。
给一级市场的两问筛选器:这一环节,是不是巨头必须有人做、但不想自己做的?国产化率是不是还在洼地?两问都答"是",就值得下注。
模型层:不训基础模型,吃"模型红利"
模型层的结论很直接:不要训基础模型——2025 年全球基础模型公司融资约 800 亿美元,两家头部就占全球风投的 14%,这是资本的军备竞赛,不是创业者的牌桌。但模型层的"周边"全是机会,三个方向:
其一,垂直模型:开源模型加行业数据等于领域专用模型,医疗、法律、金融、制造,每个行业都值得做一遍。其二,推理与私有化部署——训练定义技术上限,推理定义产业规模:训练是少数巨头的资本开支,推理是千万家企业的运营开支,拼性价比、功耗、交付能力而非纸面峰值;国产芯片、AI 一体机、行业 Agent 底座是随 Agent 落地长出来的新增需求,不只是国产替代——这是中国团队最顺手的窗口。其三,数据、评测与安全:Meta 花 143 亿美元只为买下数据公司 Scale AI 的 49% 股份;模型越多,评测、对齐、合规的刚需越大。
这里有一个每年都要重做的动作:模型能力每年上一个台阶、价格每年降一个数量级——把去年验证"做不了"的需求,今年用最新模型再试一遍。很多好公司,就藏在这个时间差里。
应用层:创业的主场,公式是"行业 know-how × AI"
应用层是创业者的主场,四个理由:速度——Cursor 18 个月 ARR 从 1 亿到 40 亿美元,Manus 八个月破 1 亿美元,软件史上从未有过的收入斜率;门槛——开源模型加 API 三五个人就能启动,模型每年的进步和降价是白拿的"外部研发红利";盘子——应用层支出 190 亿美元、增速超基建层,Agent 渗透率才 31%,还在第一局;组织——AI 让小团队获得大杠杆,"一人公司"第一次成为严肃的商业形态。
怎么不死?三条护城河:工作流嵌入(做进客户的日常流程,切换成本就是护城河)、数据闭环(越用越准的私有数据飞轮,模型公司拿不走)、行业准入(牌照、合规、线下网络——AI 替代不了的"硬摩擦")。一个死亡区要避开:模型公司下一个版本会"顺手做掉"的通用功能——翻译、摘要、通用聊天——别把公司建在别人的路线图上。
一个类比可以收住这一层:AI 是新的电。电气化时代最赚钱的不是发电厂,是用电重构的每一个行业——洗衣机、流水线、电梯。绝大多数人的优势不在算法,在于懂某个行业的"电"该怎么用。
铁证:赢下官方黑客松的,是律师、医生和公路工程师
空口无凭,看一场比赛的结果。Anthropic 官方举办的 Claude Code 黑客松:13,000 人报名、500 人入选、限时一周。五个获奖者里,四个不是职业程序员。
第一名,加州的一位人身伤害律师。他做了个叫 CrossBeam 的工具,解决加州住房建筑许可的审批难题——当地首次申报驳回率超过 90%、平均延误六个月、多花 3 万美元;他的工具分析图纸和政府补正函,20 分钟给出整改行动计划。重点是:他全程没写一行代码。第三名,布鲁塞尔的一位心脏科医生,做了诊后患者跟进工具:用大白话解释诊断、分析就诊记录、自动关联临床证据——患者第一次看得懂自己的病,医生随访不再靠人肉。还有一位获奖者,乌干达交通部的公路工程师:把行车记录仪视频直接变成道路投资评估报告,原来几周的活,5 小时跑完。
共同点一目了然:律师最懂审批的痛,医生最懂患者的痛,工程师最懂道路的痛。他们赢在行业 know-how,不是代码。"专业知识 × AI 执行力",就是这个时代的创业公式。
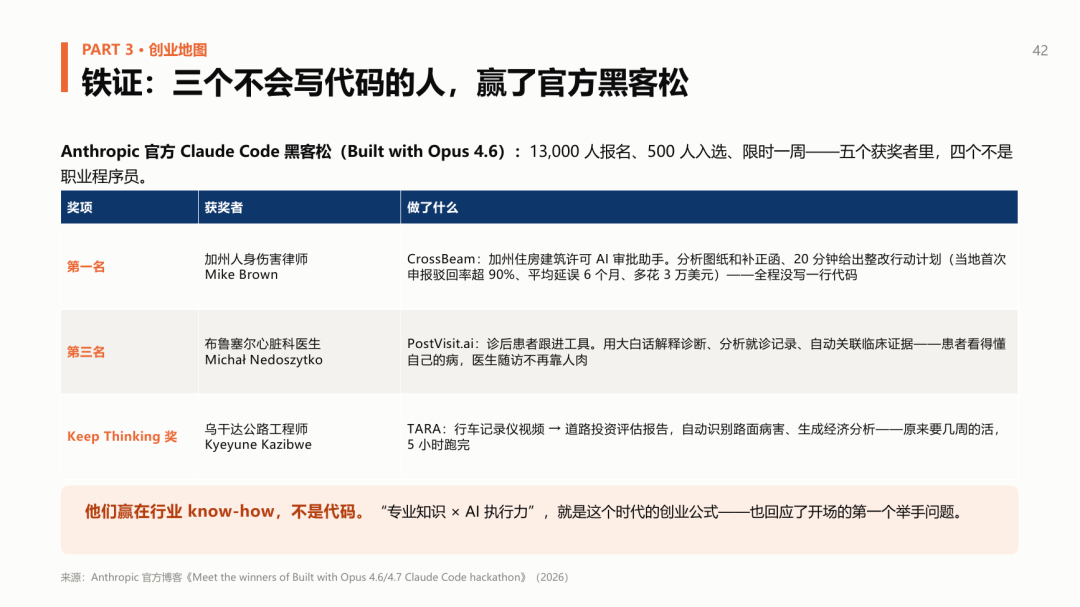
▲ 官方黑客松获奖者:行业 know-how 打败了代码能力
三盆冷水:泡沫、错配与地缘
讲完机会,必须泼三盆冷水。第一,泡沫之辩真实存在:一年 7,000 多亿美元资本开支,对应全行业 AI 收入只有几百亿美元量级;巨头之间"我投你、你买我"的循环交易在放大数字——单 GW 的账 2026 年刚转正,账是真的,但杠杆已经很高。第二,过剩与紧缺同时为真:算力现货租价三年跌七成是过剩,长约价半年反弹四成、HBM 和先进封装排队到 2027 是紧缺——判断过剩还是紧缺必须精确到环节,一切笼统结论都是错的。第三,政策与地缘是常量不是变量:出口管制反复摇摆、跨境并购说停就停——2026 年连 Meta 收购 Manus 都被叫停了。地缘不是黑天鹅,是商业计划书里必须预置的边界条件。
历史的参照系是 2000 年:互联网泡沫破裂,但光纤留下来了,亚马逊和谷歌就长在泡沫的废墟上。泡沫会出清估值,出清不了基础设施。对创业者,重要的不是预测泡沫,是活过周期。
07
方法论与行动:一列火车、四个问题、三件事
给创业者的五句话
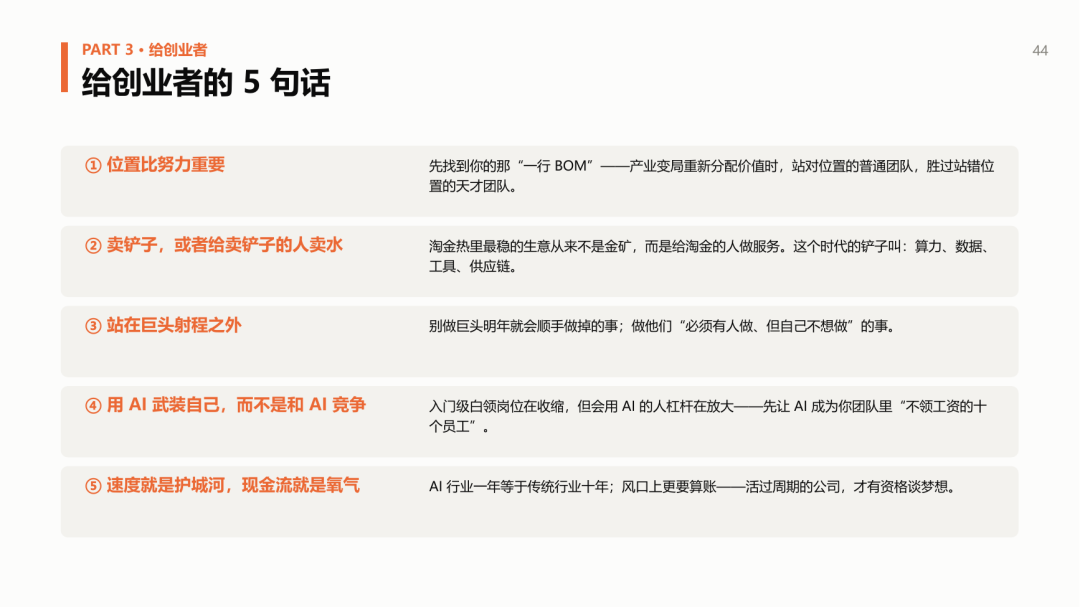
① 位置比努力重要——先找到你的那"一行 BOM":产业变局重新分配价值时,站对位置的普通团队,胜过站错位置的天才团队。② 卖铲子,或者给卖铲子的人卖水——淘金热里最稳的生意从来不是金矿;这个时代的铲子叫算力、数据、工具、供应链。③ 站在巨头射程之外——别做巨头明年就会顺手做掉的事,做他们"必须有人做、但自己不想做"的事。④ 用 AI 武装自己,而不是和 AI 竞争——入门级白领岗位在收缩,但会用 AI 的人杠杆在放大,创业第一天就让 AI 成为团队里"不领工资的十个员工"。⑤ 速度就是护城河,现金流就是氧气——AI 行业一年等于传统行业十年,越是风口越要算账,活过周期的公司才有资格谈梦想。
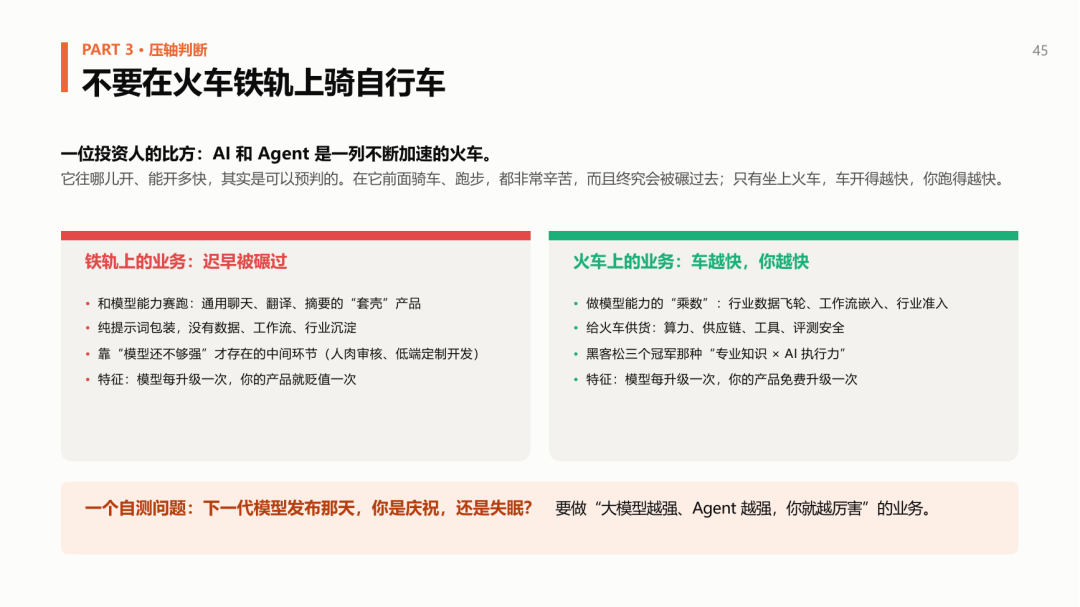
唯一的自测题:不要在铁轨上骑自行车
有位投资人打过一个恰当的比方:AI 和 Agent 是一列不断加速的火车。它往哪儿开、能力会提升到什么程度,其实可以预判——Scaling Law、token 价格曲线、Agent 落地节奏,方向清清楚楚。在这列火车前面,骑自行车还是跑步都会非常辛苦,而且终究被碾过去;只有坐上火车,车开得越快,你跑得越快。
什么是铁轨上的业务?和模型能力赛跑的业务:通用聊天、翻译、摘要的套壳产品,纯提示词包装、没有沉淀的中间层,靠"模型还不够强"才存在的环节——共同特征:模型每升级一次,产品就贬值一次。什么是火车上的业务?做模型能力的"乘数":行业数据飞轮、工作流嵌入、行业准入;或者给火车供货:算力、供应链、工具、评测安全——共同特征:模型每升级一次,产品免费升级一次。
自测题只有一道:下一代模型发布那天,你是庆祝,还是失眠?庆祝的人在火车上,失眠的人在铁轨上。
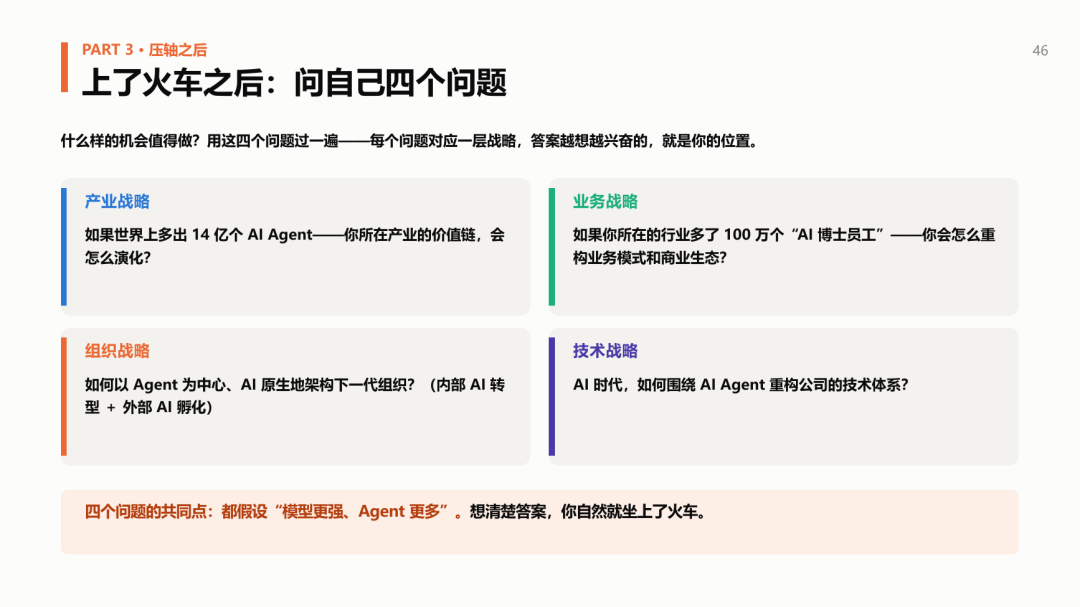
上了火车,还要找到自己的座位——四个问题,各对应一层战略,值得拿纸笔真过一遍:产业战略——如果世界上多出 14 亿个 AI Agent,你所在产业的价值链会怎么演化,谁被压缩、谁被放大、新环节长在哪里?业务战略——如果你所在的行业多了 100 万个"AI 博士员工",你会怎么重构业务模式和商业生态?(这不是科幻:编程 Agent 已经在替每个开发者每周干 20 小时。)组织战略——如何以 Agent 为中心、AI 原生地架构下一代组织?技术战略——公司的技术体系怎么围绕 AI Agent 重构?四个问题的共同点是都假设"模型更强、Agent 更多":答案越想越兴奋,说明业务在火车上;越想越害怕,趁早换位置。
给每个人的三件事
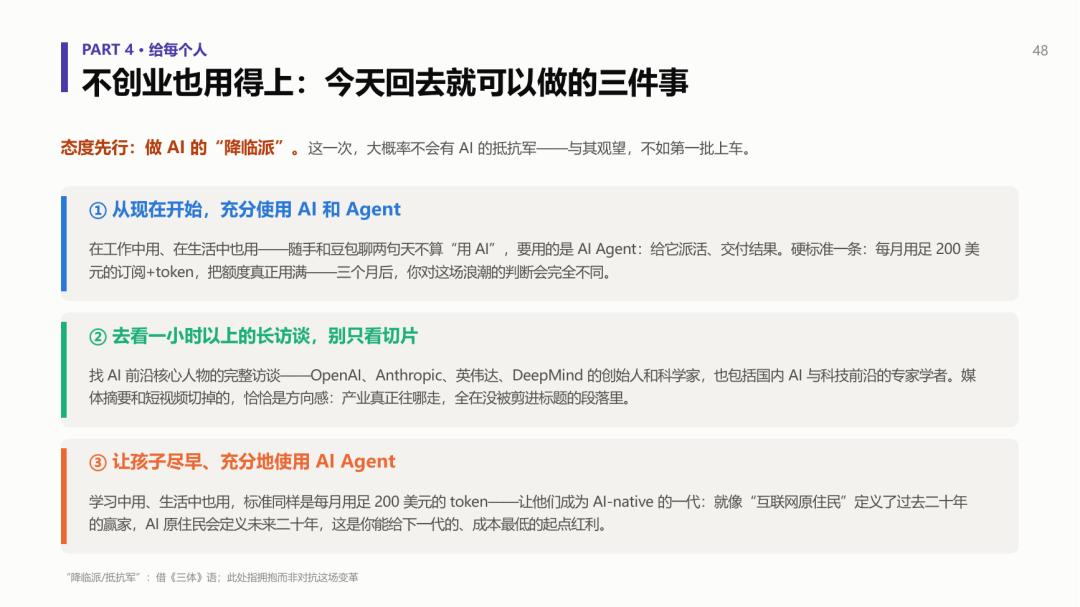
不创业的人怎么办?先亮一个态度,借《三体》的词:做 AI 的"降临派"。小说里人类分成降临派、拯救派、幸存派,还组建了抵抗军;而这一次 AI 的降临,大概率不会有抵抗军——它不是入侵者,是每个人手里最大的杠杆。与其观望争论,不如第一批上车。三件事,都不要钱:
第一件:从现在开始,充分使用 AI 和 Agent——工作中用,生活中也用。先说清什么不算:随手打开聊天应用问个天气,不叫用 AI;要用的是 Agent——把它当同事,给它派活,让它写方案、查资料、做分析、跑多轮任务,交付结果。衡量"充分"的硬指标:每月用足 200 美元的订阅加 token。开头会觉得根本花不掉,那就逼自己不断给它找事做,直到真把额度用满——只有真金白银花出去,才摸得到 Agent 干活的边界。三个月后,你对这场浪潮的判断会完全不同:工具的体感,永远先于认知。
第二件:去看一小时以上的长访谈,别只看切片。AI 行业按周变化,传统信息渠道已经失灵;最好的渠道是 AI 前沿核心人物的完整访谈——OpenAI、Anthropic、英伟达、DeepMind 的创始人和科学家,也包括国内 AI 与科技前沿的专家学者。媒体摘要和短视频切掉的恰恰是方向感:产业真正往哪走,全在没被剪进标题的段落里。
第三件:如果有孩子,让他们尽早、充分地使用 AI Agent——学习中用、生活中也用,标准同样是每月用足 200 美元。就像"互联网原住民"定义了过去二十年的赢家,AI 原住民会定义未来二十年——这可能是能给下一代的、成本最低的起点红利。
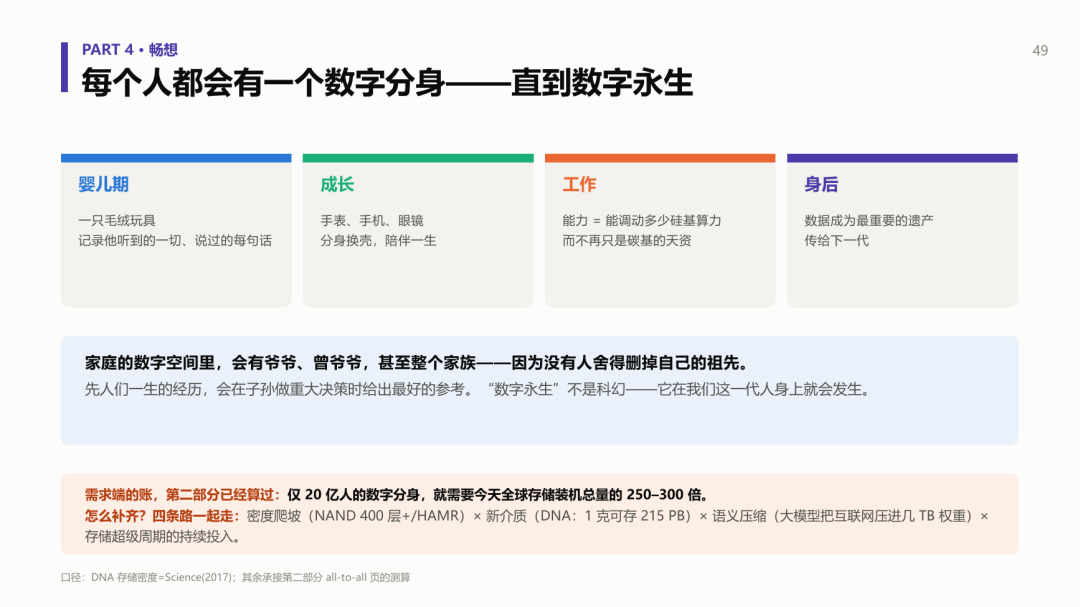
一个不太远的畅想:数字分身与数字永生
AI 原住民的一代人,每个人都会拥有一个真正意义上的数字分身。它可能从婴儿期就开始——以一只毛绒玩具的形态,记录孩子听到的一切、说过的每句话;孩子长大,分身跟着换壳:手表、手机、眼镜,陪伴一生。到最后,决定一个人工作能力的,可能不再是天生的"碳基"资质,而是他能调动多少"硅基"算力和存储为己所用。
再往后想一步:肉身过世后,这些数据会作为最重要的遗产传给下一代。家庭的数字空间里会有爷爷、曾爷爷、甚至整个家族——因为没有人舍得删掉自己的祖先。先人一生的经历,会在子孙做重大决策时给出最好的参考。这种"数字永生"不是下个世纪的事,它在我们这一代人身上就会发生。
这个畅想对产业意味着什么?需求端的账前面已经算过:仅 20 亿人的数字分身,就需要今天全球存储装机总量的 250–300 倍。缺口怎么补齐?四条路一起走:密度继续爬坡(NAND 往 400 层以上堆、硬盘上 HAMR,密度每两三年翻一倍);新介质(DNA 存储 1 克能存 215 PB,20 亿人的大脑理论上 23 吨 DNA 就装下);语义压缩(大模型本身就是最好的压缩机,把整个互联网"压"进了几 TB 的权重——数字分身存的是"意义",不必存原始比特);以及正在进行的存储超级周期。前面讲的所有基建故事,都只是这个未来的序章。
结语:
每一代人,都有自己的基础设施
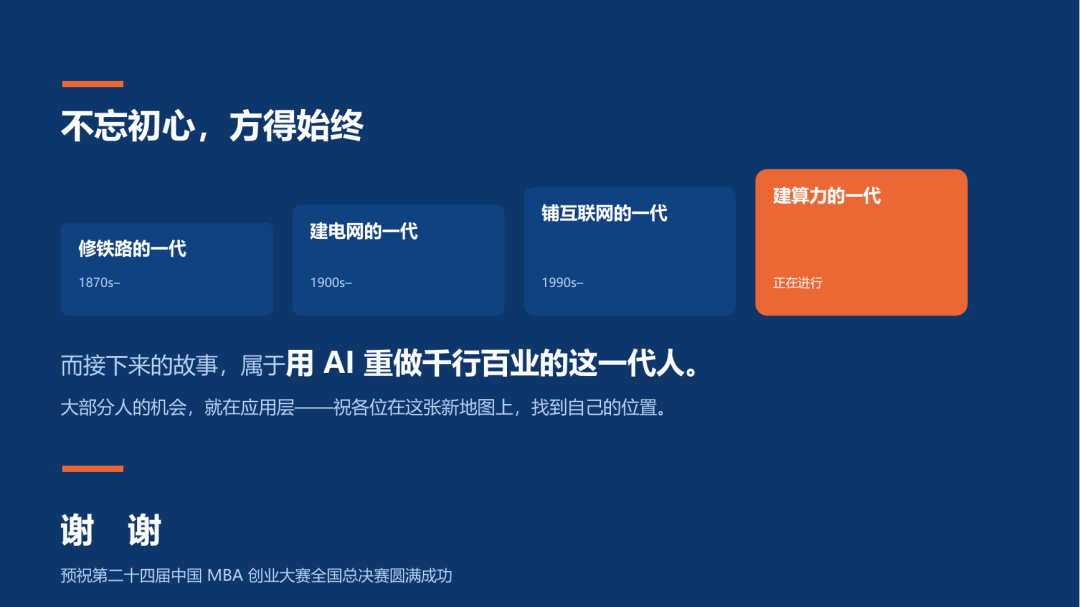
一百五十年前,有人修铁路;一百年前,有人建电网;三十年前,有人铺互联网;今天,这一代人在建算力。
而接下来的故事,属于用 AI 重做千行百业的这一代人——大部分人的机会,就在应用层,就在自己最懂的那个行业里。牌桌已经摆好,地图已经展开。下一代模型发布那天,愿你是庆祝的那一个。
数据与免责声明:本文内容整理自 2026 年 7 月一场面向创业者的行业分享及配套研究材料,经编辑重构与补充。文中数据截至 2026 年 7 月,来源包括公开财报、WSTS/Gartner/SEMI/IEA 等机构预测、公开报道及业内研讨口径,部分为第三方估算或业内流传说法(文中已标注"据报道""业内断言""综合推算口径"等);涉及企业与行业的表述仅用于记录产业观点,不构成任何投资建议。
点这里👆加关注,锁定更多原创内容
推荐阅读
喜欢我们的内容就点“在看”分享给小伙伴哦~