
 五度妙笔
 企业透视镜
 API商城

 数据库
从万卡到十万卡,国产算力最难的一关才刚刚开始
万卡现在已经算不上新闻。国内宣布过万卡集群的厂商,一只手数不完。
真正卡住人的是十万卡。不是买不到卡,是组织不起来。
十万卡=万卡x10?
十万卡不是十个万卡这么简单。规模跨过某个门槛以后,你要面对的东西就不再是"一张芯片"的问题,而是一整套系统:互联、通信、调度、容错、运维。
这里面任何一环出错,最后都会落到同一件事上——有效算力打折。集群规模越大,被故障、等待和重排吃掉的时间就越多,而且是指数级的多。
十万卡时代,拼的是"不中断"
到了十万卡集群时代,集群必须自己发现问题、自己隔离、自己恢复,保障训练不能停。
摩尔线程在万卡级交付里验证的,说到底就是这种系统级的稳定性,突出体现在三个指标上:
线性扩展率。集群不是卡堆得越大就越快,规模上去之后卡和卡之间如果处理不好互相拖累是常态。摩尔线程披露过,最高能做到 95% 的线性扩展效率——也就是加到上万张卡,整体算力基本按比例涨,没有被内耗吃掉。
有效训练时间占比超过 90%。这个数最实在。训练集群真正"在算"的净时间,扣掉修机器、等调度、任务重排之后还能到九成以上,已经是业界前几名的水平了。
零中断这一块。 长时间训练也能断点续训,再叠上通信、调度、故障诊断和恢复的全链路兜底,单点出问题不用从头跑,任务挂了能续上,局部坏了不影响整体跑。这恰恰是十万卡能长期"在线"的重要原因。
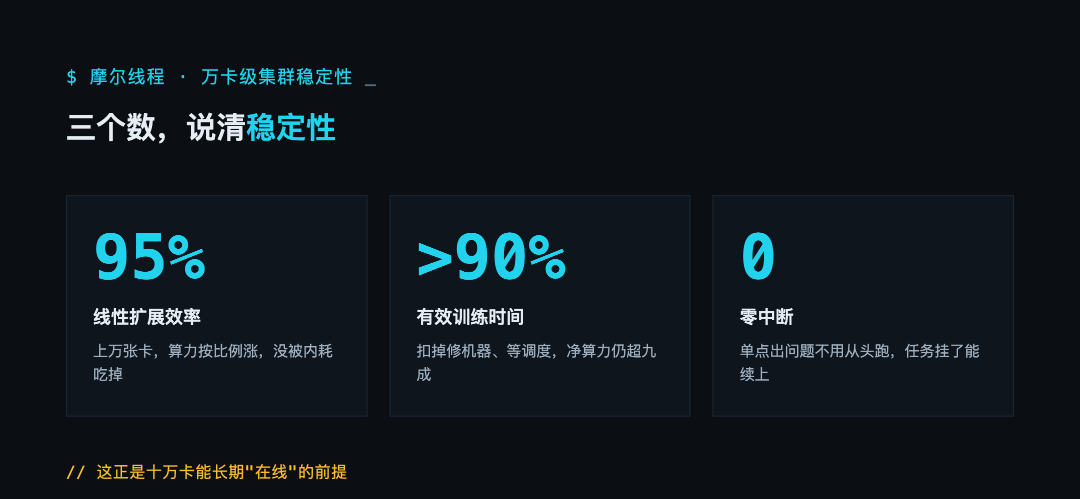
真实训练里没人能给一个永远不出问题的集群,但摩尔线程能做到让问题不中断任务。
摩尔线程,不只做芯片
外界对摩尔线程的印象,大多停留在“芯片企业”上。MTT S5000也确实是最容易被看见的产品。
但把十万卡这件事拆开看:服务器怎么设计,卡间怎么互联,集群软件怎么写,任务怎么调度,运维怎么管,出了问题怎么定位。再往上还有——软件生态,开发者能不能把现有代码低成本搬过来、模型能不能跑得起来;工程交付与产业应用,这套系统能不能真正落到客户的机房、接上真实的业务。这些能力缺一样,芯片再强也只是芯片。
从这个角度看,S5000提供的是算力单元,夸娥负责把这些算力单元组织成一套能跑真实任务的智算系统,Dense、MoE这些大模型训练场景的落地,则是这套系统被真实工作负载检验过的证明。
还有很关键的,面向十万卡扩展的C256超节点架构,属于同一个方向上的提前布局。
换句话说,这家公司现在的能力边界,已经从芯片设计延伸到了服务器、互联、集群软件、任务调度、运维管理,以及软件生态和工程交付。它的身份正在从一家设计GPU芯片的公司,变成一家覆盖芯片、集群、软件生态到工程交付和产业应用的系统能力公司。
一个信号
需求端的变化,比技术指标更能说明问题。
不久前,京东云刚宣布与摩尔线程共同打造十万卡级全功能GPU集群。头部云厂商开始把国产GPU纳入超大规模核心算力基础设施的规划,这件事的分量,比某一次发布的跑分重得多。
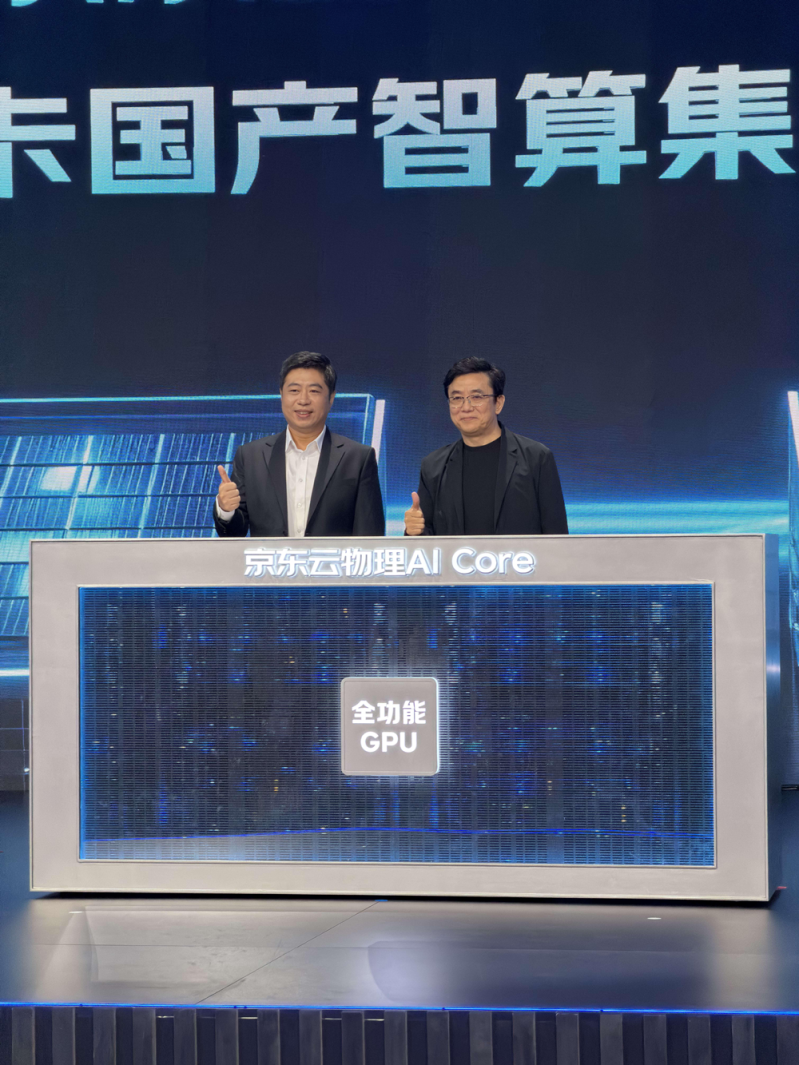
它意味着国产GPU的考察标准变了。以前问的是"能不能用",现在问的是"能不能大规模交付、长期运营"。
最难的一关刚开始
十万卡不是终点,它是分水岭。
之前比的是单点能力——谁能做出一张拿得出手的卡。之后比的是持续运营一套复杂系统的能力——谁能把十万张卡变成一台稳定运转的机器,并且让它一直转下去。
这道题没有捷径,也躲不开。国产算力最难的一关,才刚刚开始。
-END-


